MrGips • Про LLM


Гео и язык канала: Россия, Русский
Категория: Технологии


Все про локальные LLM и не только.
Для связи: @MisterGips
НАШ ЧАТ https://t.me/+ZV1ymPoTNzlkYmE6

Связанные каналы

Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


Говорят 35B можно не ждать в грядущей линейке Qwen 4

Но в целом со Strata и Qwen Flash Next, уже не особо то и надо. Правда ведь?

Что там кстати у вас как дела с Qwen 3.8 Flash Next? Играетесь?

MrGips • Про LLM / НАШ ЧАТ


Весь механизм коробки передач собрал мне GPT 6.1 Sol в Blender

Продолжаю проект симулятора автомобиля. И это кажется похоже на произведение искусства. Для реалистичности осталось обвалять в масле все эти железяки.

Если вы не в курсе что это, можете посмотреть это видео:
https://www.youtube.com/watch?v=kxTcCh7LPlU

MrGips • Про LLM / НАШ ЧАТ


Claude Opus 5.5 собрал мне игрушку в Unreal Engine

Несколько дней я мучал Опуса в Blender, чтобы он смоделировал мне все детали для Honda Accord по схемам из каталога. Затем все это добро я попробовал закинуть в Unreal Engine, чтобы собрать реалистичный визуализатор работы двигателя. А потом вообще симулятор реалистичной подвески.

Смотреть: https://www.youtube.com/watch?v=kxTcCh7LPlU

Я конечно впечатлен. До нейросетей я о таком только мог мечтать. А теперь за несколько дней сделал сам. Удивительное время!

MrGips • Про LLM / НАШ ЧАТ

967 0 8 12 21

Вот такие игрушки мне собрал Opus 5.5

Уже несколько дней я играюсь с Опусом в Blender. Каждая запчасть была отдельно смоделирована. Затем я подумал что хочу сделать стенд с работающим двигателем в Unreal Engine. Чуть позже моя Honda Accord из прошлого видео, начала ездить в UE5.8 с симуляцией полноценной подвески на тестовых участках дороги.

Интересные времена, раньше я такое только на ютубе видел, а теперь сам создаю.

MrGips • Про LLM / НАШ ЧАТ


🚀 Strata v0.1.34 - AMD на Windows, MCP для автонастройки и быстрый cancel запросов

Обновы летят как из пулемета. В этот раз на NVIDIA большого прироста скорости нет, зато релиз заметно улучшает работу с агентами и добавляет полноценный Windows-билд для AMD.

🔥 Главное нововведение - AMD теперь поддерживается на Windows через обычный START-HERE.bat.

Поддерживаются:
• RX 7900 XT / XTX
• RX 7800 XT / 7700 XT
• RX 9060 XT
• RX 9070 / 9070 XT
• Radeon AI PRO R9700
• RX 6800 / 6900 series

⚠️ Пока у AMD под Windows есть ограничения: одна GPU на модель и без vision. На Linux AMD по-прежнему поддерживает multi-GPU, а изображения обрабатываются через CPU.

👁 Что с Vision

В предыдущей v0.1.33 разработчик исправил strata-vision.exe. Сборка из v0.1.32 случайно требовала AVX-512 и могла не запускаться на многих Ryzen и Intel с ошибкой «illegal instruction».

Теперь vision encoder снова собран более универсально:
• AVX2
• без OpenMP
• сохранена поддержка RTX 20

Также vision encoder можно вынести на отдельную NVIDIA GPU через параметр:

"cuda_device": 1

То есть основную модель можно оставить на одной карте, а обработку изображений отправить на другую.

Для нового AMD Windows backend vision пока не поддерживается.

🤖 Ещё одна интересная новинка - собственный MCP-сервер tools/strata_mcp.py.

Теперь Claude Code, Cursor, Codex или Copilot могут сами:
• проверить конфигурацию ПК
• подобрать подходящую модель
• установить Strata
• запустить сервер
• проверить его состояние
• остановить Strata
• показать параметры подключения.

⚡️ Очень полезный фикс для агентских workflow: отменённый запрос теперь освобождает engine примерно за 1 секунду.

Раньше, если клиент закрывал соединение, non-streamed запрос мог продолжать генерировать до max_tokens, а streamed-запрос - продолжать обрабатывать длинный prompt. Следующий запрос в это время ждал.

В пользовательских отчётах задержка доходила до 17-33 секунд.

Теперь после disconnect/cancel вычисление быстро прекращается. В тесте разработчика после отмены длинного 57K prompt следующий короткий вопрос получил ответ примерно за 0.6 секунды.

📦 Setup тоже немного доработали:

• при продолжении прерванной загрузки теперь нужно свободное место только под оставшуюся часть файла
• перед скачиванием 111-ГБ UD-Q4_K_XL на AMD setup отдельно предупреждает, потому что эта комбинация пока не протестирована
• AMD больше не называется experimental в основной документации

Для пользователей RTX 30/40/50 самые полезные изменения:
• быстрый cancel запросов
• MCP-сервер
• исправления vision из v0.1.33
• дополнительные серверные и setup-фиксы

Обновление стандартное:

git pull

затем:

START-HERE.bat

Setup сам установит Strata engine v0.1.34.

https://github.com/Niko1221/Strata/releases/tag/v0.1.34

Кто рискнет поставит обнову, пишите в комментарии свой отзыв.

MrGips • Про LLM / НАШ ЧАТ


Strata v0.1.31 - большое обновление

Вышла новая версия Strata. Самое интересное:

• Unsloth UD-Q4_K_XL теперь можно запускать даже на ПК с 64 ГБ RAM, хотя сама модель занимает около 111 ГБ. Эксперты делятся на 3 уровня: самые используемые хранятся в VRAM, следующие - в RAM, редкие читаются прямо с SSD. На RTX 5070 12 ГБ + 64 ГБ RAM автор получил примерно 7-8.5 т/с.

• Появился reasoning_budget_tokens — теперь можно жёстко ограничить количество токенов, которое модель тратит на thinking, после чего она переходит к ответу. Это прям мне нехватало.

• Уважили также и АМДэшников. Для AMD RDNA4 decode ускорился до +15%. На Radeon AI PRO R9700 скорость выросла с 67 до 82 т/с.

• Для multi-GPU появился "split_skip_if_fits": true — можно автоматически не делить модель, если первая карта и так вмещает все experts.

• Новый экспериментальный STRATA_GR_V3=1 даёт ещё примерно +2-4% decode.
Multi-GPU теперь поддерживается и на нескольких AMD-картах.

Для обновления достаточно сделать git pull и снова запустить START-HERE.bat. Setup сам установит engine 0.1.31.

Остальные обновы можете почитать тут: https://github.com/Niko1221/Strata/releases/tag/v0.1.31

Испытали уже? Кидайте результаты в комменты!

MrGips • Про LLM / НАШ ЧАТ

1.1k 0 37 155 35

Strata снова ускорили - Qwen3.8 Flash Next уже выходит на 100+ т.с

Подрезал с реддита пост про новую обнову Strata, где еще больше ускорили движок.

Кто здесь новенький, то Strata - это движок для запуска чисто Qwen 3.8 Flash Next (огромной МоЕ модели) на потребительских ПК-шниках.

Он бьет рекорды не только в decode, но и в prompt processing.

Подъехали новые результаты.

На RTX 5070 12 GB:

• ~51 tok/s на IQ3_XXS
• до 1500 tok/s prompt processing

Для сравнения, тот же квант через llama.cpp у меня выдавал около 23 t/s на особом форке, который мне подсказал человек в комметариях. Без этого форка было 16 т/с на 5090.

А в комметах на реддите пользователи уже сообщают:

• RTX 3060 - ~60 tok/s
• RTX 4090 - ~70 tok/s
• RX 7900 XTX - 45–60 tok/s
• RTX 5090 - 100–130 tok/s и до 4–4.5K tok/s prefill

Появился и форк StrataGP, где huge pages дали около +15% скорости на RTX 3060.

Заодно Strata получила 262K контекст, multi-GPU, vision, кеширование диалога и OpenAI/Anthropic API.

Пару недель назад Flash Next на 12 GB VRAM выглядела как эксперимент. Сейчас это уже вполне рабочая локальная MoE-модель с десятками, а на 5090 - сотней токенов в секунду. Но я еще не обновлялся, поэтому это пока отзывы других людей.

Вы уже обновились? Кидайте результаты в комменты!

MrGips • Про LLM / НАШ ЧАТ


Немного увлекся в Blender с Opus'ом [продолжение]

Зачем я это всё делаю? Хочу проверить, насколько точно опус воспроизведет детали автомобиля вплоть до каждого болта в 3D моделировании.

Здесь не только нужно повторить примерную форму запчастей, но и их расположение в подкапотном пространстве.

Держу в курсе!

MrGips • Про LLM / НАШ ЧАТ


Strata добавила полноценный multi-GPU режим

Главная идея - не tensor parallelism, а разделение модели по слоям. Один GPU считает первые слои, второй - следующие, третий при необходимости - оставшиеся. При этом каждая карта держит expert cache только для своих слоёв, поэтому суммарно в VRAM помещается намного больше экспертов и модель реже обращается к CPU/RAM.

Что важно:
• NVLink не нужен;
• PCIe x4/x1 тоже допустим;
• поддерживаются RTX 30/40/50;
• каждая карта должна иметь минимум 8 ГБ VRAM;
• первая карта в списке считается основной;
• лучший режим — --layer-split auto, Strata сама подбирает оптимальное распределение слоёв;
• vision, KV streaming, checkpoints и control vectors работают и в multi-GPU.

Запуск простой:
START-HERE.bat --gpus 0,1 --layer-split auto
или вообще без параметров - установщик сам покажет подходящие GPU и предложит объединить их.

По тестам авторов на RTX 5080 + RTX 3090:
• обработка prompt ускорилась примерно на 18–20%;
• decode остался примерно на уровне более быстрой карты;
• генерация кода стала быстрее, потому что почти все нужные routed experts помещались в GPU-кэш.

То есть multi-GPU здесь - это не «в 2 раза быстрее». Основной выигрыш в том, что больше expert weights остаётся в VRAM, меньше данных приходится брать из CPU pool, а длинные prompt’ы обрабатываются быстрее.

Ещё важный момент: добавлять много слабых карт не всегда полезно. В тестах дополнительная медленная GPU, наоборот, ухудшила decode - каждый новый pipeline stage добавляет свои накладные расходы.

Итог: multi-GPU в Strata имеет смысл прежде всего тогда, когда routed experts одной большой MoE-модели не помещаются в VRAM одной карты. Тогда вторая карта может заметно снизить зависимость от RAM/CPU и ускорить работу без необходимости иметь одинаковые GPU.

Линк: https://github.com/Niko1221/Strata/blob/main/docs/MULTI_GPU.md

MrGips • Про LLM / НАШ ЧАТ

1.3k 1 29 57 18

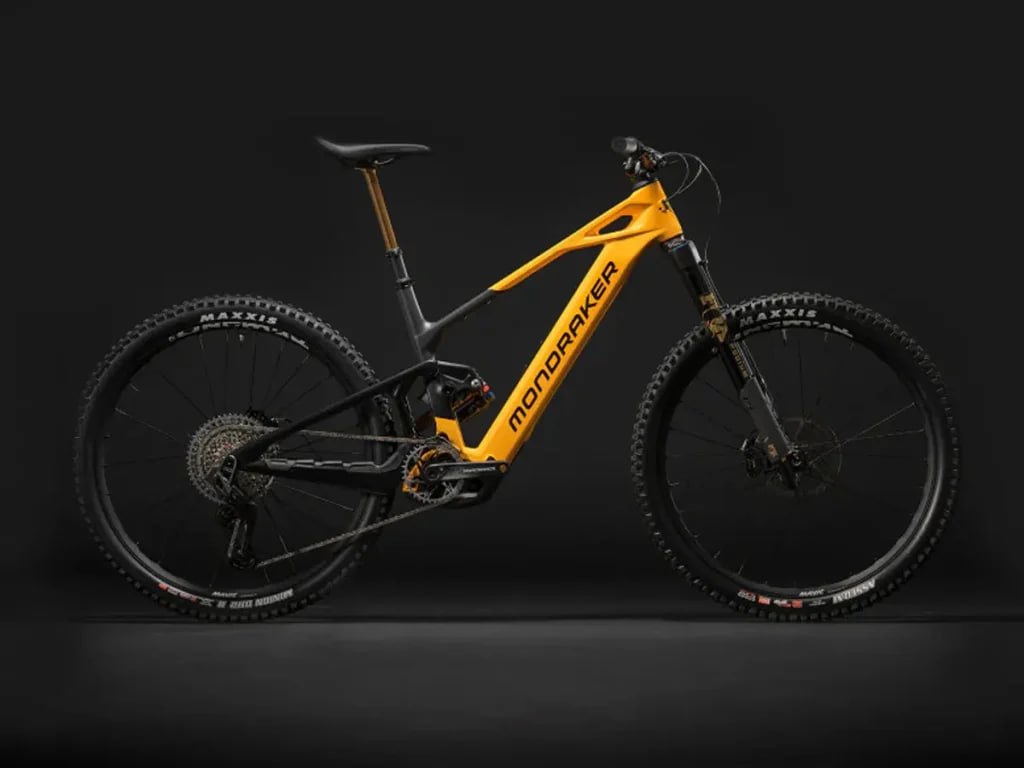
Велосипед в Blender на Strata и Qwen 3.8 Flash Next IQ3_S

Он немного корявый, потому что при генерации вылезла какая-то ошибка и генерация оборвалась.

Я делал через DeepSeek Harness, не особо его настраивал, видимо в контекст уперся раньше времени и не смог его сжать.

Но результат мне нравится. Очень много мелких деталей, которые Qwen 3.8 27B пропускал.

Держу в курсе!

MrGips • Про LLM / НАШ ЧАТ


Qwen 3.8 Flash Next со скоростью 50+ ток/с в новом движке STRATA

Только сегодня делал пост про новый движок для запуска тяжелой MoE модели, как уже подоспели тесты.

Смотреть: https://www.youtube.com/watch?v=M0mMmUrHhP0

Приятного просмотра!

MrGips • Про LLM / НАШ ЧАТ


🚀 Появился новый движок Strata, который запускает огромную Qwen3.8 Flash Next даже на видеокартах с 12 GB VRAM

Думаю вы уже знаете что Qwen3.8 Flash Next большая MoE-модель, которая требует очень много памяти. Но разработчик нового inference-движка Strata смог распределить её между GPU, оперативной памятью и SSD.

В результате модель уже запускают даже на обычных игровых видеокартах.

На RTX 5070 12 GB при контексте 128K разработчик получил:

• Q2_0 - около 65 tok/s
• IQ2_XS - около 52 tok/s
• IQ3_XXS - около 45 tok/s
• IQ3_S - около 42 tok/s

На коротком контексте скорость ещё выше.

Появились и тесты от других пользователей:

• RTX 5070 Ti - около 86 tok/s на IQ3_XXS при 64K
• RTX 4090 - примерно 58–70 tok/s на IQ3_S при 262K
• даже RTX 2070 8 GB удалось запустить примерно на 20 tok/s

Как это работает?

Strata не пытается полностью загрузить огромную модель в видеопамять.

Самые востребованные части модели находятся на GPU, остальные MoE-эксперты - в RAM, а большая PLE/n-gram память может храниться на SSD.

Таким образом, Flash Next можно запускать даже при относительно небольшом объёме VRAM.

Ещё одна важная функция — кеширование диалога. После первого запроса Strata сохраняет состояние и при следующих обращениях обрабатывает только новый контекст, что особенно важно для AI-агентов и программирования.

Пока у проекта есть ограничения: нет полноценного multi-GPU.

Но сам факт уже интересный: Qwen3.8 Flash Next постепенно превращается из огромной модели для дорогих серверов в LLM, которую можно запускать на обычном домашнем ПК.

Я сам еще не пробовал, но в НАШЕМ ЧАТЕ люди потихоньку запускают, скорость реально повыше.

Линк на движок: https://github.com/Niko1221/Strata

Модели, которые нужны Страте: https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF

Пробовали уже?

MrGips • Про LLM / НАШ ЧАТ

1.9k 4 163 35 30

Попробовал повторить тренд из инстаграма

Делал в Minimax H3, стандартный ворк Ref2V. Руки еще помнят ComfyUI.

Как же приятно, когда можно сделать локально не хуже, чем в распиаренном сидансе.

MrGips • Про LLM / НАШ ЧАТ


Qwen Image 2.1 - несколько примеров как работает режим редактирования

Промты:
Change all Coca Cola cans of by the can of . Keep then cans crushed as in . Make the white surface reflects the blue and pink colors of

Keep the character and pose in unchanged, put this Rolex wristwatch from on the character, preserve the original body shape and pose, the wristwatch fits naturally on wrist, keep the original background and original lighting, high fashion editorial photography, sharp details

Утащил с реддита для вас.

MrGips • Про LLM / НАШ ЧАТ


Opus 5.5 + Blender + Unreal Engine

У меня нет идей на игры, поэтому делаю прототип разборки ходовки с реальными каталожными номерами и 3D запчастями. Зачем? Не могу остановиться 🤷‍♂️

Все это добро засунул в Unreal Engine и прикрепил примитивную анимацию и вращение.

3D модели запчастей делал (только передняя ходовка готова) Opus 5.5, пока у него лимит, GPT-6 Astra засунула это всё в анрил.

Может будет видео про это, а может нет.

MrGips • Про LLM / НАШ ЧАТ


Qwen 3.8 27B NVFP4 (Ninfer) тоже может в геймдев

Не без косяков конечно.

🔥 Запускал я это в DeepSeek Harness, который обработал 27,9 млн токенов. Сделал одну правку. Молотил около часа.
• 26,6 млн - контекст из KV/prefix cache
• 980 тыс. - новый вход
• 290 тыс. - output модели
• Cache Hit - 96%
• скорость генерации - около 125 tok/s

Промт на создание этого шедевра будет в комментариях.

MrGips • Про LLM / НАШ ЧАТ


Немного увлекся в Блендере с Opus'ом 5.5

А как вы проводите выходные?

MrGips • Про LLM / НАШ ЧАТ


Honda_Accord_CL.blend
21.1Мб
Honda Accord созданный Opus 5.5

В комментариях под последним видео люди просили посмотреть сетку творения от Opus'а.

Если не лень, пишите отзыв в комментарии.

MrGips • Про LLM / НАШ ЧАТ


Видео недоступно для предпросмотра
Смотреть в Telegram
Зачем платить за Photoshop, когда его можно просто навайбкодить?

Увидел на реддите пост, где разработчик представил Photon Studio - бесплатный графический редактор для Windows и macOS, который он создал с помощью GPT-6 Astra.

Изначально автор просто хотел избавиться от подписки Adobe и сделать собственную альтернативу Photoshop. Но проект быстро вырос в полноценное приложение.

💰 Первоначальные расходы на ИИ составили около $2000. Позже сумма значительно выросла, но проект уже преодолел отметку в 20 000 пользователей!

Разработчик утверждает, что реализовал около 99% функциональности Photoshop. Впрочем, пользователи пока находят ошибки, а полная совместимость с Photoshop ещё не подтверждена.

🚀 И на этом автор останавливаться не собирается!
В планах создание собственных аналогов Illustrator, After Effects, Premiere Pro и Lightroom.

Плохо что он не опубликовал исходники на github. Мы бы оценили. А так понаблюдаем просто.

MrGips • Про LLM / НАШ ЧАТ

1.3k 0 21 27 28
Показано 20 последних публикаций.