


Репост из: Системный Аналитик
Масштабирование БД. Партиционирование, шардирование и репликация
⚡️Максимально кратко
💩Партиционирование — разделение БД на части в рамках одного сервера. Может быть вертикальным (по столбцам) и горизонтальным (по строкам)
💩Шардирование — разделение БД на части по разным серверам. Может быть только горизонтальным (по строкам)
💩Репликация — копирование одних и тех же данных между разными серверами
💩Партиционирование
Партиционирование — разделение большой таблицы на несколько частей. Все части хранятся на одном сервере. Бывает горизонтальным и вертикальным.
1⃣ Горизонтальное партиционирование: данные разбиваются на несколько отдельных таблиц по строкам. Каждая такая таблица содержит содержит одинаковые столбцы, но разные строки данных.
Преимущества:
➕уменьшение объема данных, которые нужно обрабатывать при выполнении запросов
➕ускорение выполнения запросов, которые затрагивают только определенный диапазон строк
➕возможность распараллеливания запросов между подтаблицами
Пример: разделение таблицы заказов по дате заказа, так что каждая подтаблица содержит заказы за определенный месяц или год.
2⃣ Вертикальное партиционирование: данные разбиваются на несколько отдельных таблиц по столбцам. Каждая такая таблица содержит часть столбцов и все связанные с ними строки данных.
Преимущества:
➕уменьшение объема данных, которые нужно загружать в память при выполнении запросов
➕ускорение выполнения запросов, которые затрагивают только определенный набор столбцов
➕возможность оптимизации хранения данных в зависимости от типа и частоты использования столбцов.
Пример: разделение таблицы пользователей на две подтаблицы, одна из которых содержит основную информацию о пользователях, а другая — доп. информацию
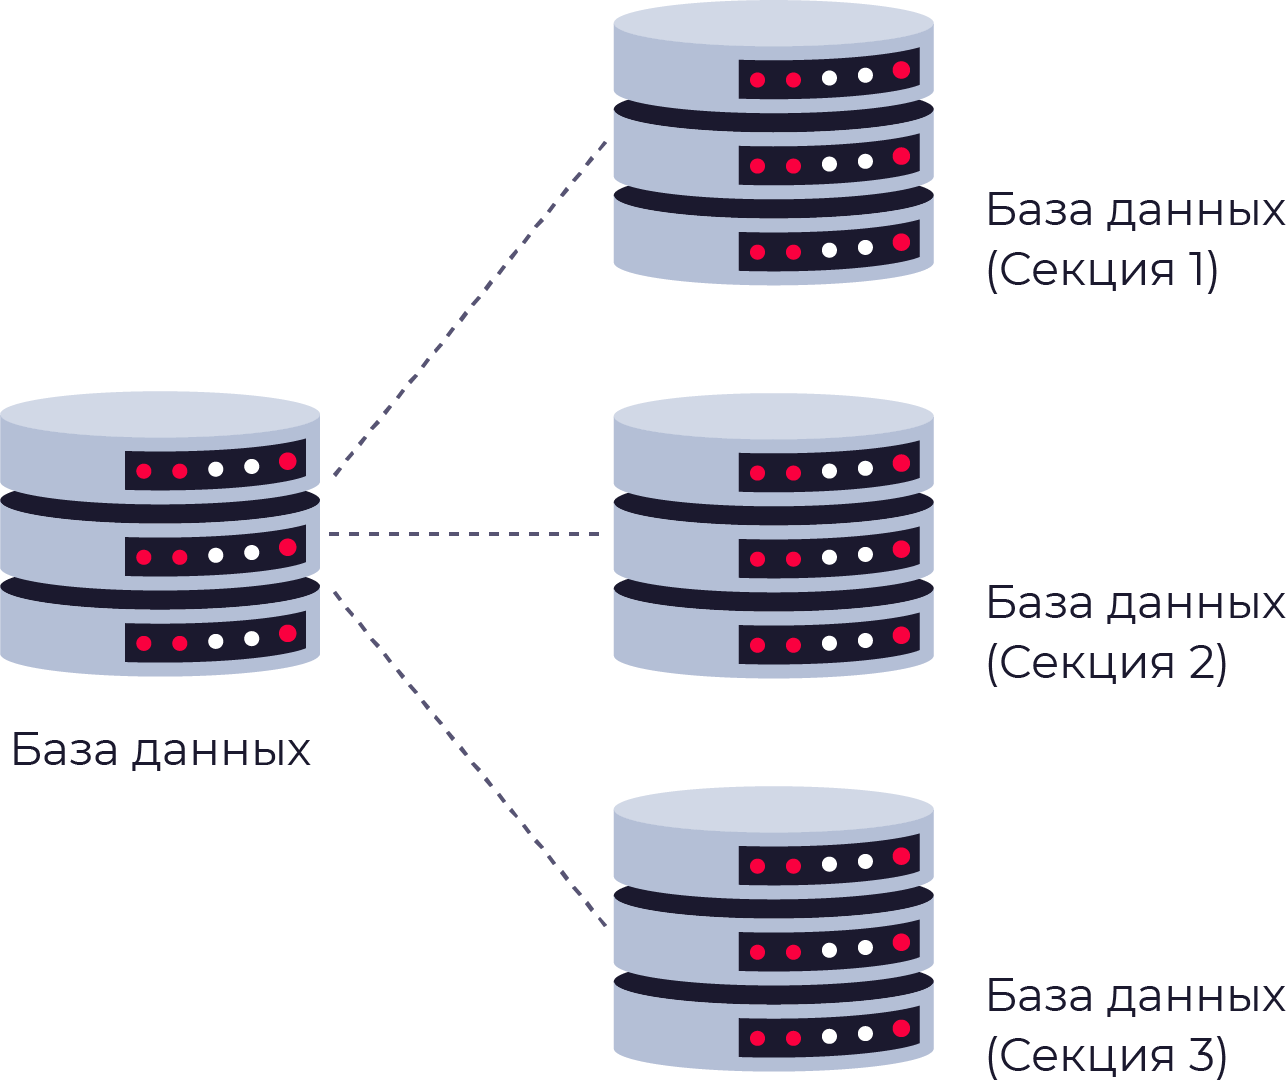
💩Шардирование — техника масштабирования БД, когда данные разносятся по нескольким машинам. Бывает только горизонтальным (по строкам). Шардирование позволяет распределить нагрузку на запись и чтение данных между различными серверами, за каждый из которых отвечает отдельная машина
Пример: есть БД пользователей. Чтобы ослабить нагрузку на сервер, разработчики горизонтально делят ее по шардам, используя хеш-функцию для определения, в какой шард отправить каждую запись. В результате пользователи будут равномерно распределены по серверам
Методы шардирования
1. Хешированное — данные разбиваются на шарды на основе хеш-функции, которая принимает входные данные и возвращает хеш-значение. Это значение определяет, в какой шард будет помещена каждая запись данных. Метод позволяет достичь высокой производительности и отсутствия единой точки отказа, однако усложняет поиск данных
2. Диапазонное — данные разбиваются на шарды на основе диапазона значений. Значения могут присваиваться с помощью ключей и других атрибутов. Метод прост в реализации и позволяет быстрее находить информацию, чем при хешировании, однако может привести к несбалансированности базы
3. Круговое — шарды упорядочиваются в виде кольца и каждый из них ответственен за определенный диапазон значений. Запросы на данные маршрутизируются в соответствии с позицией шарда в кольце. Запросы распределяются равномерно, но при добавлении и удалении шардов требуется перераспределение данных
4. Динамическое — позволяет автоматически масштабировать хранилище в зависимости от текущей производительности и объема данных. Нужна система мониторинга и балансировки нагрузки
💩Репликация
Репликация — копирование данных между несколькими серверами. При использовании такого метода выделяют два типа серверов: master и slave. Мастер используется для записи или изменения информации, слейвы — для копирования информации с мастера и её чтения. Чаще используется один мастер и несколько слейвов, т. к. обычно запросов на чтение больше, чем запросов на изменение
Преимущество: большое количество копий данных. Если мастер выходит из строя, любой другой сервер сможет его заменить
Недостатки: рассинхронизация и задержки при передаче данных. Репликация используется как средство обеспечения отказоустойчивости вместе с другими методами
⭐️ Подборка материалов доступна в базе знаний по системному анализу
#бд
⚡️Максимально кратко
💩Партиционирование — разделение БД на части в рамках одного сервера. Может быть вертикальным (по столбцам) и горизонтальным (по строкам)
💩Шардирование — разделение БД на части по разным серверам. Может быть только горизонтальным (по строкам)
💩Репликация — копирование одних и тех же данных между разными серверами
💩Партиционирование
Партиционирование — разделение большой таблицы на несколько частей. Все части хранятся на одном сервере. Бывает горизонтальным и вертикальным.
1⃣ Горизонтальное партиционирование: данные разбиваются на несколько отдельных таблиц по строкам. Каждая такая таблица содержит содержит одинаковые столбцы, но разные строки данных.
Преимущества:
➕уменьшение объема данных, которые нужно обрабатывать при выполнении запросов
➕ускорение выполнения запросов, которые затрагивают только определенный диапазон строк
➕возможность распараллеливания запросов между подтаблицами
Пример: разделение таблицы заказов по дате заказа, так что каждая подтаблица содержит заказы за определенный месяц или год.
2⃣ Вертикальное партиционирование: данные разбиваются на несколько отдельных таблиц по столбцам. Каждая такая таблица содержит часть столбцов и все связанные с ними строки данных.
Преимущества:
➕уменьшение объема данных, которые нужно загружать в память при выполнении запросов
➕ускорение выполнения запросов, которые затрагивают только определенный набор столбцов
➕возможность оптимизации хранения данных в зависимости от типа и частоты использования столбцов.
Пример: разделение таблицы пользователей на две подтаблицы, одна из которых содержит основную информацию о пользователях, а другая — доп. информацию
💩Шардирование — техника масштабирования БД, когда данные разносятся по нескольким машинам. Бывает только горизонтальным (по строкам). Шардирование позволяет распределить нагрузку на запись и чтение данных между различными серверами, за каждый из которых отвечает отдельная машина
Пример: есть БД пользователей. Чтобы ослабить нагрузку на сервер, разработчики горизонтально делят ее по шардам, используя хеш-функцию для определения, в какой шард отправить каждую запись. В результате пользователи будут равномерно распределены по серверам
Методы шардирования
1. Хешированное — данные разбиваются на шарды на основе хеш-функции, которая принимает входные данные и возвращает хеш-значение. Это значение определяет, в какой шард будет помещена каждая запись данных. Метод позволяет достичь высокой производительности и отсутствия единой точки отказа, однако усложняет поиск данных
2. Диапазонное — данные разбиваются на шарды на основе диапазона значений. Значения могут присваиваться с помощью ключей и других атрибутов. Метод прост в реализации и позволяет быстрее находить информацию, чем при хешировании, однако может привести к несбалансированности базы
3. Круговое — шарды упорядочиваются в виде кольца и каждый из них ответственен за определенный диапазон значений. Запросы на данные маршрутизируются в соответствии с позицией шарда в кольце. Запросы распределяются равномерно, но при добавлении и удалении шардов требуется перераспределение данных
4. Динамическое — позволяет автоматически масштабировать хранилище в зависимости от текущей производительности и объема данных. Нужна система мониторинга и балансировки нагрузки
💩Репликация
Репликация — копирование данных между несколькими серверами. При использовании такого метода выделяют два типа серверов: master и slave. Мастер используется для записи или изменения информации, слейвы — для копирования информации с мастера и её чтения. Чаще используется один мастер и несколько слейвов, т. к. обычно запросов на чтение больше, чем запросов на изменение
Преимущество: большое количество копий данных. Если мастер выходит из строя, любой другой сервер сможет его заменить
Недостатки: рассинхронизация и задержки при передаче данных. Репликация используется как средство обеспечения отказоустойчивости вместе с другими методами
⭐️ Подборка материалов доступна в базе знаний по системному анализу
#бд