


💪 Насколько ИИ уже приблизился к способности улучшать самого себя?
Группа из 33 исследователей представила работу с провокационным названием The Last AI Built by Humans — «Последний ИИ, построенный людьми». Авторы предлагают оценивать системы не только по числу решённых задач, но и по тому, какую часть собственного развития они способны контролировать.
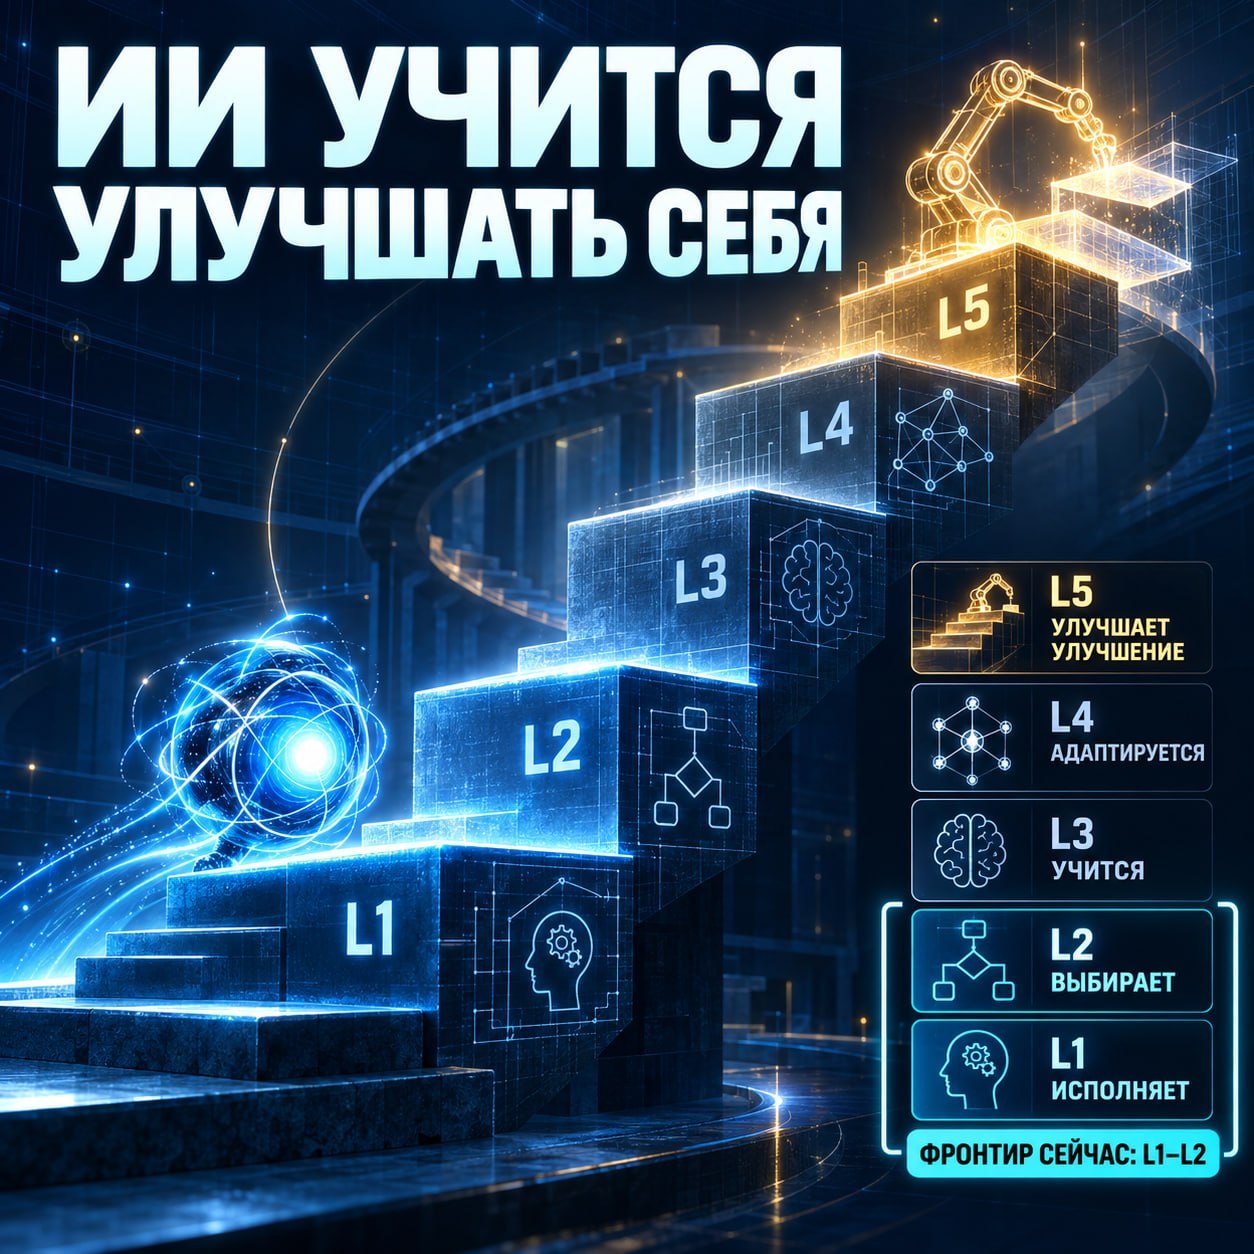
Получилась пятиуровневая шкала, напоминающая классификацию автопилотов SAE:
➡️ L1 - исполняет улучшение. Люди решают, что и как изменить, а ИИ выполняет процедуру: например, фильтрует данные или проводит заданные тесты.
➡️ L2 - выбирает способ улучшения. Цель и критерии успеха задаёт человек, но система сама находит слабое место, предлагает изменения и проверяет варианты.
➡️ L3 - выбирает, на чём учиться дальше. ИИ определяет, каких данных или экспериментов ему не хватает, и формирует собственную программу практики.
➡️ L4 - изменяется на основе реального опыта. Система анализирует результаты работы после внедрения и сохраняет полезные правила, инструменты или навыки для следующих задач.
➡️ L5 - улучшает сам механизм улучшения. Объектом оптимизации становится уже не только модель, но и процедура, которая придумывает, проверяет и отбирает следующие обновления.
Есть ещё уровень 0: модель может исправлять текущий ответ, спорить сама с собой или переписывать код, но после завершения задачи ничего не наследует. Это ещё не самоулучшение — изменился результат, а не система.
Где мы сейчас?
По оценке авторов, основная масса практических систем находится на L1–L2. ИИ уже может выполнять длинные циклы разработки, диагностировать ошибки, менять промпты, инструменты и агентную обвязку. Но люди по-прежнему задают цель, строят среду, определяют критерий успеха и решают, выпускать ли обновление.
Отдельные прототипы демонстрируют элементы L3 и L4: создают себе тренировочные задачи, накапливают опыт между запусками и перестраивают рабочие процессы по журналам ошибок. Однако авторы называют L2 сильнейшим устойчиво продемонстрированным уровнем; кандидаты на L5 пока не равны доказанной автономной рекурсии.
Какими ещё линейками измеряют развитие ИИ?
🌟 METR Time Horizon показывает сложность задач, которые агент выполняет с заданной вероятностью, переводя её во время, необходимое человеку. Это хорошая мера длительной автономной работы, но главным образом в программировании, ML и кибербезопасности; METR предупреждает, что текущие оценки свыше 16 часов пока ненадёжны.
🌟 RE-Bench и PaperBench проверяют способность вести ИИ-исследования: ставить эксперименты, оптимизировать модели и воспроизводить научные статьи. Они ближе всего к вопросу «может ли ИИ разрабатывать следующий ИИ», но измеряют результат отдельного проекта, а не наследуемый цикл самоулучшения.
🌟 Levels of AGI от Google DeepMind оценивает глубину и широту способностей: насколько система сильна и насколько универсальна. Новая шкала смотрит на другую ось — кто контролирует процесс её дальнейшего развития.
Ни одна линейка не показывает всю картину. Но вместе они задают три правильных вопроса: что ИИ умеет, как долго он способен действовать самостоятельно — и может ли он сохранить урок так, чтобы следующая версия стала лучше.
💬 Тест Тьюринга. События в сфере ИИ. Подписаться