


Ребятки учили Qwen 3.5 35B A3B молекулы дизайнить. Надеюсь молекулярные на месте
дальше от ллмки тк что именно за датасеты и фреймворки молекулярные и как они работают я не особо понимаю:
Как устроен процесс трена
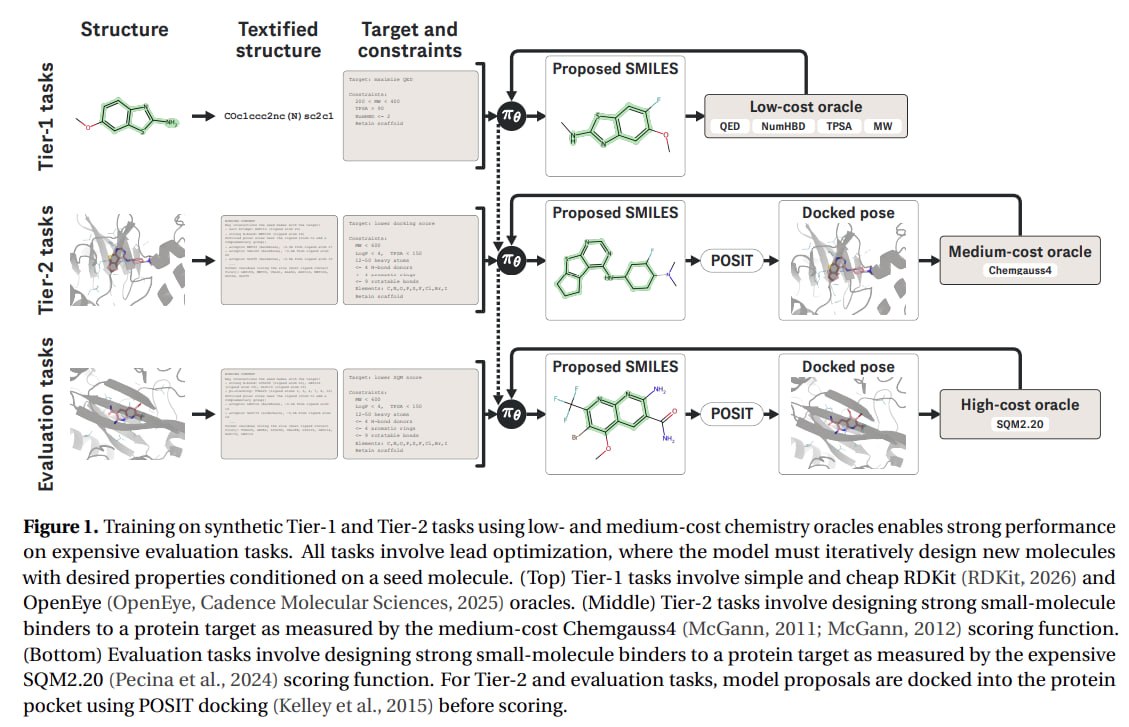
1. Создают 200k задач, которые относительно просто генерить на молекулах из ZINC. Из ZINC берут исходную молекулу, через RDKit и OpenEye считают 116 молекулярных свойств. Случайно выбирают одно свойство, которое нужно улучшить, ещё 2–4 превращают в ограничения, а через BRICS задают каркас молекулы, который должен сохраниться. Так автоматически получают задачи вида: увеличить QED, но удержать молекулярную массу и TPSA в заданных пределах и сохранить исходный каркас. В статье публичную реализацию их генератора задач не дают.
2. Qwen сама генерирует новую молекулу. Модель получает исходную молекулу + цель + ограничения и предлагает новый SMILES. Затем через инструменты проверяет, что получилось, меняет структуру и повторяет. То есть ЛЛМ — генератор, а RDKit/OpenEye здесь играют роль верификатора.
3. После этого переходят к реальным экспериментально определённым структурам белок–лиганд. Для второго этапа берут 999 комплексов из PLINDER. Информацию о кармане связывания переводят в текст: какие водородные связи уже есть, где есть стерические столкновения, какие полярные участки свободны, какие аминокислотные остатки окружают лиганд. LLM уже редизайнит молекулу с учётом конкретного кармана белка. В статье публичную реализацию этого преобразования 3D-структуры в текст тоже не дают.
4. Каждый перспективный SMILES проверяется в 3D. POSIT размещает новую молекулу в кармане белка, используя экспериментальное положение исходного лиганда как шаблон. Затем Chemgauss4 быстро оценивает получившуюся форма. Оценка возвращается обратно LLM, и она решает, как изменить следующую молекулу. Этот дорогой оценщик можно вызвать максимум пять раз за один цикл — модель должна научиться не тупо перебирать варианты, а выбирать, что действительно стоит проверять.
5. Весь этот агентный цикл обучают через RL. Для этого используется открытый prime-rl: одни процессы генерируют цепочки действий модели, обучающий процесс параллельно обновляет её веса. Награда учитывает улучшение целевой характеристики, соблюдение ограничений, валидность молекулы и количество вызовов инструментов. На Tier-1 целью является одно из молекулярных свойств, а на Tier-2 — улучшение предсказанного связывания с белком. Сначала RL идёт на дешёвом Tier-1, затем — на более дорогом Tier-2.
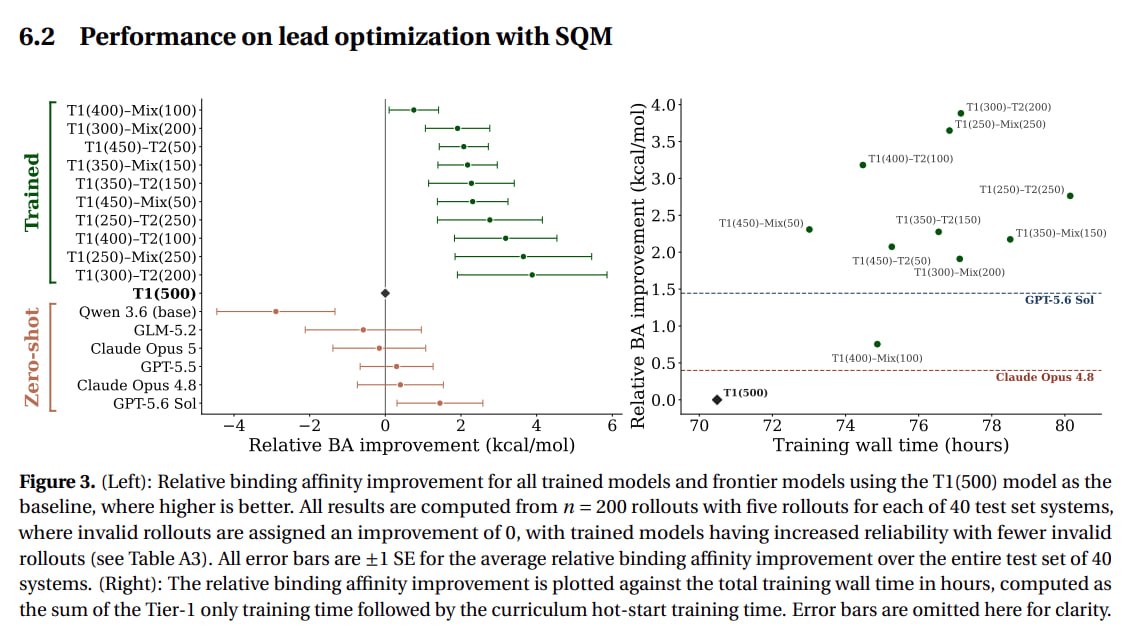
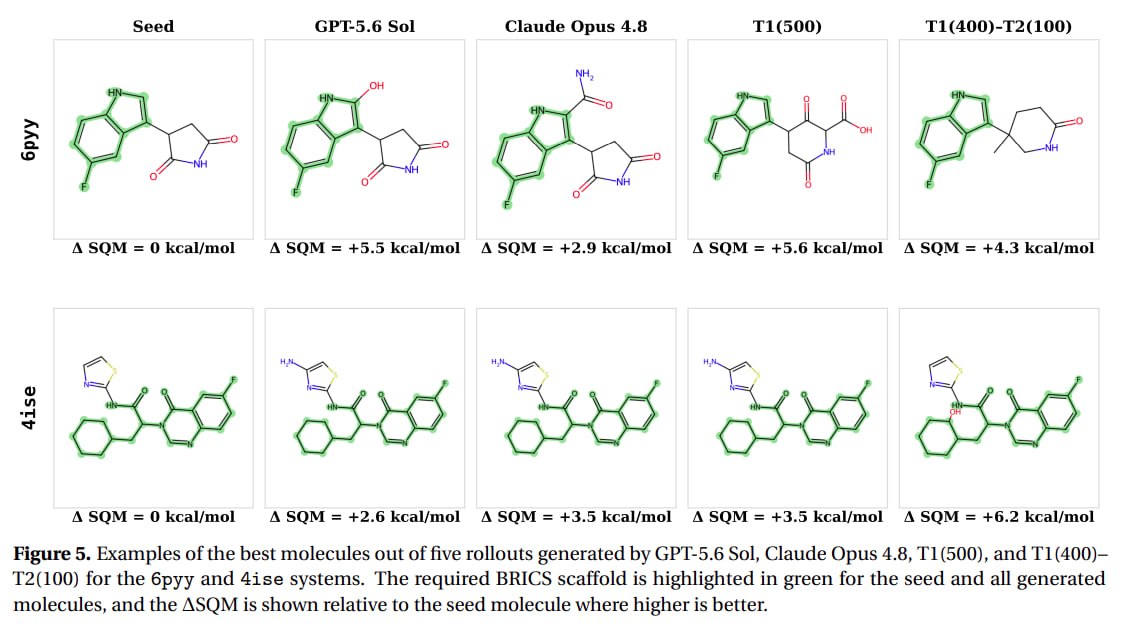
В конце модель проверяют на 40 новых системах белок–лиганд, которых не было в обучении. Вместо Chemgauss4 используют SQM2.20 — более дорогой и физически детальный метод оценки связывания на основе полуэмпирической квантовой механики. Один такой расчёт занимает уже десятки минут, поэтому масштабировать RL напрямую на нём слишком дорого. Именно здесь проверяют, перенёсся ли навык, выученный на дешёвых упрощённых задачах, на более качественный оценщик. Tier-2 берут из официального train split PLINDER, а эти 40 систем — из test split, чтобы не было утечки между train и evaluation.
Training Large Language Models for Small-Molecule Design with Synthetic Task Scaling
https://arxiv.org/abs/2609.04735
https://www.alphaxiv.org/ru/abs/2609.04735