Ivan Oseledets’ Channel


Channel's geo and language: Russia, Russian
Category: Education


Личный канал доктора физико-математических наук, профессора РАН, генерального директора AIRI, декана ФИИ МГУ Ивана Оселедца.
Для связи: brand@airi.net

Related channels  |  Similar channels

Channel's geo and language
Russia, Russian
Category
Education
Statistics
Posts filter


Ещё не написал свою книгу, а уже получил литературную премию, приятно.

1.7k 0 20 4 141

Forward from: Ars Poetica Numeralis
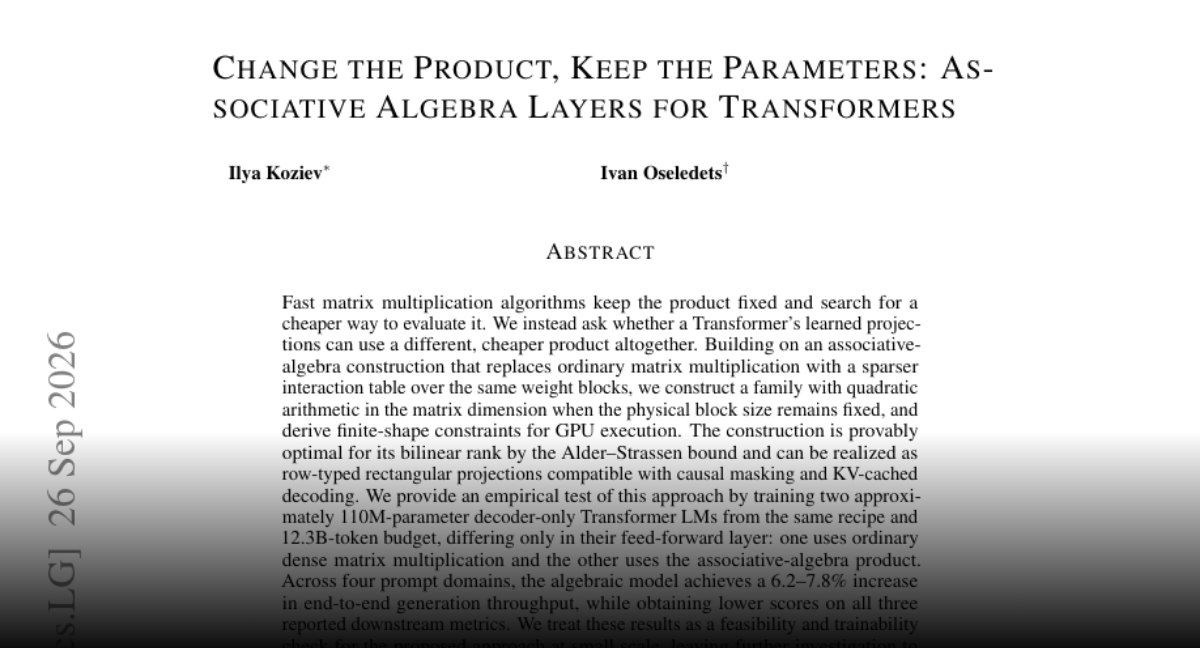
Наш препринт про архитектурную модификацию трансформера:

https://huggingface.co/papers/2609.32814
Change the Product, Keep the Parameters: Associative Algebra Layers for Transformers

tl/dr

Исследуем замену GEMM в MLP-слое трансформера на более лёгкую операцию, которая сохраняет билинейность и ассоциативность матричного умножения, но требует меньше вычислений при том же количестве обучаемых параметров.

Лонгрид

Работа состоит из трёх частей.

Часть первая: математическая база

Описывается новый оператор, заменяющий обычное матричное умножение. Формально доказывается, что он билинеен и ассоциативен.

Для оператора над матрицами размера q×q вычисляется билинейный ранг — минимальное число скалярных умножений, необходимых для его вычисления. Для q=2 новый оператор имеет ранг 6. Для сравнения, обычное умножение 2×2 требует 8 умножений, а алгоритм Страссена — 7. Эти числа всплывут в третьей части 👇

Билинейность позволяет заменить линейную проекцию трансформера, не вводя дополнительную нелинейность, а также даёт возможность формально анализировать вычислительную стоимость оператора.

При этом мы не уменьшаем число параметров и не используем sparsity или low-rank compression: сохраняется полный набор обучаемых весов, меняется только закон их умножения на активации.

Часть вторая: синтетические экспы на GPU

Показываем, что реализация нового оператора действительно может использоваться вместо GEMM в качестве линейной проекции трансформера. Приводятся оценки эффективности для нескольких архитектур, включая Qwen и DeepSeek.

Часть третья: оценка end-to-end на декодерной LM

Создаётся небольшая декодерная LM ёмкостью 110M параметров, близкая к GPT-2, но с небольшими модификациями (SwiGLU вместо стандартного FFN) и GPT-2-токенизатором.

Делаем два варианта модели: с классическим GEMM и с новым оператором в MLP. Обе модели обучаются на одном и том же инструктивном датасете с бюджетом около 12.3B токенов и в одинаковом вычислительном окружении.

Эксперимент показывает, что новый оператор остаётся обучаемым в реальных условиях, включая CUDA, floating-point вычисления и автоматическое дифференцирование в PyTorch.
Затем измеряем скорость инференса и качество на downstream-задачах через lm-eval-harness.
Для q=2 модель с новым оператором показывает прирост end-to-end throughput примерно на 7%. Для сравнения, переход от rank-7 алгоритма Страссена к rank-6 оператору сокращает число скалярных умножений примерно на 14.3%. Наблюдаемый выигрыш оказывается примерно вдвое меньше этого арифметического выигрыша, что ожидаемо: MLP составляет лишь часть вычислений модели, а итоговое время также определяется attention, LM head, memory traffic, sampling и другими операциями.

Что дальше: много экспов с другими параметрами (q=3 и 4), настройка ядер и пр. 🤗

👉 hf dailypapers link 👈


Мне крайне приятна статья, хотя и сложная

Forward from: Институт AIRI
Объединяем исследователей для обучения ИИ долгосрочному планированию

Владислав Куренков, руководитель научной группы «Адаптивные агенты» Института AIRI, запустил открытое сообщество людей, работающих над системами планирования ИИ, чтобы вместе решить одну из самых неподатливых для искусственного интеллекта игр — NetHack.

У каждого участника будет свой способ получить программу, свои инструменты и своя стратегия, а общая инфраструктура позволит видеть результаты друг друга, сравнивать их между собой и продолжать разрабатывать решения друг друга.

Владислав рассказал, почему NetHack весьма полезна для обучения ИИ:
«Одна партия в NetHack — это десятки тысяч ходов. Жизнь у героя одна, сохранений нет, подземелье каждый раз новое, а игра по дороге ничего не подсказывает. Если вы сыграли плохо, то выясняется это тогда, когда ничего исправить уже нельзя. Когда мы запускаем наших ботов играть, то вторая по частоте причина их "смерти" — голод, потому что они не позаботились о еде за несколько тысяч ходов до финального момента. На таких же ошибках спотыкаются ИИ-агенты, когда пишут код: отдельный шаг они выполняют прекрасно, а на длинную дистанцию держать планку не могут. И NetHack в этом плане становится весьма полезной для обучения ИИ».


📎Подробнее про сообщество, игру и «интеллект» агента — в интервью «Ъ-Науке».


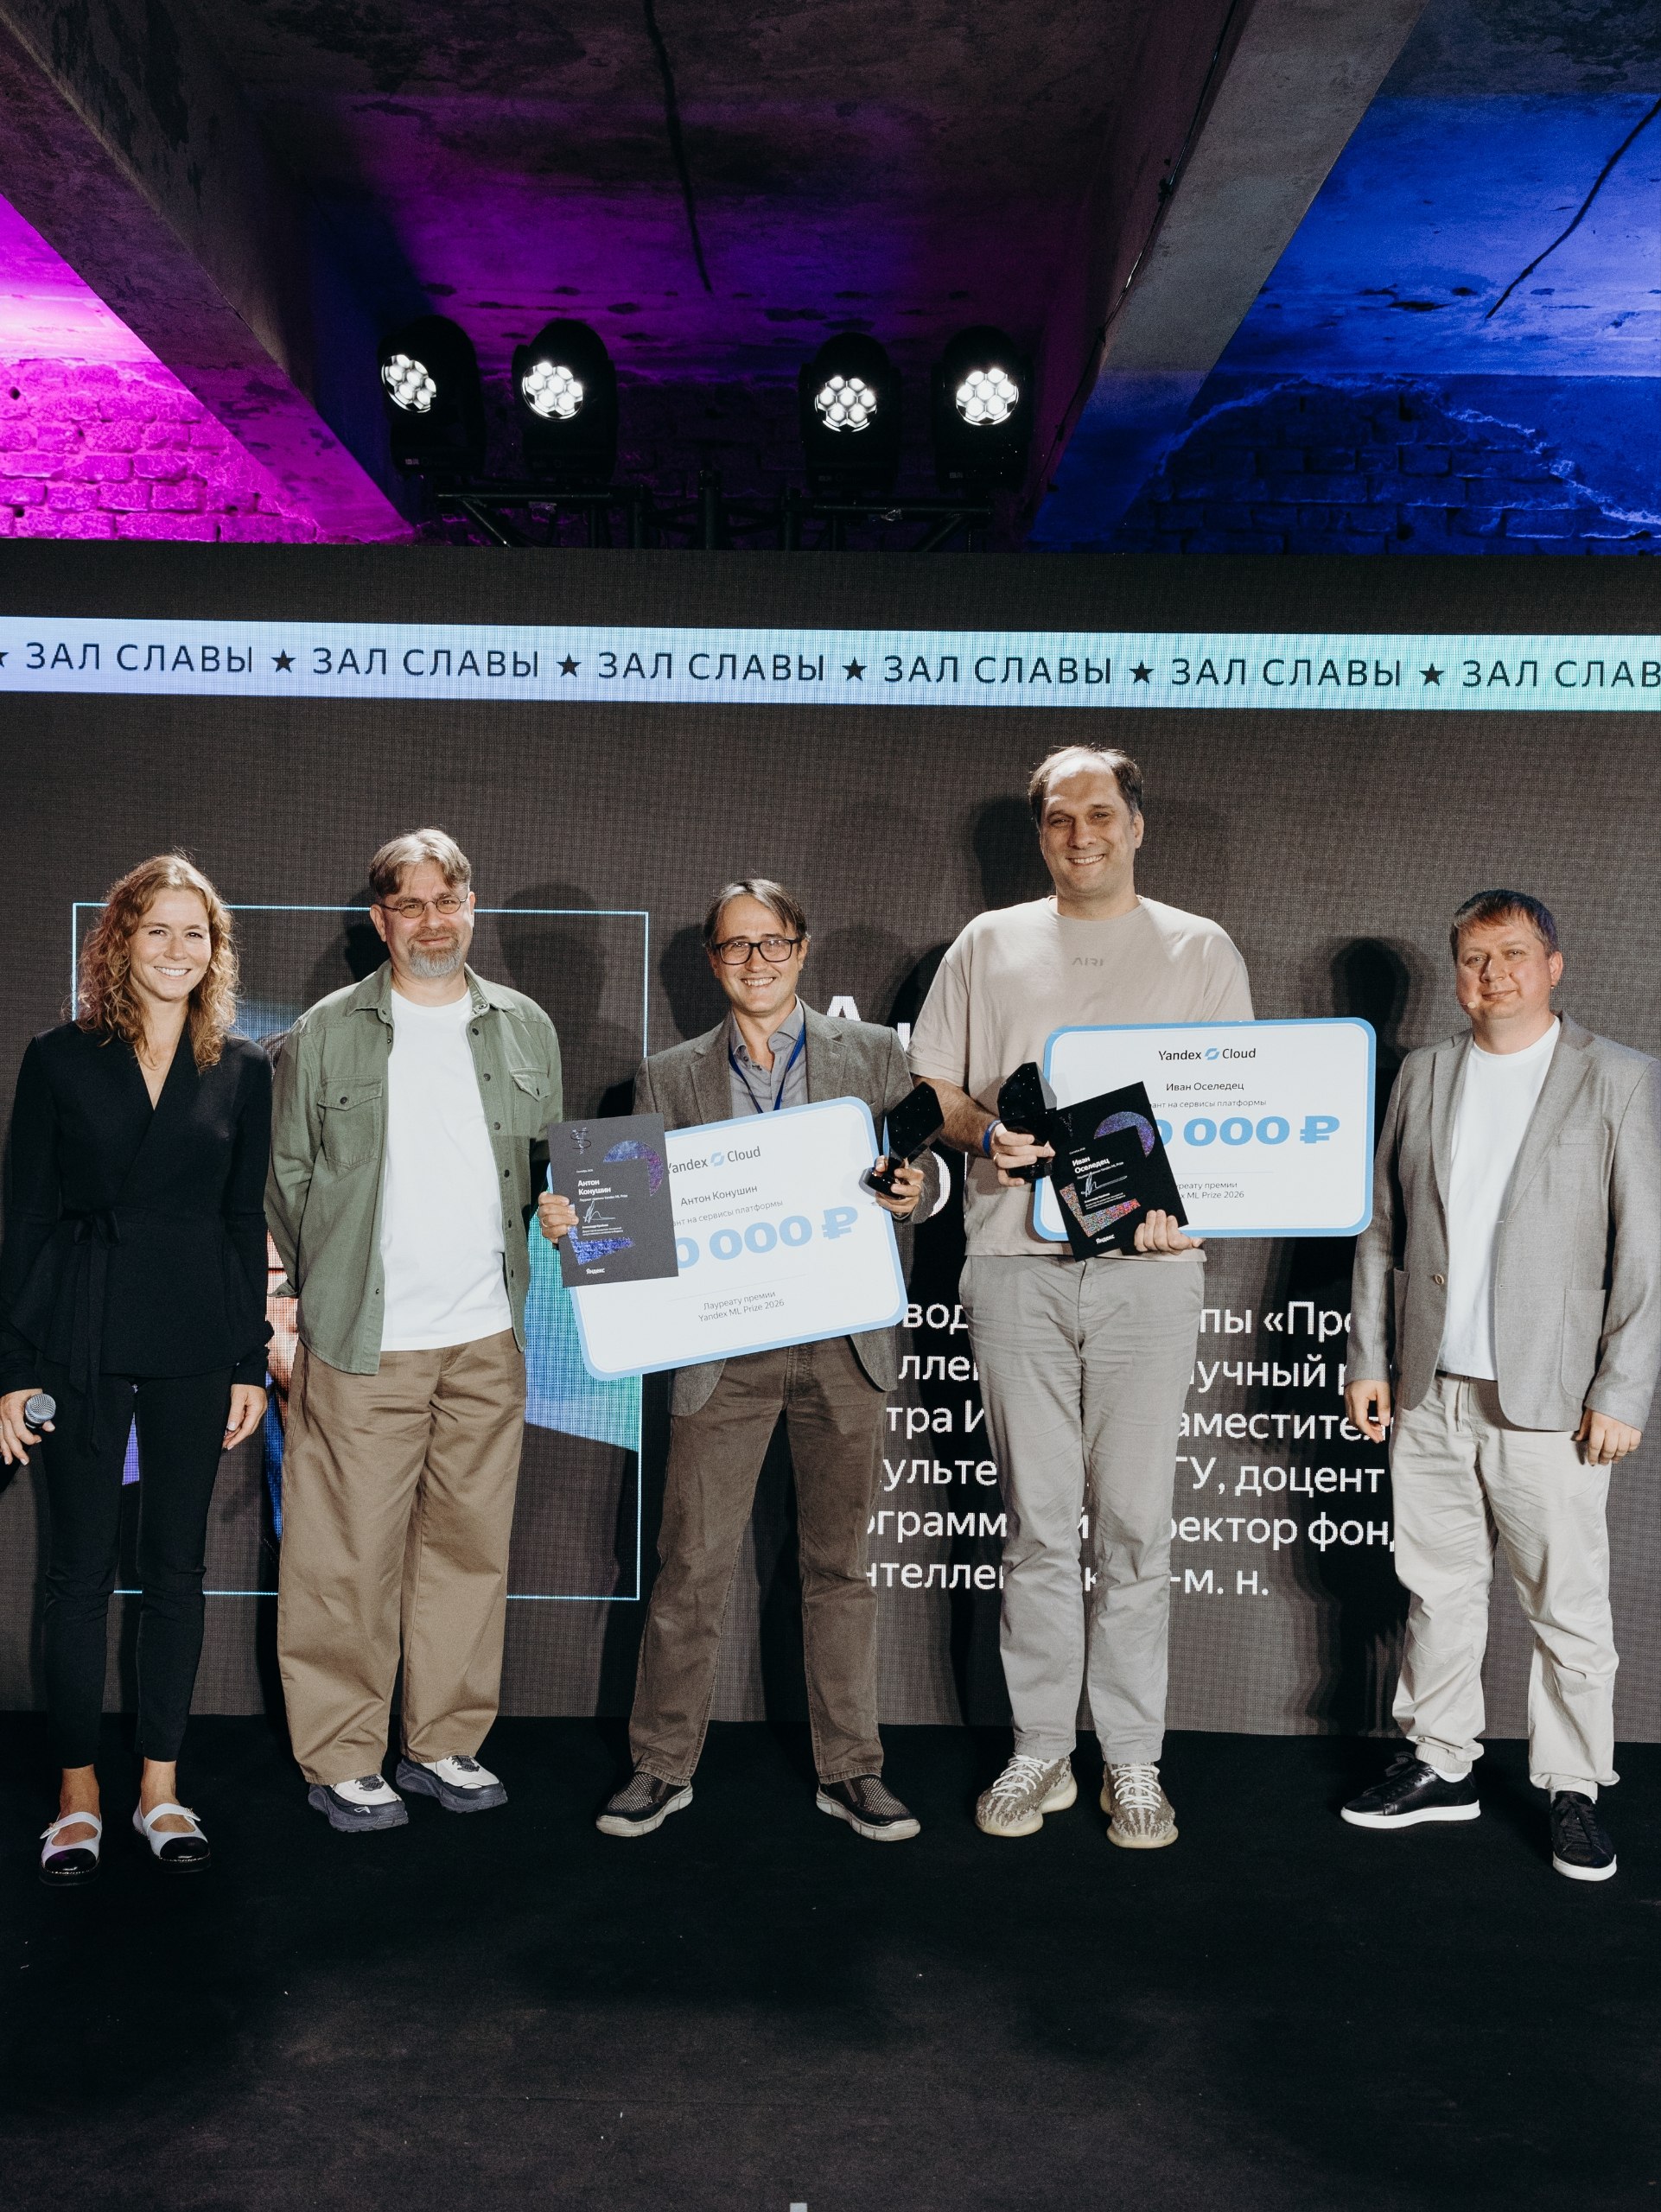
Вчера ездил на Practical ML Conf — там мне и Антону Конушину, с которым мы вместе двигаем AIRI и ФИИ МГУ, вручили Yandex ML Prize. Отметили в «Зале славы» — пишут, что это про тех, кто меняет образование, науку и технологии, вдохновляет новые поколения.

В номинации «Начинающие преподаватели» выиграли наши младшие научные сотрудники Альбина Бурлова и Константин Пчелин.

Здорово, когда твою работу и работу твоей команды видят и признают — спасибо коллегам. Продолжим развиваться в том же направлении.

4.4k 0 33 4 136

Решение проблемы тысячелетия про задачу Навье-Стокса - очень круто!

https://nplus1.ru/material/2026/09/09/openai-x-navier-stokes


Forward from: Факультет искусственного интеллекта МГУ
📆 Все перевернули календарь?

Под костры рябин возвращаемся в 28 августа – вспоминаем, как прошел наш разогрев перед учебой. Фото и видео – в галерее.

Благодарим за поддержку фонд Олега Дерипаска «Вольное дело» и фонд «Интеллект».


ФИИ стартовал


Forward from: ген ИИ
Video is unavailable for watching
Show in Telegram
ИИ делает нас умнее. Или все-таки нет?

Друзья, специально к Дню знаний мы выложили новую серию подкаста 2TOK об ИИ в образовании и науке.

Он уже доступен на YouTube и VK Видео.

В гостях Андрей Себрант, директор по стратегическому маркетингу Яндекса и профессор ИТМО, и Иван Оселедец, гендиректор Института искусственного интеллекта AIRI и декан факультета ИИ МГУ.

С одной стороны ИИ можно использовать как экзоскелет для мозга: он подхватывает усилия, забирает рутину, помогает сделать больше и быстрее, но направление движения все равно определяет человек.

С другой стороны можно превратить его в «инвалидное кресло» для мышления: отдать модели домашку, диплом, презентацию и даже не пытаться вычитать и понять результат.

Выбор остается за человеком.

Что обсудили:

• Проблема домашек не появилась вместе с ChatGPT. До нейросетей школьники искали ГДЗ. Если задание воспринимается как бессмысленное заполнение времени, ученик все равно найдёт кратчайший путь. Запретить ИИ здесь проще, чем разобраться с мотивацией и способом оценки знаний, но вряд ли полезнее.

• Учить «правильным промптам» поздно уже в момент подготовки программы. Технология меняется быстрее учебников. Профессия промпт-инженера, которую в 2023 году объявляли профессией будущего, быстро растворилась в обычном умении работать с моделями. Нужнее навык постоянно переучиваться и спрашивать у агента, как лучше решить конкретную задачу.

• Нейрослоп становится новой формой профессиональной небрежности. Нажать «сделай презентацию» и принести 20 аккуратных слайдов ещё не значит выполнить работу. Бывает так, что презентацию сократили вручную с 18 до 6 слайдов и вычитали, а после очередного прогона через нейросеть она вернулась уже на 21 слайде. Модель ускоряет производство текста, но не берет на себя смысл, вкус и ответственность.

• В науке ИИ уже работает как соавтор. Агент подбирает 50–100 работ, резюмирует их и отмечает фрагменты для самостоятельного чтения. То, что раньше занимало две недели, теперь укладывается в день. Еще интересный пример: студентка за трёхчасовой семинар вместе с Claude сформулировала гипотезу, написала код и подготовила работу, которую затем приняли на конференцию.

В подкасте мы ставим неудобный вопрос перед школами, ВУЗами и нами самими: если модель умеет написать типовую домашку, диплом или научную статью, что именно мы теперь должны считать результатом обучения и работы?

Для меня ответ такой: ценность сейчас смещается от производства текста к постановке задачи, проверке, пониманию и личному суждению. ИИ может сделать нас заметно сильнее. Но когнитивную мышцу, которую перестали напрягать, никакой экзоскелет уже не спасет.


Смотрите новый подкаст, оставляйте комментарии. Ну и скажите, для вас ИИ скорее «экзоскелет для мозга» или «инвалидное кресло»?

#2TOK

💬 ген ии | MAX


Forward from: Институт AIRI
«Лето с AIRI 2026» не заканчивается! Делимся лекциями и семинарами ⏯

Мы записали всё, о чём на протяжении двух недель говорили исследователи и эксперты на летней школе. Собрали целый багаж знаний — 76 видео! — из разных областей ИИ и делимся им с вами, чтобы все могли послушать и узнать для себя что-то новое и интересное.

📎Сохраняйте ссылки на плейлисты: VK Видео, YouTube — и пересылайте их тем, кому тоже может быть полезно)


Forward from: Москва главное
🫪 Конкурс на новый факультет искусственного интеллекта МГУ составил 127 человек на место


Команда Антона Конушина и лаборатория Fusion Brain вместе с  ребятами Сергея Маркова и Игоря Пасечника из SberAI опубликовали крутое обновление в нашей линейке моделей для реверс-инжиниринга!

CADENA: Stepwise CAD Reverse Engineering

Перешли на пошаговое предсказание — модель стала гибче, качество выросло, и чем сложнее датасет, тем больше отрыв. Плюс собрали CADENA-Bench: 3396 реальных механических деталей, разбитых по категориям ЕСКД, чтобы можно было оценивать готовность к практике для отдельных типов деталей.

О постановке задачи для тех, кто пока про нее не слышал: по скану физической детали восстановить её CAD-модель — дерево построений, которое инженер может править и по которому деталь можно произвести. Последовательность CAD-операций пишется питоновским кодом, так что фактически это mesh2code.

Наши прошлые модели предсказывали всю последовательность разом и потому наследовали статистику трейна: если операция B в обучении всегда стоит между A и C, на инференсе она встанет туда же. На сложных и редких деталях это ломалось. В CADENA мы предсказываем по одной операции за раз — модель исполняет то, что уже написала, смотрит на разницу с целью и решает, что делать дальше. Плюс новый генератор, дающий длинные последовательности операций.

Результат: заметный отрыв на всех датасетах, где мы замеряемся. На CADENA-Bench мы лучше в 5 категориях из 6 и в среднем. На BenchCAD, где свои модели меряет в том числе Claude, восстановление объёма 91% против 71% у фронтирных моделей и 75% у специализированных.

На гифке — как модель собирает деталь по операциям.

Paper: https://arxiv.org/abs/2608.00799 · https://huggingface.co/papers/2608.00799

GitHub: https://github.com/zhemdi/cadena

Dataset: https://huggingface.co/datasets/kulibinai/cadena-bench

Model: https://huggingface.co/kulibinai/cadena
Заапвоутить: https://huggingface.co/papers/2608.00799


В свой день рождения приехал в Екатеринбург. Второй раз за месяц.

Впрочем, Иннопром — одна из самых старых площадок, где помимо того, что поговорить, можно и плодотворно поработать.

Во-первых, мы подписали соглашение между AIRI, Сбером и УрФУ о создании лаборатории по ИИ в промышленности. Где, как не на Урале. Во-вторых, были полезные встречи, нашёл на стендах несколько интересных отечественных компаний.

Делюсь мыслями по итогам дискуссии об ИИ в промышленности. Если посмотреть, что сегодня делают лидеры рынка за рубежом, скажем, как Airbus начинают взаимодействовать с Mistral, что делает Anthropic, то становится очевидно: они идут в очень плотную, практически неразрывную связку с промышленностью. Потому что там находится следующий большой скачок в развитии искусственного интеллекта. Посадили программистов писать код, наблюдали, как они работают, где ошибаются и как исправляют свои ошибки. Это очень важная мысль. Самые ценные данные — это ошибки и процесс их исправления. Когда программисты писали код, ошибались, находили решение и исправляли его, Anthropic фактически записывал этот процесс. Именно благодаря этому появился Claude и именно поэтому компания смогла так далеко продвинуться. В промышленности должен работать такой же подход. Нужно не просто собирать данные, а пытаться решать действительно сложные инженерные задачи — примерно так, как их решает конструктор.

Есть компании, которые работают именно так. Они буквально отправляют инженера на предприятие и смотрят, что делают люди, как принимают решения, как обходят ограничения, где ошибаются и как выходят из сложных ситуаций. Нужно посадить человека рядом, чтобы он ходил, наблюдал и записывал. Без такого погружения практически невозможно понять, как на самом деле устроен процесс. Нужен человек со стороны, но при этом достаточно опытный, чтобы увидеть не только действия, но и логику принятия решений. Поэтому подход «давайте накопим данные за последние тридцать лет, а потом что-нибудь из них вытащим» не сработает.

Нужно цифровизировать экспертов. Цифровизировать способы принятия решений. И, что особенно важно, цифровизировать ошибки. Если построить такую систему, можно действительно кардинально ускорить развитие. Этим сегодня во многом занимается наука. Мы уже поняли, что сама языковая модель может быть не такой уж большой. Главное — всё, что находится вокруг неё: среда, инструменты, агенты. Способ действительно ускорить развитие — пустить таких помощников внутрь реальных процессов, дать им практически полный доступ и перестать бояться ошибок.

Ошибки будут. И это хорошо. Потому что именно на ошибках происходит обучение. На идеальных результатах новые знания практически не появляются. Науке критически нужны партнёрства с реальными производственными процессами. Без этого мы так и останемся либо писать код, либо работать в тех областях, где результат легко проверить. Хороший пример — кибербезопасность. Там сразу понятно: получилось взломать систему или нет. Поэтому туда так активно пошёл Anthropic. Но если мы действительно хотим ускорить производство, сократить сроки и снизить издержки — другого пути нет. Нужно перестать ставить перед собой безопасные задачи и начать формулировать невозможные цели.

Например, сделать какой-то процесс в два раза быстрее. Очень хороший пример — развитие мобильной связи. Нам нужны большие, амбициозные цели, которые требуют кардинального ускорения. Например, сегодня атомная электростанция у нас проектируется и строится около восьми лет, а в Китае аналогичные проекты реализуют примерно за четыре года.

Вот такая цель — понятная цель: сократить срок в два раза. И, возможно, мы все честно понимаем, что не достигнем этого в заявленные сроки, но если мы не поставим перед собой такие цели, то не достигнем их никогда.


Наши ребята продвинулись в решении одной 30-летней математической задачи (используя ИИ в процессе, конечно). Саму задачу придумал Е.Е. Тыртышников, мой научный руководитель и лауреат научной премии Сбера.

https://www.kommersant.ru/doc/8727455

3.8k 1 60 2 148

На прошлой неделе ездил в Питер, выступал на ПМЭФ. Был рад принять участие в нескольких сессиях, спасибо организаторам, модераторам и коллегам за интересные дискуссии. А записи трансляций есть по ссылкам.

1) «Люди для будущего индустрий в мире ИИ» — её организовал Сбер. Поговорили про образование. Рассказал про факультет искусственного интеллекта МГУ, деканом которого являюсь. Считаю, что сейчас на первый план выходит не умение запоминать знания, а реальные навыки и понимание, и на наших программах мы как раз будем учить, в первую очередь, думать и рассуждать.
https://forum-spb.ru/programme/innovation-space/157300/

2) Сессия Минобра «Доступные данные как общественное благо: институциональные условия для прорывных исследований и наукоёмкого предпринимательства в эпоху ИИ» — на ней поговорили, как сегодня корпорации могут участвовать в финансировании систематизации научных данных — что, на мой взгляд, крайне важно, — получая при этом измеримую коммерческую отдачу, и какие модели партнёрства государства и бизнеса здесь уже доказали свою эффективность.
https://vkvideo.ru/video-167915299_456241766

3) «AI First, но не AI Only: новая операционная система мира». Крайне увлекательная дискуссия, которую организовали Авито. Модерировала её, кстати, Ксения Собчак. Высказал мнение, что нам нужно не просто продолжать развивать ИИ и интегрировать его в разлиные процессы, но и делать это более радикально, потому что текущих темпов, на мой взгляд, недостаточно. Если бы мы с такой же осторожностью, как в вопросах, связанных с ИИ, подходили к другим технологиям, то у нас бы до сих пор не было бы, например, авиаперелётов, ведь вначале самолёты очень много падали. И в итоге если мы не будем выходить за пределы, скажем так, обучающей выборки, то у нас никогда не будет прогресса, а нам он нужен, поскольку у человечества есть ещё очень много нерешённых задач.
https://forum-spb.ru/programme/business-programme/156782/

4) В сессии Минздрава «Искусственный интеллект и здравоохранение: старт дан, как извлечь пользу?» обсудили сильный ИИ в медицине. В этой сфере, конечно, мы пока далековато от сильного ИИ, в отличие от той же научной деятельности или написания кода. Пока модели справляются с сопоставлением симптомов и диагнозов, но этого недостаточно: о сильном ИИ в медицине можно будет говорить тогда, когда он научится быстро и качественно помогать в разработке новых лекарств, связывать действительно сложные и редкие случаи заболеваний, уменьшать неопределённость в диагнозе.
https://forum-spb.ru/programme/business-programme/156653/

5) «ИИ в новых материалах: кто заберёт рынок» от Норникеля. Тут говорил о важности целеполагания и правильного подхода к сбору данных. Казалось бы, простая логика: надо заниматься такими материалами, которые наверняка будут синтезированы и полезны бизнесу. Однако большинство тех исследователей, кто занимается поиском новых материалов, делает это просто потому что им нравится. А бизнес при этом не хочет менять отлаженные процессы, если и так всё неплохо работает. Но если текущие процессы не приводят к существенному прогрессу, то их нужно менять. И учёным тоже нужно не бояться браться за сложные задачки. Иначе мы так и будем нуждаться в постройке дома, и при этом создавать только супер-топоры и продвинутые пилы, что в реальности не приведёт к прогрессу.
https://forum-spb.ru/programme/business-programme/156677/


Первый день ПМЭФ подходит к концу. Выпустили сегодня первую версию модели из нашего семейства Optimal Cognitive Core, OCC-RAG. Это компактная SLM для Q&A по контексту. Модель доступна в 2 размерах: 0.6B и 1.7B. Несмотря на маленькое число параметров обе уверенно отвечают на сложные multi-hop вопросы, рассуждают пошагово и корректно, отказываются отвечать, когда контекста недостаточно.

Как мы этого добились?

1. Сложные синтетические данные.

Открытые QA-датасеты, как правило, маленькие и не таргетируют задачу faithfulness. Модели учатся отвечать, но не всегда следовать контексту. Поэтому мы построили собственный пайплайн генерации данных: с помощью метода Wikontic (https://t.me/Ivan_Oseledets/283) извлекаем граф знаний из текстов и генерируем вопросы по путям в этом графе. Получаются по-настоящему сложные multi-hop задачи, где нужно объединить факты из нескольких источников, например: «В каком городе родился режиссёр фильма, получившего Оскар в год рождения Леонардо ДиКаприо?». Дополнительно пайплайн умеет генерировать вопросы, на которые в контексте нет ответа, чтобы отдельно учить модель отказываться.

В итоге наш метод позволяет генерировать данные из любых неструктурированных документов в почти неограниченном количестве!

2. Mid-training

В качестве базы взяли Qwen3-0.6B-Base и Qwen3-1.7B-Base и провели масштабный mid-training на пороядка 8 млрд токенов. Мы также дополнили данные специальным форматом рассуждения, который цитирует источники прямо в ответе. Это дополнительно повышает faithfulness.

Прогнали OCC-RAG на HotpotQA, MuSiQue и TAT-QA. Добавили ConFiQA, один из самых сложных бенчмарков на faithfulness, где модель должна следовать контексту, даже если он противоречит общеизвестным фактам.

Итого:

Качество на уровне моделей в 2–6 раз больше по размеру; на ConFiQA обходят даже Qwen3-32B; заметно лучше следуют контексту и реже подменяют его внутренними знаниями; среди специализированных малых QA-моделей (например, Pleias-RAG) показывают лучший результат.

Репорт на HuggingFace Daily Papers: https://huggingface.co/papers/2606.00683

Отмечу, что работа по согласованности, четкости и скорости в команде — эпичная. Продолжаем работать над улучшенной версией для tool-calling и Agentic RAG задач.

Ждите обновлений!

P.S. Не успел выйти с форума, уже увидел новости у ТАСС, РГ, в телеграм, Forbes, Код Дурова, много где. Радует, когда наши медиа следят за повесткой, реагируя не только на «что-то новое от Гугла».

Кстати, про значимость малых моделей сегодня как раз хорошо написал Андрей Себрант из Яндекса. Почитайте — https://www.forbes.ru/mneniya/562028-maly-da-udaly-pocemu-vazny-ii-modeli-kotorye-sovsem-ne-na-sluhu

7.4k 6 194 1 103
16 last posts shown.