this->notes.


Kanal geosi va tili: Rossiya, Ruscha


О разработке, архитектуре и C++.
Tags: #common, #cpp, #highload и другие можно найти поиском.
Задачки: #poll.
Мои публикации: #pub.
Автор и предложка: @vanyakhodor.
GitHub: dasfex.

Bog‘liq kanallar  |  O‘xshash kanallar

Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Фиксируем результаты.

Некоторые вещи мне не помогут писать посты. Но мне было интересно узнать, откуда у меня аудитория, например.

• География (>560).
РФ 65%, 11% Беларусь, несколько ожидаемых для меня стран одинакового размера (Сербия, Польша, UK по паре процентов). Чуть больше на остальную европу и столько же на остальной мир (по 8%).

• Род занятий (≈560).
86% разработчики. Ещё 5% — ML-enjoyers. В остальном либо очень мало, либо непонятно кто.

• Опыт (≈570).
Тут всё согласно нормальному распределению (что интересно, учитывая произвольность выбранных интервалов). Большинство (26%) 3-5 лет. По 20% на 1-3 и 5-10. По 14% на 20 лет.

Подтвердил ожидания.

Приятно, что вы разные: молодые неопытные и взрослые видавшие коллеги.

• Грейд (≈560).
8% не работают. Я надеюсь, это ваш осознанный выбор.
Столько же студентов/стажёров и джунов. 32% middle. 29% senior. Всё до этого момента выглядит ожидаемо.
6% подписчиков переросли senior (уважаемо, особенно если вы не просто себе лычку выбили). Порядка 6% — руководители (в основном IC, но есть и пару M2+, и даже один C-level, кто бы вы ни были).

Фактически получается, что аудитория у меня всё-таки больше опытная, чем неопытная. Это конечно хорошо, но возможно с толканием базы надо быть осторожнее.

• Размер компании (545).
Не то чтобы это радикально важно, но даёт примерную картинку, насколько разные инженерные практики вы видите. Потому что компания размером 50 явно отличается от компании в 20к человек. Хотя и одна компания в 20к может радикально отличаться от другой компании в те же 20к.

Значит вы разнообразные ещё и в самом опыте, и в проблемах, с которыми приходится сталкиваться.

23% в супергигантах каких-то. Почти 40% в небольших компаниях до 1000 человек. Остальные в серединке.

• ЯП (520).
Ожидаемо, большинство из вас трогает C++ (75%), C (21%), Python (47%) и Go (21%). Остальное поменьше. Rust всего 7%. Молодой ещё видимо.
Java/Kotlin и Js/Ts по 10%.

На Cobol никто не пишет. Слава богу.

• ЯП интересы (≈470).
Rust увлекает почти половину подписчиков (меня пока нет). Остальное +/- матчится с тем, что фактически используется.

• Сфера (≈550).
Половина — бэкендеры. Всё остальное в меньшинстве.
Получается, средний подписчик — C++ бэкендер. Это довольно необычное сочетание для мира разработки.
И я такой же. И такая комбинация мне очень нравится. Хорошо, что мы друг друга нашли.

• Интересы (≈460).
>40 % — backend. ≈30% — DB. 56% — low-level performance (значит можно и даже нужно больше уделять этому внимания). 38% конкретно backend performance (и сюда). 54% concurrency (и сюда!!).
Пятая часть подписчиков ещё интересуются engineering management (значит я буду время от времени что-то про это писать, но не увлекаться).

• Карьерная задача (≈510).
1/10 ищет первую работу. Успехов вам.
1/4 растёт до senior. Если будете делать правильные вещи, то получится достаточно быстро. Тут важно быть надёжным работягой и не подводить важных людей. Вы этому научитесь.
13% хотят вырасти дальше senior. Я тут концептуально понимаю, как это, но на практике пока не наработал. Давайте разбираться вместе.
8% хотят двигаться в сторону EM и дальше (см. канал Андрея и его community).
7% и 14% процентов хотят в бигтех или более технический домен. Значит вам нужно понять, чего ждут от хорошего кандидата и пойти усиленно над этим работать. Если не понимаете, что надо, приходите ко мне поговорить.
1/5 кайфует от жизни. Рад за вас!

• Уровень понимания (≈490).
1/4 понимает всё.
45% тратит некоторые усилия на вникнуть. То есть не прям очевидно, но достаточно понятно.
1/5 чуть сложнее. Улавливают концепции, но есть сложности с деталями.
Меньшинству очень сложно. Приходите с вопросами, чего вы!
5% шутников не вникают, потому что им не интересно. Ну штош!

Получается, что большинство понимает всё довольно успешно. Варианта 2: либо я пишу очень понятно (круто); либо топики базовичковые (надо грузить вас чем-то более сложным).

Повторим когда-нибудь, когда вас станет гораздо больше. Будем думать, как это применять теперь мощно.


#cpp

Представьте вот такой код:

auto object = GetObject(params...);

auto another = object;
MessAround(object);

// (1) you want to write some logic here

Где MessAround — функция, которая непредсказуемым образом меняет значение вашего object. То есть значение соответствует всем инвариантам, но вы не знаете, какое конкретно.

Как вы будете писать код в (1)?

Вы наверное проверите какие-то свойства вашего object. Может он там empty()/isNull()/valid(). Или может вы сразу решите его почистить: clear(). Или может присвоить что-нибудь туда захотите: object = Object{1, 2, 3}.
Или можете вообще сравнить его с чем-то (вдруг там всё-таки какое-то конкретное значение появилось):

if (object == "str_val"_obj) {...}


Делаете ли вы что-то неправильное? Должен ли компилятор вам подсказать проблему в таком коде? Может UBsan? Может clang-tidy?

Да нет.

Более того, даже если вы сделаете что-то такое:

auto first = object["first"];

Вы возможно ничего плохого не сделали. Вы просто не знаете, что точно там лежит. MessAround туда могло подложить что угодно.

Конечно, проблемы могут возникнуть, если вы, не проверив состояние вашего объекта, будете предполагать, что он обладает какими-то свойствами. Например, думать, что он не пустой. Или что он содержит сколько-то каких-то элементов. Это всё может быть, но вообще-то мы точно утверждать не можем.

Использовать объект после MessAround это примерно то же самое, что написать функцию, решающую некоторую задачу в вакууме. На примере функции, решающей любую задачу:

void solve(Object obj) {...}

Вы опять же про этот obj ничего не знаете. Вам надо проверить разные корнер кейсы. А потом как-то там решать вашу проблему.

Чем эти примеры отличаются от работы с переменной после std::move?

Да ничем.

Мы так яро привыкли к правилу «использовать переменную после std::move опасно», что в нашей ментальной модели это часто равносильно undefined behaviour. Уже само это действие вызывает подозрения. Code smell так называемый.

Хотя никакого UB тут нет. UB может возникнуть от того, что вы пользуетесь объектом, предполагая, что у него есть какие-то свойства. Точно так же и в нашей функции solve, которая может не учесть какие-то потенциальные входные данные. Пытаться разыменовать пустой указатель, не проверив его, неправильно.

И к сожалению эта ошибка стала достаточно частой, чтобы мы выработали ощущение неправильности происходящего. Само действие стало табу. В clang-tidy вон проверка отдельная есть (которую приходится игнорировать с NOLINT).

Отсюда рождаются ментальные модели вида
• «после std::move ничего нельзя»
• «после std::move можно только переприсваивать или уничтожать объект, всё остальное запрещено».
Это упрощения, которые мы себе придумали, чтобы меньше думать. И они почти всегда работают. Но иногда всё же нет.

Давайте думать и не вестись на вот эти попытки наших развитых эволюционировавших мозгов упрощать. Это мы профессионально ленимся.

P.S. Важно подчеркнуть ещё один факт.
Состояние объекта после std::move — всем известное «valid but unspecified». По стандарту это работает для стандартной библиотеки. Но кажется, мы уже настолько к этому привыкли, что считаем это данностью в любом случае. Не то чтобы это ожидание обосновано. Авторы библиотек делают что хотят. Но наверное писать ломающий это ожидание код всё-таки не надо.
А для стандартной библиотеки довольно просто понять, можно ли вызывать метод у мувнутого объекта: у метода не должно быть precondition. Например у std::vector::front он есть: !empty(); у std::vector::clear такого нет.

@thisnotes. Patreon, newsletter.
Спасибо Artyom Garkavy и niki4smirn.


#common

Сидите вы себе спокойно, разрабатываете поиск каких-нибудь объектов. Может это товары, может странички вики, может код. Что угодно. Ваш поиск — качественный keyword search.

Почесали вы репу и решили, что надо улучшать качество. Обучили новую модель, которая умеет понимать СмЫсЛ и выдавать эмбеддинги объектов. Эмбеддинги вы складываете в какую-нибудь векторную БД. Поиск там работает из коробки.

Вопрос: как интегрировать два поиска?

Проблема тут понятная: так как модели поиска работают различно, взять скор каждого объекта и сравнить со скорами объектов из другого поискового движка просто нельзя (это не имеет смысла, ведь в одном движке скор может быть от 0 до 1, а в другом [0; 1000]; считаются по-разному, означают разное).

Что делать?

Reciprocal Rank Fusion (RRF) — алгоритм объединения нескольких списков результатов поиска в один общий. Идея за ним простая: вместо сравнения сырых скоров из разных поисковых систем мы будем смотреть только на позицию айтема в изначальных списках.
Выражается формулой:

RRF(doc) = SUM( 1 / (k + rank_i(doc) ), i in [1; N]

doc — документ
N — количество поисковых систем/движков
rank_i(doc) — позиция документа doc в i-м списке
k — некоторая константа, положим 60.

Фактически, чем выше документ находится в разных списках, тем больше его итоговый RRF score.

Давайте быстрый пример. Keyword search выдал (номер-документ):

1 A
2 B
3 C
4 D

а vector search:

1 C
2 A
3 E
4 B

Тогда

RRF(A) = 0.0325
RRF(B) = 0.0317
RRF(C) = 0.0323
RRF(D) = 0.0156
RRF(E) = 0.0159

Итоговый результат выглядит так:

1 A
2 C
3 B

D и E можем опустить по некоторому трешхолду или просто потому что они не встретились в результатах обоих движков.

Почему мы взяли k=60?

Понятно, что большее значение k уменьшает влияние первых позиций, а меньшее наоборот: сильнее их награждает.
А 60 это просто значение, использовавшееся в оригинальной статье. Авторы его как-то примерно подобрали и потом отталкивались во всей статье от конкретного значения в формуле.

Плюсы RRF:
• не требует никакого обучения. Простой математический метод.
• очень легко реализовать. Джуна посадите и чекните PR через день.
• неплохо работает даже в самом базовом виде. Без подкручивания k.
• устойчив к разным шкалам score, потому что их не использует.
• очень легко добавлять новые движки.

Минус один, но жирный: не учитывает, на сколько разница между позициями сильная.
Оригинальные скоры для соседних документов в рамках одного движка могут различаться очень сильно, но из-за высокой позиции документ всё ещё может оказаться на высоком месте в итоговом результате.

Фактически RRF — первый бейзлайн для гибридного поиска. Но если хочется качество получше (то есть перестать просто «смешивать» документы, а реально понимать «что лучше показать юзеру»), нужно обучать отдельную модель, которая переранжирует результаты ещё раз. Может она даже будет тяжёлой, но в силу того, что работать ей надо не со всем набором документов, а только с топ-X найденных, это обычно не проблема.

@thisnotes. Patreon, newsletter.
Спасибо Artyom Garkavy и niki4smirn.


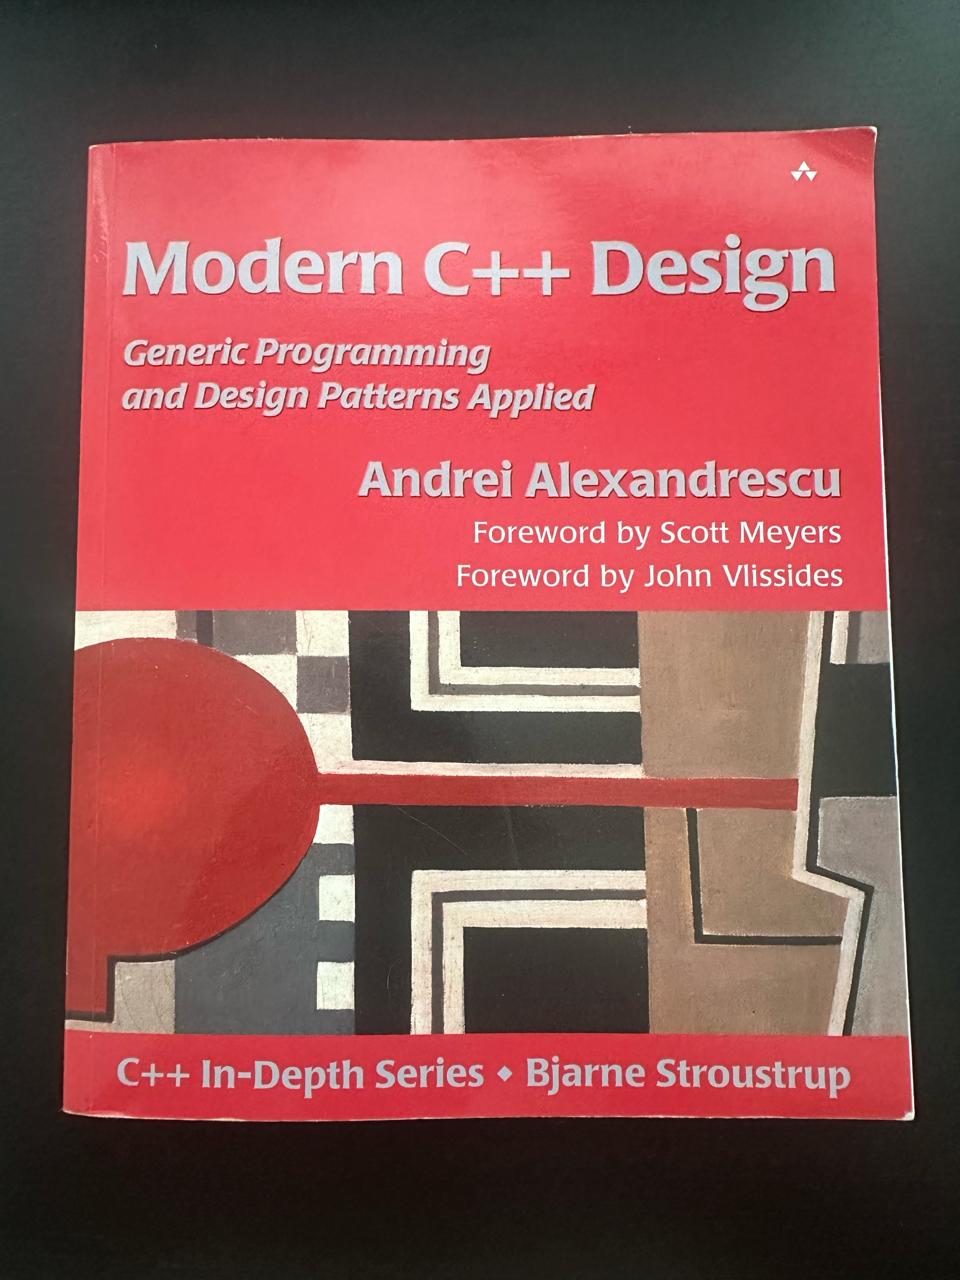
#cpp #books

Да, книга 2001ого года. Мы ровесники.
И да, в ней в основном обсуждаются какие-то решения, которые сегодня уже всем знакомы и лежат в стандартной библиотеке сто лет. Но есть но...

Содержание:
1. Policy-Based Class Design.
Глава рассказывает про сложности создания качественного кастомизируемого дизайна общих классов и почему множественное наследование не помогает в решении проблемы экспоненциального роста потенциальных версий ваших компонент. Есть примеры использования различных policy.
В конце обсуждается, как декомпозировать ваш класс на policy. Есть такой совет: «Anything that can be done in more than one way should be identified and migrated from the class to a policy». Важно помнить, что книга для пишущих общего вида библиотеки. Скорее всего для общего решения в продуктовом коде правильнее будет сказать: «Выносите то, что прямо сейчас нужно вынести». Не наперёд, а в моменте.

2. Techniques.
Вторая глава рассказывает про набор отдельных утилиток и возможностей языка, которые могут применяться в более общих решениях. Некоторые из них:
- compile-time assertions (до static_assert)
- partial template specialization
- integral constant to type (дед std::integer_constant)
- type-to-type mapping
- type selection (std::conditional)
- TypeTraits (правда тут это класс с константами, а не как у нас «вчера» шаблонные структуры)

3. Typelists.
Typelists конечно не поддерживают произвольное количество аргументов (потому что шаблоны не умели). Выглядят они так:

typelist

Дальше реализовываются разные операции и рассказывается про применение класса.

4. Рассказывает про проблемы стандартного аллокатора и после введения локальных понятий поясняет реализацию small-object аллокатора.

5. Про паттерн Command и generalized functor для его реализации. Фактически std::function.

6. Рассказывает про реализацию Singleton.

Причём довольно подробно описывая проблемы разных подходов. В итоге приходим к Meyers singleton. После небольшого chatgpt-like фактчека оказалось, что именно в этой книге Andrei Alexandrescu подарил миру это название.
Далее он рассматривает самоназванную KDL problem (которая легко может возникнуть на практике) и изобретает Phoenix singleton для её решения.
К концу главы обсуждается реализация singletone для многопоточного случая и общая policy-based реализация.

7. Про умные указатели.
Кто такие, как пользоваться и как должны быть реализованы с точки зрения различных случаев на практике.

8 и 9. Про фабрики и абстрактные фабрики.

10. Посвящена паттерну visitor.

11. Реализации мультиметодов.
Это как бы перегрузка функций, которая знает чуть больше, чем положена. Кратко можно пояснить так:

class Shape {};
class Asteroid : public Shape {};
class Spaceship : public Shape {};

void Collide(Asteroid& a, Spaceship& s) { /* Logic 1 */ }
void Collide(Shape& s1, Shape& s2) { /* Logic 2 */ }

И вот обычно вы бы вызвали Collide на основании того, какая ссылка была передана. Если Asteroid был передан как Shape, то вызовется общая функция для Shape. Вот мультиметоды позволяют понять, какой объект на самом деле лежит в памяти и вызвать для него соответствующую перегрузку.

Каждая глава проходит путь от каких-то простых реализаций до более продвинутых через рассмотрение ошибок и проблем, которые возникают при неаккуратном дизайне.

Сегодня конечно книга выглядит уже скорее как исторический артефакт. Но!
• первая глава про policy-based design всё ещё актуально, потому что говорит концептуальные вещи. Мне она сильно запомнилась и помогла на некоторые концепции иначе смотреть.
• большинство других глав полезны с точки зрения понимания, как стоит смотреть на проектирование общих решений.

То есть если не воспринимать книгу как справочник по C++, а попытаться увидеть в ней мануал по проектированию на примере конкретных задач, получится очень даже полезно.

@thisnotes. Patreon, newsletter.
Спасибо Artyom Garkavy и niki4smirn.


#perf

Попробовал собрать в кучку (кажется, немного сумбурно всё же) мысли по двум моментам:
• что искать в данных и как их собирать, чтобы на них можно было быть oriented
• чуть более разнообразные, чем обычно, примеры применения DOD.

https://thisnotes.dev/blog/dod_examples/

Да, на инглише, теперь иногда будет так.

Ещё можете подписаться на newsletter: https://thisnotes.substack.com/subscribe
Может вам на почту удобнее получать.

@thisnotes. Patreon.
Спасибо Artyom Garkavy и niki4smirn.


Давайте новый тег заведём: #perf

Во-первых, надо понять, что я вообще понимаю под перфом, ведь понятие очень широкое. Так как мои интересы лежат в районе эффективности распределённых систем, то перф для меня — всё, что позволяет делать эти распределённые системы быстрыми. В зависимости от системы вам может понадобиться решать проблемы разного характера. Где-то это про сделать ручку для обработки данных батчами, чтобы по сети поменьше ходить. Где-то научиться нормально пользоваться БДшкой. Где-то надо почаще попадать в L1 кеш и префетчить данные. А где-то вообще выбросить всё что есть и сделать заново в другой парадигме. Вся широта проблем меня занимает. В разной мере в разное время.

На самом деле я бы расширил понятие перфа до слова эффективность. И разговаривал бы ещё про то, что такое эффективность команды или всех разработчиков на стеке Х. Что такое developer experience. Почему унификация помогает средне-большой компании экономить деньги и вот это всё. Тут конечно надо быть осторожным и не уйти в степь вида «дайте-ка я ещё померяю, кто у меня в команде больше коммитов делает и буду им оценочку на ревью повыше ставить». Я за здравое понимание «эффективности разработки», а не за вот это корпоративное обмазаться метриками и всем в нос им потом тыкать.
Но такие вещи я постараюсь в тег не заносить, чтобы не обманывать хардкорных си плюс плюс подписчиков.

Во-вторых, начать тег я хочу с концепции. Концепция хорошо показана в докладе с CppCon 2014: Data-Oriented Design and C++ от Mike Acton. Это даже тот самый классический доклад, который всем показывают по теме.

Я его смотрел когда-то пару лет назад. Смотрел не очень осознанно. А сейчас как-то естественным образом пришёл к понимаю подобного направления и случайно ещё наткнулся на доклад, который вроде про то самое.

Суть хорошо показана в первой части (где-то первые 30 минут, дальше начинаются примеры кода). Кратко её сформулировать можно так: данные это всё. Основная проблема: при решении задач мы часто оперируем ментальными моделями, которые хорошо выглядят с точки зрения нашего человеческого понимания объектов, трансформаций данных и решения проблемы «переложить объект слева направо». Но так как компуктеры работают не так, как мы думаем, необходимо взять себя в руки и подумать про то, как данные должны трансформироваться (фактически единственно важный вопрос при проектировании). И из этого ответа у вас вытекают все возможности решений.

Фактически весь перф это про data oriented design. Ведь вам не нужно ускорять то, что согласно данным не нужно ускорять. И нужно то, что нужно. Вам нужно знать, как ваши данные выглядят, какие там взаимосвязи. Как они используются. Желательно знать как можно больше. Вы хотите решать задачу для наиболее common случая, потому что это статистически принесёт больше пользы.

Короче знайте свои данные.

Есть ещё доклад Vittorio Romeo «More Speed & Simplicity: Practical Data-Oriented Design in C++». Несмотря на какой-то околоискуственный пример, тут неплохо показана попытка сдвига мышления от привычной OOP парадигмы в сторону DOD.
Особенно, пусть это и не относится особенно к делу, красиво задвинул в конце про адекватный интерфейс для SoA.

У меня вот прям после некоторого количества информации по этой теме какой-то сдвиг в голове случился, и некоторые вещи обрели новый, более устойчивый смысл, а некоторые его радикально потеряли. Будем наблюдать, какие плоды это в итоге принесёт.

@thisnotes. Patreon.
Спасибо Artyom Garkavy и niki4smirn.
На правах мегапатрона послание подписчикам от Artyom Garkavy:

Try it today: google.com.


#common

Мы часто делаем системы, которые обладают какими-то ограничениями. Ограничения наш хлеб: если бы надо было сделать универсальную систему для любой, абсолютно любой задачи, её бы скорее всего не стали финансировать даже на этапе идеи. Масштаб изначально не объять.

Например, сервис доставки продуктов, в котором я провёл 4 года, обладает (по крайней мере раньше) некоторыми интересными свойствами.

Во-первых, это жутко операционный бизнес.

У вас есть склады, а значит нужно находить существующие помещения нужного размера и подписывать аренду с владельцами. Вам нужны поставщики. Для оптимизации некоторых процессов вообще можно захотеть построить завод, чтобы товары самому производить (и растить маржу). Некоторые фичи нельзя сделать в одного, потому что нужно не только код написать, но и научить кладовщиков в десятках городов (и странах) делать вещи иначе. Горячая еда и кофе не могут быть горячими постоянно. Их нужно греть/готовить, а значит соблюдать санитарные нормы, и вообще найти физическое место для оборудования.

Но это же и делает задачи особенными. Идея, которая мне очень понравилась, но заглохла на этапе поисков ресурса, — поставить на каждый склад принтер, заинтегрироваться с сервисом AI-генерации картинок и печатать каждому пользователю открытку с его заказом. Как же фаново звучит.

Операционка — ограничение, которое всегда было и постоянно нужно учитывать.

Но это не то, про что я хочу рассказать. Ещё есть во-вторых: сервис не имел user generated content (UGC). Хотя он предоставлял какой-то контент (товары посмотреть). Всё, что вы видели в приложении, полностью создаётся или внимательно валидируется сотрудниками. В какой-нибудь социальной сети, живущей на UGC, в любой момент кто угодно может запостить абсолютно что угодно. А вот в сервисе доставки нет.

Почему это хорошо?

Я не говорю, что это хорошо. Я говорю, что это существующее ограничение, которое имеет свои плюсы.

Например, вы можете доверять данным. Это значит, что задач
• модерации
• антиспама
• соблюдения копирайта
просто не существует.
Вам не нужно удалять содержимое за мгновение, потому что юзер мог написать что-то не то и яростно кликает на кнопку Delete. За сутки отрастёт и ладно (преувеличиваю конечно, но суть ясна). А это даёт возможность обкладываться кешами по самое не хочу.

Другое преимущество: объём данных не растёт так непредсказуемо.
Никакой пользователь на загрузит гигабайт фоток за полдня. Не придёт злостный робот-спамер с вредными комментариями (придут другие, но про это когда-нибудь потом).
Вам буквально проще заниматься capacity planning.

Более того, скорее всего данные в целом меняются не очень часто -> вы получаете систему вида «few writes, many reads». Значит возможно данным не нужно появляться мгновенно (что тоже не всегда правда, но мы теоретизируем) и можно обрабатывать их более сложными и долгими способами. Можно в конце концов взять 1000 самых популярных поисковых запросов (если у вас поиск есть) и посчитать самые релевантные ответы на них. Раз в сутки пересчитывать одной большой долгой кронкой.

У вас вероятно нет горячих и холодных данных (ну может с какого-то момента есть, но до этого вам нужно ещё дожить, когда в системе с UGC всё может произойти завтра).

Я не говорю, что все отпавшие задачи выше — фигня какая-то. Нет. Они очень интересны. Но у вас трейдофы смещаются в сторону и позволяют оптимизироваться под вещи, которые не могут быть возможны в UGC системах. Всё вокруг вы можете оптимизировать под чтение, а не запись.

Иногда от UGC можно умело избавляться -> не добавлять сложные последствия. Например, не показывать отзывы юзеров на товары, а показывать AI-суммаризацию (CEO вам ещё спасибо скажет: AI добавили, нифига себе модные).

Короче ваши решения могут быть более долговечными и производительными, если вы поймёте специфику вашего продукта и его ограничения.

Попробуйте потратить время на этой неделе, чтобы глубже ощутить подобные ограничения в вашем проекте.

@thisnotes. Patreon.
Спасибо Artyom Garkavy и niki4smirn.
От мегапатрона Artyom Garkavy вам:

Try it today: google.com.


#list

0. [talk] Achieving Peak Performance for Matrix Multiplication in C++. Aliaksei Sala.

Алексей рассказывает про постепенное улучшение умножения матриц, начиная от базового подхода и двигаясь через улучшение работы с кешами, simd, префетчингом и всякими другими финтифлюшками.

1. [article] How Google Measures and Manages Tech Debt.

Хорошая системная статья про то, как в Google пытаются мерять и бороться с техдолгом как явлением. Вряд ли вы найдёте радикальные откровения, но системность подхода на уровне.

2. [article, download pdf] Microservices Anti-Patterns: A Taxonomy.

Статья написана поверх опроса специалистов на тему антипаттернов при использовании микросервисов. Я — святая простота — некоторым типичным проблемам удивился, так как даже подумать не мог, что где-то считают это нормальным. Например, «local logging», который подразумевает хранение логов в рамках контейнера одного сервиса. То есть нельзя сразу везде искать. Жесть как так жить вообще можно...

Хотя с другими я не прям согласен как с проблемами. Имхо можно спокойно и без API-gateway пожить. И shared libraries вообще-то отличное решение, если адекватно ими пользоваться.

В статье рассматриваются не только технические проблемы, но и организационные. Вроде «быть жадными на микросервисы» (== делать новый на любой чих). Или не менять структуру компании в соответствии с новрй технической организацией.

Не предлагаю прочитать всё внимательно. Скорее пробежаться глазами по табличкам с описанием отдельных проблем в середине.

3. [article] Build better software to build software better.

Чуваки из Slack рассказывали, как переделывали build-пайплайн.

Кроме очевидных поинтов мне очень понравилась мысль (нигде явным образом не сформулированная), что иногда использование тулинга требует подготовки и переделки системы под инструмент.

И может это даже окупится.

4. [article] p99 0 ms* autocomplete for 240 million domain names.


Про контент.

Я не буду разбирать и рекомендовать отдельные доклады. Это я сделаю когда досмотрю пару пропущенных, и их выложат в открытый доступ.

Наблюдения такие:
• было солидное количество докладов, которые уже рассказывали на других конференциях. Это стандартная практика, но она чувствуется гораздо сильнее в англоязычном пространстве, когда конференций и докладчиков в целом больше. Если сейчас в программу Meeting C++ 2026 заглянуть, там вы тоже солидное кол-во повторов найдёте.
• очень много говорят про фичи последних стандартов. Рефлексия. Контракты. Это логично, ведь всем хочется знать, как там фичи покруче использовать, но я в последнее время перестал пытаться ухватывать каждую новую функцию. Стараюсь смещать фокус в более фундаментальные вещи.
• безопасность и Rust. Ну вот популярные насущные топики. Что с них взять.

Было ощущение, что не всегда доклады в сетке расставлены равномерно. Где-то в большом зале мало людей, а в другом поменьше не протолкнуться. В последний день в один слот стояли Jason Turner, Matt Godbolt и Timur Doumler. Жоска!

Мне очень понравилось.

Несколько фотографий с конфы и из города в целом.

На фото номер 3 коллега из Bloomberg: Женя Селиверстов. У него блог есть: omniverse.ru

Последняя — с прогулки в соседнем Hythe, где мы случайно встретили огромного пса Scooby. Наш 6-килограммовый зверь был готов наброситься, но он не знает, как это не любить кого-то, так что обошлось.


#cpp

ACCU on Sea 2026.

Помните, я в июне на конфе был? Пора отдавать долги.

Конфа проходила в Folkestone. Это город на юге UK. Прям у моря, так что название не врёт.

Раньше это было две отдельные конференции: ACCU conference (более общепрограммистская, пусть ACCU непосредственно с C и C++ и связано) и C++ On Sea. Мне несколько раз независимо сказали, что объединились они стратегически: сложно таскать участников дважды в год на похожие мероприятия, да ещё и денюжек у всех мало, так что от сотрудничества все только выиграют. Охотно верю.
Если в России подобные конфы часто делают проф организации, которые на этом деньги зарабатывают, то тут это скорее сборище энтузиастов. Надеюсь, они не работают в минус.

Сравнить с предыдущими конфами той же серии у меня конечно не получится. Но я могу сравнить с СНГшными альтернативами.
Во-первых, очень непривычно ездить на длинные конфы. Самая большая до этой у меня была на 2 дня. А тут все 4, и это я 2 дня воркшопов пропустил.
Во-вторых, очень непривычно ездить (на поезде), а не на самолёте летать. То есть уже кпд повыше (время в пути относительно времени на конференцию).
В-третьих, просто потому что это такая локация, вдали от Лондона (там дорого, причём и участникам, и организаторам), город отдаёт чуть больше Англией. Вот этой дефолтной обычной. У жил в гостинице старше моих дедов, с двумя кранами (для холодной и горячей воды) и под крышей. Вокруг всё такое деревянное. Короче даёт вайбом.
Морюшко рядом просто замечательное. За пару дней до конференции мы приезжали просто город посмотреть. Кроме огромного количества мошек у воды нареканий не было. Симатишно.

В силу того, что конференция так-то довольно большая и известная, было очень много известных чуваков. Вот лист рандомных имён, на которые удалось посмотреть вживую, с кем-то даже пообщаться: Andrei Alexandrescu (я пожал ему руку и хотел её больше никогда не мыть, но жена не разрешила), Jason Turner, Matt Godbolt, Walter E Brown, Klaus Iglberger, Nicolai M. Josuttis, Victor Ciura, Andreas Fertig, Sandor DARGO, Hana Dusíková, Timur Doumler, Arne Mertz и много других (коллег по компании не упоминаю). Они все настоящие, как и я настоящий. Очень необычно видеть людей вживую спустя 8 лет просмотров по телевизору.

Кормили дефолтно по-английски.
Стенды компаний вокруг были в основном трейдинги разного направления.
Вечерние активности были довольно интересными. Квиз особенно. Мы с коллегой вдвоём его начинали и для усиления привлекли группу из 5 случайных мужчин с пивом в руках. Победить нам это не помогло, но усилиться точно.
Walter E Brown в какой-то из вечеров устраивал Movie Night. Это он показывал на большом экране прикольные видосы с вайбом из ВК 2015. Визуализации сортировок. Как забавно хор имитирует звуки виндовс. Короче дедовские мемы.

Очень понравился формат лайтнингов.
Я несколько лет на C++ Russia с ними выступал и посмотрел на них тут. Отличия радикальные. На C++ Russia это сайдактивность где-то там в уголке, пока в главном зале большинство участников мощно пьют пиво и в конкурсах участвуют (по крайней мере в прошлые года, в этом я не посещал). На тебя приходит посмотреть человек 10-15, лайтнинги не blazingly fast (до 20 минут). Их мало.
На ACCU On Sea лайтнинги до 5 минут. Строго. Если превышаешь тайминги, у тебя отберут микрофон силой. Они идут час после докладов (то есть 12-14 лайтнингов успеваем) и они каждый день. Фактически за 3 вечера ты слушаешь ещё дополнительные ≈35 микродокладов на самые разные темы: рандомные плюсовые приколы, рекламы стартапов, астрономия, как клаву под себя собрать, про ос, какой-то чувак просто песню спел, даже не про C++. И это всё происходит в главном зале, куда фактически все приходят изначально, а значит у тебя есть большая аудитория. Гораздо более энергичный и заряженный формат. Рекомендую попробовать, друзья из джуг ру груп.


Когда я начинал руководить, одним из формальных шагов (хотя и довольно полезных) было пройти внутренний курс для начинающих руководителей. Он выглядел примерно как в течение месяца раз в неделю почти полный день вы сидите с такими же чувачками в зуме, слушаете «эксперта» по теме, а потом друг с другом тренируетесь в разных игровых ситуациях. Например, объявить оценку сотруднику, который ожидал результат получше. Или как сотрудников растить (что, как мы с вами помним, неимоверно сложно).

Одной из предлагаемых сайд-активностей было найти себе ментора в компании. Какого-нибудь опытного менеджера (выше М1), с которым время от времени можно побазарить про происходящее у тебя, как молодого рук-ля, или про то, что мы узнавали на обучении.

Я рассуждал так: с моим прямым руководителем у меня контакт есть; со скипом тоже есть регулярные встречи; со рук-лём скипа тоже есть; а вот дальше нет. На скипе скипа контакт обрывался. Логичным было его наладить.

Скипом скипа (или для простоты CTO-1) в тот момент уже больше полугода был Андрей Романовский. Он к нам пришёл из сервиса рядом. Выглядел прикольно (молодой и уже успешный, тогда ещё и лысый). Вот мы с Андреем каждую неделю на протяжении ≈1.5 месяцев болтали за всякие менеджерские штучки (точнее он мне за них пояснял).

Потом у нас осталась редкая, но регулярная встреча, где можно было про всякое поговорить. Например, он мне рассказывал, чем он работе занимается. Так я держался в курсе про проблемы больших дядек и нашего сервиса в целом. А то они не всегда долетают сверху к работягам пониже.

У Андрея есть канал (в конце поста).

Я про него в последнее время лично людям рассказываю, и людям нравится. Может и вам пойдёт.

Он пишет про всякое менеджерское, но это конечно не означает, что вам надо в руководители метить. Всё применимо и если вы хотите быть качественным адекватным IC.

Вы спросите, чем он радикально отличается от других аналогичных человеков? Я вам скажу.

Средний канал про что-то менеджерское — это буквально повторение очевидных вещей по кругу. Я знаю порядка 10 известных в русскоязычном телеграмме авторов, которые имеют 10к+ подписчиков и пишут инфу, которую я ещё будучи джуном прекрасно понимал. Они только забивают информационный канал и ничего полезного не приносят.

Андрей тоже пишет про понятные вещи, но они понятные только когда ты у него прочитал и подумал «ну да, так оно и есть, но я что-то сам никогда про это не думал». То есть это всё просто, но чтобы к большинству мыслей прийти, надо какого-то количества булшита накушаться и вывести. Он вот за вас это делает.

Я знаю много лидов, которые знают, как надо, но вот они какие-то теоретики что ли. У меня не единожды были менеджерские диалоги вида
кто-то: «чтобы исправить ситуацию, делай А и Б»
я: «но тут проблемы 1, 2 и 3. Я не понимаю, почему А и Б поможет, можешь объяснить?»
кто-то: «ничего не знаю, надо делать А и Б».
Я начинаю делать А и Б (ведь может я что-то упускаю), получаю проблемы 1, 2 и 3. Прихожу это обсуждать, а «кто-то» сидит в замешательстве и не понимает, как это расгребать.

Вот Андрей всё это теоретическое тоже знает, но он по фактам мне всегда раскидывал. Как реально надо делать. Почему то получится, а на это даже времени тратить не надо. Прям уверенный практик этих сложных менеджерских штучек.

Ещё он матом иногда смешно ругается.

Вот канал: @leadsnotes.

Ещё он ищет себе full-stack разработчика. Вот тут почитайте: https://t.me/leadsnotes/322


#cpp

С марафоном препроцессорным я подотстал от происходящего в мире. Потому некоторые штучки-дрючки довольно поздно выкладываются. Мда.

Ну и ладно! Я что, СМИ? У меня жена ваапче-то есть. Некогда мне тут сидеть круглыми сутками, да следить за новостями бесконечно.

Смотрели документалку про C++?

The Story of C++ : The World's Most Consequential Programming Language | The Official Story.

А после можно последующее обсуждение:
Inside C++'s Biggest Challenge | Panel Discussion with Bjarne Stroustrup, Herb Sutter & More.

Вообще ощущения от фильма кайфовые. Сделано дорого-богато (HRT всё-таки имеют денюжку в кармане, могут себе позволить). Местами ощущалось, что это чуть ли не документалка про какое-то ужасное событие. Стихийное бедствие или терракт. Не знаю почему. Может быть вайб того, как снято. Музыка на фоне.

Но вообще-то довольно познавательно. Интервью с важными, даже ключевыми, фигурами в развитии языка дают веса истории. Хорошо передана история 80х и 90х (хотя я появился после, так что мне можно рассказать что угодно). Интересно рассказана история STL (хотя явно не достаточно глубоко, и на самом деле там были какие-то конфликтные моментики). Есть забавные истории.

Чтобы сформировать более сбалансированное мнение, я заодно почитал там-сям обсуждения. В основном предъяв несколько:
• история слишком official и почти полностью от лица участников ISO комитета
• про Boost почти не упоминают, хотя он сильно повлиял на развитие языка
• в 2000х был кризиc, который упоминается мимоходом, хотя на самом деле тогда это была огромная проблема. Драму сгладили
• молчат про экосистему, хотя это одна из главных проблем языка. Документалка в целом на языке сосредоточена

То есть рассказывается всё более радужно и весело, чем было на самом деле. Как будто проблем особо не было и нет, хотя вот они, маячат у нас перед носом.

В итоге это скорее история C++ от лица создателей C++, но не исчерпывающая история языка. Чтобы получить честную, полную картину, хорошо бы послушать мнения оппонентов.

Зацените, как дед кайфово в шляпе выглядит.

@thisnotes. Patreon.
Спасибо Artyom Garkavy и niki4smirn.
На правах мегапатрона послание подписчикам от Artyom Garkavy:

Try it today: google.com.


Теперь про Сербию.

Я раньше в ней не бывал. Только слышал забросы вида "идёшь в центре города, слева тц, справа заброшка". Впечатляюще?

Я конечно упускал контекст. Заброшки там не просто так, а из-за бомбёжек НАТО в 1999м. Причём ребята не сильно планируют с ними разбираться (по крайней мере, не со всеми): хотят оставить напоминание о случившемся.

Первое впечатление от Белграда довольно сумбурное. Не очень чисто, здания старые. От всего вокруг отдаёт совдепом. Вот эти советские-like здания, потемневшие от времени. Вайб советского брутализма от большинства зданий в центре города (мы, ради справедливости, сильно за центр и не выбирались). Как-то мрачно!

Ты естественным образом сравниваешь новые места относительно тех, где долго пожил. И по ощущениям Белград не дотягивает ни до Минска (потому что там всё гораздо аккуратнее), ни до Лондона (потому что в Лондоне больше европейского и больше всего в целом).
Но к концу 4ого дня стало как-то уже даже и ничего. Всё серое и неприятное стало просто серым. Мы вкусно кушали и ходили в новых местах в первом настоящем (уехав куда-то) с переезда отпуске. В каком-то смысле даже немного вернулись домой, во что-то более понятное и привычное.

Я попробовал плескавицу. Мне понравилось.
Попробовали ракию. Не понравилось. Это оказывается просто местная водка. Я к такому готов не был. I'm a beer guy.

Ещё мы ездили в Нови Сад. Такой небольшой [относительно] город с крепостью и базовым форматом: исторический центр и остальное как есть. Симпатично на 3 часа, но и хватит.

Очень жарко там везде было. 36 примерно. Парились все 5 дней от начала и до конца. Благо, сербы понимают, где живут, и имеют нормальные работающие кондиционеры везде, где необходимо. Не то что англичане блеан.

Ещё церкви очень красивые. Возможно потому что огромные.

По порядку:
• князь Михаил на коне (я так понимаю, местное популярное место для встреч) на (опять же, насколько понимаю) важной площади. На фоне национальный музей.
• вид на Дунай и какую-то вторую реку с территории белградского замка.
• какая-то рандомная церковь у главпочтамта.
• одна из самых больших православных церквей в мире.
• вид на Нови Сад с крепости (которая типа новисадская, но на самом деле в Петроварадине).
• рандомная фотка из Нови Сада.


#cpp

Back to Back 2026 (который был C++ Zero Cost Conf).

Я выбрал несколько докладов из всех 4х треков. Если доклад не выбран, это не значит, что он плох. Возможно он не зашёл мне темой, а возможно не так интересен, как другие. Навалить вам просто все доклады мне не очень хотелось.

0. 9 миллиардов этажей concurrency. Андрей Аксёнов.

Доклады бывают в разных форматах. Этот доклад не должен глубоко раскрывать тему, на мой взгляд. Он скорее должен дать вам много разных слов, с которыми вы должны пойти разбираться.
Ну и это Андрей Аксёнов со своей подачей. Хулиганской.

1. Трассирую и профилирую — бесплатно. Александр Емеленко.

Александр рассказывает про измерение времени и запись логов жоска эффективно, двигаясь от базовичкового медленного варианта к быстрому наносекундному.

2. Building the tiniest pomodoro app. Miloš Anđelković.

Хороший доклад для понимания техник уменьшения размера ваших бинарных файлов. От отказа от зависимостей и правильной компиляции до переписывания всего совсем иначе.

3. Profile-Guided Optimisation. Taming the pitfalls in the name of performance. Alexander Zaitsev.

Я особо раньше не смотрел доклады про PGO, потому что они сразу куда-то в дебри уходят. Как будто для них нужен уже солидный такой контекст.
А вот тут не так. Тут Alexander рассказывает про базовые понятия, проблемы, кто что умеет, как делать, профит. Такое солидное введение в тему.

4. Google's Highway Library for SIMD Programming — Does It Deliver the Promise? Ivica Bogosavljevic.

Ivica рассказывает про гугловую SIMD либу. В местах, где она хороша (как и заявлено), и где не очень хороша и не справляется со своими задачами (или справляется, но не очень хорошо).

5. Microseconds in Network Code. Artur Soloviev.

Artur рассказывает про несколько вариантов работы с сетью, чтобы было быстро.

6. To 264 and Beyond: Modern Approaches to Distributed Identifier Algorithms. Mons Anderson.

Тут Mons рассказывает про огромное количество (штук 15 может) разных distributed ID. Их устройство, некоторые принципы работы, tips & tricks для разработки своего решения. Плюсы и минусы разных подходов.

Как один из критериев ещё обсуждалась длина закодированого ID. Это важно, ведь если ваши ID в огромнющей системе сделать на байт короче, это может вылиться в Гигабайты экономии.
А ещё это важно, потому что некоторые строки (покороче) попадают в SSO буфер, а некоторые нет. Мета, например, когда-то ровно по причине увеличения SSO буфера переходила на свой fbstring. А потом вернулась на стандартную строку, когда clang научился давать 23 символа в SSO буфере из коробки.
Возможно, вы можете пойти и поменять тип для хранения ваших ID на small_string или как оно у вас называется. И получить какой-нибудь профитик.


#common

МАРТИН ИДЕН ОШИБАЛСЯ.

Книге уже больше 100 лет, так что у вас было полно времени её прочитать. Потому выдать спойлер бояться не буду (хотя главные панчи всё-таки придержу).

Так где он ошибался?

Когда Мартин стал уважаемым известным писателем, его стали активно звать на всякие обеды, встречи, интервью. Хорошо с ним обходились, уважали. Мартина это раздражало. Его основная мысль в это время успеха была примерно такая: «Почему они любят меня сейчас? Моя работа [имеется в виду все те книги, рассказы, повести и стихи, которые Мартин усиленно писал пару лет] была уже сделана. Я никак не изменился как человек. Но тогда [до публикации и признания] никто не звал меня на обед, когда я голодал и мне нужны были эти обеды! А сейчас все зовут, а мне уже не нужны эти обеды!» (на обеды он тем не менее ходил).

В голове Мартина должно быть так: ты делаешь работу и все магическим образом должны тебя за это зауважать.

Переводя на наш с вами, он считал, что достаточно «написать код». Однако по какой-то причине Мартин не подумал про два других важных этапа успеха:
• выкатить в прод (в его случае опубликовать работы через издателей)
• поработать над визибилити (в его случае каким-либо образом добиться известности хотя бы в сообществе).

То есть это всё у него в итоге было, но в юношеских стенаниях упускалось.

Давайте учиться на чужих ошибках. Как бы круто вы ни закодили что вы там кодили, как бы круто оно ни работало, никто не будет вас хвалить за работу (если вы не джун или микромидл, но это отдельный разговор). Всем нужен результат. Даже не так. Всем нужен наблюдаемый результат.

Самая крутая фича должна быть у юзера и должна показать, что она приносит деньги. Самая крутая оптимизация должна реально что-то наоптимизировать.

И вам очень повезло, если по какой-то причине важным начальникам и начальницам очевидно, что вы большие молодцы и достойны премии повыше.

Но обычно не так. Обычно надо ещё самим замерять, сколько денег вы принесли. Сколько ресурсов сэкономили. Как изменилась метрика.
И, что ещё более важно, надо пойти и всем про это рассказать. А если вам не нравится таким заниматься, то либо найдите себе руководителя, готового делать это за вас, либо смиритесь с тем, что ваш гений не признают.

Если вы макромидл или тем более senior+, без визибилити никуда. Примите это.

Ниже картинка, на которую важно иногда посматривать, чтобы не забывать всё выше.

А книга хорошая. Почитайте.

@thisnotes. Patreon.
Спасибо Artyom Garkavy и niki4smirn.

15 ta oxirgi post ko‘rsatilgan.