


Настройки сервера и CDN отсекают ИИ-краулеров там, где SEO-софт показывает код 200
Соблюдение robots.txt — дело добровольное.
А вот блокировки на уровне сервера, CDN или фаервола обойти нельзя: запрос жестко отклоняется, и у краулера нет выбора.
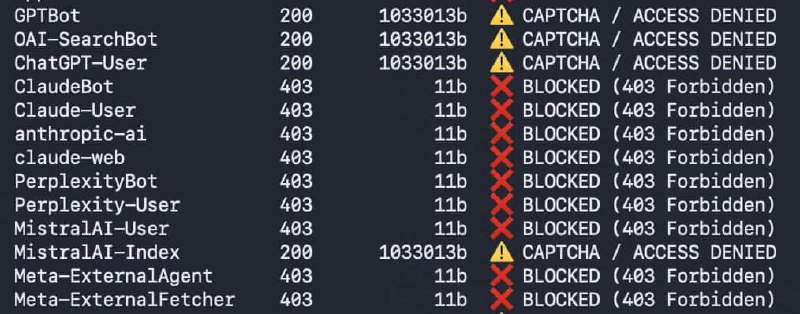
Стандартный SEO-софт не выводит эту разницу: при краулинге урл может отдавать 200, тогда как ИИ-краулер получает 403, страницу-заглушку или вообще другой ответ.
Временное окно закрывается.
С 15 сентября 2026 года Cloudflare применяет новые дефолтные правила для свежих доменов: боты, классифицированные как Training или Agent, блокируются на страницах с рекламой, в то время как ботам класса Search доступ открыт.
Это же обновление меняет то, как блокировки ИИ-тренировок (включая старую настройку "Block AI bots") обрабатывают гибридных краулеров Search + Training.
Опенсорсный bash-скрипт bot-block-checker вскрывает эту слепоту без доступа к логам.
Сначала он запрашивает урл со стандартной строкой User-Agent от Chrome, чтобы зафиксировать базу, а затем отправляет тот же запрос, подставляя более 30 строк User-Agent различных ботов и краулеров.
Статус-кода самого по себе недостаточно — 200 может оказаться страницей-заглушкой, — поэтому скрипт также сравнивает размер тела ответа и ищет известные паттерны блокировок относительно базового запроса.
Любой 429 перепроверяется изолированно, чтобы отделить реальную блокировку от ложноположительного срабатывания из-за слишком частых запросов.
Одной локации тоже мало, потому что один и тот же бот получает разные ответы в зависимости от входящего IP.
Прогони тест дважды: с локальной машины на резидентном IP и через Google Cloud Shell на датацентровом IP.
Затем сравнивай результаты:
— Блокировка в обеих средах при доступной базе: конкретное правило против бота, разбирайся с ним в первую очередь.
— Блокировка только в одной среде: проблема на уровне сети, например, фильтрация датацентровых IP или гео-ограничения; само по себе это ничего не доказывает.
— Идентичный успешный ответ везде: нет признаков того, что к этому User-Agent относятся иначе.
Заблокированный бот — это не всегда проблема.
Если сайт отшивает Bytespider, это не бьет по SEO или AEO.
Блокировка становится критичной, когда она срезает краулеров класса Search или Agent, которые должны находить, извлекать или цитировать контент.
Скрипт не может на 100% сымитировать запрос от реального краулера.
Воспринимай любой флаг как сигнал, а не как железобетонное доказательство: подтверждай данные в конфигурации CDN/сервера или логах, прежде чем нести их инфра-команде.
https://athenseo.com/knowledge-hub/how-to-check-if-ai-crawlers-can-actually-reach-your-site/
#AICrawlers #BotBlocking #TechnicalSEO
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Соблюдение robots.txt — дело добровольное.
А вот блокировки на уровне сервера, CDN или фаервола обойти нельзя: запрос жестко отклоняется, и у краулера нет выбора.
Стандартный SEO-софт не выводит эту разницу: при краулинге урл может отдавать 200, тогда как ИИ-краулер получает 403, страницу-заглушку или вообще другой ответ.
Временное окно закрывается.
С 15 сентября 2026 года Cloudflare применяет новые дефолтные правила для свежих доменов: боты, классифицированные как Training или Agent, блокируются на страницах с рекламой, в то время как ботам класса Search доступ открыт.
Это же обновление меняет то, как блокировки ИИ-тренировок (включая старую настройку "Block AI bots") обрабатывают гибридных краулеров Search + Training.
Опенсорсный bash-скрипт bot-block-checker вскрывает эту слепоту без доступа к логам.
Сначала он запрашивает урл со стандартной строкой User-Agent от Chrome, чтобы зафиксировать базу, а затем отправляет тот же запрос, подставляя более 30 строк User-Agent различных ботов и краулеров.
Статус-кода самого по себе недостаточно — 200 может оказаться страницей-заглушкой, — поэтому скрипт также сравнивает размер тела ответа и ищет известные паттерны блокировок относительно базового запроса.
Любой 429 перепроверяется изолированно, чтобы отделить реальную блокировку от ложноположительного срабатывания из-за слишком частых запросов.
Одной локации тоже мало, потому что один и тот же бот получает разные ответы в зависимости от входящего IP.
Прогони тест дважды: с локальной машины на резидентном IP и через Google Cloud Shell на датацентровом IP.
Затем сравнивай результаты:
— Блокировка в обеих средах при доступной базе: конкретное правило против бота, разбирайся с ним в первую очередь.
— Блокировка только в одной среде: проблема на уровне сети, например, фильтрация датацентровых IP или гео-ограничения; само по себе это ничего не доказывает.
— Идентичный успешный ответ везде: нет признаков того, что к этому User-Agent относятся иначе.
Заблокированный бот — это не всегда проблема.
Если сайт отшивает Bytespider, это не бьет по SEO или AEO.
Блокировка становится критичной, когда она срезает краулеров класса Search или Agent, которые должны находить, извлекать или цитировать контент.
Скрипт не может на 100% сымитировать запрос от реального краулера.
Воспринимай любой флаг как сигнал, а не как железобетонное доказательство: подтверждай данные в конфигурации CDN/сервера или логах, прежде чем нести их инфра-команде.
https://athenseo.com/knowledge-hub/how-to-check-if-ai-crawlers-can-actually-reach-your-site/
#AICrawlers #BotBlocking #TechnicalSEO
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO