


Alibaba: выпустили языковую модель Qwen 3 с гибридным режимом работы: обычный и рассуждение.
Часть серии ллм включает в себя обычные модели 0.6B // 1.7B // 4B // 8B // 14B // и 32B. Версия на 0.6B может работать на телефоне, для 14B поместится в 24 ГБ VRAM, а 32B надо будет запускать уже с выгрузкой в RAM. Модели 0.6B - 4B имеют контекст 32к (можно кормить книжки), остальные 128к (небольшая библиотека).
Также 0.6B может использоваться для ускорения больших моделей посредством предсказывания очевидных токенов. Задаётся через настройку speculative decoding в боковой панели LM Studio или llama.cpp.
Другая часть это экспертные модели (MoE) 30B-A3B и 235B-A22B, у которых количество параметров 30B и 235B соответственно, а активных 3B или 22B. Тут у всех контекст 128к. Эти модели уже для запуска на серверах.
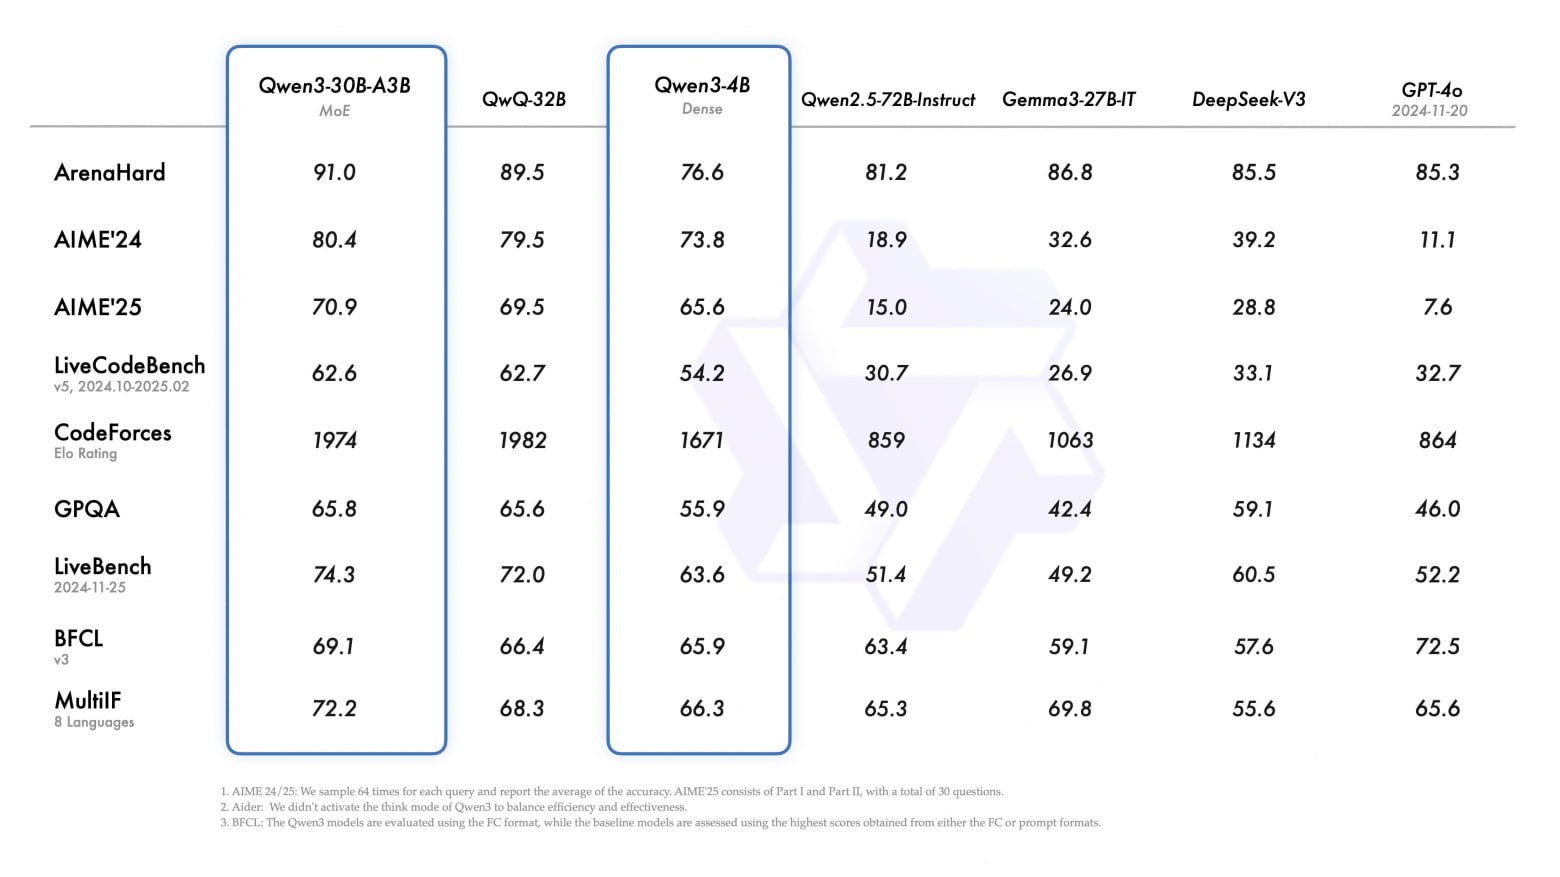
По бенчам бьёт другие опенсорсные модели и закрытые вроде Gemini 2.5 Pro, Grok 3, и o3-mini. Хорошо себя показывает как в креативном копирайтинге, так и написании кода и математике.
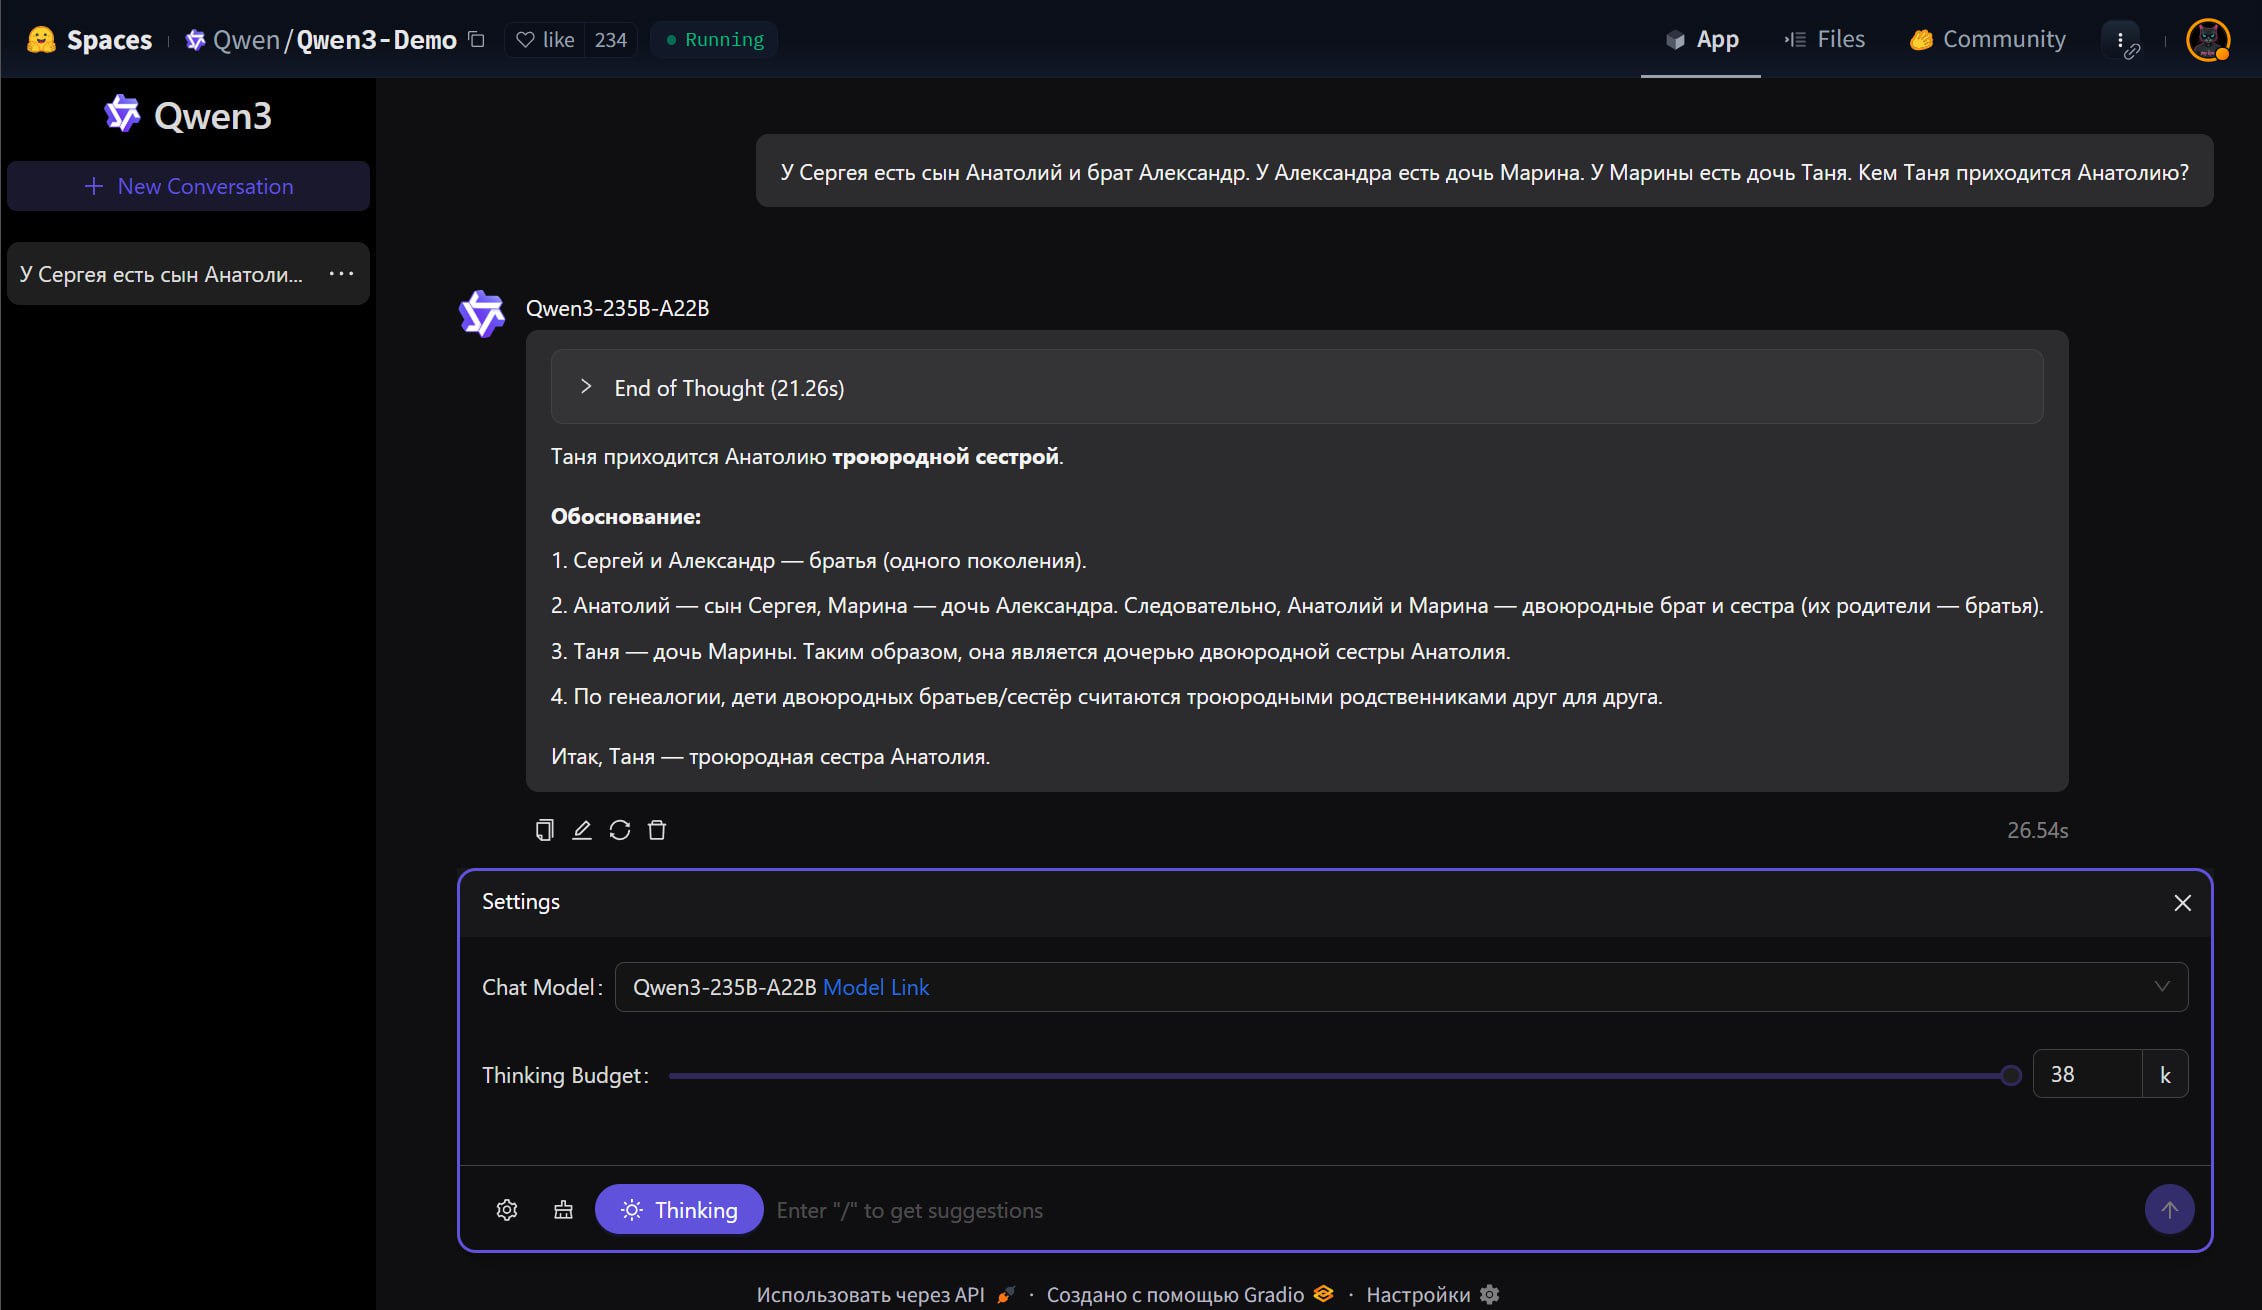
Как и прежде русский язык поддерживается. Режим размышлений можно выключать или задать бюджет на это (thinking budget), что может ускорить ответы.
Уже завезли в ollama и можно гонять в OpenWebUI. Или просто скачать LM Studio и прямо там в интерфейсе подберется оптимальная модель под ваше железо.
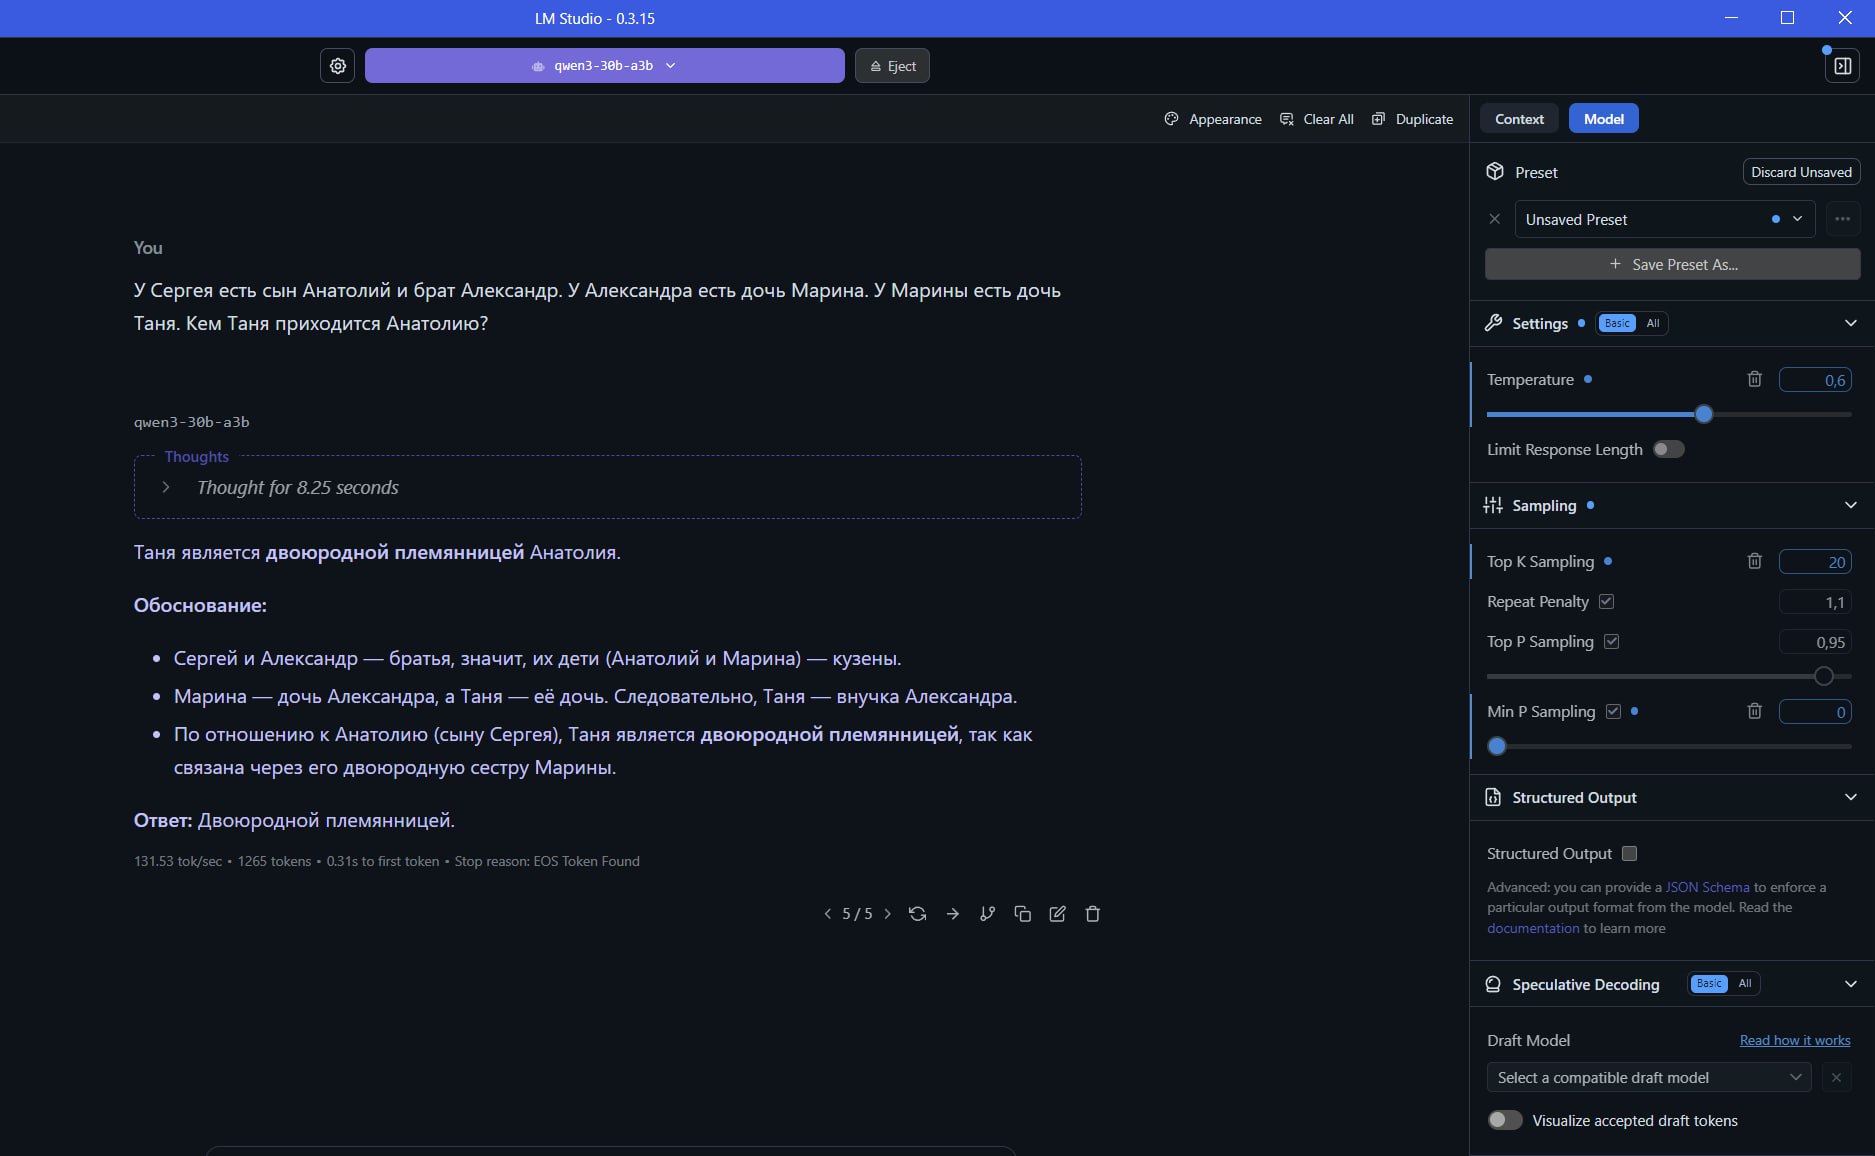
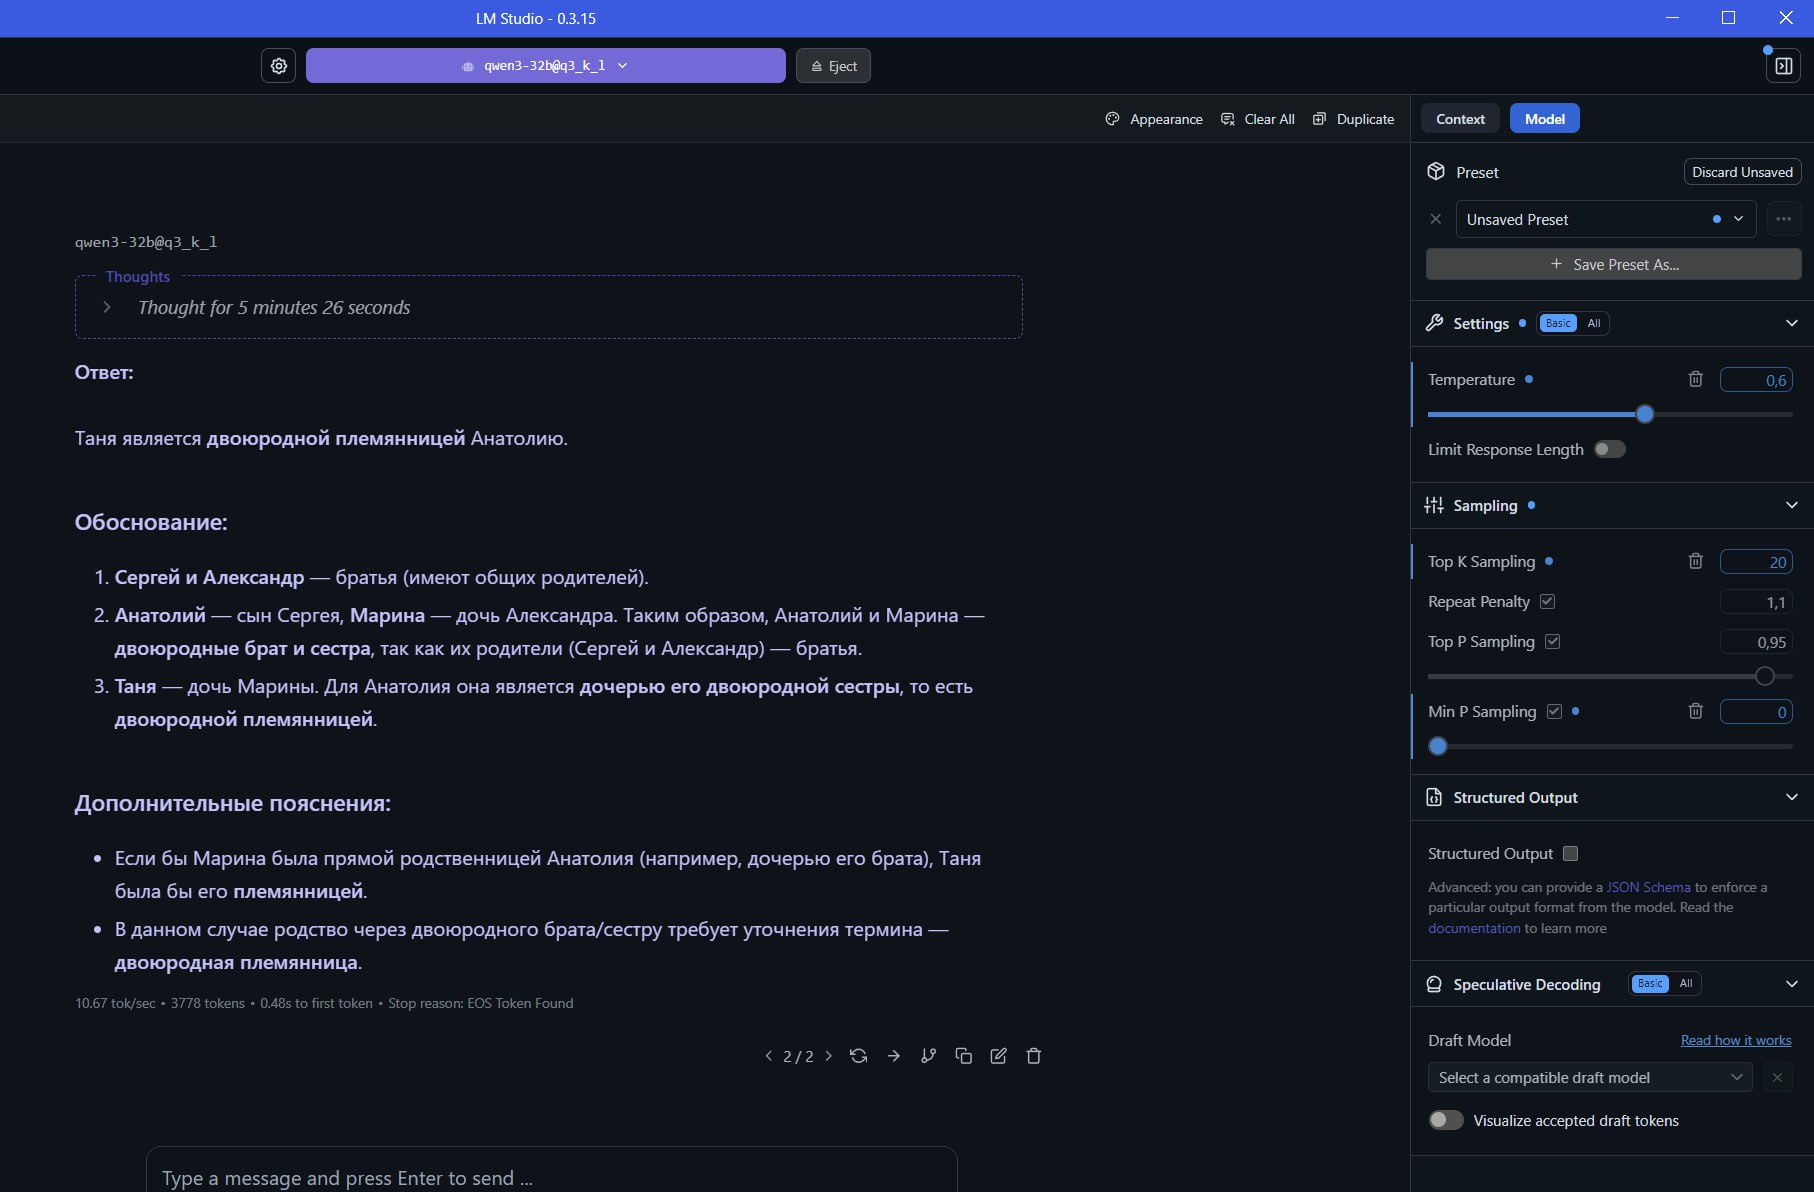
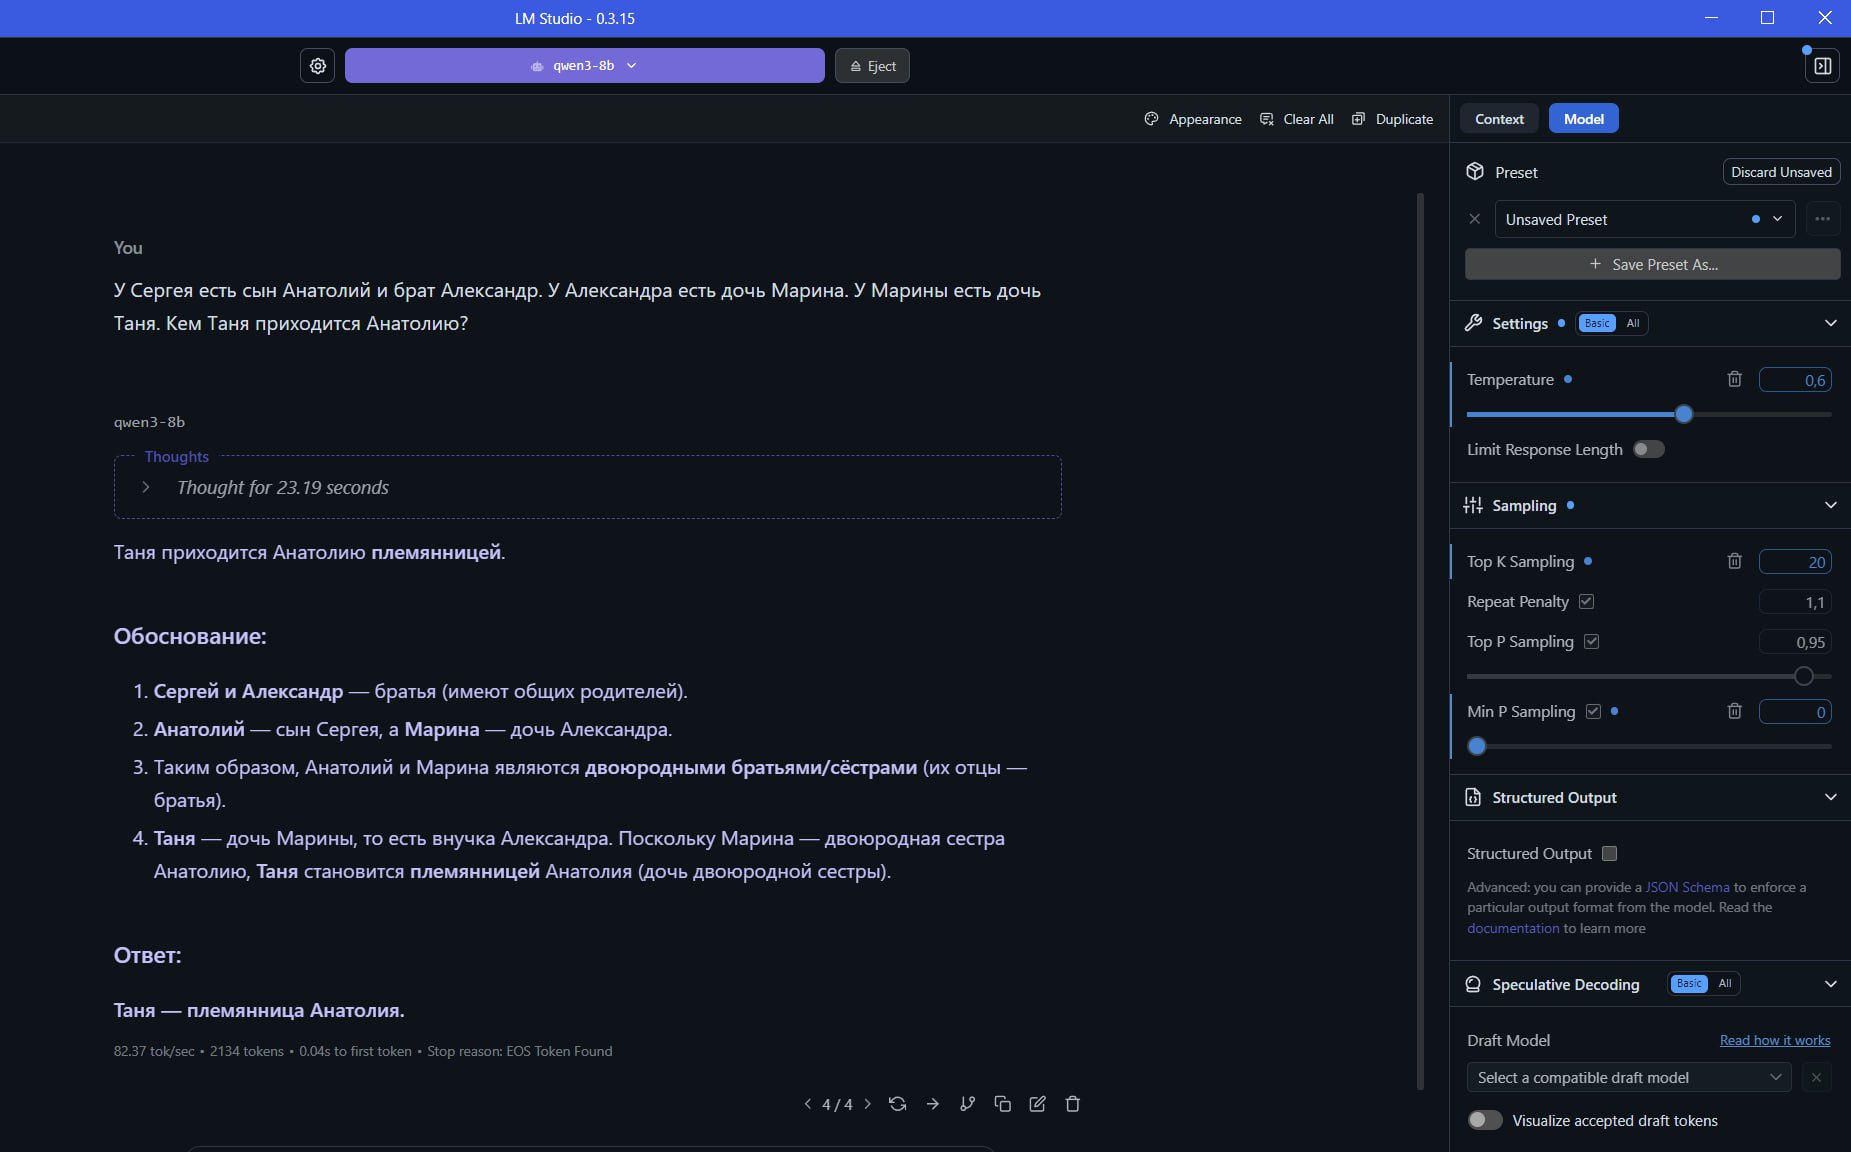
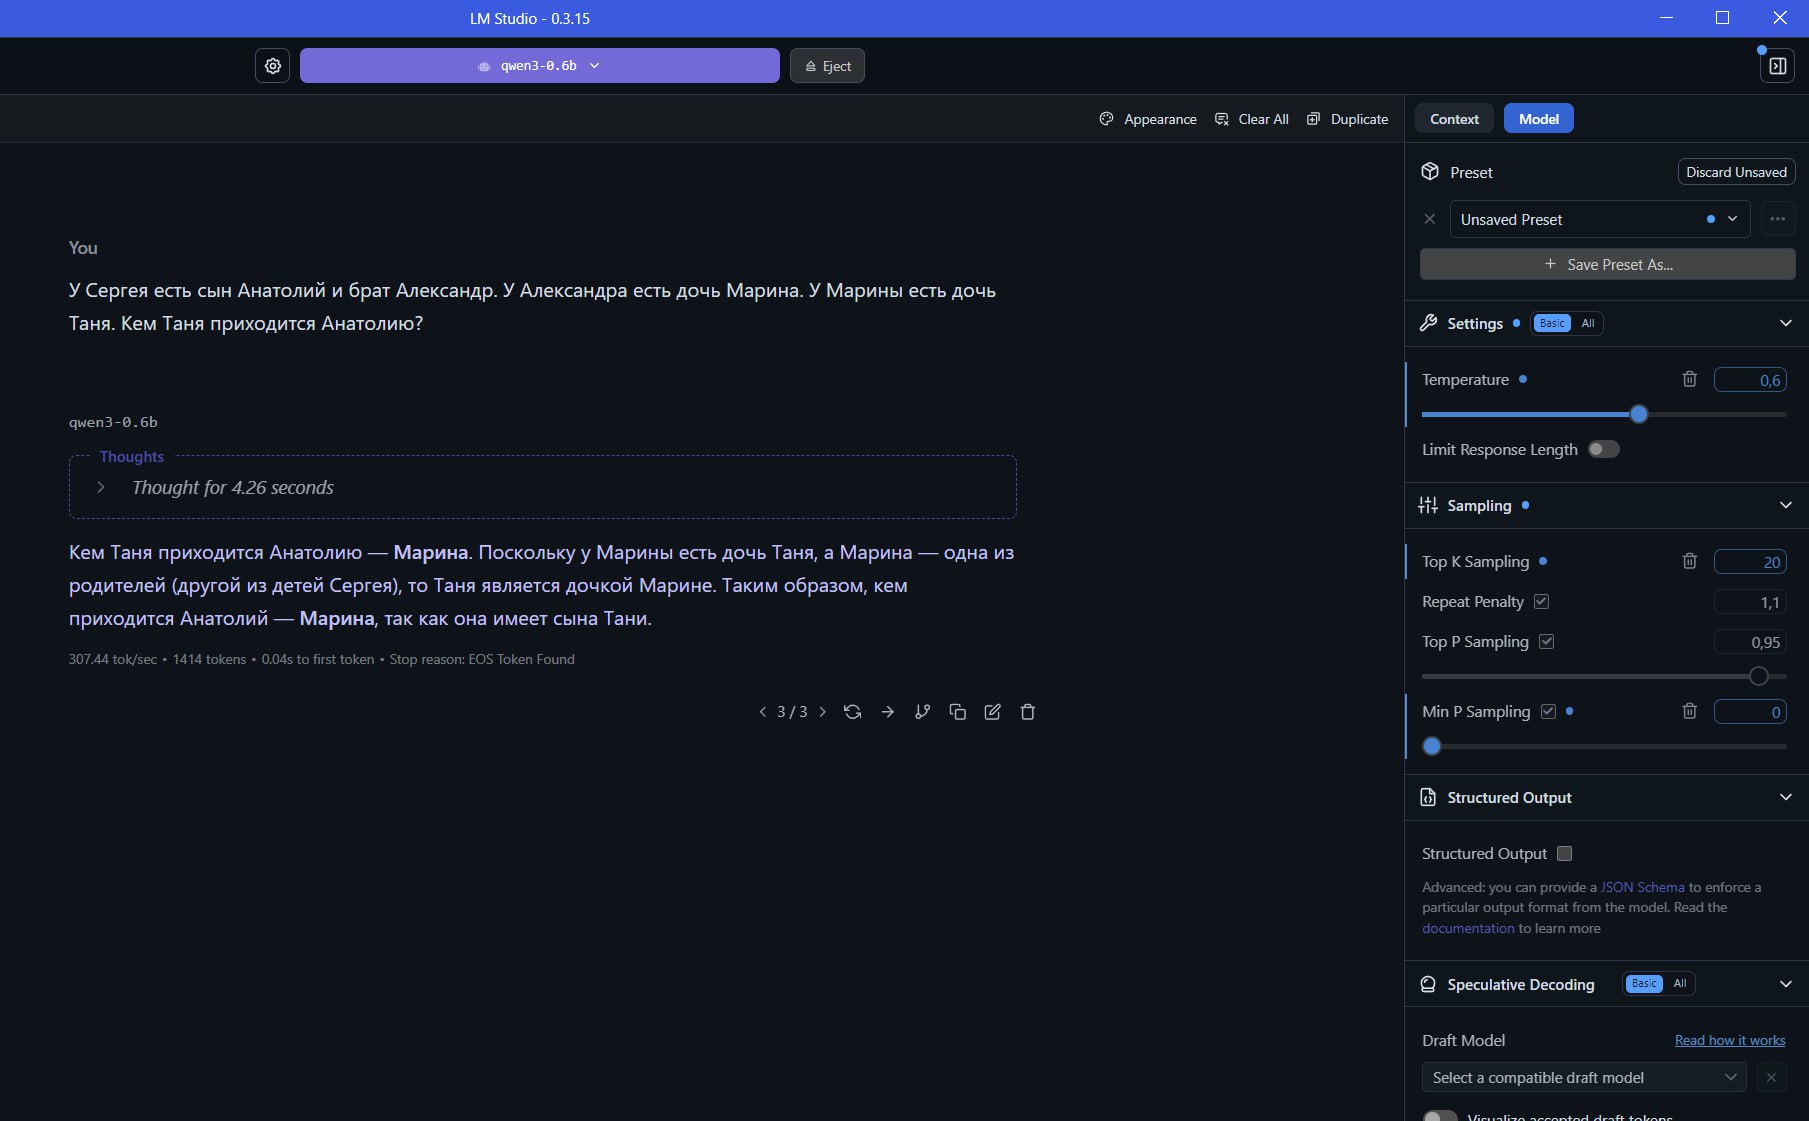
Для получения оптимальных результатов рекомендуется: при рассуждениях ставить настройки Temperature=0.6, TopP=0.95, TopK=20, и MinP=0, а при обычном режиме Temperature=0.7, TopP=0.8, TopK=20, и MinP=0. Я сначала прогнал свой тест на родственные связи (правильный ответ — двоюродная племянница) без этих настроек и результат был хуже, а где-то модель уходила и вовсе в мыслительный лимб.
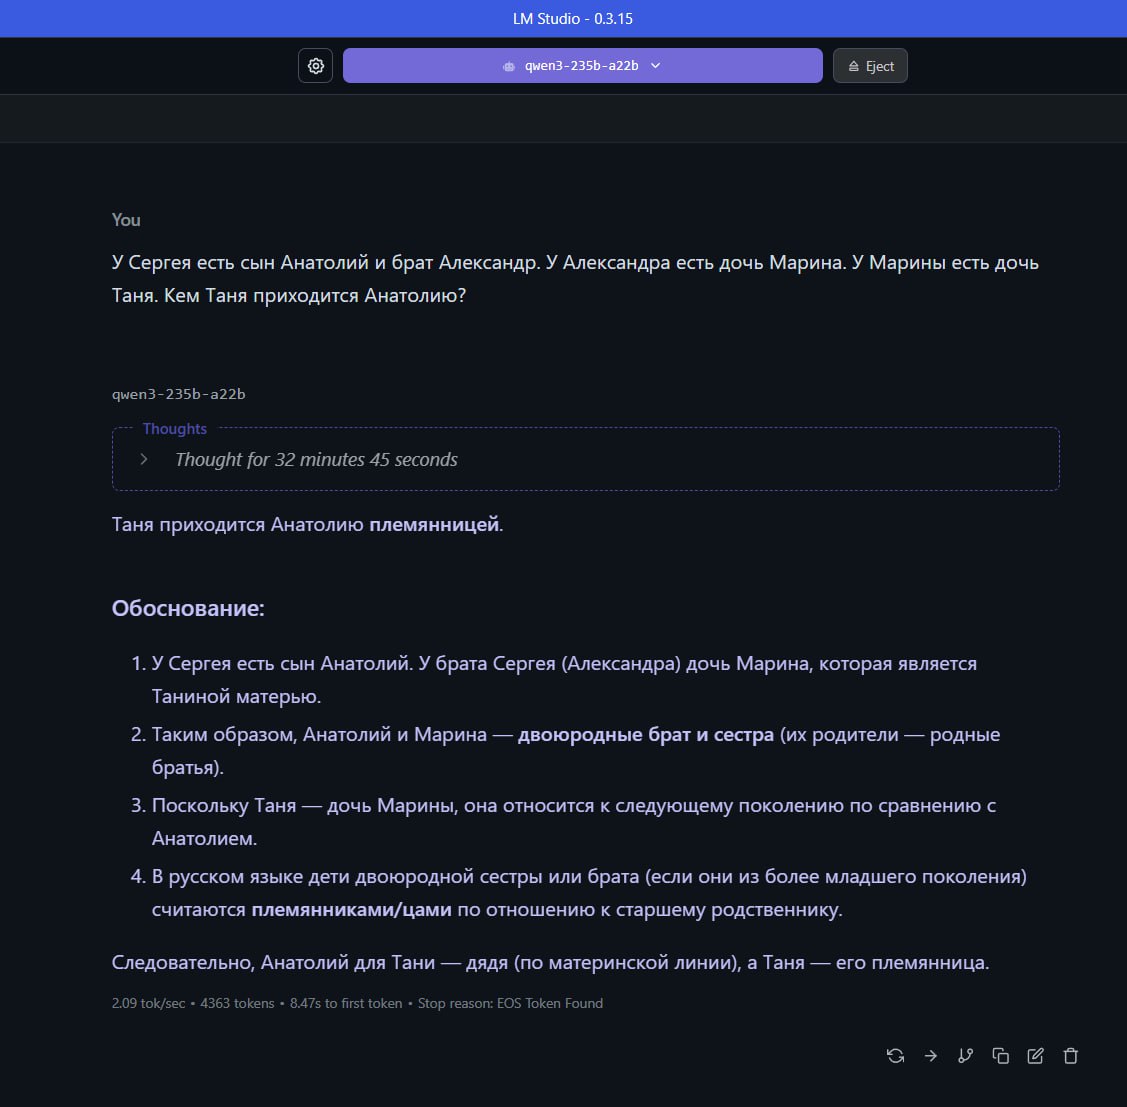
Модели 0.6B и 1.7B можно будет гонять на смартфоне, например, через PocketPal или в браузере через WebGPU. А я решил помимо промежуточных вариантов ещё попробовать запустить у себя самый крупняк в самом простом варике весом 111 ГБ... Штош, оно запустилось, съело и почти все 24 ГБ VRAM и 128 RAM, а ответ занял 34 минуты и не сказать, что впечатлил.
Меньшие размеры были и пошустрее и пришли к правильному ответу:
❌ 0.6B (Q8_0) — 307.44 ток/с // 4,26 сек
❌ 8B (Q8_0) — 82.37 ток/с // 23,19 сек
✅ 32B (q3_k_l) — 10.67 ток/с // 5 мин 26 сек
✅ 30B-A3B — 131.53 ток/с // 8,25 сек
Демо (хаггинг)
Демо (сайт)
Приложение (Android // iOS).
Анонс
Гитхаб
Хаггинг
Ollama
————————————————————
🔥 Создай своего цифрового двойника, оживи персонажа, или интегрируй бренд. Напиши — @AndreyBezryadin