


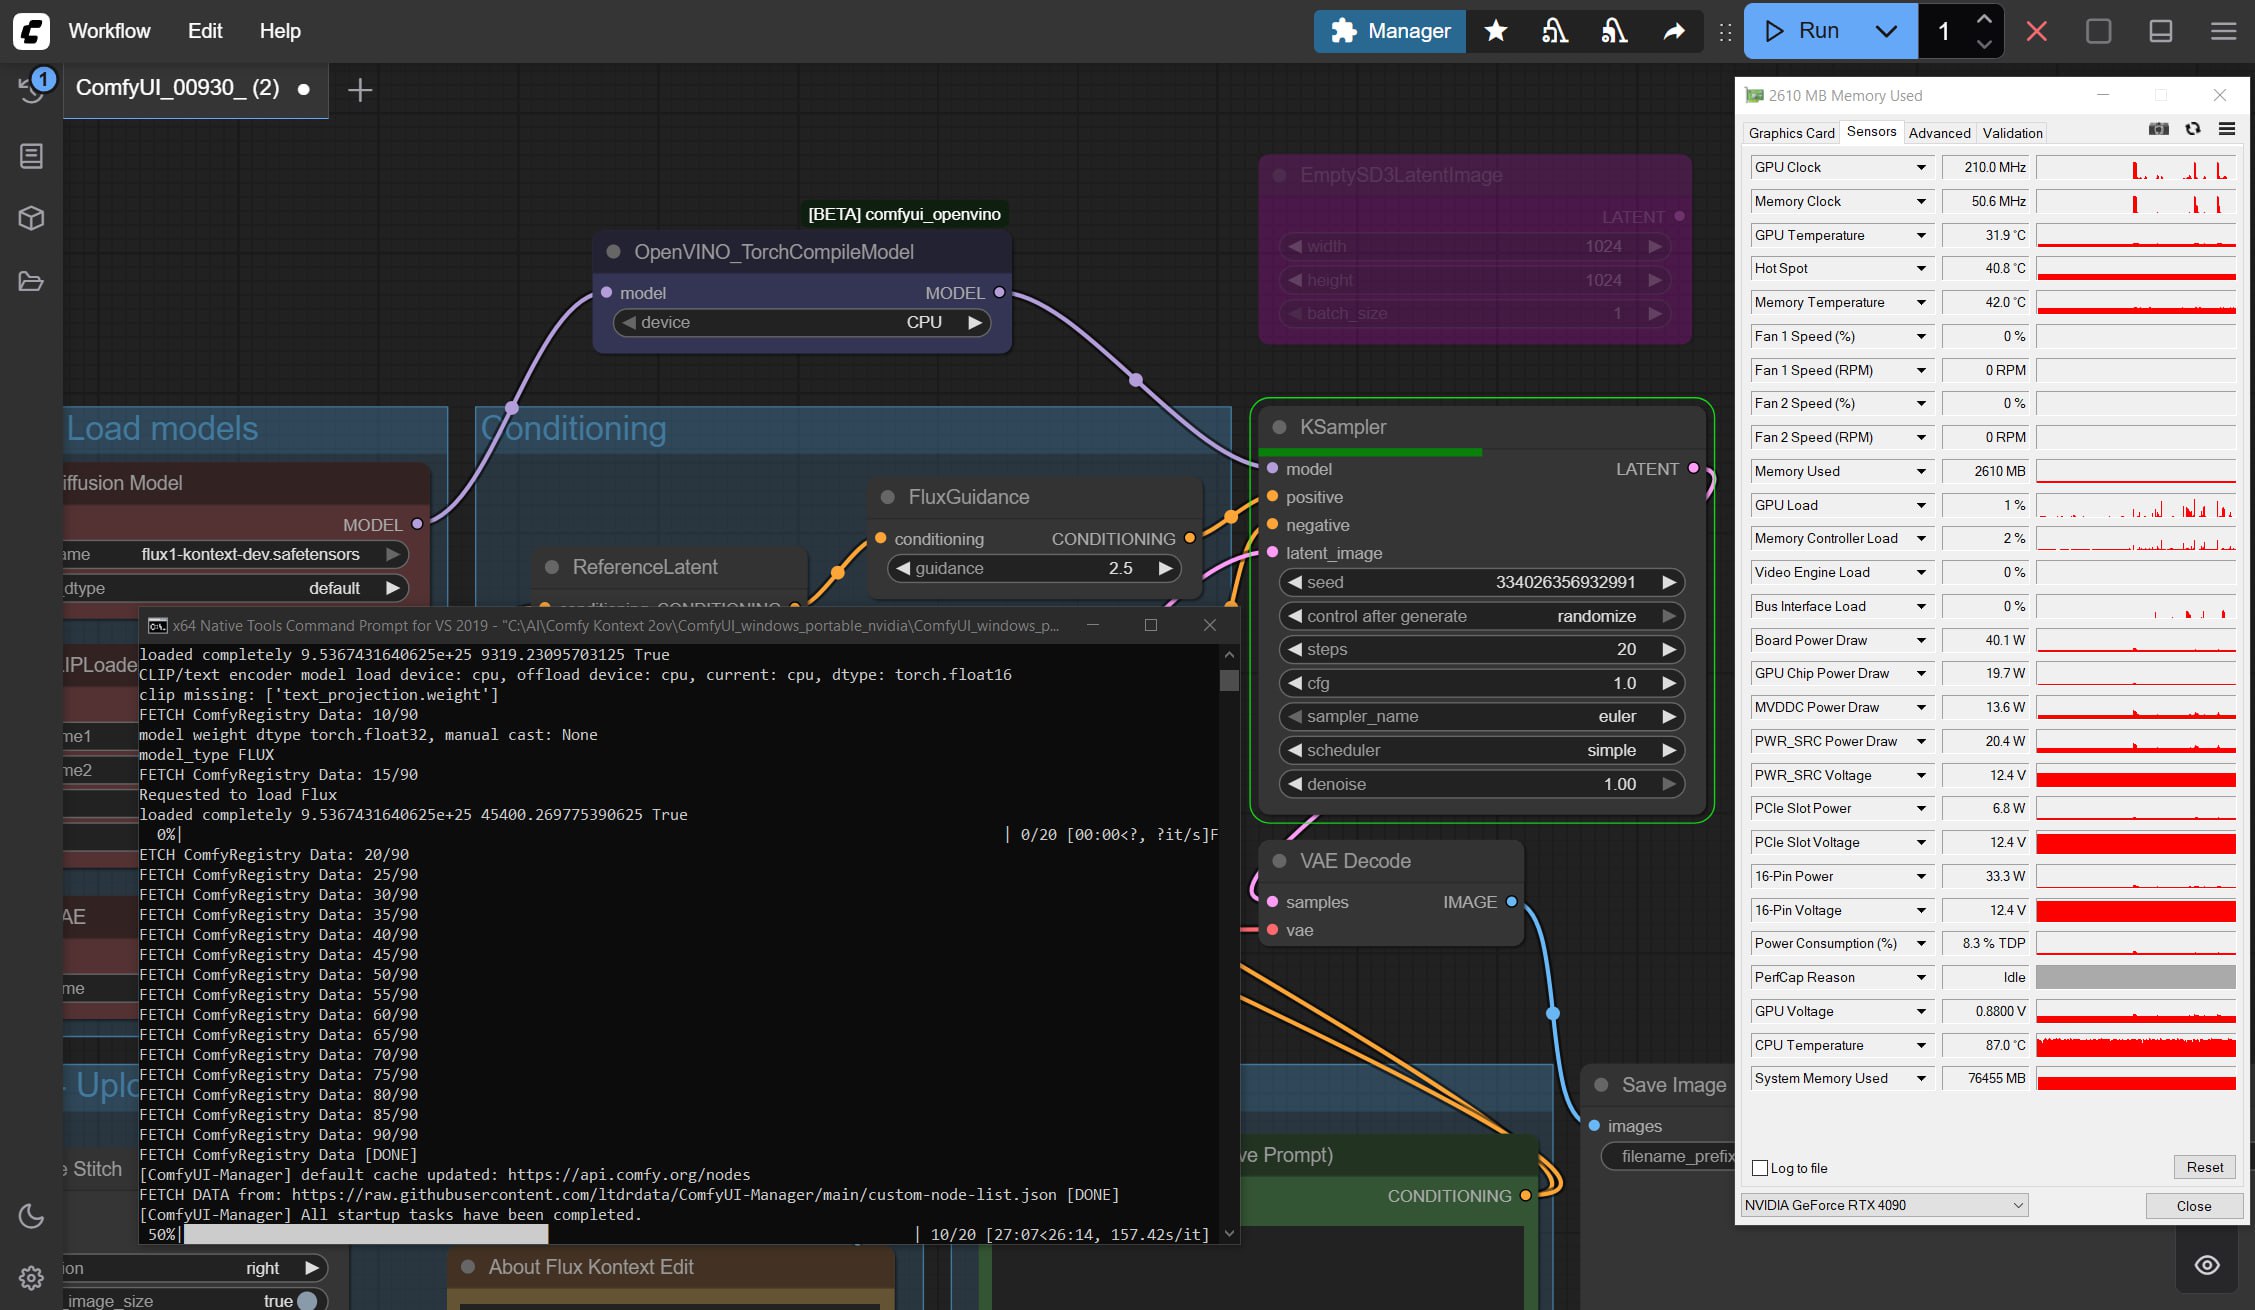
Comfy: добавили ноду IntelVINO для оптимизации генерации на железе Intel, включая cpu, gpu, npu.
Нода OpenVINO_TorchCompileModel ставится через Comfy менеджер. Апдейт позволяет получить существенное ускорение создания контента, не жертвуя качеством.
Для работы нужен Triton. Есть билд на Windows и на Linux. Я долго ходил вокруг да около него, не хотел и брыкался, а он поставился быстро и безболезненно. Главное следовать инструкциям с гитхаба. Бонусом идёт то, что он нужен для всяких Sage, Flash, и прочих атеншенов. Так что на OpenVINO с ним история не заканчивается.
Чтобы ноду привести в работу, нужно запустить Comfy с параметрами:
Для портативной версии:
.\python_embeded\python.exe -s ComfyUI\main.py --cpu --use-pytorch-cross-attention --windows-standalone-build
pause
Для декстопной (хотя я не нашёл в настройках где вбить):
python3 main.py --cpu --use-pytorch-cross-attention
Нода должна соединять загрузчик модели и KSampler как на видео. Если при запуске у вас будет ошибка про компилятор cl, добавьте путь до cl.exe в переменную среды Path. Путь типа такого:
C:\Program Files\Microsoft Visual Studio\2022\Community\VC\Tools\MSVC\14.43.34808\bin\Hostx64\x64
Мне со всеми ошибками помог справиться бесплатный Grok. Можете юзать любую ллм на свой вкус, чтобы решить задачку.
Первый запуск может быть долгим из-за компиляции шейдеров торча в оптимизированную версию для запуска на своём железе. Второй должен быть значительно шустрее.
На моём i9 12900k первый прогон занял 50 минут на дефолтную генерацию через Flux Kontext в 20 шагов (на 4090 это 28 сек для сравнения). При этом температура цп поднимается до 87, а потребление RAM до 77 ГБ.
Второй прогон... также. Пока не ясно, что именно не так, будем выяснять. У кого производительность забустилась отпишитесь в комментах.
UPDATE: удалось завести. Первая генерация 37 секунд, потом ускоряет Kontext в fp8 с 24 сек на картинку до 16 сек. Если запустить в сочетании с SageAttention и флагом в батнике --gpu --use-pytorch-cross-attention, то можно добить до 12 сек на генку, но может работать нестабильно. Папка python_embeded со всем нужным в комментах в виде архива. BF16 Kontext не ускоряется ибо не помещается целиком в 24 ГБ VRAM.
Анонс
Triton (Windows)
Triton (Linux)