


Репост из: AI❤️4Life prod
✴️ DeepSeek V4.1 Flash: 552 млрд параметров, 1 млн контекста и цена Flash вместо Pro
DeepSeek выпустила V4.1 Flash – новую мультимодальную модель с архитектурой Causal Encoder-Decoder. Всего в ней 552 млрд параметров, но на один токен активируется около 8 млрд при чтении входных данных и 16 млрд при генерации ответа.
Такое разделение хорошо подходит для агентных задач: модель читает огромные системные промпты, кодовые базы, историю диалога и результаты инструментов, а выдаёт сравнительно короткое решение.
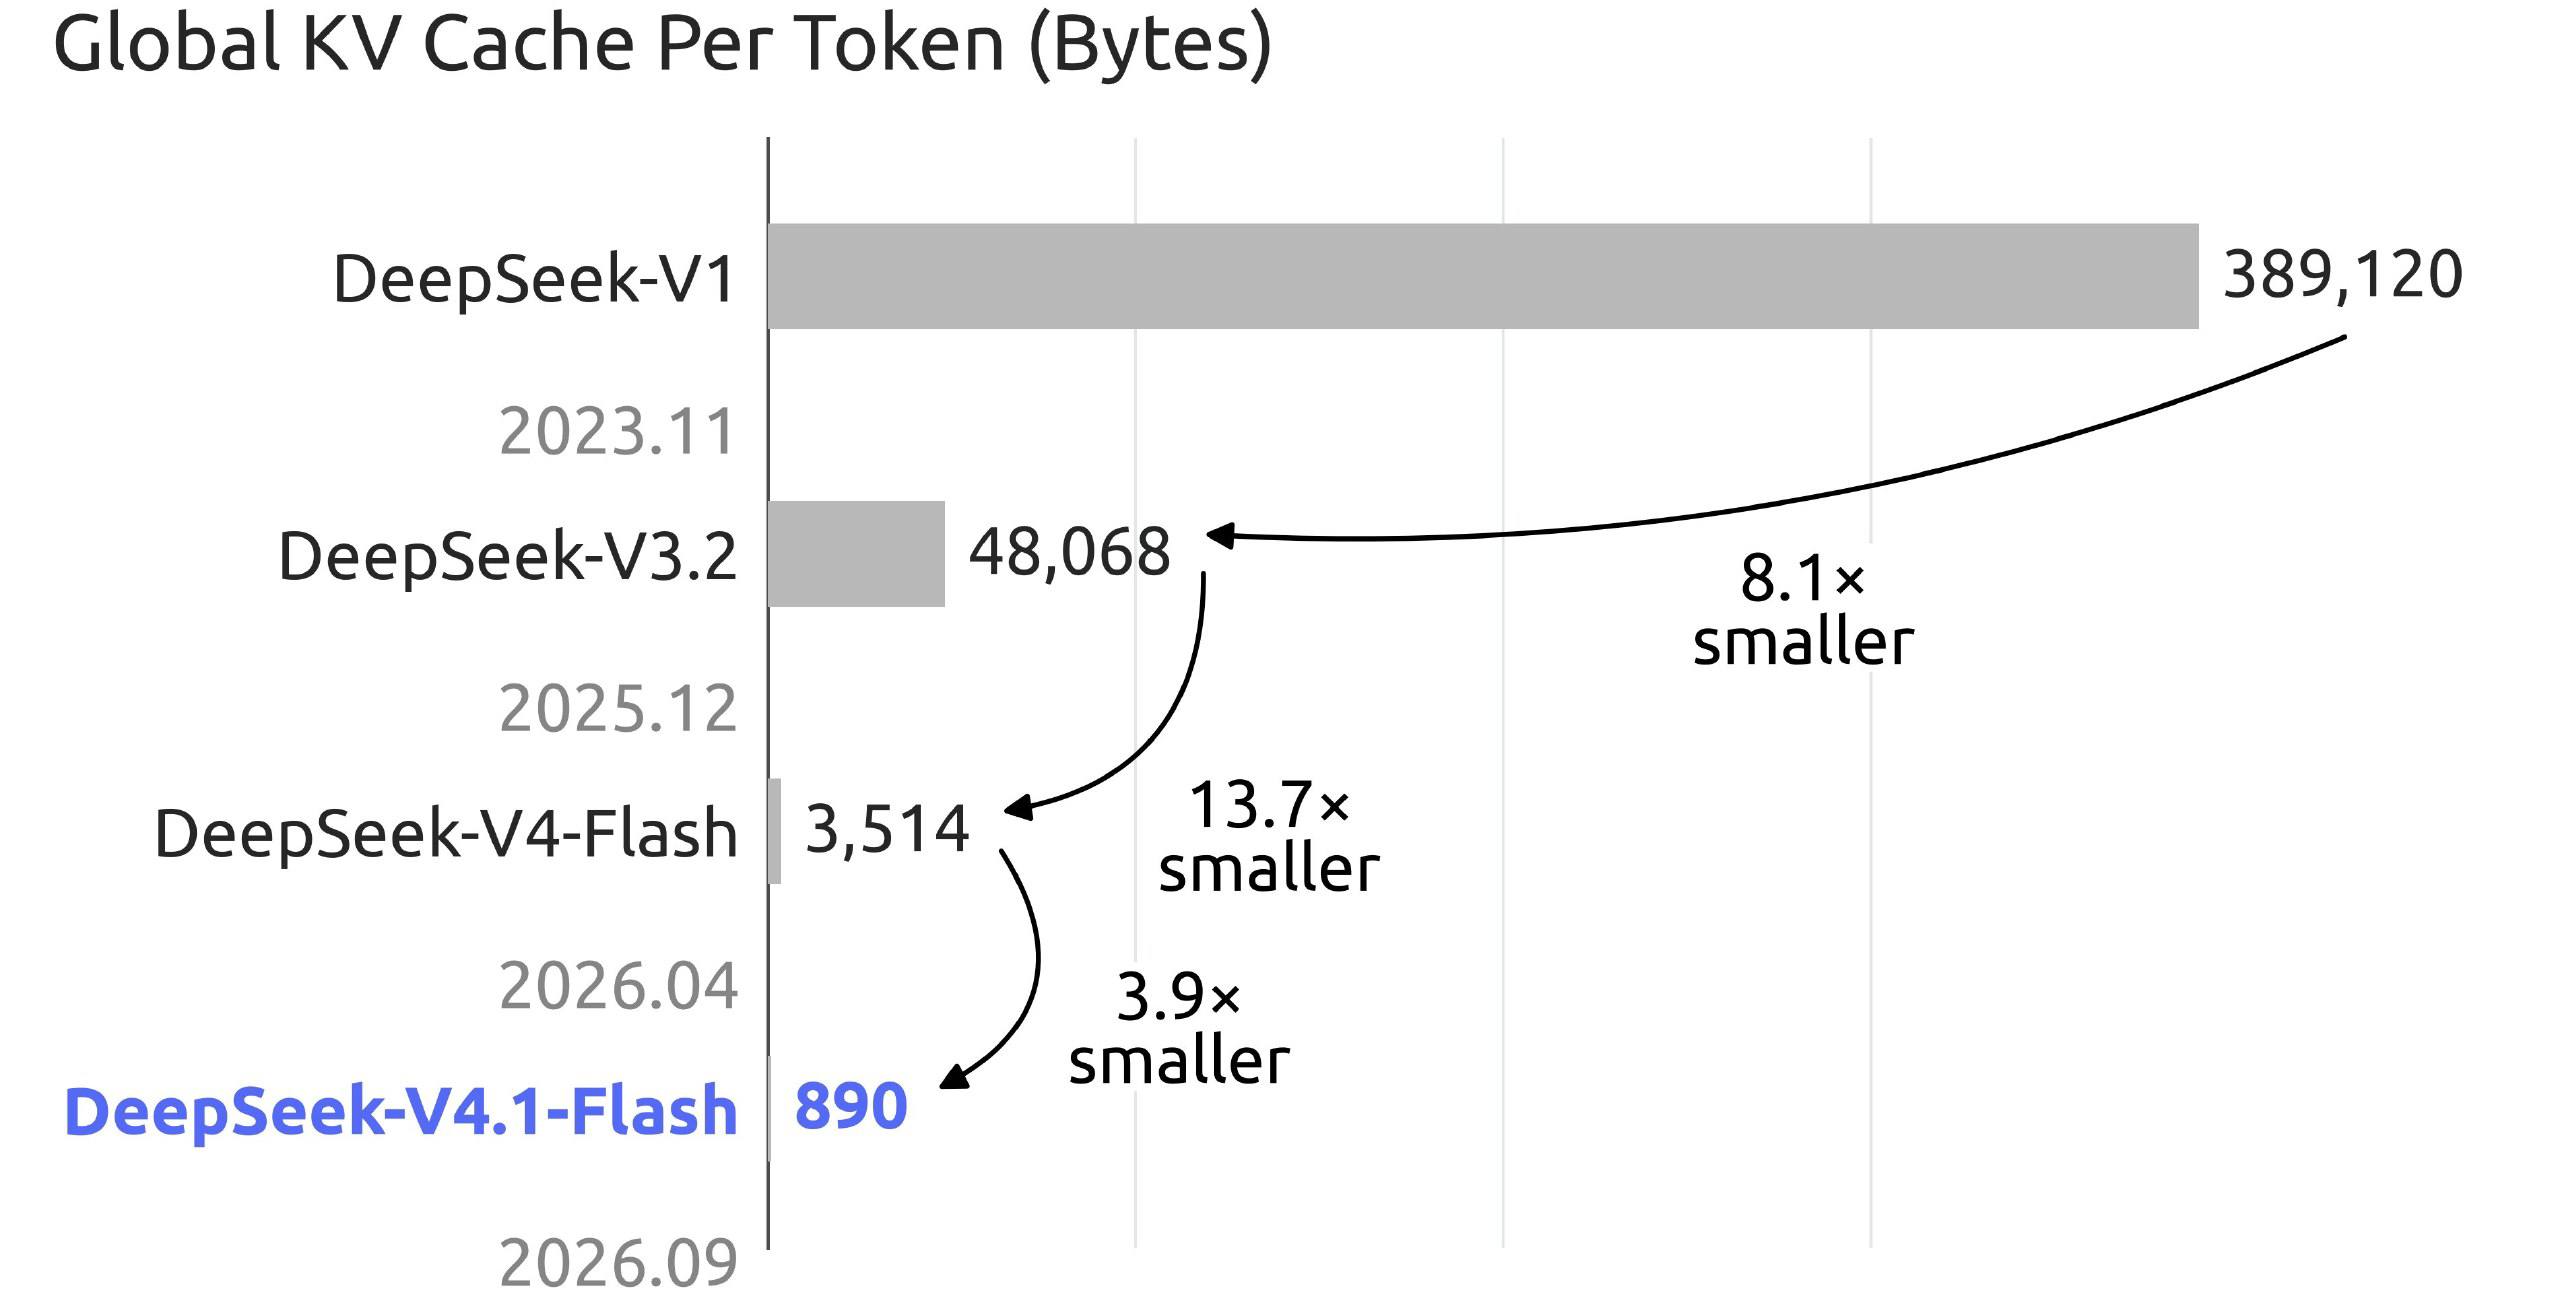
• 🧠 KV Cache: глобальный кэш сжат до 890 байт на токен – примерно в четыре раза меньше, чем у V4 Flash
• 👁 Мультимодальность: текст и изображения поддерживаются прямо в основном API-моделе
• 📚 Контекст: до 1 млн токенов
• 🎛 Мышление: доступны режимы с разной глубиной рассуждений
• ⚡️ Инфраструктура: новая архитектура рассчитана на более быстрый inference и высокий throughput
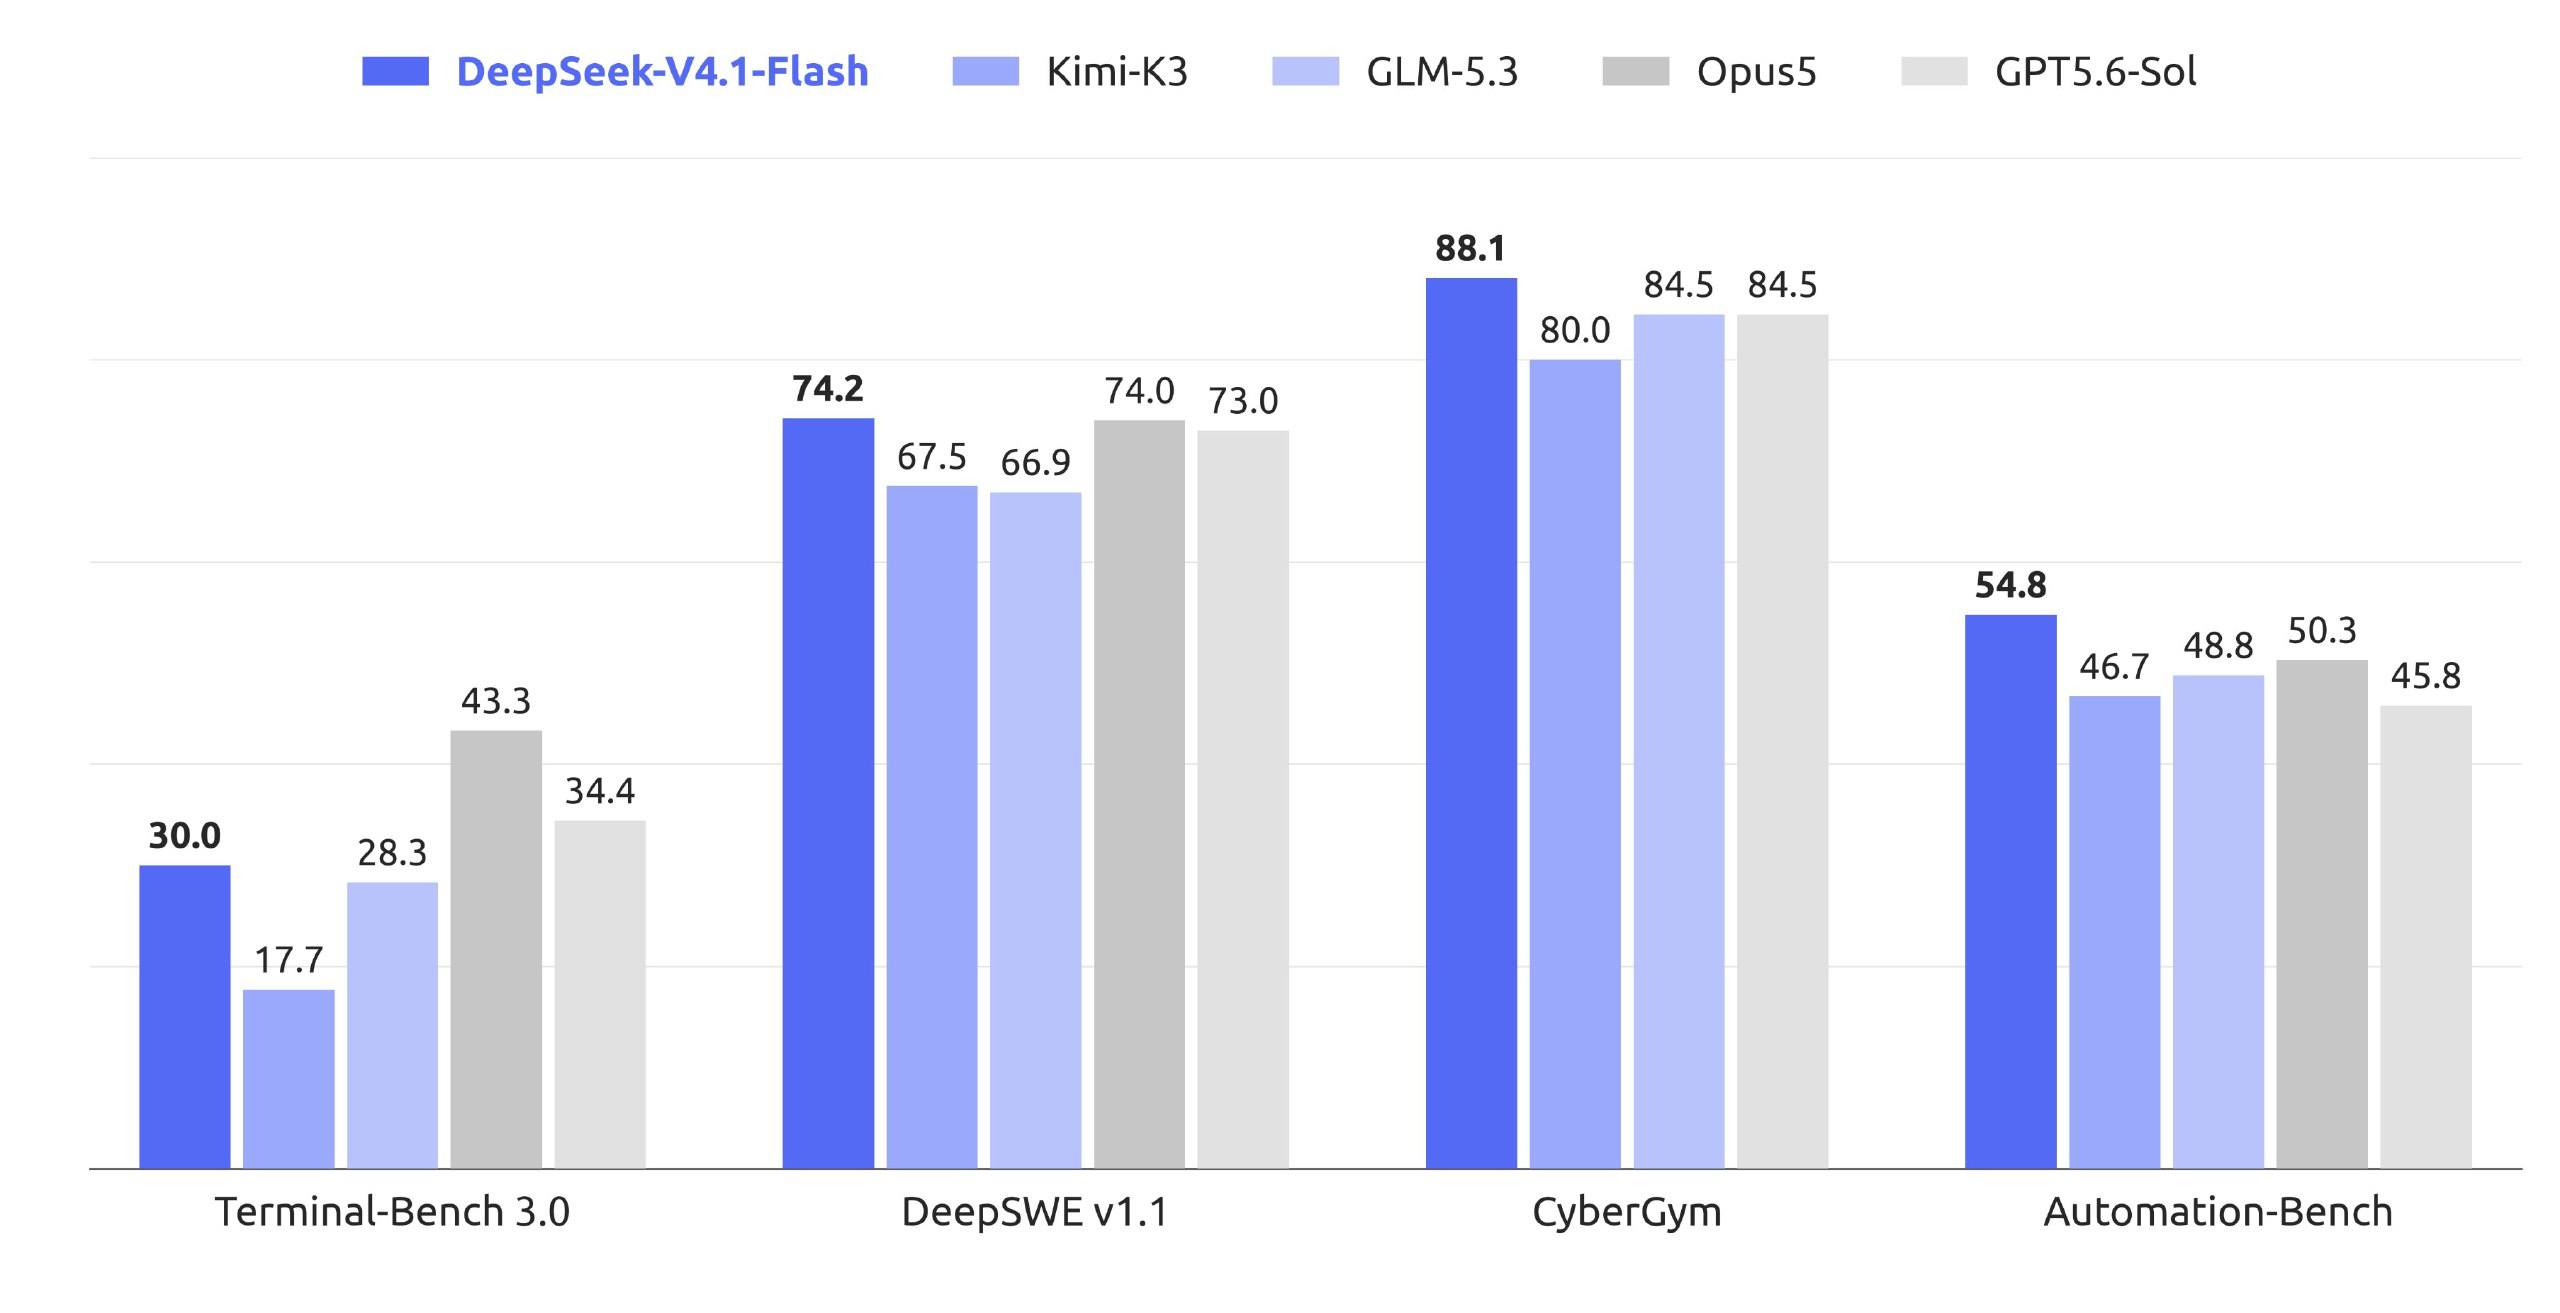
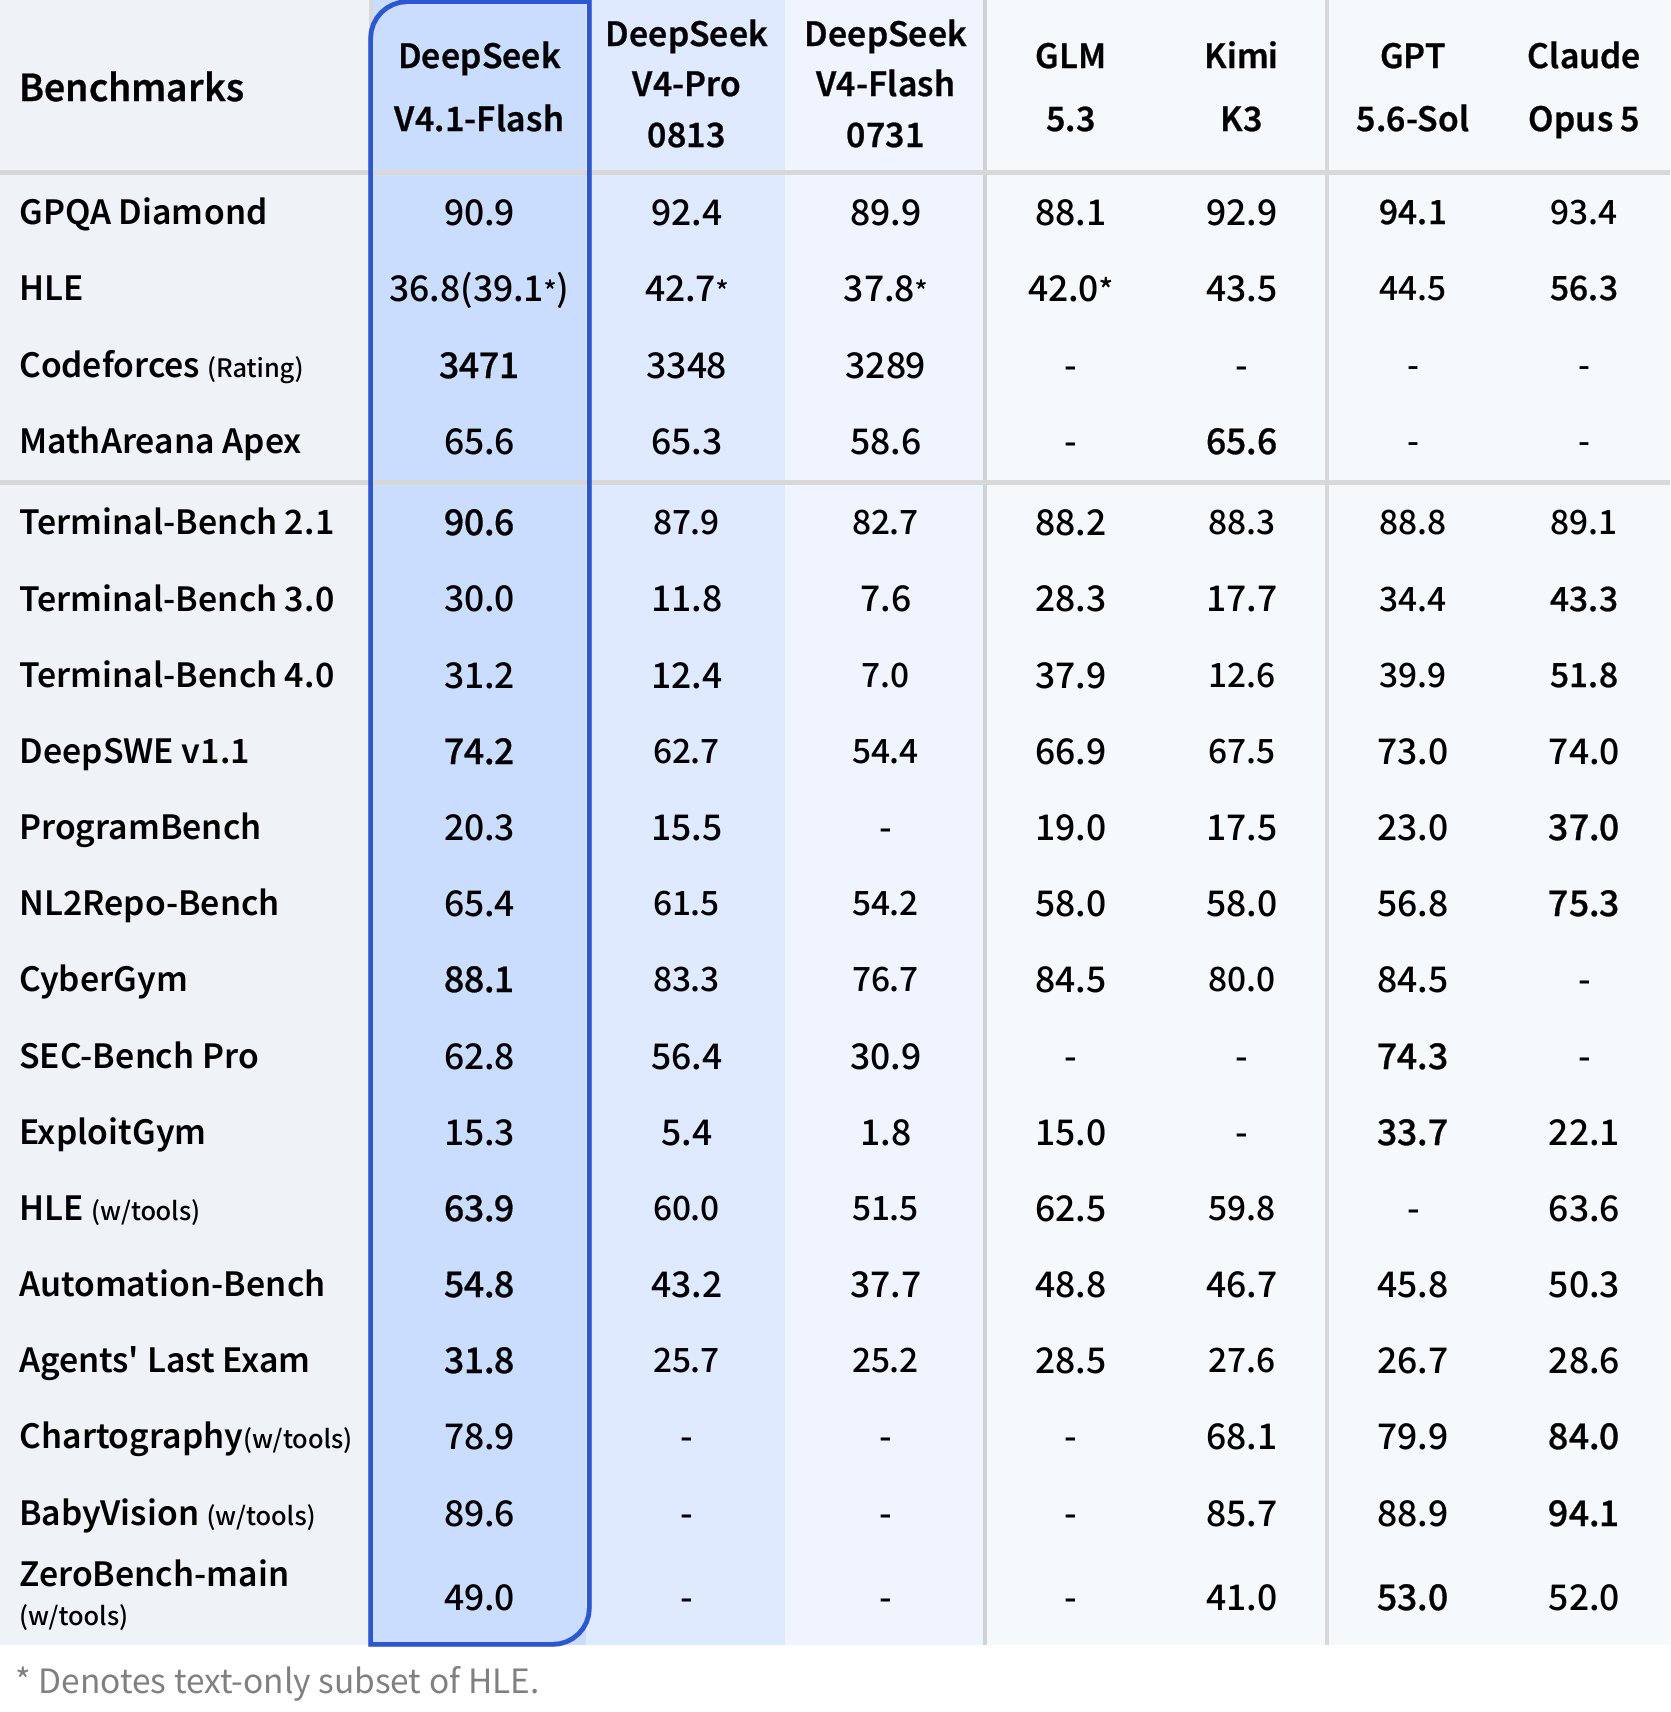
В официальных тестах DeepSeek V4.1 Flash набрала 90,6% на Terminal-Bench 2.1, 74,2% на DeepSWE v1.1 и 88,1% на CyberGym. Также модель получила 90,9 на GPQA Diamond и рейтинг 3471 в Codeforces. DeepSeek заявляет, что по производительности, стоимости, скорости и общему времени выполнения новая Flash превосходит V4 Pro.
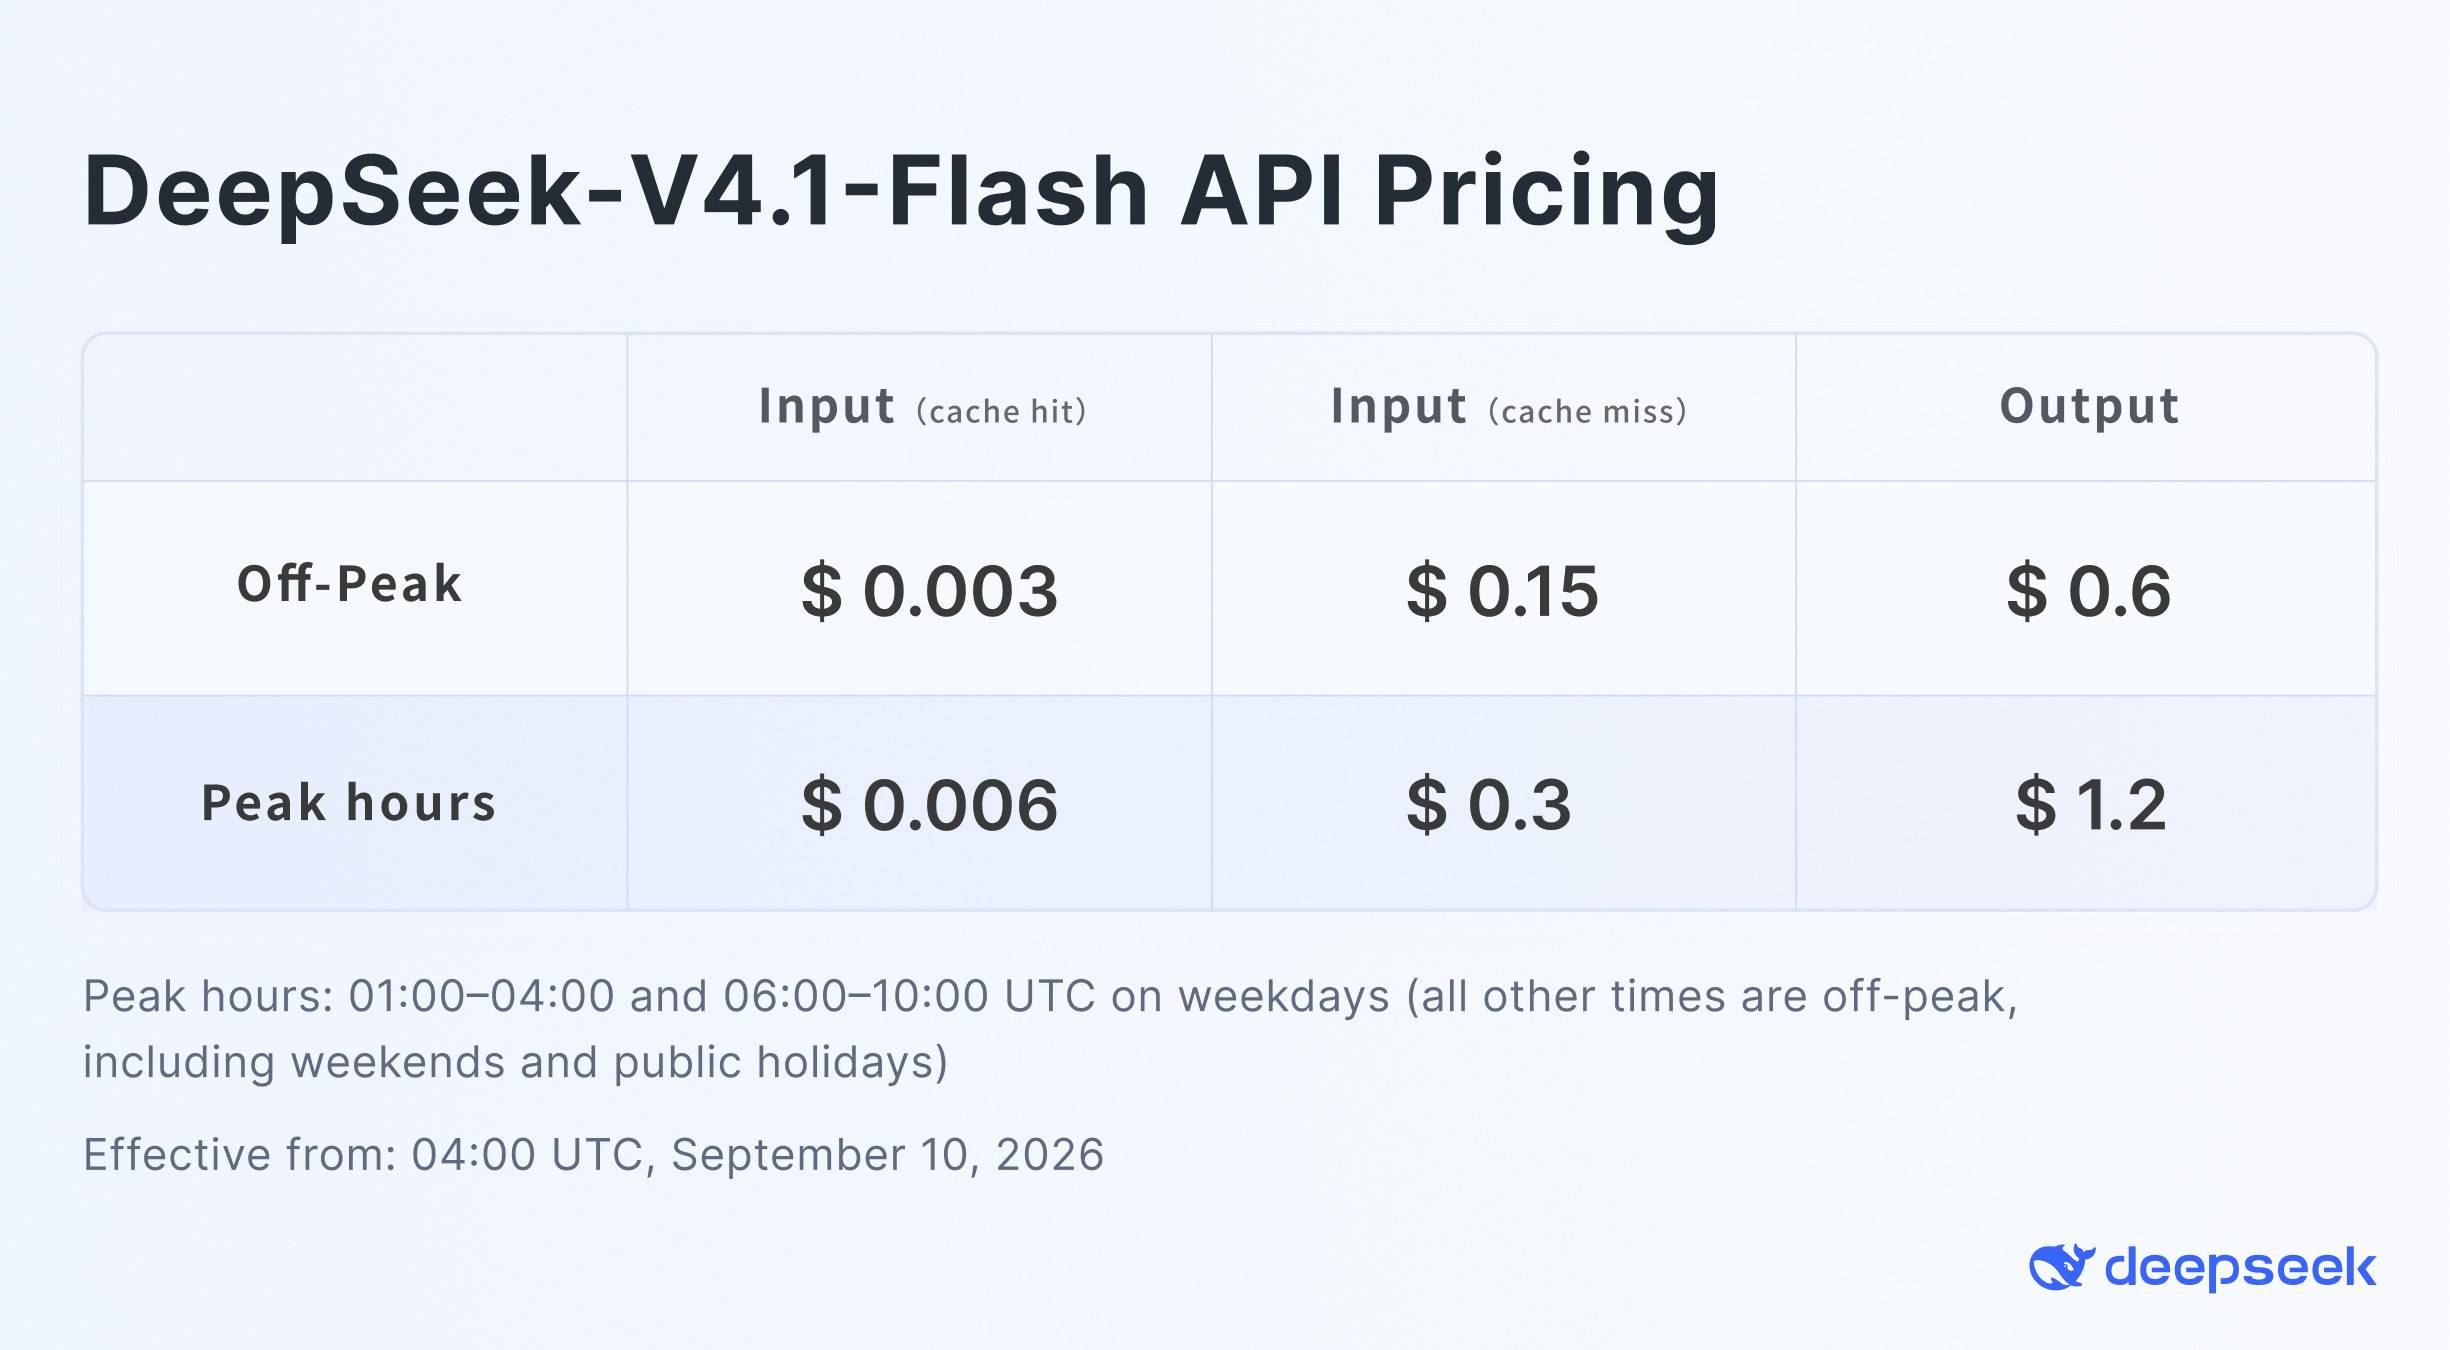
Цены снизились одновременно с релизом:
• 💾 Cache hit: 0,02 юаня за миллион токенов в непиковые часы
• 📥 Cache miss: 1 юань за миллион токенов
• 📤 Вывод: 4 юаня за миллион токенов
В пиковые часы ставки вдвое выше. Новые цены действуют с 10 сентября, а с 14 сентября запросы к deepseek-v4-pro начнут перенаправляться на V4.1 Flash и тарифицироваться по цене Flash – до выхода будущей V4.1 Pro.
Для API используется имя deepseek-flash. Старые идентификаторы V4 Flash и V4 Flash Vision Exp временно сохранят совместимость, но уже будут вести на новую модель.
Самое интересное здесь не только в benchmark. DeepSeek оптимизирует модель под длинные агентные циклы: повторяющийся контекст, RAG, кодовые базы, tool calls и диалоги, где стоимость KV Cache быстро становится важнее красивой цены за один короткий запрос.
🔗 Официальный changelog DeepSeek
🔗 Технический отчёт V4.1 Flash
━━━━━━━━━━━━━━━━━━━━
📢 AI❤️4Life — канал об искусственном интеллекте
🤖 SyntxAI — все самые нужные нейросети в одном сервисе
🔒 MaxVpn — Удобный и быстрый VPN
🧠 Google AI Pro — подписка на личный Google-аккаунт на 18 месяцев за 990₽
━━━━━━━━━━━━━━━━━━━━
👑 Авторский курс по созданию персональных ИИ-агентов
#ai #DeepSeek #LLM #agents #coding #нейросети