


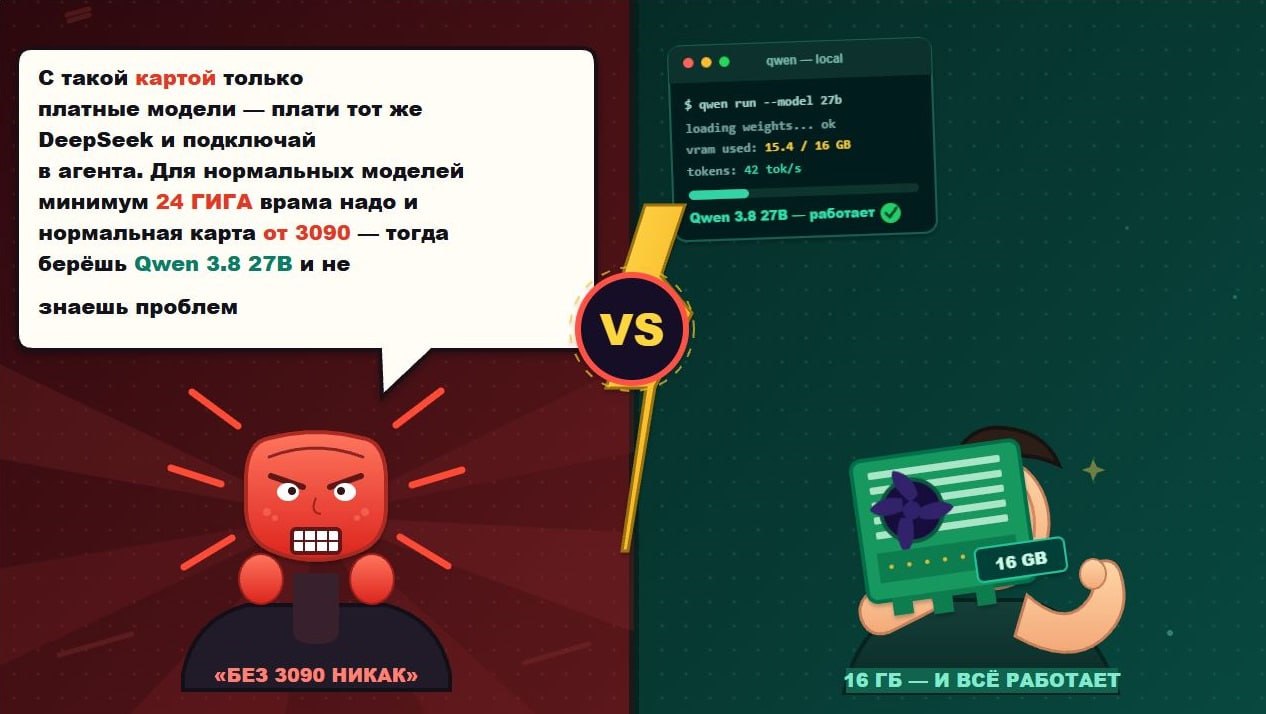
📋 Как запустить мощного ИИ-агента на видеокарте с 16 ГБ VRAM
На Хабре протестировали локальный агентный стек на RTX 5060 Ti 16GB. Автор проверил несколько квантов Qwen3.8 27B, llama.cpp и подключение к OpenCode – с упором на контекст, скорость и реальную работу с кодом.
Что внутри:
• 🧠 Требования к локальному агенту: контекст больше 80 тысяч токенов, скорость от 50 токенов/с и приемлемое качество кода
• ⚙️ Qwen3.8-27B IQ4_XS: около 15,3 ГБ, примерно 40–50 токенов/с с MTP, но контекст пришлось уменьшить
• 🧩 Qwen3.8-27B UD-Q3_K_XL: 13,2 ГБ, до 92 тысяч токенов контекста и около 50 токенов/с – наиболее сбалансированный вариант для агентного кодинга
• 🚀 Qwen3.8-27B IQ3_S с DFlash: 11,8 ГБ плюс отдельная модель предсказания, 55–65 токенов/с и до 70 токенов/с в пике
• 🛠 Настройка llama.cpp, MTP и DFlash, подключение локального сервера к OpenCode и автоматическое сжатие контекста
В качестве проверки агент собирал простые HTML+JS-игры и самостоятельно исправлял ошибки. Вывод практичный: RTX 3090 даёт больше запаса, но видеокарту с 16 ГБ VRAM рано списывать – при правильном кванте она уже подходит для локальной разработки.
🔗 Читать статью на Хабре
━━━━━━━━━━━━━━━━━━━━
📢 AI❤️4Life — канал об искусственном интеллекте
🤖 SyntxAI — все самые нужные нейросети в одном сервисе
🔒 MaxVpn — Удобный и быстрый VPN
🧠 Google AI Pro — подписка на личный Google-аккаунт на 18 месяцев за 990₽
━━━━━━━━━━━━━━━━━━━━
👑 Авторский курс по созданию персональных ИИ-агентов
#ai #LLM #Qwen #OpenCode #llama_cpp #локальныемодели #нейросети