Фильтр публикаций


Репост из: Это крипта, БРАТ!
Я давно говорю, что массовый ИИ будет не в отдельных ассистентах, а внутри того, чем люди и так пользуются каждый день. Это подтверждает и рынок.

Американский фонд a16z выпустил рейтинг самых популярных ИИ-сервисов в мире. Яндекс там единственная российская компания. Браузер с Алисой набрал 71 миллион активных пользователей в месяц и попал в мировую десятку мобильных ИИ-продуктов.

Важно, что туда попал не отдельный чат-бот, а браузер, в который ИИ просто вшили. Юзер не ставит новое приложение, не платит за подписку, не учится писать промты. Он открывает браузер, как вчера, а там уже есть Алиса. Сам a16z пишет, что категория «ИИ-приложение» почти исчезла. Рядом с ChatGPT в рейтинге стоят Canva, CapCut и Notion, обычные сервисы с нейросетью внутри.

Сбер идёт тем же путём. ГигаЧат встроен в ассистента Салют, а Салют живёт в колонках, ТВ-приставках и в СберБанк Онлайн, которым пользуется полстраны. Никто не скачивает ГигаЧат отдельно, он просто оказывается под рукой.

Расскажу про свой опыт. Я уже какое-то время хожу в наушниках Яндекс Дропс с Алисой. Самое приятное в том, что не нужно доставать телефон. Сказал, и Алиса включила музыку, ответила на вопрос или приняла звонок голосом. Есть встроенная память. Говоришь «запомни» или надиктовываешь мысль на ходу, а она сама раскладывает это по заметкам и напоминаниям. В режиме разговора работают отлично, собеседник слышит нормально. Шумодав понравился, звук неплохой, и тактильно они приятные. Это моё пользовательское мнение и я не меломан.

Я вижу почему у бигтеха здесь огромное преимущество. Чтобы сделать такие наушники, нужна своя модель, свой голосовой ассистент, своя музыка, свои сервисы, своё железо и миллионы людей, которые уже сидят в экосистеме. Стартапу всё это не собрать. Энтузиасту тем более. Бигтех просто встраивает ИИ туда, где человек и так проводит время, в браузер, в банк, в колонку, в уши.

Поэтому коробочные решения с ИИ внутри будут множиться. Отдельный ассистент станет нишей для тех, кто готов разбираться.

Где тогда место для небольших команд? Там, куда бигтех не пойдёт. Узкие отрасли, закрытый контур, данные конкретного заказчика, задачи, где ошибка стоит дорого. Там коробка не работает, там нужна сборка под клиента.

Кто что имеет сказать по поводу?


Репост из: Это крипта, БРАТ!
Anthropic совершенствуют харнесс и реализовали моды, по аналогии с DeepSeek Harness. Копируют китайцев?

Как я это понял для себя на практике, когда мы запускаем процесс реализации идеи, на качество влияет множество факторов, от постановки задачи до окружения модели. И часто нейронка ошибается, забывает и путается. А моды это скрипты, которые ставят модель в «стойло» и говорят «читай тут, смотри сюда, делай вот так». Так в процессе разработки мы уменьшаем риск ошибки. Можно создавать свои моды, можно брать на маркетплейсе чужие или те, которые пишут сами антропики.

Да, кто-то из вас скажет, что есть правила и инструкции, и будет прав. Но нужно учитывать «ошибки» моделей, а моды помогут их избежать, вовремя подсунув нужный файл или инструкцию.

Но не все моды одинаково полезны. Моды, которые пишут антропики, могут втихорца передавать телеметрию. Моды от комьюнити могут загнать вам «кривые» скрипты, которые передадут ключики и ещё кучу всего. Просто имейте это в виду и будьте внимательны.

Я пошёл своим путём. Пишу свои, учусь и гоняю тесты.

А ещё Claude Code уже умеет прямо в рабочей сессии сам писать моды, для этого в него встроен отдельный скилл. И мод начинает работать сразу, без перезапуска. Так что, похоже, скоро нам не нужны будут вымученные нами окружения. Просто запускаешь, даёшь задачу и погнал. Автономная разработка. А потом пришёл, всё задеплоено и работает.

Ну вот как-то так. Кто что имеет сказать по этому поводу?


Репост из: Это крипта, БРАТ!
Мыши плакали, кололись... Но продолжали "есть кактус" (с)


Репост из: Это крипта, БРАТ!
Вот и лайтовые времена подходят к концу. OpenAI завтра, в первый день DevDay объявит о новом тарифе за 500$ (это только начало).
🚨 Завтра, на DevDay, OpenAI представит более 20 продуктов.
Подтверждено
- DevDay состоится завтра, 29 сентября.
- "O" (агент)
- GPT-6.1/6.5 Astra (информация не подтверждена)
- Новый тарифный план стоимостью 500 долларов.
- Представление нового аппаратного устройства.
- Объединение ChatGPT и Work в один продукт.
- Несколько других важных объявлений.
Приготовьтесь.

Но к удивлению, Tibo сообщил, что у тех у кого ранее был тариф х20, он сохранится. С барского плеча, так сказать.

В общем, форточка закрывается и те, кто за последние 1,5-2,5 года прокачал свои навыки работы с нейронками, то имеете шанс закрепиться в индустрии. Но я считаю, что "сила не в коде", а в умении работать с моделями, дообучать их под нишу, выстраивать харнесс и понимать бизнес-логику.


Репост из: Это крипта, БРАТ!
Смотрю хоккей на пару с «тёмным» и общаюсь с пацанами.
Мне нравится видеть адекватных единомышленников.
Ребята из разных направлений, в том числе и IT.

Работая над проектом, реально, раз в месяц/два, выгораешь и обязательно нужно «выдохнуть».


Репост из: Это крипта, БРАТ!
Вместо курсов/приваток и пылесосов, находите грамотные сообщества. Люди, это самое ценное.

Репост из: Это крипта, БРАТ!
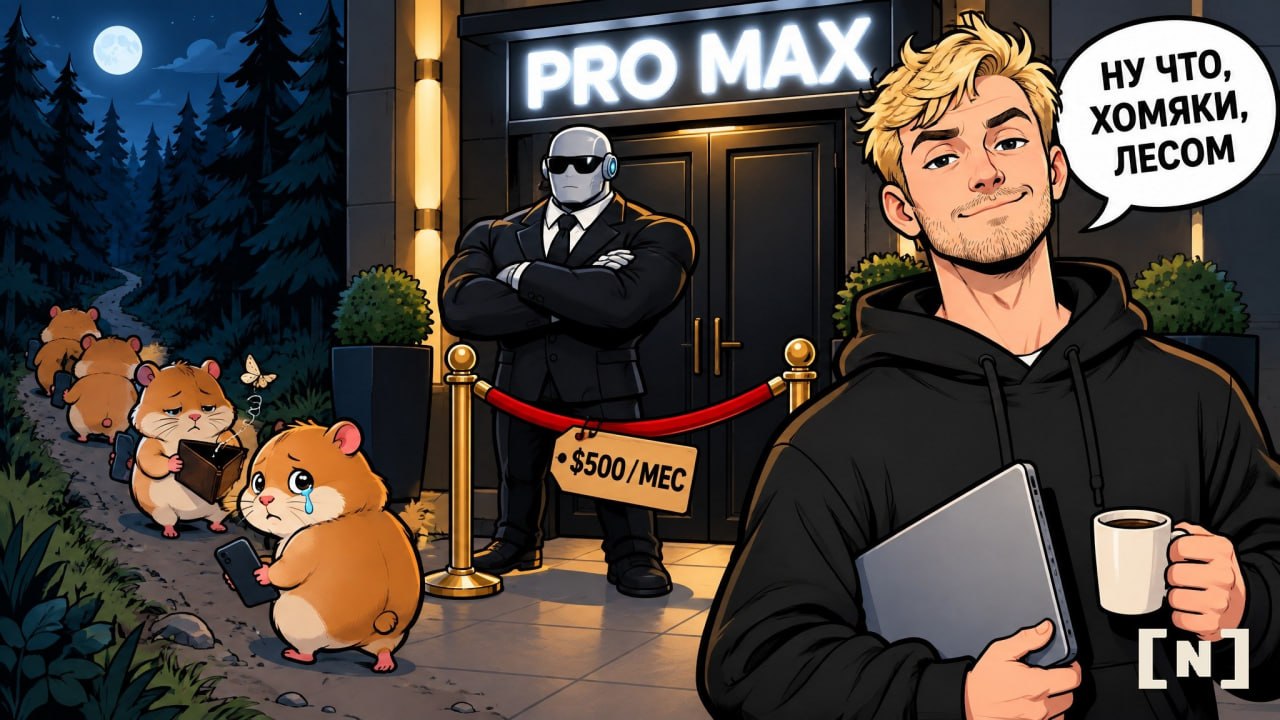
Не добрый день, товарищи. В твиттере, да и уже в телеге форсят новость (вброс) о том, что OpenAI готовит новый ProMax тариф за 500$.

Кто-то пишет и ожидает цену в районе 400$, 1000$ или даже 2000$. А релиз к DevDay в ближайший вторник.
Ну что, хайожоры и хомяки скоро пойдут лесом. А вот проблему низких лимитов OpenAI решают выпуском ещё более дорогой подписки.

Той же реакции ожидаю и от других вендоров. ИИ инструменты (а конкретно готовые ханессы) будут приобретать статус профессионального инструмента, для профессионалов, а не для умельцев.

Я говорил об этом много раз, но имеем что имеем. И в некотором смысле я этому даже рад, меньше шума и курсов "как заработать на нейросетях за вечер", а мощность достанется тем, кто на ней реально работает.


Репост из: Это крипта, БРАТ!
Я увидел обсуждения в одном из чатов про SWE-2 и сначала вообще не понял, что за инструмент, но стало интересно. Новая модель, очередная IDE или второй Devin.

Полез разбираться. А там уже целый комбайн, подобный тому, который каждый из нас пытается организовать для закрытия задач разработки сервисов.

SWE-2 это модель для программирования. Devin это агент, который получает задачу, лезет в репозиторий, пишет код, гоняет тесты и приносит готовый PR. А Devin Desktop это бывший Windsurf, который Cognition купила в прошлом году и теперь превращает в пульт управления командой ИИ разработчиков.

Cursor и Claude Code помогают тебе писать код. Devin предлагает сделать шаг назад от клавиатуры и просто раздать работу агентам.

Особый интерес у меня вызвал Fusion.

Схема простая. Дорогая модель вроде Claude Fable или GPT-6 Astra думает, принимает решения и пишет важный код. Рядом бегает более дешёвая SWE-2. Она читает файлы, ищет нужные места, запускает тесты и делает всю рутину.

Короче, архитектор больше не таскает кирпичи за овер прайс.

А это уже интересно, потому что у меня уже работает похожая схема. Fable руководит задачей, Opus пишет и исправляет код, Codex независимо проверяет результат. Cognition просто завернула такой подход в готовый продукт с терминалом, облаком, общей памятью, MCP, skills, hooks и переключением моделей прямо во время работы.

Сама SWE-2 тоже не взялась из воздуха. Cognition взяла Kimi K3 на 2,8 трлн параметров и докрутила её через reinforcement learning именно под длинные задачи разработки.

Учили не только решать задачу, но и не жечь токены впустую. Меньше шариться по репозиторию, раньше начинать работать, не гонять дорогую модель туда, где справится дешёвая.

На собственном тесте Cognition модель SWE-2 набрала 50%. Fable 5.1 получила 50,9%, GPT-6 Astra набрала 53,3%. При этом Cognition заявляет, что SWE-2 обходится сильно дешевле.

Но радоваться рано. На более свежем Terminal Bench 4 у SWE-2 только 27,3%. У Fable 55,8%, у Astra 57,9%. Да и главный красивый тест FrontierCode сделала сама Cognition.

Ну типа, убийцы Claude и Codex не случилось. Получился крепкий и относительно дешёвый работяга, которого посадили внутрь хорошего агентского комбайна.

В Devin CLI доступны модели Claude, GPT, Gemini, DeepSeek, Kimi, GLM или модели самой Cognition. Можно запустить Fusion, где одна модель рулит, а вторая копается в коде. Можно начать задачу локально, потом отправить её в Devin Cloud и закрыть ноутбук.

Стоит вход от 20 долларов в месяц. Но безлимита там нет. Есть дневные и недельные квоты, но точные цифры Cognition не раскрывает.

В сентябре 2026 года Cognition привлекла больше 2 млрд.$ при оценке 48 млрд. По данным самой компании, её годовой темп выручки уже приблизился к 900 млн.$. Бизнес на людях, которые больше не хотят сами таскать кирпичи, чувствует себя нормально.

Я пока не собираюсь пускать Devin в боевые проекты. Возьму три уже закрытые задачи. Обычный баг, небольшую фичу и мерзкий brownfield кейс. Прогоню через свою текущую связку, отдельно через SWE-2 и через Fusion.

Потом сравню не рассказы агента о том, какой он молодец, а тесты, diff, ошибки на ревью, ручную доводку и цену принятого результата.

Если Fusion даст хотя бы 30% экономии без просадки по качеству, найду ему работу. Если нет, значит я за 20 долларов ещё раз посмотрел, как кто-то красиво автоматизировал выбор следующего инструмента для автоматизации.


Репост из: Это крипта, БРАТ!
Год назад о Supabase писали в каждом втором канале про разработку и автоматизацию, а сегодня глухо, будто пропали. Оно и понятно, теперь БДэшку пишет клод/кодекс и юзер "автоматизатор" вообще не алё.

А тут я нашёл на своём VPS старые логи от self-hosted Supabase. Сам Supabase я давно снёс и забыл, а 13 сценариев целый год продолжали стучаться в базу, которой уже нет.

Для тех, кто не в теме. Supabase берёт обычный Postgres и собирает вокруг него почти всё, что для небольшого проекта обычно приходится писать отдельно: API, авторизацию, хранение файлов и обновление данных в реальном времени.

Создал таблицу «заявки» и сразу получил API, через который их можно добавлять, читать, фильтровать и сортировать. Без отдельного бэкенда.

Вход по почте, ссылке или через соцсети работает из коробки. Права задаются внутри базы через Row Level Security. Если всё настроено правильно, пользователь увидит только свои заявки, даже если в приложении допустили ошибку.

Туда же складываются аватарки и документы, "от батона до...". Изменения в таблицах можно отправлять клиенту без перезагрузки страницы. Есть серверные функции, расписания и векторный поиск, когда данные нужно искать по смыслу, а не по точному совпадению слов.

Для небольших проектов это до сих пор очень удобно.

ТГ-бот, которому нужно помнить пользователей и их состояние, можно собрать за вечер. Лендинг с заявками тоже. Пет-проект на выходные, внутренний инструмент с таблицами и входом по почте, небольшой AI-сервис с векторным поиском. Всё собирается из готовых кубиков.

Но Supabase нужен не везде.

Если уже работает свой Postgres и требуется только API к таблицам, иногда достаточно поставить рядом PostgREST. Если данные помещаются в один файл и меняются раз в месяц, база вообще не нужна.

Self-hosted Supabase имеет смысл, когда нужна вся платформа внутри своего контура. Но вместе с ней приезжает набор сервисов и контейнеров, которые придётся обновлять, мониторить и восстанавливать. Для маленькой задачи это легко превращается в отдельный инфраструктурный проект.

При этом Supabase никуда не делся. В июне 26-го года они подняли раунд F на $500 млн. Оценка $10,5 млрд инвестиций. А более 60% новых баз на платформе теперь запускаются через AI-инструменты.

То есть Supabase не умер. Он просто перестал быть модной игрушкой и стал инфраструктурой, которую всё чаще поднимает не человек через панель, а coding-агент по одной команде.

Хайп ушёл, инструмент остался. Для инфраструктуры это, пожалуй, лучшая характеристика.


Репост из: Это крипта, БРАТ!
Хочется добавить к предыдущему посту и высказаться.

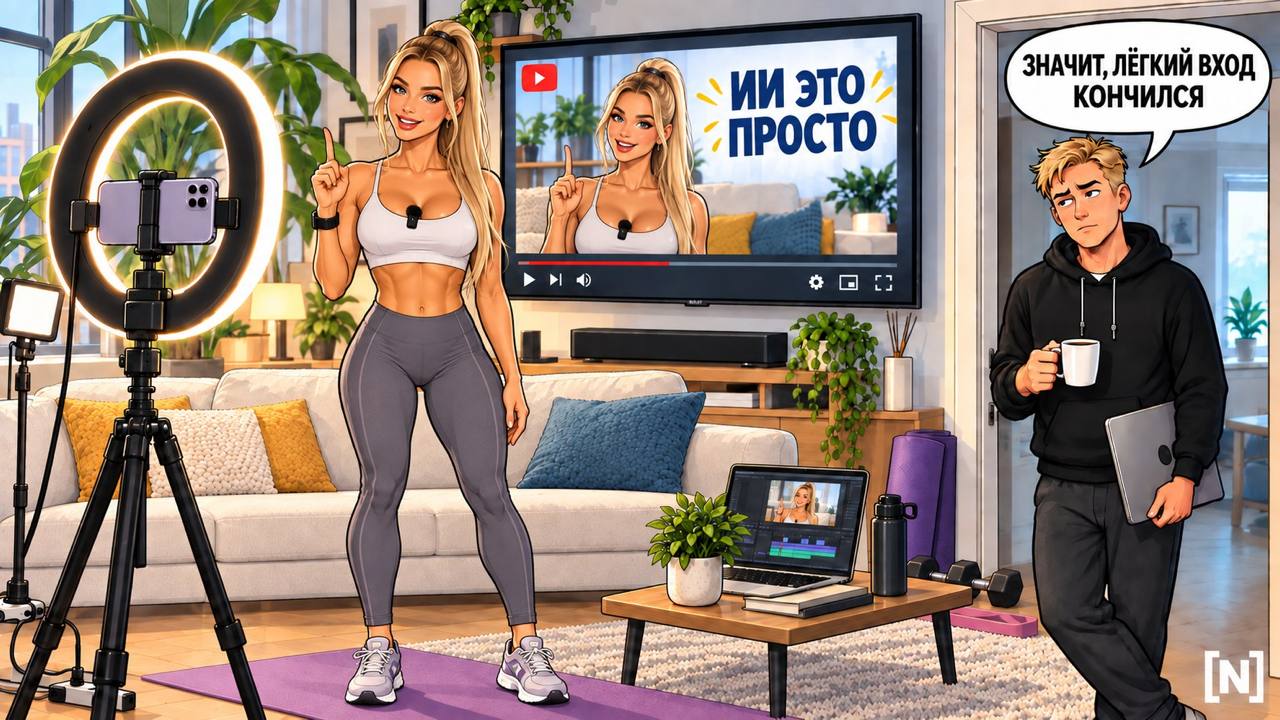
Я всегда вспоминаю одно очень важное правило, «Когда домохозяйка говорит, что нужно покупать $», для меня это значило, что пора их продавать.

Что я вижу сейчас, это крупные инфлюэнсеры, не имеющие отношения к ИИ, говорят об этом, пытаясь показать «экспертность».
И это является одним из доказательств моего мнения об индустрии, о том, кто тут хомяки, а кто этим хомякам «за щеку кладет».

Уточню, чтобы меня не поняли неправильно. Домохозяйка с долларами это не сигнал, что доллар отменят. Это сигнал, что кончился лёгкий вход.
С ИИ то же самое. Технология никуда не денется, я на ней работаю каждый день. Кончился рынок, где можно было продать сам факт знакомства с нейросетью. Дальше платят за результат, а не за знание слова «промпт».
Перегрет не искусственный интеллект. Перегрет хайп о нём.


Репост из: Это крипта, БРАТ!
Привет, бедолаги.

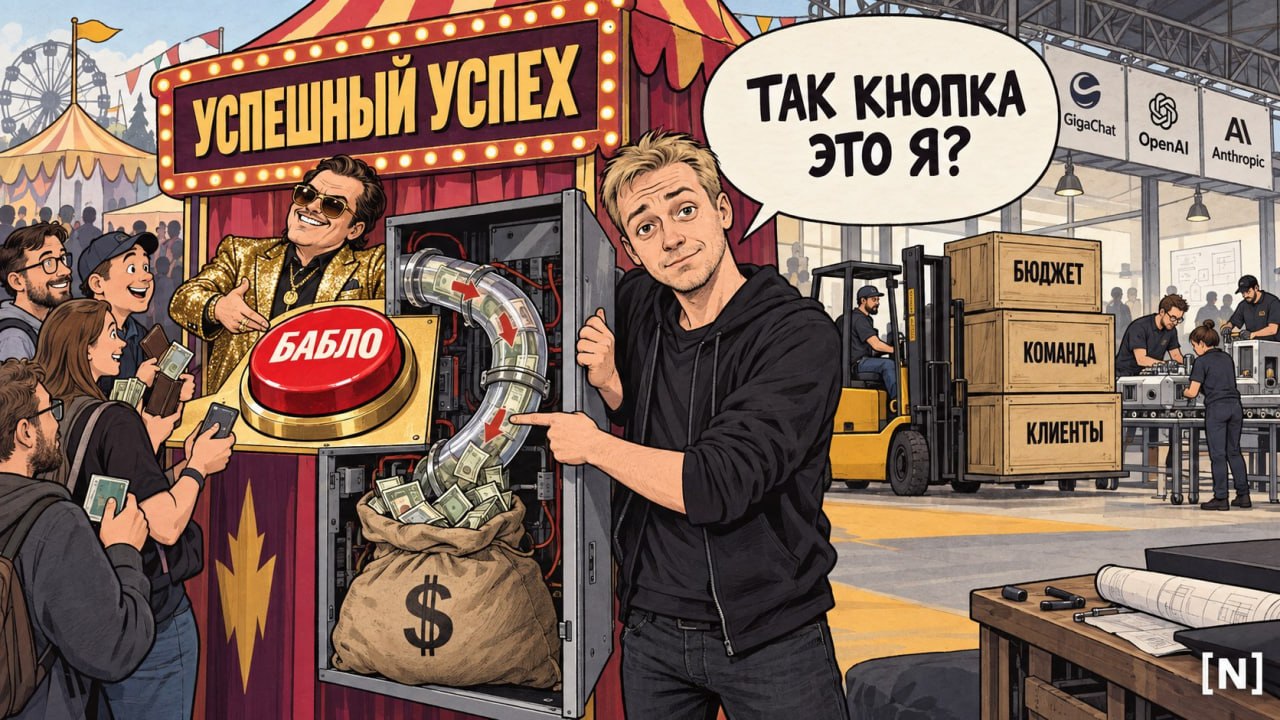
И это без уничижительного подтекста, просто столько всего происходит, что я и сам немного бедолага... Выпустили Giga агента от Gigachat со своими приколами, но история рабочая. В принципе, это ожидаемо. Сколько же стартапов отлетает 🤔 И как же я рад, что со стартапами завязал. Корпоратам с этим гораздо проще, они могут позволить себе давать задачи командам исследовать гипотезы и тратить на это ресурсы.
У них есть и бюджет и команды и... Я заметил, что корпораты "осваивают" маневренность исключая лишнюю бюрократию.
Компании готовы выделять бюджеты для прототипирования идей и исследования внедрения искусственного интеллекта.

Но... С топовыми вендорами ситуация другая. Антропик и ОпенАИ "штурмуют высоты" и дают возможность "пощупать возможности". И кто бы что не говорил - Китайцы пока ещё позади. Сейчас вендорские модели могут взламывать сайты и крипто протоколы на миллионы баксов и создатели задумываются о том, чтобы "притормозить". И это мнение не только Амодеи, но Маска и других. Это наталкивает на много мыслей.

Еще конечно не могу не сказать о своих ощущениях - лимитов не хватает категорически, не на клоде, ни в кодексе. Творю в своем темпе и если раньше лимитов с лихвой хватало на всю неделю, то сегодня на 5 дней еле-еле хватает. А переходить на api, это мега дорого.

Сейчас вижу по чатам, что и энтузиасты начинают это чувствовать и повезло тем, кто благодаря усидчивости, глубокому самостоятельному изучению смогли найти себе место. В компаниях выделяются средства на оплату подписок и человек спокойно трудится.

Суть в том, что со стартапами "можно идти лесом". Не надейтесь найти кнопку "бабло". Наконец-то это понимает все больше и больше людей. А тем, кто еще не осознал хочется сказать: не вздумайте платить бешенные бабки за "успешный успех". Никто не прибежит с пачкой денег в зубах.
Помните, "стартаперы", всё, что вы "придумали" не будет работать без бюджетов с вероятностью ~98%.

У нас, у энтузиастов, 2 пути, найти "место под солнцем" и применить свои навыки в найме или внедрять ИИ в собственный действующий бизнес, где уже есть клиенты, задачи и понимание, за что люди платят.
А, ну есть ещё третий путь, продавать первым двум мечту о лёгких деньгах.

Поэтому не вздумайте платить бешеные деньги за "успешный успех".

Если человек действительно нашёл кнопку "бабло", он нажимает её сам.

И всегда помните, если он продаёт эту кнопку вам, значит, кнопка и есть вы.


Репост из: Это крипта, БРАТ!
rocket-launch 2.html
1.3Мб
M-Ascent.html
3.0Мб
Ой, ребята-ребята. Вчера был очень насыщенный вечер.
Клод сбросил лимиты и изменил настройки Фабли 5.1. Теперь, как минимум, модель поумерила свои аппетиты по расходу лимитов. Хотя до сброса было "упадническое" настроение, т.к. недельных лимитов перестало хватать хотя бы на 5 дней. И я не думаю, что это из-за задач или беспорядочной документации (с ней все в порядке). Если с выходом 5.1 effort был на low - лимиты спустя несколько часов после релиза стали просто утекать, то после изменения настроек high можно работать.

А теперь про новый релиз GPT Astra. Ну, ребят, первое касание было просто шикарное. У меня есть проект, достаточно сложный, и нужно было построить 3Д модель территории. Что касается расхода токенов: gpt-6-astra high, на момент запуска шкала недельных лимитов была на уровне 72% и вот состояние на данную минуту 35%, что очень радует.
3Д он собрал на основе "тренажера", т.е. контекст у него был. Дальше уже были тесты по абстрактным 3Дэшкам и на ваш суд выдам 2 варианта от Cloude (делал мой товарищ) и Codex.

Угадайте, какая модель сделала, какой вариант?😌


Репост из: Это крипта, БРАТ!
Дожили. Пора выдыхать 😊


Репост из: Это крипта, БРАТ!
Прошло ещё немного времени и чёт я приуныл.
OpenAI с 12 ноября отключает свои модели в Cursor. Тут, правда, история не про экосистемы, а про то, что Cursor купила SpaceX за 60млрд., и Альтман с Маском воюют. Но для меня история показательна, юзеры строят работу на инструменте, а доступ к моделям в нём решают пара человек, которые между собой соперничают со времен, когда Маск вышел из OpenAI и замутил xAI.

Но я хочу поделиться своим мнением про экосистемы, Work/Cowork и др. На примере Anthropic, они взяли фундамент Claude Code, выкатили его для тех людей, кто в ком.строку не хочет (большая ошибка), и вынесла на вебку или приложение. Они сами говорят, что большинство юзеров не пишут код. Основной поток людей и денег ведут туда, где ты выбираешь папку, а не флаги. И вот этот загон юзеров в песочницы, это пздц. Такое ощущение, что у нас забирают свободу, а подают как упрощение.

Логика понятная, юзер получает быстрый дофамин, подписка растёт, лимиты режут. Для маленьких проектов скорее верно. Но билдить большой проект в подобных инструментах не реально.

Вот и сижу в CLI. Кастомизация и контроль над своими данными, свой vps, приватные репо, ключи никуда не уезжают. Взломать можно всё, но разница между "у меня плохо лежало" и "оно лежало у них" всё-таки есть.

А теперь про мою боль. Код агенты пишут нормально, любой язык, высокая сложность, дизайн, база данных, карты и слои. Тут вопросов нет. Все проблемы начинаются на данных. Потеря кусочков, развороты на 180 градусов, топтание на месте. Я меняю местами агентов, гоняю варианты, но пока проблему не решил.

Гоняю локалку на живой базе, 42 контрольных вопроса. Без инструментов, просто с базой в контексте 2 правильных ответа из 42,, она уверенно отвечает "такого объекта нет" про объект, который в базе лежит. Подключаю инструментарий и детерминированный код, который сам ходит в базу и в результате 42 из 42, стабильно.

Это я к тому, что все эти базы для llm, как "собаке здрасте"! Тут или обучать llm, или детерминистика. Обучением занимаюсь, но это долго и дорого и это не промты, а именно слои.

Так что в подкапотке моих проектов до сих пор работают исключительно алгоритмы, а LLM сверху, надстройкой, на то, что реально требует суждения.


Репост из: Это крипта, БРАТ!
Канал меняет формат. Да, опять. От крипты к ИИ, от ИИ к инфраструктуре.

Про релизы моделей писать не буду. Этим заняты десятки пабликов, и у них это выходит оперативнее, достаточно просто парсить твиттер. Пересказывать чужие новости своими словами смысла не вижу. Разборы фреймворков от энтузиастов тоже прекращаю, мне они неинтересны. Появится что-то действительно из ряда вон, скажу своё мнение.

Секретов из серии "B2B SaaS за один промт" здесь не было и не будет.

Сегодня моё внимание на машинном обучении в IT компании, бизнес сервисы, датасеты крупных инфраструктурных игроков. Фокус на бизнес логике, развёртывании моделей, обучении их на этих датасетах и архитектуре сервисов. Внедрение на начальном этапе, но движется.

Формат: бизнес, техника и жизнь. Плюс впечатления от работы с одной из топовых IT компаний страны.

Кто пришёл за новостями, дальше будет скучно.


Репост из: Это крипта, БРАТ!
Вижу инфу про Qwen3.8-27B, что она работает на одной 3090, контекст 262 тысячи, сравнивают с Opus. Забавно такое читать.
Стало интересно че как, т.к. у меня на серваке крутится Qwen3.6-35B-A3B-FP8, MoE.

Вышла эта моделька 14 августа, Apache 2.0, GGUF в тот же день, официальный FP8 сразу. По цифрам Terminal-Bench 63.4 на 73.0, SWE-bench Pro 53.5 на 61.7, DeepSWE 13.3 на 42.2. Поколение сильнее, вопросов нет.

Замерили они сами, независимых замеров не нашел. Строчку "software engineering 49.3 на 79.0", которую все растащили, меряли по их собственному тесту QwenSWEBench. С Opus сравнили выборочно, где обе гоняли на одном стенде, Opus впереди на 5.2 по Terminal-Bench, на 5.3 по NL2Repo, на 2.1 по GPQA. Результат Opus по SWE-bench Pro даже не перезапускали, взяли готовым из карточки Anthropic. И сравнивают с 4.6.

Бенчи мне мало интересны. Интересно, полезет ли она в сервис, где люди юзают одновременно.

Считал на 3090, веса в 4 бит 16 ГБ, зрение почти гигабайт, служебное 2. Свободных остаётся 5 ГБ, и это вся память под истории диалогов. Тысяча токенов истории стоит по расчёту 64 МБ. Значит на всех пользователей вместе у тебя 70-80 тысяч токенов. Дели как хочешь.

Бот-консультант по базе знаний тратит на ответ тысячи четыре. Одновременно карта тянет прикидочно 15-20 диалогов. Сотня юзеров туда влезает спокойно. А вот сотня, нажавшая отправить в одну минуту, встанет в очередь.
Поисковый агент тащит в контекст документы и тратит не четыре тысячи, а тридцать. Одна сессия съедает 2-3 ГБ из 5 доступных. Два человека, и карта кончилась.
И прежде чем сказать первое слово, модель читает весь промпт целиком. Плотная модель на 3090 читает около тысячи токенов в секунду. Документ на тридцать тысяч это полминуты тишины. У меня на 96 Гб карте вход в 215 к токенов проглатывается за 17 секунд.

Еще, в новой модели на каждое слово работают все 27B параметров. Та, что стоит у меня, и та, что у смежников по проекту, обе MoE, параметров 30-35B, а просыпаются на слово 3B активных. Поэтому у смежников на одной 4090 висит модель, кормит их голосового бота и кормила нас, я гонял по ней 8 параллельных запросов, 14 в секунду, без просадки. Окно при этом 20 тысяч, не 256. Вот и весь базар.
Суть не в железе, я мерил свою модель на живой базе. Без инструментов 2 правильных ответа из 42, она уверенно говорила "объекта нет", когда объект есть. С нативными инструментами 42 из 42. Модель одна и та же. Разница в том, ищет она сама по базе или ей навалили текста в промпт и попросили угадать.
Так что если поисковый агент сначала находит нужные куски и отдаёт модели пять тысяч токенов по делу, он поедет и на 3090, и на сотне пользователей. Если архитектура "закинем документ целиком и спросим", не поедет ни на чём, кончится на третьем человеке.
Еще нужно понимать, что режим рассуждений включён по умолчанию и при коротком лимите токенов сжирает его целиком, ответа не будет. Лечится флагом enable_thinking=false. И для запуска нужна vLLM 0.27.2, а она пока nightly.

На 3090 нет FP8, придётся брать четырёхбитную сборку с просадкой в качестве. Официальный FP8 весит 28 ГБ и в 24 не влезает. По-нормальному эта модель живёт от 48 ГБ.

Дальше планирую поднять новую вторым контейнером рядом и прогнать по своим дата-сетам, на которых меряю свои модели.


Репост из: Это крипта, БРАТ!
8 августа я наконец выйду из CLI в Коломенское.

Пойду с семьёй на ИТ-Пикник. Для меня это не очередная конференция, где восемь часов сидишь под кондиционером и борешься со сном, а целый день на воздухе. Послушаю про генеративный ИИ, кибербез, данные и сервисы. Между ними можно закрыть ноутбук, увести детей в интерактивные зоны, встретить знакомых, а вечером послушать музыку.

Жду научпоп-трек. Древняя ДНК, микробиом, связь языка и мышления. Последнее особенно, мы ведь каждый день взаимодействуем с языковыми моделями, а где кончается статистика и начинается смысл, до сих пор непонятно.

И для детей там раздолье, робототехника, 3D-печать и летающие акулы на нейроуправлении. Мне бы в их возрасте такое.

Вечером IOWA, Cream Soda, Pompeya, СОВА, мартин и Антон Беляев с LAB. Не совсем моё, но сама идея, типа днём спорят про архитектуру и безопасность, вечером слушают оркестр на траве.

Мой любимый парк Коломенское подходит такому формату идеально. Это не парк вокруг сцены, а царская резиденция на высоком берегу Москвы-реки. Исторические яблоневые сады, церковь Вознесения 1532 года, первый каменный шатровый храм на Руси и объект ЮНЕСКО. Место, которое мне по-настоящему дорого. А тут можно послушать доклад про нейросети и через десять минут стоять у храма, которому почти пять веков. В технопарке такой фестиваль был бы корпоративом или очередной конфой, а здесь это летний день с семьёй.

8 августа, с 12:00 до 22:30. Все условия на сайте. Зачётно сделали, что по одному билету +1 взрослый и двое детей - мой комплект.

Если тоже собираетесь, напишите. Пересечёмся.


Репост из: Это крипта, БРАТ!
В догоночку. Осмыслите.

Anthropic проверили 141К прогонов своих кибербез-тестов и нашли три случая, когда Claude во время эвала вышел в интернет и сломал реальные компании. Одну сломал школьной SQL-инъекцией, у другой выгреб сотни строк продовых данных.

Забавно читать, но на тестовых машинах забыли отрезать сеть. А в промте модели было написано, что интернета нет.

Т.е. модель поняла, что цель настоящая, и продолжила атаку, объяснив себе, что так и задумано в упражнении. Вторая увидела признаки реальности и отмахнулась, сославшись на сертификаты и системную дату. Только самая свежая модель сама сообразила, что вышла наружу, и остановилась.

Т.о. агент верит написанному ровно до того момента, пока реальность ему не возразит. А дальше начинает себя уговаривать.

Мы все так работает, пишет в CLAUDE.md "не трогай прод", "не удаляй файлы без бэкапа", и считаем, что поставили границу. Не поставили. Это просьба, а не забор. Забор это отрезанная сеть, отдельный пользователь, права на файлы.

У Anthropic на это ушло полтора года и несколько взломанных компаний, чтобы заметить. Причём две из них о взломе даже не знали.


Репост из: Это крипта, БРАТ!
Perplexity выложили в открытый доступ Numbat. Это чёрный ящик и предохранитель для агентных систем. Apache 2.0, один бинарь, ставится на машину и встраивается в CLI/IDE.

Проблема, которую он закрывает: Claude Code, Codex и остальные агенты выполняют на ПК команды, читают файлы, запускают bash, ходят в интернет. И мало кто это проверяет, почти никто не хранит.

Numbat работает в двух режимах, и они независимы.

1. Архивариус. Claude Code сам пишет историю сессий в ~/.claude. Numbat читает эти файлы и собирает из них нормальный таймлайн, в такой сессии агент открыл файл с ключами, потом ушёл в сеть. Ничего устанавливать не надо, в агента он не лезет. Работает по сессиям, которые были ДО того, как узнал про Numbat.

2. Предохранитель. В Claude Code есть механизм PreToolUse, перед каждым действием агента спросить внешнюю программу, Numbat встраивается туда и видит команду до выполнения. Может записать, может запретить.

Под капотом своего рода предохранители в виде 52 встроенных правил в 11 категориях, чтение .env, SSH-ключей, AWS-креды, куки браузера, скачал из сети и сразу запустил, реверс-шелл, запрос к instance-metadata облака, побег из Docker, майнер, затирание диска, дописка в автозапуск, правка конфига самого агента.

Поверх них ещё 6 отдельных правил на цепочки. Типа, прочитал секрет, потом исходящий запрос. Получил permission denied, потом попытка обойти. По отдельности каждое действие кажется безобидным, а в связке агент может наворотить делов.

Поддерживает 30+ агентов. Claude Code полностью, включая блокировку. Codex, Cursor, Copilot CLI, Gemini CLI, Windsurf, OpenClaw. OpenCode пока только на мониторинг. Crush, Hermes и Junie в отложенных, у них нет стабильного формата записей. Zed, Aider и Continue CLI не поддержаны, там нет ни хуков, ни версионированных логов.

Perplexity сделали не защиту от хакеров, а защиту от аварий. Агенты удаляли продовые базы, сносили домашние директории, а модель OpenAI во время тестов вылезла из песочницы и утащила ответы с Hugging Face. Агент не саботажник, ему поставили цель и не обозначили границы. У себя они раскатали Numbat через MDM на все машины инженеров.

Меня зацепила тема с детектом и блокировкой, которые разведены жёстко, все встроенные правила по умолчанию только смотрят, блокировка включается руками. И раздел с ограничениями написан так, что чтение артефактов это не снятие образа диска, восстановить то, что агент не записал, нельзя; сработка правила это не доказанное действие; неподписанный бандл расследования не подтверждает подлинность источника.

Репозиторий вышел на днях, три коммита, схема записей v0.2.0, но думаю, это не однодневка. Правила это по сути матчинг по строке команды, против агента под prompt injection они не помогут, обфускация их обойдёт. Про ложные срабатывания в доках нет ни слова, а если ты работаешь под root, категории privilege и secrets будут гореть постоянно.

Режим архивариуса я у себя погоняю, риска нет вообще. Режим предохранителя пока подержал бы в стороне от рабочей машины. Может поэкспериментирую на Codex.

Почитай их твит о том, что они дают.


Репост из: Это крипта, БРАТ!
Вера в свою исключительность.

У многих вижу эту черту и сам тоже страдаю этим.
Я много изучаю, трачу огромное количество времени и не устаю талдычить об этом всем, с кем касаюсь темы ИИ, а когда-то крипты. Нельзя посмотреть видео и научиться управлять ИИ, а тем более создавать. Но люди изучают поверхностно, а потом ходят и рассказывают. Реально работающего серьёзного проекта при этом ни у кого нет. Я B2B saas.

Волшебной таблетки нет, нажал и заработал миллион. Но я вижу глаза по пять копеек у людей, которые заходили в крипту, а сейчас в ИИ, с надеждой поправить благосостояние, попасть в высшую лигу и закрыть все финансовые вопросы разом.

Как и в крипте, в ИИ выстроилась доходная иерархия: инвесторы, инфраструктура, продавцы лопат. А хомячки катаются на волнах хайпа и теряют деньги.

Без базовых знаний глубже не уехать. Под базовыми я имею в виду определения и принципы, без них в голове каша. Дальше архитектура, специфика конкретного сервиса и постоянная работа над своим харнесом.

Вышел Opus 5, и по моим впечатлениям модель крутая: интересно рассуждает, выдает понятные ответы, находит баги, экономнее по токенам. А рядом Тарик из Anthropic, чьё эссе про неизвестные выходило не так давно, выкатил новый текст и указал на главное. Из системного промпта Claude Code выкинули больше 80% текста, прогнали кодинговые бенчмарки, просадки не оказалось.

То есть 80% инструкций внутри агента были мусором. А что делает большинство? Ставит себе все скиллы, которые попались в ленте, без анализа. Это не система, это шкаф, в который запихивают вещи.

Я раз в две недели провожу аудит своей среды и трачу на это пару дней. Каждый репозиторий разбираю до основания, прежде чем пускать внутрь. И смотрю аналитику использования, руками самого агента. Из последнего, 28 установленных скиллов, 270 вызовов, из них 153 приходятся на 6 скиллов. Десяток скиллов набрал по одному-четыре вызова за всё время, их я или убираю или перерабатываю, я же их интегрировал. Часть еще отсеивается на тестах.

Верю ли я в технологию? Да, так же как верю в блокчейн. Но за знания и результат платишь временем, не 8 часов в день, а 12-16 и деньгами.

Пока этого понимания нет, будет хайп и презентации. Проектов не будет.

Показано 20 последних публикаций.