


😳 Почему анаграммы путают со смыслом: 5 материалов про эмбеддинги
👀 Для начала небольшой контекст: Python-разработчик из Microsoft Памела Фокс в докладе про визуализацию векторных представлений обратила внимание на курьёз: одна из моделей OpenAI посчитала семантически близкими слова с совершенно разным значением просто из-за одинакового набора букв. Например, алгоритм решит, что пушистый кот семантически подозрительно близок к электрическому ток.
🤔 Так бывает, потому что эмбеддинг — это координаты слова в векторном пространстве, а поиск по смыслу берёт ближайших соседей. По каким признакам слова окажутся рядом, решает модель, и у разных моделей выходит по-разному. В худшем случае семантический поиск выдаст на целевой запрос абсолютно чужеродные документы из-за поверхностного сходства символов, а баг искать негде: векторы посчитаны исправно.
Чтобы понимать, откуда берутся такие соседи, собрали пять материалов: от собак до критики косинусной близости 👇
➡️ Peter Sergeant, Embeddings explained
➡️ Hesam Sheikh, LLM Embeddings Explained
➡️ Vicki Boykis, What are embeddings
➡️ Pamela Fox, A visual exploration of vector embeddings
➡️ Piotr Migdał, Don't use cosine similarity carelessly
Резюмируем: пять вкладок открыть проще, чем дочитать. Пишите в комментарии, с чего начнёте 👇 (всм материала, не вкладки)
#рабочий_стол@beelinetech
📱 Подписывайтесь на нас в VK
👀 Для начала небольшой контекст: Python-разработчик из Microsoft Памела Фокс в докладе про визуализацию векторных представлений обратила внимание на курьёз: одна из моделей OpenAI посчитала семантически близкими слова с совершенно разным значением просто из-за одинакового набора букв. Например, алгоритм решит, что пушистый кот семантически подозрительно близок к электрическому ток.
🤔 Так бывает, потому что эмбеддинг — это координаты слова в векторном пространстве, а поиск по смыслу берёт ближайших соседей. По каким признакам слова окажутся рядом, решает модель, и у разных моделей выходит по-разному. В худшем случае семантический поиск выдаст на целевой запрос абсолютно чужеродные документы из-за поверхностного сходства символов, а баг искать негде: векторы посчитаны исправно.
Чтобы понимать, откуда берутся такие соседи, собрали пять материалов: от собак до критики косинусной близости 👇
➡️ Peter Sergeant, Embeddings explained
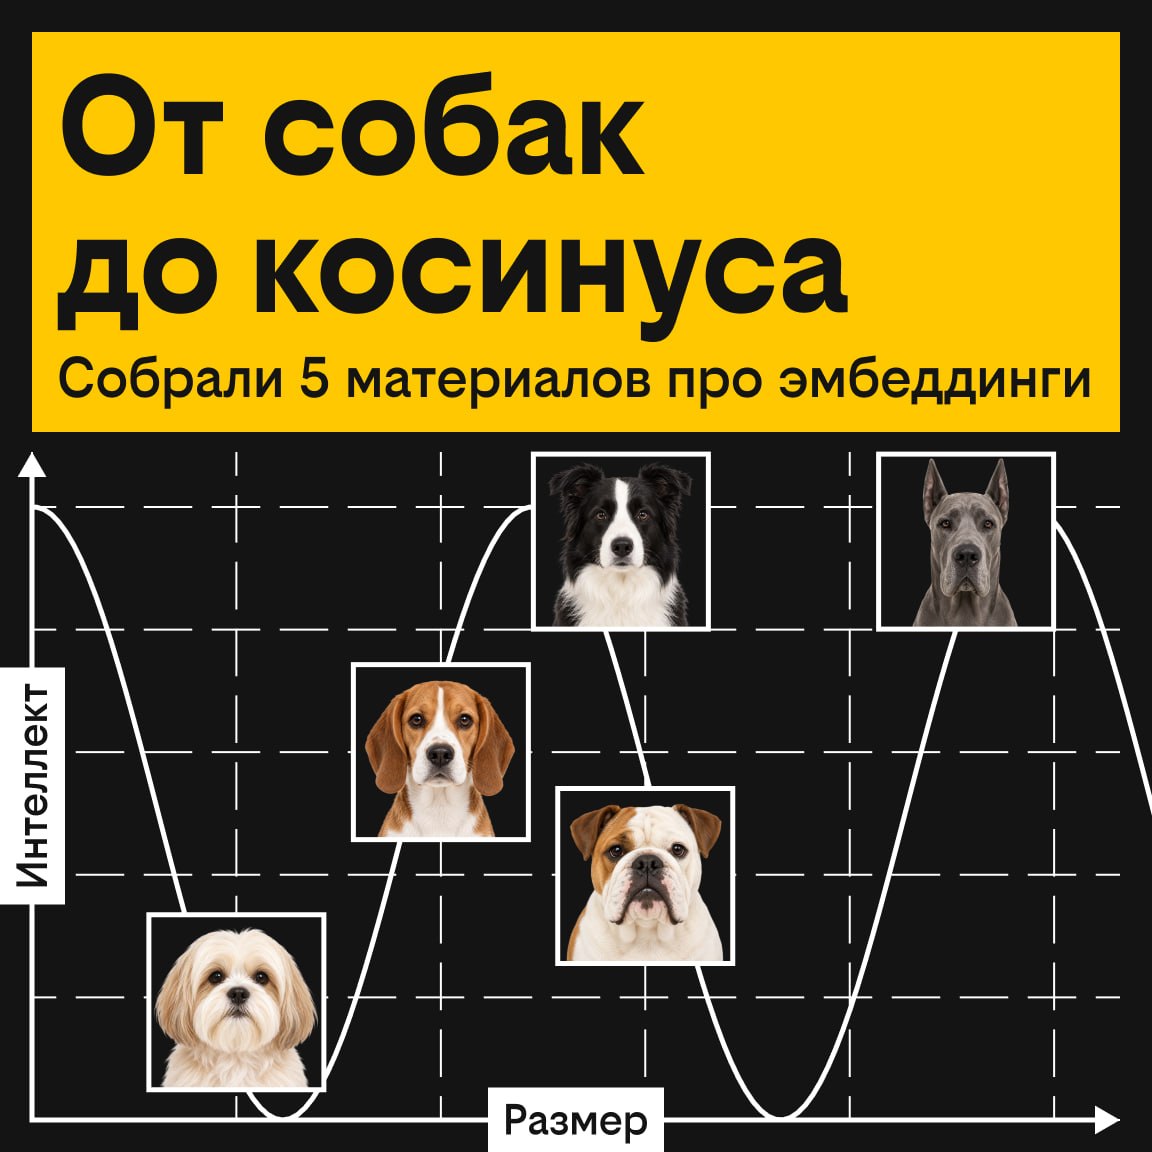
Питер Сарджент начинает с пород собак: он превращает их габариты и сообразительность в координаты. Затем автор переносит эту идею на книги и анализ слов. Руководство ориентировано на людей без опыта в коде — читатели легко справятся на уровне формул в Excel.
➡️ Hesam Sheikh, LLM Embeddings Explained
Разработчик Хесам Шейх разбирает превращение текста в числовые векторы на живых примерах. Он превратил свой гайд в интерактивную песочницу с наглядными схемами. Пользователи могут буквально покрутить объемные графы и в деталях рассмотреть, как слова притягиваются друг к другу.
➡️ Vicki Boykis, What are embeddings
Инженер Вики Бойкис последовательно разбирает тему векторизации — от One-Hot и TF-IDF до Word2vec и современных моделей. Она выстроила материал по нарастающей сложности: старт не требует навыков программирования. Однако для полного погружения читателям всё же пригодятся основы Python и линейная алгебра.
➡️ Pamela Fox, A visual exploration of vector embeddings
Python-разработчица Памела Фокс сопоставляет поведение моделей OpenAI и Word2vec на одних и тех же словах. В ее примерах наглядно видна специфика ada-002: метрика близости колеблется в диапазоне 0,75–0,88, смазывая контраст. Читатели быстро поймут, почему важно ориентироваться на ранжирование результатов, а не на само значение сходства.
➡️ Piotr Migdał, Don't use cosine similarity carelessly
Разработчик Пётр Мигдал разбирает главные ловушки косинусной метрики, которую многие применяют по инерции. Он наглядно объясняет, почему математическое сходство не равно смысловому: для алгоритма капучино и эспрессо выглядят одинаково, но для человека разница принципиальна. Вместо стандартных формул для компактных задач автор советует поручать оценку релевантности языковой модели.
Резюмируем: пять вкладок открыть проще, чем дочитать. Пишите в комментарии, с чего начнёте 👇 (всм материала, не вкладки)
#рабочий_стол@beelinetech
📱 Подписывайтесь на нас в VK