


Как обучение математике влияет на другие способности модели – новое исследование от крупнейших университетов США и Китая
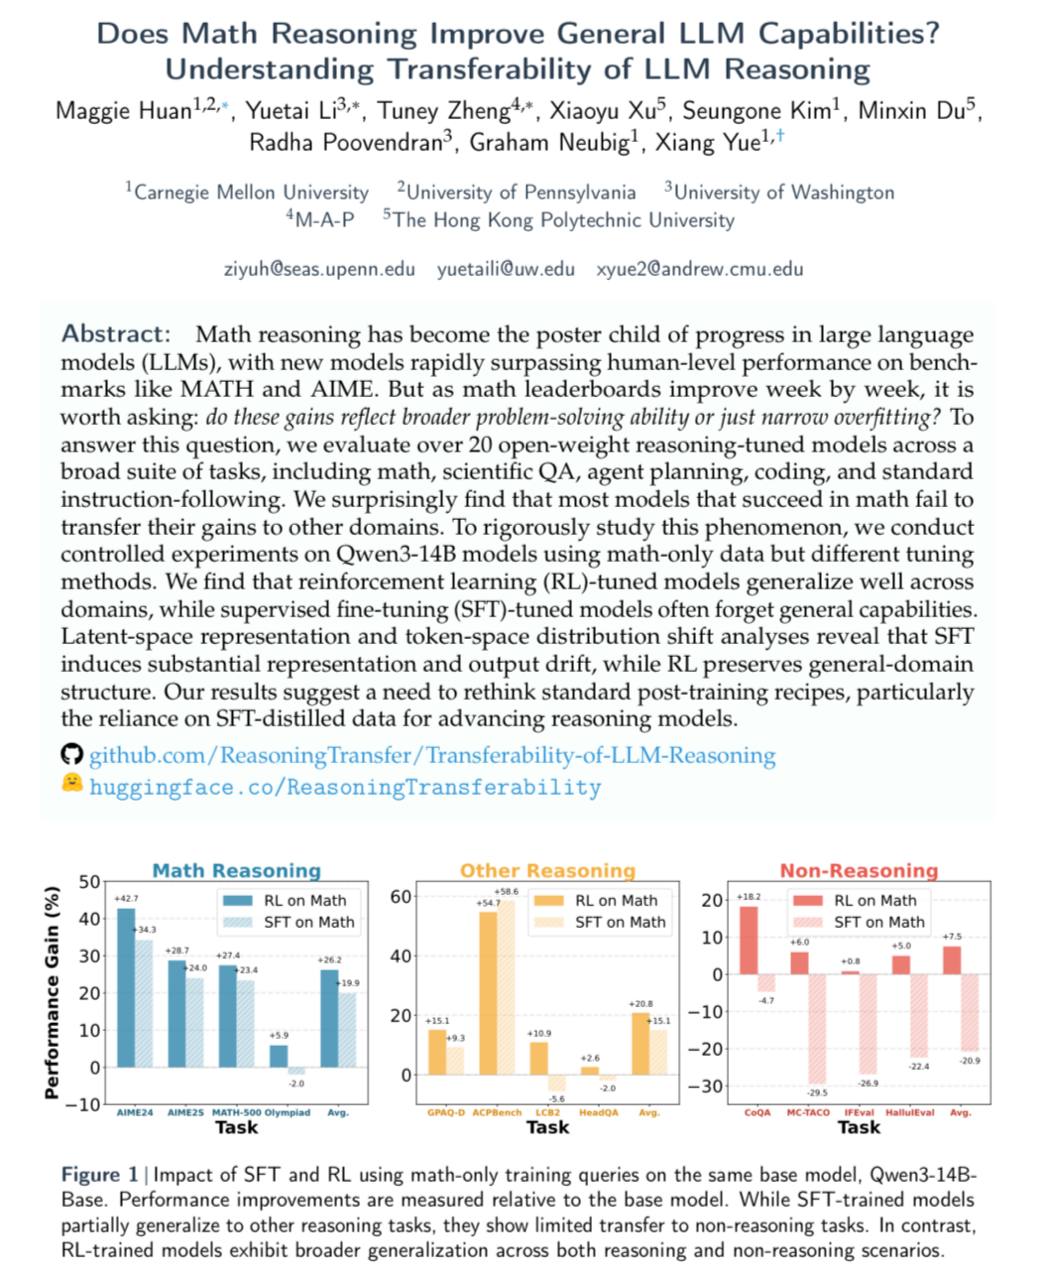
Уже долго в области LLM по умолчанию считается, что если затюнить модель на математику и кодинг, ее способности улучшаться и в других областях. Якобы, улучшаем общее научное мышление. Но так ли это?
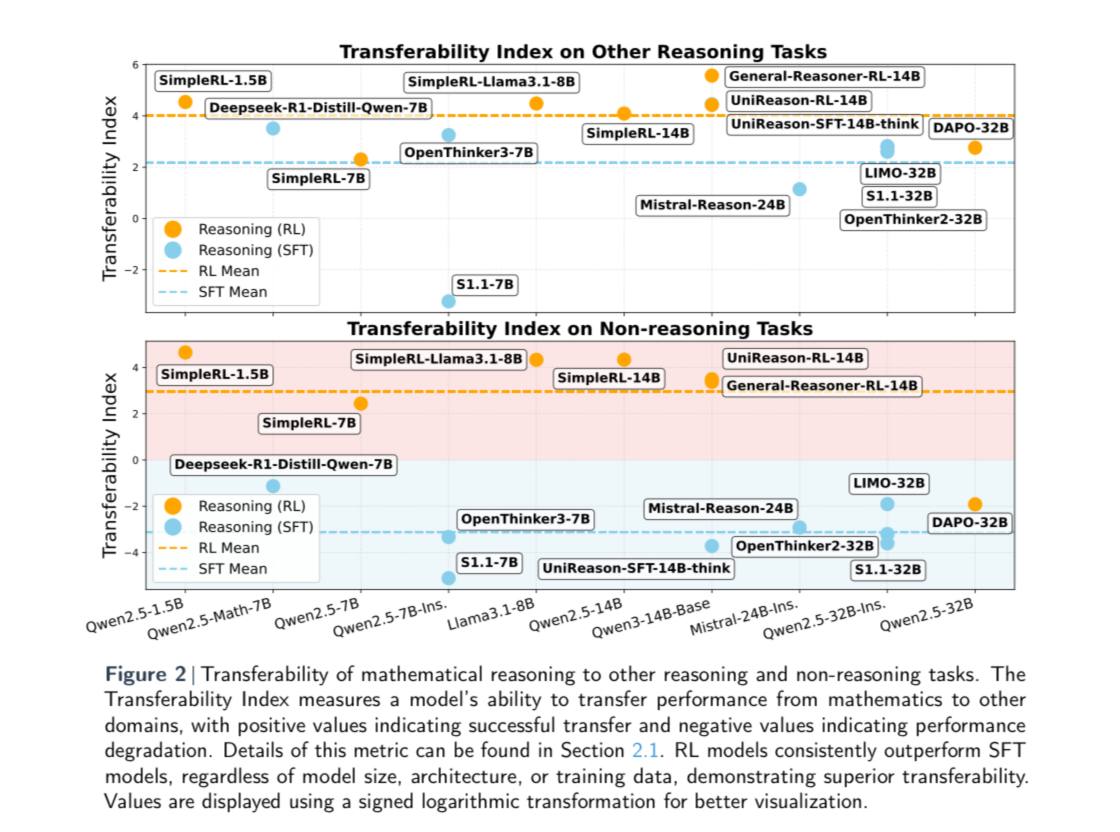
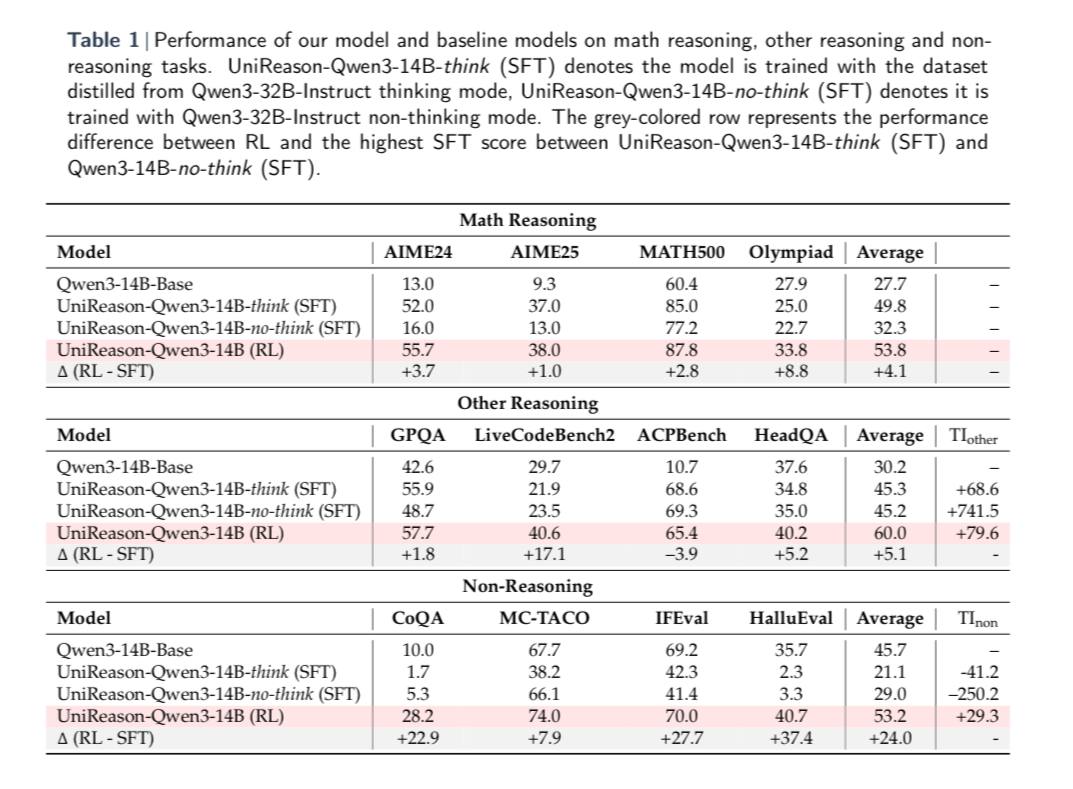
Ученые из университетов Гонконга, Карнеги-Меллона, Пенсильвании и Вашингтона специально брали модель, обучали ее математике и замеряли так называемый Transferability Index – то есть относительный прирост метрик в новой группе задач относительно прироста в математике.
В итоге эмпирически доказано: математика действительно бустит общий интеллект, все как у людей. Но вот насколько сильно – зависит от того, как тюним.
Если с помощью обычного SFT, то TI получается около 40%. Неплохо, но с RL все интереснее. Там TI аж под 80%.
Почему так? PCA показывает, что SFT просто слишком сильно меняет латентное пространство моделей, и это ухудшает гибкость относительно новых задач.
А вот RL редактирует лишь ключевые предметно-важные распределения токенов, а нерелевантные слои не трогает. Получается синергия: сохраняем общие знания и усиливаем их техническими.
Вот так. На самом деле очень важный для практики результат. В статье, кстати, еще много интересных визуализаций и графиков: arxiv.org/pdf/2507.00432