


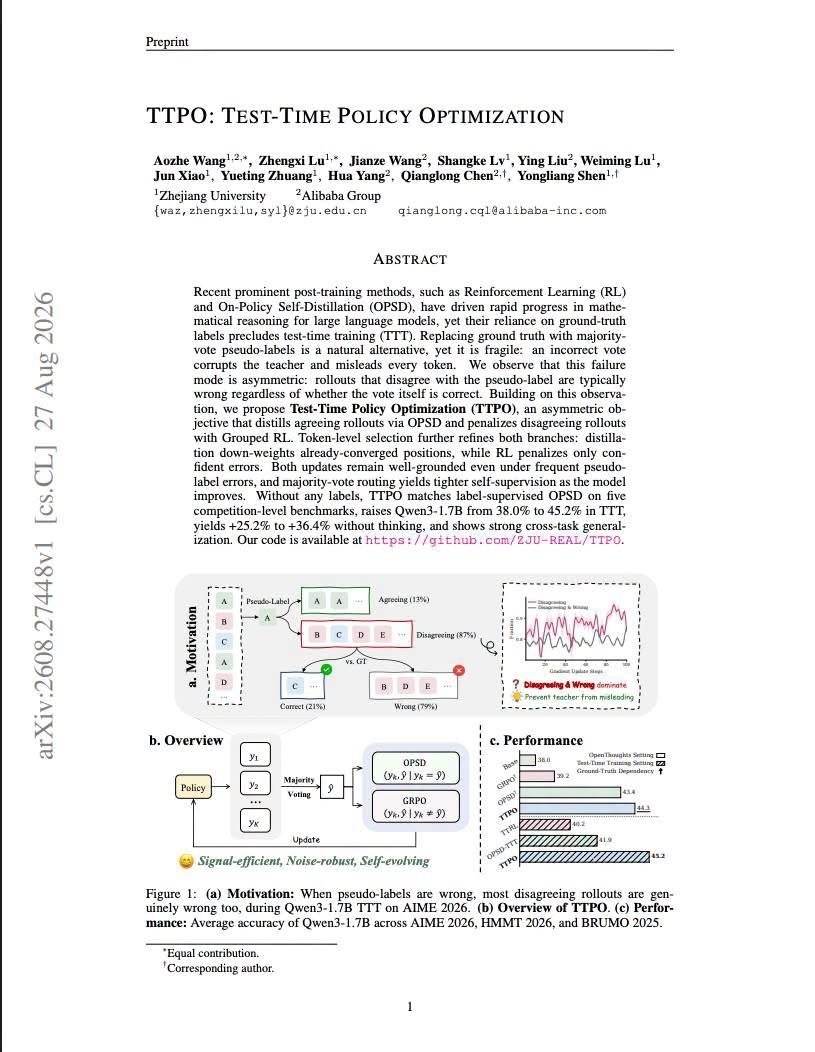
TTPO обучение моделей без явной разметки.
Представь, LLM сдаёт олимпиаду по математике. Ответов нет. Как ей улучшать себя прямо во время решения?
Команда из Чжэцзянского университета и Alibaba предложила TTPO (Test-Time Policy Optimization) - метод, который позволяет модели самообучаться на тесте без единой метки.
В чём проблема?
Обычно для обучения нужны правильные ответы. В test-time training их нет. Наивный выход - это взять мажоритарное голосование: сгенерировать К решений (к примеру 8), выбрать самый частый ответ и считать его псевдоправильным. Но на сложных задачах такой псевдоответ ошибается в ~85% случаев. Учиться на нём в лоб - значит закреплять ошибку.
Ключевое наблюдение авторов это асимметрия ошибок. Челы заметили, даже когда псевдоответ неверен, ~79% решений, которые с ним не согласны, тоже ошибочны. То есть штрафовать "не согласных" почти всегда правильно, независимо от того, права ли псевдометка.
Как работает TTPO.
Метод делит все решения на две группы и применяет к ним разные сигналы:
• Согласные, где траектории совпали с псевдоответом → дистилляция от учителя. Учитель - это та же модель, но ей подсказали финальный ответ, и попросили привести рассуждения для его получения. Зная финал, она строит рассуждения чётче без мечтаний и тупиков. Ученик перенимает стиль рассуждения, а не ответ - это важно, тк помним про 85%.
• Не согласные траектории, где ответ не совпадает с мажоритарным → штраф GRPO. Наказываем за уверенные ошибки, но не трогаем безобидные токены.
Почему это работает? Фишка в токен-уровневом подходе.
Учат не всё решение целиком, а отдельные токены. Вес большой там, где ученик неуверен, а учитель (с подсказкой) уверен. Где ученик и так совпадает с учителем – не трогают.
По сути, мне это напомнило DPO на минималках, где роль предпочтений играют вероятности учителя, а не разметка человека. Ну и конечно мажоритарные траектории.
Результаты
• Qwen3-1.7B в чистом TTT: 38.0% → 45.2% точности, обгоняет TTRL и self-distillation.
• Без режима размышления прирост +25–36%, что в разы больше, чем у OPSD с метками.
Отмечено, что обучение на одном бенчмарке улучшает другие – значит, модель учит обобщённое рассуждение, а не запоминает задачи. 🧠
Покрайне мере так считают авторы. 👍