ПРО ДАННЫЕ И ДАТА-ИНЖЕНЕРОВ


Гео и язык канала: Россия, Русский
Категория: Технологии


Платформа: https://directprobi.ru/platform/
Контакт автора: https://t.me/alexdirect

Связанные каналы  |  Похожие каналы
Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


ТЕОРИЯ APACHE SPARK

Еще до начала работы с большими данными делал видео про Apache Spark (в качестве эксперимента). Это было небольшое обзорное видео, чтобы структурировать и запомнить основные моменты. Тогда еще монтировал всё сам🤗

Позже на работе плотно столкнулся со спарком и вот что понял: Power Query, CTE в SQL и PySpark - очень похожие штуки.

Да, разные движки, разные операции, но:
● везде есть цепочка преобразований (набор шагов последовательных изменений данных),
● вы пишете что нужно сделать, а движок определяет как именно это сделать внутри,
● можно попросить движок кэшировать этап если он нужен более одного раза,
● по возможности всё выполняется в параллель, чтобы завершить запрос быстрее (на pq это параллельные вычисления, в spark - разделение данных по воркерам).

Я конечно обобщаю, но сходства присутствуют.

Явное отличие Spark - он не просто предполагает написание запроса. При работе с кластером, вы еще и должны запланировать ресурсы под ваш запрос. Для меня это всегда было проблемой😭 Никак не мог понять сколько там этих ядер и оперативки надо выставлять.

Но однажды собрал всю инфу, нарисовал презентации и всё же разобрался. Теперь у вас есть почти 3 часа крутого контента, чтобы не только подготовиться к собесу, но и применить знания на текущей работе.

Ссылочка тут: https://directprobi.ru/platform/apache-spark-teoriya


СЕКРЕТЫ В КОДЕ: КАК Я ПАЛИЛСЯ И КАК ПЕРЕСТАЛ

Когда-то для меня было нормой держать рабочий пароль к БД прямо в коде. У меня был скрипт на Python, который подключается к базе, и пароль был вписан как обычный текст. Рано или поздно это должно было сыграть против меня.

В то время я регулярно проходил занятия по Python. Мы созванивались с программистом, он показывал мне разные фишки. Все уроки он записывал, чтобы я мог посмотреть и лучше разобраться.

И, конечно, при переключении вкладок пароль попал на запись. Несмотря на моё доверие к преподавателю, рабочий пароль пришлось сменить. И если я это заметил, кто-то другой может не заметить утечку.

Другая частая ошибка - пароль в коде попадает в git. При этом гит-репозиторий может быть как публичным, так и приватным. Каким бы он ни был, пароль туда попадать не должен.

Как по неопытности не слить свой пароль? Давайте разбираться.

Хорошие практики

Хранение пароля в коде у разработчиков считается типичной плохой практикой. А что же считается хорошей? Вариантов много. Всё зависит от того, где вы работаете, с чем, от чего этот пароль и какая у вас среда. Пробежимся по вариантам.

1. HashiCorp Vault - корпоративный стандарт для хранения паролей и кредов в целом. Внутри простой интерфейс: создается переменная, ей указывается значение. У одних сервисов есть права на просмотр или изменение переменной, у других - нет. Еще Vault умеет генерировать пароли "на лету" и выдавать их на ограниченное время. Если злоумышленник украдет такой пароль, через час он уже истечёт.

2. Переменные окружения. Самый простой и популярный способ. Пароль хранится в настройках операционной системы или в CI/CD-платформе (GitHub Actions, GitLab CI, Jenkins). В коде же мы пишем просто:
import os
password = os.getenv('DB_PASSWORD')
Если переменная не задана - скрипт упадет с ошибкой, но пароль точно не засветится в коде или репозитории.

3. Файл .env - удобно для локальной разработки. В корне проекта создается файл .env, куда записываются все секреты. Сам файл .env всегда добавляется в .gitignore, чтобы он точно не попал в коммит. В репозиторий кладется файл-шаблон .env.example. В нём указаны имена переменных без реальных значений (значения пустые или фейковые). Новый разработчик клонирует репозиторий, создаёт .env из .env.example и вписывает свои пароли локально.

4. Шифрование конфигурационных файлов. Для этого есть Ansible Vault, git-crypt или SOPS. Конфиг с паролями лежит в репозитории, но в зашифрованном виде. Расшифровывается только в момент деплоя с помощью мастер-ключа, который хранится отдельно. Это компромисс между удобством и безопасностью.

5. Подмена на этапе сборки. В некоторых фреймворках (Docker BuildKit, Webpack) можно подставлять секреты только во время сборки образа, не зашивая их внутрь контейнера. Пароль используется для установки зависимостей из приватных репозиториев, а после сборки - удаляется.

Это только 5 базовых способов, а ведь есть еще...
Пока писал пост, понял, что материала получается на целую статью, так что ловите ссылочку если заинтересовались: https://directprobi.ru/blogs/sekrety-v-kode-paroli-tokeny-peremennye-okruzheniya-env-vault/


КТО ТАКОЙ ДАТА-ИНЖЕНЕР

Данные должны быть актуальны, корректны и находиться в нужном месте - именно за это отвечает инженер данных.
Но что за этим кроется?

В каждой компании дата-инженер выполняет разную работу. У всех свой стек технологий и скоуп обязанностей. Сегодня поговорим о задачах дата-инженера и о том, что в его задачи не входит.

Классическое понимание Data Engineer

Если в компании правильно выстроены процессы, Data Engineer получает задание от системного аналитика, где детально написано, что нужно сделать. Сам инженер данных не принимает решений какую таблицу грузить в базу и какое поле в неё добавить. Всё это приходит в виде системных требований.

Инженер данных решает как именно грузить данные - инкрементно или полностью, как быть при повторном запуске и так далее. Это именно технические решения и техническая работа.

Когда задача завершена, тестировщик проверяет результаты. Только после всех проверок решение попадает в продакшн. Но процесс не всегда построен именно так...

Разный масштаб и команды

Описанное выше - стандарт больших компаний. Но что насчёт маленьких? В маленьких компаниях гораздо меньше ресурсов и нет возможности нанимать столько специалистов. Да и культура часто не простроена, а роли не распределены. В начале карьеры нужно быть к этому готовым.

В небольшой компании дата-инженер может заниматься чем угодно: поиском правильного решения совместно с бизнесом (вместо бизнес-аналитика), составлением системных требований (вместо системного аналитика), тестированием различных решений (вместо тестировщика) и, конечно, анализом данных и созданием BI-систем (вместо дата-аналитика и BI-аналитика). Всё это интересно, но это не работа дата-инженера.

Что по инструментам?

Стек технологий везде разный, но есть ключевые узлы. У вас должен быть оркестратор, чаще всего Airflow, иногда - Dagster. В оркестраторе идёт планирование процессов загрузки данных.

В любой системе есть источник (откуда данные грузятся) и приёмник (куда всё поступает). Тут всегда актуальны Python и SQL. Python - чтобы реализовать саму загрузку данных, SQL - чтобы правильно осуществлять вставки и проверить корректность данных.

Инструментами обработки данных могут быть Spark, DBT, Flink итд. В качестве финальной точки часто используют ClickHouse - на нём удобно делать витрины для UI или BI. Внутри системы можно столкнуться с Postgres, в Postgres обычно хранят транзакционные данные или метаданные. И конечно Kafka - через неё проходят потоковые данные, которые потом обрабатывает Flink или Spark Streaming.

Если компания работает с миллиардами строк, они могут использовать Lakehouse: хранение данных в S3 (Iceberg или Delta Lake). Если компания работает с миллионами строк и данные структурированы, ничего не мешает обходиться обычными Postgres и ClickHouse.

Из чего состоит ежедневная рутина?

Как и везде, вам придётся общаться с коллегами. Это могут быть аналитики, тестировщики или ваш руководитель. Коммуникация в любом случае будет. В моей работе созвоны и встречи обычно занимали ~10% времени.

У вас уйдёт время на разбор системных требований и деталей ТЗ. Это ключевой этап, иногда он занимает даже больше, чем работа с кодом. Сюда же добавим текстовую коммуникацию - нужно написать вопросы и отчитаться о сделанной работе. Текстовая коммуникация тоже занимает свои 10% времени.

Ну и база - работа с кодом. Это и запросы к нейросетям, и разбор проблемных моментов, и само написание кода. Несколько раз столкнувшись с ошибками нейросети в важных запросах или скриптах, вы точно начнёте всё проверять. Так что проверка, тестовый запуск и финальные правки - еще 20% работы перед публикацией в git.

Что примерно выходит по времени:
- речевая коммуникация ~ 10%
- текстовая коммуникация ~ 10%
- разбор требований к задаче ~ 20%
- написание кода ~ 20%
- проверка кода и тесты ~ 20%
- работа с Git (+ ребейзы, конфликты, итд) ~ 10%
- паузы, переключения, орг. моменты ~ 10%


И напоследок

400-500К рублей в месяц - вполне реальные зарплаты для опытного дата-инженера в РФ. Ваша рутина может отличаться от описанной тут. Но, надеюсь, общее понимание у вас появилось.

Сама работа может показаться скучной - иногда это просто перекладывание данных из одной базы в другую. Но набор применяемых инструментов и подходов - крайне интересен.

Учиться работе с данными можно долго и это очень увлекательно. Если учесть востребованность и неплохие зарплаты, Data Engineer - одна из самых интересных современных IT-специальностей.

Если заинтересовало - в статье еще больше деталей


CLICKHOUSE: ЧТО ВАЖНО ЗНАТЬ

Записал курс по ClickHouse и собрал самое важное в один пост. Если хотите работать с кликхаусом или собираетесь на собес - очень рекомендую🔥

Получилось 15 уроков, всё максимально структурировано и по делу. Ниже - ключевые моменты, чтобы за пару минут понять суть. А в конце - ссылка на бесплатный курс ⬇️

Что такое ClickHouse 🏠

Колоночная аналитическая СУБД - данные хранятся по столбцам, а не по строкам. Это упрощает сжатие и аналитические запросы, так что Clickhouse считает агрегаты по миллиардам строк за секунды.

Это не замена PostgreSQL, скорее его партнёр - транзакции приходят в OLTP-базу, аналитика собирается в ClickHouse, а между ними работает CDC или ETL-пайплайн.

Почему кликхаус такой быстрый🏄

Он берёт только нужные столбцы, ничего лишнего. Читает не построчно, а гранулами по 8192 строки, считает данные блоками и обрабатывает несколько значений за 1 такт процессора. Однотипные значения в столбце жмутся в 5–20 раз.

Структура хранения 📖

Внутри ClickHouse выстроен так: таблица - партиция - кусок - гранула (8192 строки). Вставки могут происходить и небольшими кусками, но фоновые слияния укрупняют мелкие куски.

Базовый движок хранения - MergeTree, на движках семейства MergeTree обычно хранят основные данные. Есть варианты - ReplacingMergeTree, CollapsingMergeTree и AggregatingMergeTree. На таких движках данные автоматически подменяются, удаляются или агрегируются в фоновом режиме. Для просмотра итогового вида таблицы в запросах используют слово FINAL.

Как правильно делать 🔥

● При создании таблицы задаём ключ сортировки - задаётся по частым фильтрам, от низкой кардинальности к высокой. Это даёт ускорение запросов в разы.

● Партиционирование делают по месяцу, при большом потоке - по дню. Лучше иметь десятки партиций, чем десятки тысяч. Таблицы меньше 10 ГБ можно не партиционировать.

● Данные вставляют батчами по 10–100 тысяч строк, не чаще раза в секунду. Если клиент не умеет вставлять батчами - включаем асинхронную вставку.

● ClickHouse не любит точечные правки. Есть лёгкий UPDATE, но для потока изменений стандарт такой: ReplacingMergeTree и вставка новой версии строки. Дубли схлопнутся при фоновом слиянии, а до него таблицу читают через FINAL.

● Денормализация при вставке, а не соединения при чтении. Справочник до 10 миллионов строк помещается в словарь, его значения подтягиваются в материализованном представлении через dictGet.

● EXPLAIN indexes = 1 SELECT ... показывает, сколько кусков и гранул будет прочитано запросом - сразу понятно надо ли менять ORDER BY.

● system.query_log - журнал выполненных запросов с временем, объёмом чтения и памятью, отдельно проверяем частые запросы.

Как лучше не делать🫣

1) Вставлять часто и по одной строке. Тысяча INSERT за минуту - тысяча кусков и ошибка "too many parts".

2) Менять строки по одной, как в OLTP. Мутация переписывает затронутые столбцы целиком, лёгкий UPDATE дешевле, но тоже не бесплатен.

3) Соединять две большие таблицы: правая целиком собирается в хеш-таблицу в памяти и если она большая - памяти может не хватить.

4) Ставить Nullable без нужды - лишний байт на строку и проверки. Если нет смысла в пустоте - выставляйте значение по умолчанию.

5) Ждать от ClickHouse транзакций, внешних ключей и быстрых точечных запросов по id, особенно если id нет в ключе сортировки. Это не его работа.

Что путают чаще всего🙄

Словарь - справочник в памяти, обращение по ключу за наносекунды, обновляется сам по времени жизни. Лучшая альтернатива JOIN.

Материализованное представление - обычно это триггер на вставку: считает агрегаты на входящем блоке и пишет в целевую таблицу.

PRIMARY KEY - не уникальный столбец, а разреженный индекс: одна отметка на гранулу, поэтому он указывает лишь диапазон, где искать.

Ключевое правило 🧠

ClickHouse блестяще решает задачу «прочитать много данных быстро» и плохо - «изменить одну строку быстро». Это ключевой момент при выборе СУБД и дальнейшей архитектуры таблиц.

Полное погружение в ClickHouse тут: https://directprobi.ru/platform/clickhouse-teoriya/


ГОЛОСОВОЕ УПРАВЛЕНИЕ АГЕНТАМИ

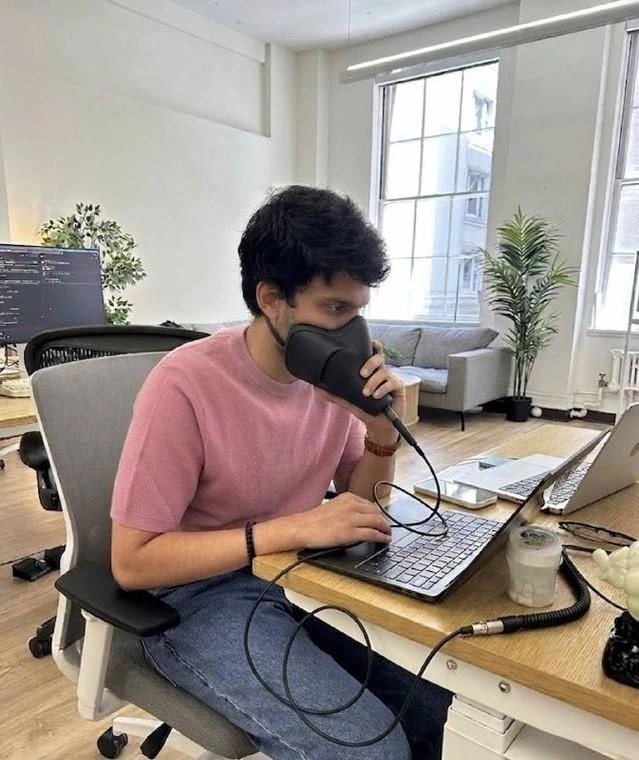
Многие видели маску для диктовки промптов, которая позволяет не мешать друг другу в офисе. Я долго вбивал текст руками, пока все пользовались аудио. Пришла пора перестать печатать🎙

Я привык вбивать любой текст руками. Мне казалось, что я печатаю быстро, но на практике скорость речи в 2.5 раза быстрее. Да, точность снижается, но скорость речи = 850 знаков в минуту против 330 знаках при печати.

Мне казалось, что при общении с агентами важна точность. На самом деле важно дать агенту как можно больше деталей для понимания задачи. А это как раз удобнее делать с помощью речи.

После первого общения с агентами в аудио возникли вопросы: зачем вообще ждать, пока этот микрофон включится? Почему нельзя всё время работать с активно включённым микрофоном? Почему не наговаривать текст в тот же Telegram или прямо в файл, не ограничиваясь Claude Code или Codex?

В Windows есть Win+H, но он требует интернета и не активен постоянно. Да и гибкости ему явно не хватает.

Как всегда - придумываем своё решение 🧠

Распознавание голоса оказалось гораздо проще, чем я ожидал. Не нужно задействовать API и платить деньги. Всё можно сделать на своём компе. С помощью Claude написал небольшую программу на базе Сберовской аудио-модели GigaAM v3 e2e CTC. Теперь прога постоянно крутится локально, слушает мою речь и транслирует в текст. Кстати, этот пост частично написан с помощью аудио.

Если не пытаться слушать музыку, многие процессы становятся в разы быстрее. Это и работа с текстами, и постановка задач агентам, и сообщения, и просто сбор полезных мыслей.

Отдельный кайф - настраиваемая автозамена. Говоришь одно слово, а печатается заранее заготовленная длинная команда.
произносишь "окружение"
-> печатается "source /home/user/venv/bin/activate"🔥

Можно даже повесить на голосовую команду выполнение скрипта: сказал слово - запустилась программа. Звучит как что-то невероятное 😵‍💫

Есть конечно и недочёты: если пишешь пост или важное сообщение, сходу правильно надиктовать почти нереально, придётся править. Хотя и при печати также☺️
По скорости и ресурсам у себя проблем не замечал (на серверах тоже ок), но если ресурсов не хватает, диктовка может подтормаживать.

За последнее время создал много небольших, но полезных инструментов. В основном для себя, не рассчитывая их продать, так как цена копеечная. Скоро обязательно соберу всё воедино, выложу на платформе и сделаю про них подробное видео🤗

А вы как, уже пользуетесь голосовым промптингом?


ПРО ДАТА-ИНЖЕНЕРОВ

В конце 2024-го года я писал пост (https://t.me/directprobi/119) об окончании курса "Инженер данных". Это был типичный технический курс по всем хард-скиллам дата-инженера. Много преподов и огромный пласт разного опыта.

Такие курсы проходят, чтобы работать с большими данными. Найти такую работу у меня получилось довольно быстро😊 Уже почти полтора года я работаю дата-инженером в крупной компании. И это совсем другой опыт по сравнению с работой в рекламном агентстве.

Изначально этот канал был посвящён Power BI, Power Query, коннекторам и разным полезностям - это был очень крутой бекграунд. Но область Data Engineering гораздо шире, чем Power BI или Power Query. И инструментов там гораздо больше 🫣

Теперь это канал про данные, дата-инженеров и в целом про IT. Спрос на специалистов по работе с данными уже давно растёт, да и вокруг полно интересных тем, о которых хочется рассказать.

Если вам интересна работа с данными, на платформе я собрал все курсы по Power BI, Power Query и коннекторам, и конечно добавил новых - про Big Data и другие полезные инструменты. Есть много бесплатного, но желающие поддержать могут оформить недорогую подписку 🔥

Заходите, платформа тут: https://directprobi.ru/platform/


Все коннекторы на одном лендинге

Наконец-то структурировал инфу по коннекторам для сбора данных в БД - теперь всё на одной странице.

Все функции для загрузки данных бесплатно выложены на Github. Также есть открытая справка по применению функций с примерами на Python. Всё максимально доступно и понятно, даже нейронка не нужна😊

Это отличный вариант если вы не собираетесь делиться токенами со сторонними компаниями и хотите организовать сбор данных на своём серваке.

Если нужно добавить коннектор к популярному сервису, можно написать мне в личку, думаю смогу с этим помочь.

Вся инфа и ссылки теперь тут: https://directprobi.ru/connectors/


ОСНОВЫ APACHE AIRFLOW

Ещё когда работал с Power BI, меня всегда интересовал Airflow. Сначала он казался чем-то сложным - миллион настроек, да еще эти питоновские классы и другие нюансы кода, что сходу не разберёшься.

У меня были коллеги, кто гораздо лучше умел его настраивать. Они писали свои кастомные операторы, делали сложную загрузку данных, отчего еще больше казалось, что я вообще ничего не пойму 🙄

Со временем стали понятны несколько вещей:
⚡️ ничего сложного в самом Airflow нет (ну, кроме классов)
⚡️ Airflow - всего лишь оркестратор, он не должен выполнять никакой загрузки данных, только вызывать скрипты
⚡️ вам на самом деле не нужен миллион настроек, хватит примерно десятка (или двух)

Теперь работаю с Airflow каждый день и сделал довольно подробный ролик по его настройке. У многих не работает YouTube, так что смотрите прямо на платформе:
https://directprobi.ru/platform/apache-airflow-osnovy/


Как я ушел с GetCourse и сделал свою обучающую платформу
(ссылка в конце поста)

Раньше регулярно оплачивал GetCourse. В среднем около 5000 рублей в месяц (4000р за тариф, 1000р за хранилище). Это минимальный тариф (до 1000 пользователей), меньше уже некуда.

Идея сделать свою обучающую платформу давно сидела в голове, но раньше казалась слишком сложной - ведь это огромный объём работы (будто бы основной работы мало).

Но когда стало популярным писать код нейросетями, я взглянул на задачу иначе и решил попробовать 💪
Накидал схему базы данных *, прикинул разные кейсы и начал делать проект на любимом Django.

* Вспомнил, что в Karpov Courses на курсах дата-инженера мы именно такую схему и рисовали в конце первого блока - там были курсы, студенты, уроки, итд - не зря учился)))


Заход #1: Replit - AI IDE для простых смертных
Первый и самый простой вариант для старта. Там были разные глюки, странности, не всё работало идеально. Но главное, что это работало. Основа платформы была запущена и видео грузились.

Заход #2: Cursor - AI IDE для разработчиков
Настало время для «более программистского» инструмента. Cursor в мелочах удобнее для программиста, но плевался я от него не меньше. Отладка процесса оплаты потребовала проведения 50+ транзакций, прежде чем всё заработало.

Заход #3: Claude Code - агент для кодинга
И тут уже всё полетело. Переход на Claude Code позволил всё доработать и сделать приемлемым. Устранение ошибок, доработка фичей, настройка той же оплаты — всё пошло в разы быстрее и круче.

Для видео выбрал Kinescope. Нужна была надёжная платформа для хранения и стриминга, а у них отличные условия. Кстати, слышал Kinescope тоже делает один человек:)

Что в итоге получилось?

✅ Стоимость упала в 4 раза: с 5000 ₽ до 1200 ₽ в месяц. Возможно, она вырастет, но всё равно экономия существенна.

✅ Никаких ограничений - если в геткурсе минимальный тариф работает до 1000 юзеров, то тут - разве что не потянут CPU и RAM, других лимитов нет.

✅ Полная кастомизация: Можно добавлять любые фичи, которые придут в голову. Захотел переключатель «презентация/видео» - сделал. Нужны квизы после уроков - пожалуйста. Возможность скрыть или показать список всех уроков - не проблема.

✅ Игровая динамика: Добавил баллы за прохождение уроков и систему грейдов для мотивации. Теперь учиться интереснее:)

Не претендую на инфраструктуру подобную GetCourse, но тот минимальный набор функций, которым я пользовался там, реализовать удалось. И это уже очень неплохо🔥

На платформе уже появились разные курсы, в том числе и сделанные от начала до конца с помощью ИИ, но о курсах расскажу в следующих постах.

Сама платформа тут: https://directprobi.ru/platform/


————————————
Серия подкастов про ИИ

Мне очень нравится NotebookLM с его возможностью делать подкасты на любую тему и быстро изучать любую область. Можно накидывать в источники множество Youtube видео, иностранных сайтов из поиска, а если нужно, то и выгрузку чатов Telegram.

Сделал для вас несколько подкастов про ИИ на тему расширенной работы с LLM. Инфа в подкастах частично пересекается, но каждый по отдельности интересен.

Какие есть варианты добавления знаний в LLM:
• собственные файлы
• поиск в интернете
• дообучение модели
• RAG на ваших данных

Ну и темы про принятие решений на стороне LLM:
• MCP как протокол общения LLM с внешним миром
• ИИ-агенты как самостоятельные системы на базе LLM

Ссылка на канал тут если потерялась при пересылке🔥


Подключение к 1С актуально для большинства бизнесов, но в интернете слишком много разрозненной инфы по этой теме 😵‍💫

В этом видео сравнил разные методы подключения к 1С, а также рассказал почему лучше выбрать платный коннектор за небольшую цену.

В чём преимущества такого решения:
1) Поддерживает большие объемы данных
2) Не требует вмешательства программистов
3) Отображает человеческие названия столбцов + полезные метаданные с подсказками для быстрого создания связей
4) Работает даже в Excel - есть в виде обычной функции Power Query + в виде MEZ для Power BI
5) Теперь к нему есть короткое понятное видео с примером создания отчёта 🔥

Как пользоваться коннектором и как создать простой отчёт смотрите тут: https://youtu.be/8_SzGH3ApDY


КАК ПОЛУЧАТЬ ДАННЫЕ ИЗ CLICKHOUSE В POWER BI И EXCEL

Ранее у меня уже была статья на эту тему, но поскольку тема всё более популярна, решил сделать видео 🔥

Разбираю разные способы получения данных, но чаще всего достаточно простого кода на Power Query:
Table.PromoteHeaders(Csv.Document(
Web.Contents("XXXXX.ru:8123", [Timeout=#duration(0,0,30,0), Query = [
user = "XXX",
password = "123123123",
query = " SELECT * FROM xxx.xxxxxxxxx " & " FORMAT CSVWithNames "
]])))

В плане безопасности:
Важно ставить качественные пароли, а также закрывать доступ к Clickhouse по IP лишним пользователям. И конечно, не стоит пересылать файлики pbix или xlsx с параметрами подключения в коде. Так вы уже хорошо защитите свою БД от внешних подключений и подбора пароля.

Ссылки на видео:
https://youtu.be/1t_PrAuSoL8
https://vkvideo.ru/video-174039178_456239883


НОВАЯ СТАТЬЯ ПРО CLICKHOUSE И DOCKER

Если раньше вам требовался отдельный человек, который будет писать коннекторы и мониторить загрузку данных в базу, то теперь всё может работать в докере в параллельных потоках с регулярными оповещениями в Telegram.

Да, Ozon и WB могут создать некоторые трудности, но в первую очередь это ошибки их собственных API. С остальными сервисами всё работает прекрасно 🥂

О чём написал в статье:
- как развернуть ClickHouse
- как заблокировать доступ к ClickHouse чужим IP
- как настроить сбор данных в ClickHouse за 1 час
- как запустить параллельные потоки сбора данных
- как объединять таблички после загрузки в ClickHouse
- как подключиться к ClickHouse из Excel и Power BI
- как решать проблемы в случае остановки загрузки

Ссылка на статью 😋находится тут😋

Кажется, уже всё рассказал - снял несколько видео и теперь есть статья со всеми деталями. Вам остаётся только попробовать❤️

Кстати, последний раз мне удалось залить метрику минут за 15 - настолько всё стало быстро и удобно:)


ИЗ API В GOOGLE SHEETS НА PYTHON

Загрузка данных в Clickhouse - это замечательно, но никто не хочет работать с БД 😔

Когда приходится даже минимально разбираться с серверами, Docker, Linux, Clickhouse, порой кажется, что проще было бы качать данные руками, чем освоить всё это.

Как итог - даже готовые коннекторы с подробной инструкцией по загрузке данных мало кого вдохновляют.

Новый формат применения коннекторов

Теперь вы не сможете сказать, что чего-то не знаете 😊 Максимально простой скрипт на Python и данные загружены в Google Sheets! Никаких докеров, линуксов и БД 🔥

Если компьютер не всегда включен, а обновление нужно ночью, желающие могут взять виндовый сервер и настроить ежедневное обновление там.

Что можно грузить:
WB, OZON, Yandex Market, GetCourse, Yandex Direct, VK Ads, Yandex Metrika, Bitrix24 и еще несколько коннекторов в разработке.

Видео как это работает:
https://vkvideo.ru/video3073415_456240030

Получение токена Google Sheets:
https://github.com/morinad/google_token-oauth_by_link

Пример скрипта и актуальный список коннекторов:
https://boosty.to/morinad/posts/1ba11242-7625-43aa-817e-0d6be7676dfd?share=post_link


ЧАСТЫЕ ФОРМАТЫ ФАЙЛОВ ДЛЯ РАБОТЫ С ДАННЫМИ

Недавно создал новый YouTube канал, куда буду закидывать технические (и не только) видосы обучающего характера.

В них нет простых и полезных решений для маркетологов или BI-аналитиков. Это более техническая инфа, касающаяся работы с данными. Так что подобные видео могут быть больше интересны IT специалистам.

Пока начал с простого - популярные форматы файлов:
https://vkvideo.ru/video3073415_456240029
ТОП-10 форматов для работы с данными: от CSV и JSON до PARQUET
Наши курсы: 1) Основы Power BI (бесплатный курс): https://directprorf.ru/basics?utm_source=vkvideo 2) Power BI для рекламных отчётов: https://directprorf.ru/powerbi?utm_source=vkvideo 3) Коннекторы для рекламных отчётов: https://directprorf.ru/excel?utm_source=vkvideo 4) Коннекторы для Маркетплейсов...


Небольшое видео про API Яндекс Диска

Поскольку ссылка на видео YouTube может искажать статистику видео, буду публиковать здесь ссылки на ВК. Да и ВПН никому включать не придётся😊

Видео тут: https://vkvideo.ru/video3073415_456240028

А файлы как всегда на Boosty (в открытом для всех посте)
Данные Яндекс Диска в Power BI и Excel по API
Новые видео, статьи и полезности в Telegram: https://t.me/+AvtWabJB1ms5NmE6 Файлы на Boosty (бесплатно): https://boosty.to/morinad/posts/2f48cda3-3953-491d-9ae4-9991dddfe0d4?share=post_link Наши курсы: 1) Основы Power BI (бесплатный курс): https://directprorf.ru/basics?utm_source=vkvideo 2) Power..


🌟 APACHE SPARK ПРОСТЫМИ СЛОВАМИ 🌟

Когда вы работаете с сырыми данными, где каждое действие - отдельная строка, приходится обрабатывать огромные объёмы данных😭 Обычно для таких преобразований используются распределённые системы, например Apache Spark.

Преобразования в Spark чем-то похожи на Power Query, например неиспользуемые шаги там тоже не выполняются. Правда Spark вообще ничего не будет выполнять пока не поступит команда-действие, например "загрузить итоговые данные в файл".

Как это устроено изнутри рассказал в небольшом видео🔥

Видео тут: ссылка


ДЕТАЛЬНО ПРО FINE-TUNING CHATGPT

Написал крутую детальную статью про дообучение ChatGPT👇

Дообучение модели состоит из 2 этапов - работа с дообучающим файлом и работа по дообучению модели. Оба этапа Fine-Tuning можно выполнять как через интерфейс ChatGPT, так и по API.

Для удобства рекомендую готовить дообучающий файл через Excel и отправлять прямо из Excel с помощью API.

Если вы хотите добавить свои настройки дообучения, дальнейшее дообучение можно делать через интерфейс. Если же вас устраивают настройки по умолчанию - можно выполнять дообучение также в Excel-файле.


Статью можно почитать тут


ДООБУЧЕНИЕ CHATGPT НА СВОИХ ДАННЫХ

Если вы хотели дообучить ChatGPT на своих данных, то вариант сделать это через Excel - самый простой. Вы сможете использовать дообученную модель в любых программах и чат-ботах на любом языке программирования.

Конечно, для качественного дообучения вам понадобится не 10 строк, а хотя бы 1000, а лучше 10 000, но зато результат дообучения будет гораздо интереснее.

Видео как дообучать ChatGPT через Excel:
https://youtu.be/y1kvizbxv6U

Работает всё это конечно же через VPN, без этого ChatGPT просто не примет ваши запросы.

Excel-файл для дообучения тут:
https://boosty.to/morinad/posts/a0264d42-9aa3-4434-8d9c-57c1a256d5fa?share=post_link

Будьте осторожны с запросами в Excel - повторное обновление может привести к повторной отправке файла или к повторному запуску дообучения. После запуска дообучения из нужного файла можно сразу удалить ID файла на вкладке fineTuning.

Изучите справку и прайсы перед началом работы:
- список доступных моделей для дообучения
- стоимость дообучения и использования моделей


Видео недоступно для предпросмотра
Смотреть в Telegram
Получение содержимого папки из Yandex Disk API 🔥

После добавления коннектора к файлам Яндекс Диска для Power Query очень просили получение файлов из папки.

Как в PBI Service обновлять данные из папки без шлюза?
🫣

1) Грузим файлы в папку на Яндекс.Диск.
2) Обращаемся к API Яндекс.Диска с помощью функции ниже и получаем список доступных файлов.
3) На основе коннектора к файлам пишем запрос по обработке типового файла и превращаем этот запрос в функцию от адреса файла.
Если сразу параметризуете адрес файла в запросе, можно быстро создать функцию, которая будет меняться при изменении запроса. Для этого просто жмём правой кнопкой на запрос с параметром и выбираем создать функцию.

4) Добавляем к списку файлов столбец с вызовом нашей функции от адреса файла и разворачиваем полученные таблицы.

Процесс показал на видео. Как итог - все файлы в папке обработаны одинаково, а при добавлении в папку похожих файлов их данные автоматом попадают в общую таблицу. При этом функцию обработки легко корректировать.

Где это работает?
- Power BI Desktop
- Power BI Service
- Power BI Report Server
- Excel

Получение списка файлов из папки тут:
let
function = (fileLink as text, token as text)=>
let
headers=[#"Content-Type" = "application/json", #"Authorization" = "OAuth "&token, #"Accept" = "application/json"],
querydata = [#"path" = Text.Replace(fileLink, "\","/"), limit="1000000"],
web = Web.Contents("https://cloud-api.yandex.net/", [RelativePath="v1/disk/resources", Headers = headers, ManualStatusHandling = {404, 400}, Query =querydata]),
result = Json.Document(web),
link = result[_embedded],
items = link[items],
toTable = Table.FromList(items, Splitter.SplitByNothing(), null, null, ExtraValues.Error),
expandColumn = Table.ExpandRecordColumn(toTable, "Column1", {"created", "modified", "size","path"}, {"created", "modified","size", "path"}),
pathCorrect = Table.ReplaceValue(expandColumn,"disk:/","",Replacer.ReplaceText,{"path"}),
chType = Table.TransformColumnTypes(pathCorrect,{{"created", type datetime}, {"modified", type datetime}, {"size", type number}})
in
chType,
result = Value.ReplaceType(function, FuncType),
FuncType = type function (fileLink as (type text meta [
Documentation.FieldCaption = "Путь к папке после C:\YandexDisk\:",
Documentation.SampleValues = {"Мои файлы\Лучшие файлы"}]),
token as (type text meta [
Documentation.FieldCaption = "Ваш токен (ссылка на получение ниже):",
Documentation.SampleValues = {"y0_AgAAAMfGA...rBX0d-ZpA5O"}]))
as table meta [
Documentation.Name = "Получаем список сущностей из папки Яндекс.Диска",
Documentation.LongDescription = "",
Documentation.Examples = {[ Description = "Ссылка на получение токена:",
Code = "https://oauth.yandex.ru/authorize?response_type=token&client_id=a363cf6712db45978a012820777fc06a",
Result = "По ссылке вы получите токен" ]}]
in result

Показано 20 последних публикаций.