


Как обучить GPT на своих данных?
Проблема:
У меня есть Telegram User-бот, созданный за один вечер. Он следит за каналами, ждет новые посты и пишет комментарии для привлечения трафика.
Но ответы бота слишком общие. Хочется, чтобы комментарии соответствовали тематике канала. Для этого нужно обучить ИИ на контенте канала.
Варианты решения:
1. Fine-tuning
Берем базовую модель (GPT-4, LLama 3.1, Claude) и дообучаем на своих данных. Минусы: Дорого, Долго, частые галлюцинации, данные быстро устаревают.
2. RAG (Retrieval-Augmented Generation)
Вкратце, передаем модели данные через промпт (например, актуальный курс валюты) и с ними работаем. Минус: объем данных ограничен размером контекстного окна.
Решение:
И тут нам на помощь расширения контекстного окна спешит векторное представление! Это преобразование слов в числовые векторы, например:
Король: [0.5, 0.1, 0.3],
Королева: [0.5, 0.2, 0.3],
Принц: [0.4, 0.1, 0.4],
Принцесса: [0.4, 0.2, 0.4],
Трон: [0.6, 0.1, 0.2],
Замок: [0.3, 0.1, 0.5],
Компьютер [0.1, 0.4, 0.6]
У векторных слов есть параметр «косинусное сходство», показывающий связь между векторами. Например, сходство между «король» и «королева» ≈0.98, а «король» и «компьютер» ≈0.49.
Нормой считается значение ≈0.7, ниже — хуже. Векторное представление слова не фиксировано и вычисляется из доступного контекста, например, из книги.
Как вычислить эти векторные отношения?
Легко. Это называется эмбеддингом данных. В API OpenAI есть метод Embeddings, который принимает текст и возвращает его векторное представление.
Он подходит для неструктурированных данных, таких как мой Telegram канал. Или мы можем вручную структурировать данные и дать ML наводку на эталонный ответ с косинусным сходством 1.
Таких библиотек много, но суть одна — они вычисляют векторные представления смыслов и описывают связи между словами.
Так же вектора позволяют делать математические операции над ними. Например, если из вектора «король» вычесть «мужчина» и прибавить «женщина», получится вектор, близкий к «королева».
Эмбеддинг — это «смысл» данных в представлении для нейросети.
Что делать дальше?
Сохраняем результаты в векторную базу данных и позволяем нейросети, прежде чем ответить, искать смысл по значению векторов с косинусным сходством 0.7 или выше. Тогда ответы будут основаны на наших данных и без галлюцинаций.
А если ещё дальше?
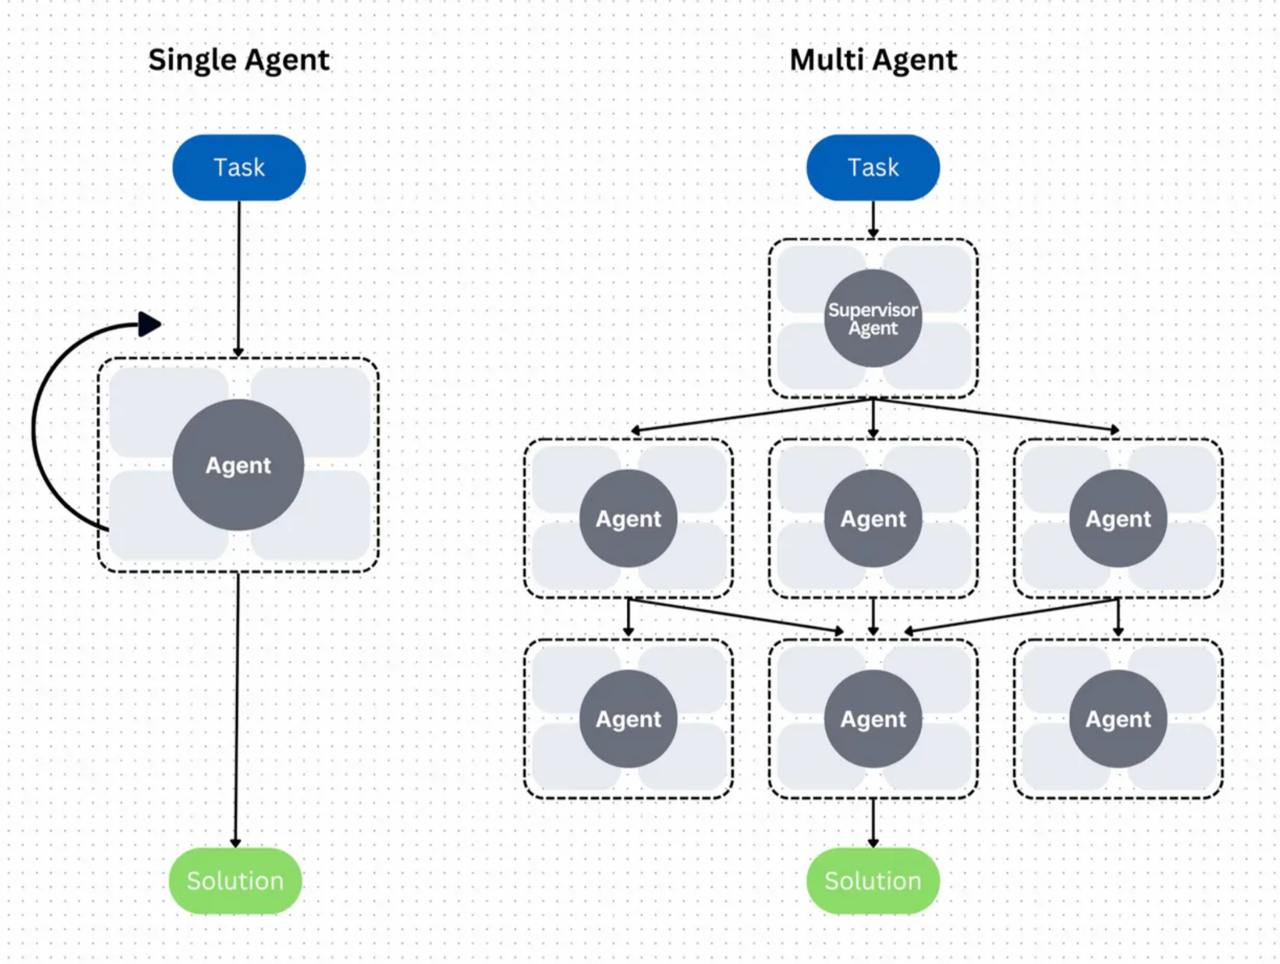
Мы плавно подходим к ML-агентам. Это наборы нейросетей, каждая из которых отвечает за знания в определённой области.
Например, один агент знает о курсе доллара, другой — о моём канале. Разделение на такие «функции» позволяет исключить неверные ответы до 98% и создать конвейер по производству контента.
Сейчас в Twitter на хайпе такие ML-агенты, состоящие из нескольких частей:
Центральный агент — мозг управляет всем, агент планирования — анализирует задачу, агент действия — адресует задачу конкретному агенту, агент памяти — сохраняет все взаимодействия и дообучается на них…
Теперь осталось найти время, чтобы реализовать теорию на практике.
📊 #статистика День 1093 == 2220 час в IT