


Тестирование GigaChat 3.1 10B на агентных бенчмарках
Обычно я не пишу про новые модели, тем более отечественные, но совсем недавно состоялся релиз моделей семейства GigaChat 3.1 от команды Сбера.
В линейке вышли две модели, на 702B и 10B параметров, обе построены как MoE и обе, судя по позиционированию, должны хорошо работать с русским языком, но моя специализация больше про агенты, поэтому я рассматриваю модели прежде всего как основа для агентов. Поскольку у меня нет ресурсов для запуска версии на 702B, выбор пал на 10B, так как после апгрейда моей RTX 4090 до 48 Гб памяти такой вариант вполне можно погонять локально.
Про предыдущую ноябрьскую модель мне писать не хотелось, потому что для агентных сценариев она была практически бесполезна, максимум наивный tool calling на несколько тулов. При этом в анонсе 3.1 отдельно делался акцент на том, что она поддерживает function calling, поэтому ожидание было простое - модель должна заметно лучше работать в таких задачах.
С учётом прошлого опыта, когда промпт для тройки ещё пару недель доводили после релиза, я решил не спешить и отложил тесты, однако, пару дней назад появилась новость о том, что в vLLM была добавлена поддержка гигачатовского шаблона tool calling, и вроде как теперь тулами точно можно пользоваться.
Для оценки я использовал три хорошо знакомых мне бенчмарка, которые довольно быстро показывают, способна модель решать агентные задачи или нет:
- SWE - https://github.com/swe-bench/SWE-bench
- TAU - https://github.com/sierra-research/tau-bench
- BFCL - https://github.com/ShishirPatil/gorilla/tree/main/berkeley-function-call-leaderboard
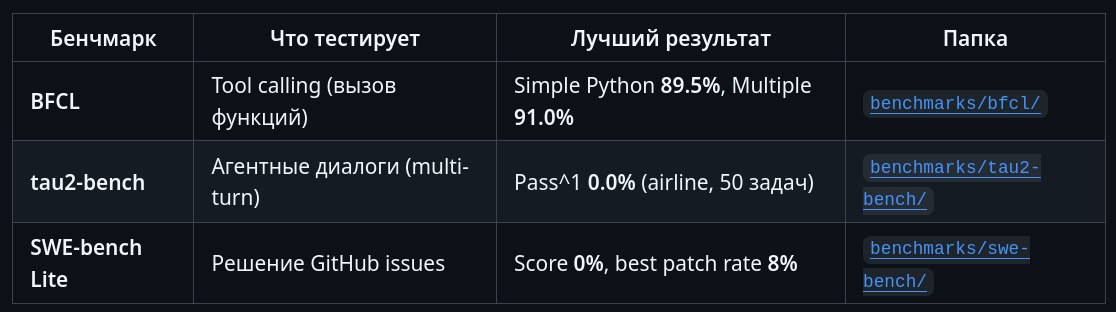
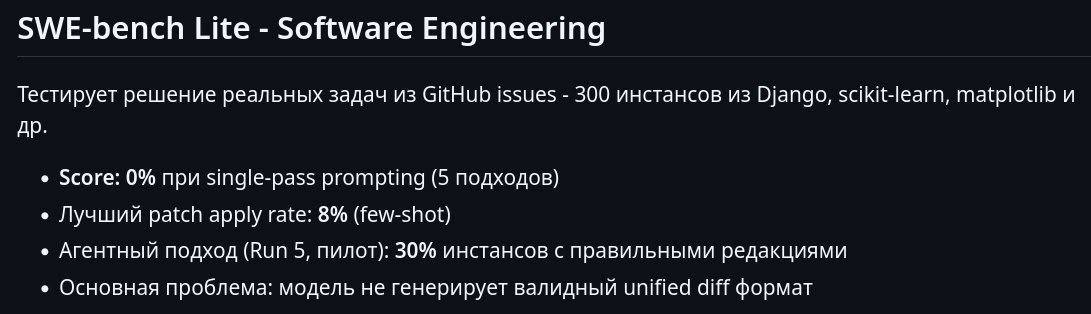
На SWE модель показала 0%. Пришлось прям заморочится чтобы запустить тестирование модели на этом бенчмарке, а потом ещё и тюнить chat template пошел, потому что модель не хотела стабильно генерировать валидный diff patch, но даже это ситуацию не исправило, хотя с новым шаблоном промежуточные результаты стали чуть стабильнее.
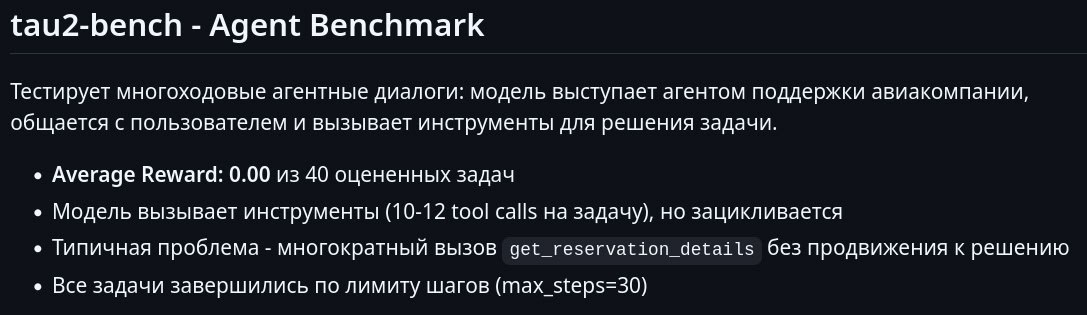
На TAU результат тоже 0%. Модель уходит в бесконечные последовательности вызовов тулов и не может корректно определить, достаточно ли ей уже данных для завершения задачи или нет.
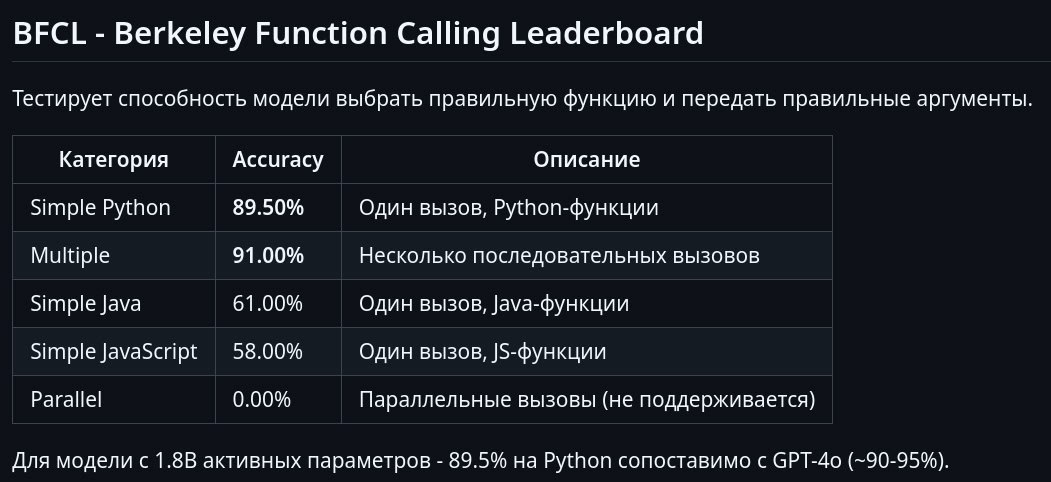
Единственным бенчмарком, который показал подозрительно (так как на остальных агентных бенчах результаты нулевые) высокие результаты, оказался BFCL. На нём модель набрала 89.5% на Simple Python, 91% на Multiple, а на остальных тестах результаты были уже скромнее - в районе 61%. Заодно этот бенч показал, что параллельные вызовы модель не поддерживает (но это возможно через правки промта можно поправить).
Результаты тестов, детали запуска и отладочные данные собраны здесь:
https://github.com/EvilFreelancer/gigachat-benchmarking
Чуда, к сожалению, не произошло. Складывается впечатление, что развитие больших языковых моделей пока не до конца синхронизировано с тем направлением, в котором сейчас движется объективная действительность, так как для практических agentic-сценариев одной только более-менее рабочей поддержки function calling уже недостаточно. Если модель не держит agentic loop, её прикладная ценность в таких задачах остаётся очень ограниченной.
При этом прогресс всё же есть. Если смотреть на дистанции в несколько лет, путь от ruGPT2 до почти стабильно работающего function calling - это заметный прогресс. Но по текущим меркам этого всё ещё мало.
Мой итоговый вывод довольно простой:
На мой взгляд, для среднего класса агентных задач куда интереснее выглядел бы формат MoE в диапазоне 100-150B в битности MXFP4, при этом и нижнюю границу компактной модели, как мне кажется, нет большого смысла опускать ниже 13B (как-то посчитать какой размер оптимальнее всего для 24Гб VRAM с контекстом 30-60k токенов), да и плюс размер эксперта в 1.8B маловато, к чему высокая скорость если модель не держит контекст и уходит в циклы.
Для себя выводы я сделал, подожду GigaChat 4, по моим ощущениям, она должна выйти осенью на AI Journey. Возможно, у новой модели ситуация изменится. Хотя вполне вероятно, что к тому моменту рынок снова успеет уйти вперёд.
Обычно я не пишу про новые модели, тем более отечественные, но совсем недавно состоялся релиз моделей семейства GigaChat 3.1 от команды Сбера.
В линейке вышли две модели, на 702B и 10B параметров, обе построены как MoE и обе, судя по позиционированию, должны хорошо работать с русским языком, но моя специализация больше про агенты, поэтому я рассматриваю модели прежде всего как основа для агентов. Поскольку у меня нет ресурсов для запуска версии на 702B, выбор пал на 10B, так как после апгрейда моей RTX 4090 до 48 Гб памяти такой вариант вполне можно погонять локально.
Про предыдущую ноябрьскую модель мне писать не хотелось, потому что для агентных сценариев она была практически бесполезна, максимум наивный tool calling на несколько тулов. При этом в анонсе 3.1 отдельно делался акцент на том, что она поддерживает function calling, поэтому ожидание было простое - модель должна заметно лучше работать в таких задачах.
С учётом прошлого опыта, когда промпт для тройки ещё пару недель доводили после релиза, я решил не спешить и отложил тесты, однако, пару дней назад появилась новость о том, что в vLLM была добавлена поддержка гигачатовского шаблона tool calling, и вроде как теперь тулами точно можно пользоваться.
Для оценки я использовал три хорошо знакомых мне бенчмарка, которые довольно быстро показывают, способна модель решать агентные задачи или нет:
- SWE - https://github.com/swe-bench/SWE-bench
- TAU - https://github.com/sierra-research/tau-bench
- BFCL - https://github.com/ShishirPatil/gorilla/tree/main/berkeley-function-call-leaderboard
На SWE модель показала 0%. Пришлось прям заморочится чтобы запустить тестирование модели на этом бенчмарке, а потом ещё и тюнить chat template пошел, потому что модель не хотела стабильно генерировать валидный diff patch, но даже это ситуацию не исправило, хотя с новым шаблоном промежуточные результаты стали чуть стабильнее.
На TAU результат тоже 0%. Модель уходит в бесконечные последовательности вызовов тулов и не может корректно определить, достаточно ли ей уже данных для завершения задачи или нет.
Единственным бенчмарком, который показал подозрительно (так как на остальных агентных бенчах результаты нулевые) высокие результаты, оказался BFCL. На нём модель набрала 89.5% на Simple Python, 91% на Multiple, а на остальных тестах результаты были уже скромнее - в районе 61%. Заодно этот бенч показал, что параллельные вызовы модель не поддерживает (но это возможно через правки промта можно поправить).
Результаты тестов, детали запуска и отладочные данные собраны здесь:
https://github.com/EvilFreelancer/gigachat-benchmarking
Чуда, к сожалению, не произошло. Складывается впечатление, что развитие больших языковых моделей пока не до конца синхронизировано с тем направлением, в котором сейчас движется объективная действительность, так как для практических agentic-сценариев одной только более-менее рабочей поддержки function calling уже недостаточно. Если модель не держит agentic loop, её прикладная ценность в таких задачах остаётся очень ограниченной.
При этом прогресс всё же есть. Если смотреть на дистанции в несколько лет, путь от ruGPT2 до почти стабильно работающего function calling - это заметный прогресс. Но по текущим меркам этого всё ещё мало.
Мой итоговый вывод довольно простой:
Использовать маленькую модель на 10B незачем, а большую на 702B - не на чем.
На мой взгляд, для среднего класса агентных задач куда интереснее выглядел бы формат MoE в диапазоне 100-150B в битности MXFP4, при этом и нижнюю границу компактной модели, как мне кажется, нет большого смысла опускать ниже 13B (как-то посчитать какой размер оптимальнее всего для 24Гб VRAM с контекстом 30-60k токенов), да и плюс размер эксперта в 1.8B маловато, к чему высокая скорость если модель не держит контекст и уходит в циклы.
Для себя выводы я сделал, подожду GigaChat 4, по моим ощущениям, она должна выйти осенью на AI Journey. Возможно, у новой модели ситуация изменится. Хотя вполне вероятно, что к тому моменту рынок снова успеет уйти вперёд.