Геолог-программист


Гео и язык канала: Россия, Русский
Категория: Технологии


В этом канале делюсь различными рекомендациями и контентом, который считаю полезным или интересным. Как правило, контент связан с программированием в геологии.
Чат по программированию и ML: https://t.me/GeoMLearning

Связанные каналы

Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


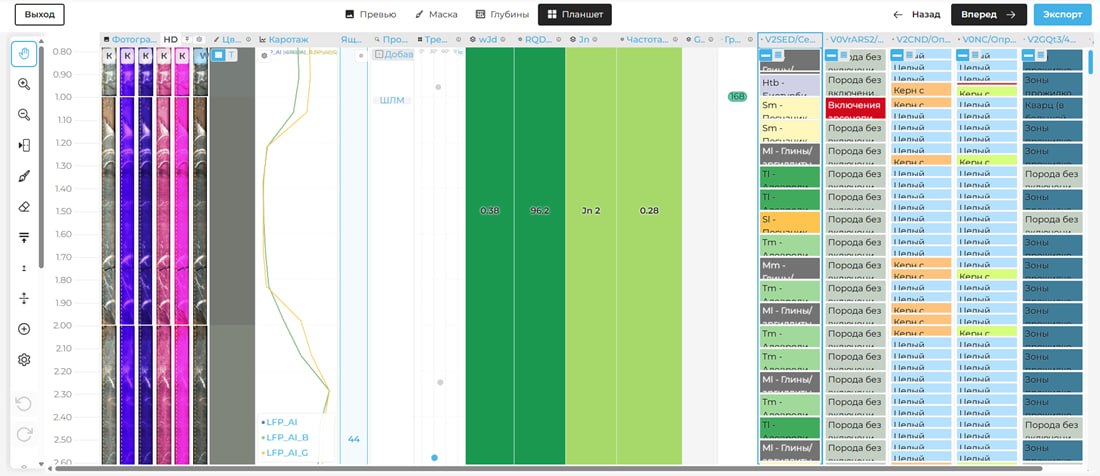
Кстати, у нас случился релиз 🥳.

Заходите - попробуйте https://deepcore.petroleum.digital/ (если вы были ранее зарегистрированы - все данные должны были сохраниться).

Теперь определяется вся геотехника, включая альфу и бетту и можно фильтровать по естественным трещинам (это всё было, но теперь всё на одном планшете и не надо перезапускать), дополнительно - можно вообще всё что угодно загружать, включая шлифы и каротаж.

Выгрузка - в любом видео - строгая отчетность в docx, csv, xlsx

Шлифы можно тоже обрабатывать - определять гранулометрию, следите за обновлениями, скоро будет много интересного ;)

@geologistprogrammer | VK | max


Кому алмазных буровых голов отечественных с XII (самым сложным) классом буримости?
(не реклама, как всегда - делюсь новостями с конференций)

Доклад вызвал бурную дискуссию и желание поддержать проект со стороны экспертов, вношу свою лепту :)

Ещё немного пообщался с самим производителем - оказывается, буровиков-технологов не хватает, много кто просто губит коронки на пустом месте, вне зависимости от страны производства коронок.

@geologistprogrammer | VK | max


Кто на Майнексе - буду рад видеть в 'Толстом', презентация будет в районе 10:30-11:30 (возможно позже) и после - у нашего стенда 🤝


Она перестала быть только про керн.

Идея новой версии системы автоматического описания керна — логичный запрос от пользователей: хочется хранить и смотреть на всё вместе, наша же позиция всегда была от данных, которые мы можем обрабатывать автоматически, теперь работаем и с образцами (шлифы, аншлифы, шлам), и с каротажем.

Мы продолжаем встраиваться в специализированные системы наших партнеров (зачем реализовывать у себя то, что и так уже есть у коллег, благодаря чему пользователь не должен учиться новому инструменту), однако, как и любой вендор, должен быть «founder's edition» версия, чтобы можно было легко тестировать гипотезы и быть максимально гибким к применению тех или иных алгоритмов с возможностью быстро адаптировать готовый и оттестированный функционал коллегам с понятным запросом по ручкам и данным для легкого внедрения.

С новой версией можно будет познакомиться на Майнексе (у некоторых коллег она уже развернута для тестов ;), 7-го октября на сессии «Методики и технологии эффективного изучения недр», в промежуток между 10 и 11 буду одним из докладчиков, а после у нас на стенде можно будет попробовать самостоятельно (вход на выставку — бесплатный).

@geologistprogrammer | VK | max


Scispace\perplexity на коленке

С чего на самом деле начиналась история ИИ - ассистента?
На самом деле - первоначальная задумка - создать непосредственно помощника исследователя, аналогичного перечисленным в заголовке.

Как они работают?
Как правило - это некоторая большая языковая модель или ряд отдельных БЯМ вокруг которых есть разные инструменты - это всё объединяется в харнес-систему (harness - упряж), где множество агентов одновременно выполняют различные задачи.
Главная модель (как правило - самая большая) - является оркестратором, которая знает сильно больше других, и ряд маленьких - у них в контексте четкая задача и небольшой набор инструментов для них.

Например, вы отправляете запрос "Создай подборку статей про рудоносность золото‑сульфидных месторождений Восточной Сибири за последние 5 лет".
Оркестратор раскидывает задачу:
— один агент генерирует ряд запросов для поиска, вытаскивает DOI / аннотации, научные метаданные;
— второй шерстит открытые источники — eLibrary, КиберЛенинку, сайты институтов;
— третий собирает всё в единую таблицу: title, authors, year, url, relevance_score.
Дальше эта информация может разными способами векторизоваться\индексироваться и собираться в базу, с которой может работать другой агент.

Технический стек
Сама обвязка может состоять из разного, для конкретно нашей цели - нужен минимум RAG (Retrieval-Augmented Generation, генерация с поиском по базе) и, собственно, источники информации, которые должны базу заполнять, ну и технологический стек, основанный на российских технологиях, чтобы голова не болела.

С точки зрения индексации баз по науке существует несколько систем научного цитирования, colab.ws и РЦНИ. У того и у другого есть апи и вроде бы как оба доступны.
Ребятам из колаба можно написать в чат - быстро ответят и решат все вопросы, со вторыми сколько не пытался связаться, к сожалению, так и не получил ответа, при этом что отправлял несколько запросов с разных адресов.

Кроме научных баз - полезно собирать данные и статьи из интернета - для этого используется апи яндекса, оно доступное и достаточно бюджетное.
Ну и сама языковая модель - гигачат, на мой вкус - он отвечает лучше других с точки зрения русского языка и у них сразу есть модель для эмбедингов.

Результаты
В целом, система получилась более менее рабочей, но пока что сильно требовательно по ресурсам с точки зрения запросов - в тот же самый колаб может улетать до 100 запросов на поиск разной литературы. Также далеко не всегда можно скачать PDF, что усложняет создание базы для RAG и пока что требует частого вмешательства, ну и написание статей у меня пока не в приоритете, поэтому это больше остается экспериментом и интересным опытом.
Ну а что в приоритете - это вторая версия системы автоматического описания керна, про которую, наконец, скоро смогу рассказать много подробностей :)

@geologistprogrammer | VK | max


Сделал личного ИИ-ассистента

Есть много задач, которые требуют много времени но не особо мне интересны (заполнение документов, подача написанных статей в журналы и пр.), кроме того для обновления курса - надо проанализировать как предыдущие лекции, так и обновленные и составить конспекты\вопросы\тайм-коды.
Как это всё автоматизировать?

Думаю, многие слышали про автоконспектирование, но, как правило, всё запускается в облаке — ассистент может положить запись в открытую ссылку без пароля — далеко не всегда это может быть хорошей опцией.
Собственно, потому и пришла идея взять готовое и адаптировать под личные задачи.
Первоначально — делал MVP на ноутбуке — начал с whisper.cpp. Проблема с ней в том, что она генеративная, зацикливается (делает вид, что расшифровка идёт, но генерирует одну и ту же фразу) + требовательна к памяти. Тем не менее, подход оказался рабочим, расшифровка получалась, но что с ней делать? для последующей обработки — нужна локальная LLM. Та же история с зацикливанием, если модель небольшая.

После ряда экспериментов — MVP себя оправдало, но как вы сами догадались — вычислений много, да и ноутбук надолго не оставишь включенным. Некоторое время думал над вариантами и купил мини-сервер (помещается буквально на ладони) с 128 ГБ объединённой памяти и Ryzen AiMax. Расчёт был на то, что под примерно такие характеристики и оптимизируют открытые модели. На данный момент расчет уже оправдал себя, поскольку недавно вышедшая квантизированная Qwen 3.8 (125 млрд, инференс по 6млрд) там вполне может жить и генерировать ответы со скоростью до 30 токенов/с (может падать до 15, если контекста много). Этого вполне хватает, чтобы поставить задачу и уйти заниматься своими делами, в целом, модель подходит, в т.ч. для генерации кода.

В итоговом решении — LLM от 32B параметров, GigaAM (сберовская модель, которая не страдает от зацикливаний) + pyannotate только для своего голоса, чтобы разметить фрагменты речи, тишину, и другие моменты.

Аппетит приходит во время еды, да и зачем такому железу простаивать — поэтому повесил туда локального бота. Можно скинуть свое голосовое с описанием задач\результатов и на выходе получить задачи для отправки в трекер. Связка с Telegram / почтой / Яндекс.Трекером / YouGile / Max — может быть настроена, можно, например, запрашивать план задач на сегодня.

Как может работать в теории
Отправляешь запись → на выходе расшифровка, задачи для каждого и мемо. Всё локально.

Но начиналось, на самом деле, всё с немного другой идеи, которая требует ещё больших ресурсов — об этом завтра ;)

@geologistprogrammer | VK | max


Сделано за лето:

Создан полностью локальный секретарь на основе GigaAM + Gemma 4 + RyzenAiMax.

Освоена новая репка (Repka Pi 5) - кое-какие подробности уже можно найти в моих постах в блоге репки.

Доведена до предрелизного состояния (переписано всё, весь функционал первой версии работает, осталось довнедрить новый) система автоматического описания керна второй версии.

Работаю над второй версией курса по программированию с нейропомощниками для геологов.

Подробнее всё опишу в следующих постах, остаемся на связи🤝

@geologistprogrammer | VK | max


Видео недоступно для предпросмотра
Смотреть в Telegram
Что происходит в 4 утра?

Появляется темная тема в нашей системе автоматического описания керна.
Буду завтра показывать вторую версию в рамках МингеоФорума, можно посмотреть в онлайн на геовебинарах в сессии Кибергеология.
https://geowebinar.com/mingeo-2026

@geologistprogrammer | VK | max


Видео про большие языковые модели для геологов.

Продолжаю кататься по конференциям, решил попробовать такой формат по части образовательных видео, чтобы оставаться с вами на связи - коллеги из Soilbox помогли в реализации - записали видео выступления на ГеоИнфо.
Смотреть тут на вк видео https://vkvideo.ru/video-221089833_456239022
Пишите по формату в комментариях в ВК или тут.

@geologistprogrammer | VK | max


А перед сессией можно заглянуть к коллегам из ТехноИнфо в соседней Аналитике. Они собрали обещанную установку для сканирования керна.
Уже готовим нашу систему к их данным.

@geologistprogrammer


Месяц конференций, не успеваю всем делиться, но скоро исправлюсь, спасибо, что остаетесь на связи 🤝.

На прошлой неделе был на конференции по инженерной геологии, рассказывал про применение больших языковых моделей (скоро будет видео), а сегодня - по рудной геологии в рамках Miningworld и Мингеоофрума на сессии 'Кибергеология', начало в районе 15-16, приходите, будет интересно.
UP, зал G сразу справа после экскалаторов, не входя на выставку.

@geologistprogrammer


С днём геолога! Интересных проектов, творческих идей и вдохновения для новых открытий!


Сегодня на геоевразии, из интересного - познакомился с компанией из Индии, которое оборудование для шлифов делает.

Буду сегодня в 14 часов в 4 зале делать доклад про применение машинного обучения без обучения (детектируем слои без необходимости предварительно обучать алгоритмы).

Если вы тоже тут -буду рад пообщаться.

@geologistprogrammer | VK | max


Я учился в кибердеревне.

Недавно пришел к такой мысли, ведь где еще можно собрать свою робособаку, как не в Сколтехе?

Как многие знают, я не ищу легких путей, ведь это слишком скучно. Именно поэтому в какой-то момент я принял решение продолжить обучение в другом вузе, это позволяет сильно расширить ваш кругозор и узнать много нового, посмотреть на старые проблемы с нового ракурса.

Так и случилось. В Сколтехе не только обучение на английском, но и совершенно другой взгляд на многие вещи, направленный на практическую реализацию, так и получился проект по автоматическому распознаванию керна.

Сложно описать, сколько всего узнаешь о мире и людях в процессе бесконечного улучшения. Ну и, конечно, без кооперации не обходится, скоро будем внедрять много нового ;)

Узнавайте новое, это всегда полезно, тут вот можно с программами ознакомиться https://student.skoltech.ru/ru, там теперь магистратура, аспирантура и бакалавриат, кстати, на тот же Petroleum Engineering поступают далеко не только нефтяники, но и инженер-геологи и другие специальности.

Пишите, где еще можно собрать свою робособаку или кардинально изменить взгляд на мир👇

@geologistprogrammer | VK | max


Репост из: Ассоциация геологов, геофизиков и инженеров
🤖 Хакатон по машинному обучению — ваш шанс проявить себя перед крупной нефтегазовой конференцией!

В преддверии конференции Интеллектуальный анализ данных в нефтегазовой отрасли приглашаем всех желающих принять участие в захватывающем Хакатоне по машинному обучению!

Что вас ждёт:

❇️ 4 разноплановые задачи — от классического анализа табличных данных до передовых методов научного машинного обучения (Scientific ML).
❇️ Свобода выбора направления под ваши интересы и компетенции: компьютерное зрение, физико‑информированные нейросети, алгоритмы сжатия данных, работа с геохимическими данными.

💡 Почему стоит участвовать?

- прокачать навыки на реальных задачах нефтегазовой отрасли.
- поработать в команде с единомышленниками.
- получить опыт решения прикладных задач с использованием ML.

Участвуйте, ищите интересные необычные решения задач, и выигрывайте ценные призы за свои творческие способности, эрудированность и гениальность🤓😉

Принять участие 👈

ps.: Присоединяйтесь к нам в наших других соцсетях:
Группа Вконтакте: https://vk.com/geomodel_conferences
Канал в Max https://max.ru/id9725125483_biz


И ещё один 👇 хакатон :)


Сразу несколько хакатонов и все по ДЗЗ, успевайте зарегистрироваться (у всех окончание регистрации 31 марта):

Экспедиция DS. призовой фонд — 15 000 000 ₽.
Регистрация https://expds-platform.upgreat.one
Подробнее тут https://upgreat.one/contests/expds

Разработка геосервисов систем управления природопользованием
https://sgugit.ru/events/otkrytyy-khakaton-po-razrabotke-geoservisov-sistem-upravleniya-prirodopolzovaniem-/

ГИС-ИТ (до 30 лет)
https://gisit.ru/#registration

@geologistprogrammer | VK | max


#анонс #гео_дата_завтрак
Предлагаю собраться в преддверии дня геолога.
Дата и время: 4 апреля, 12:00 (через 2 недели)
❗️Важно: если собираетесь прийти - пишите мне в личку или на почту hi@beeugene.ru, свою почту, возможно, потребуется предоплата для бронирования.
Адрес: Москва, скорее всего, Цветной бул., 15, стр. 1, Found Record Store & Pizzeria
https://yandex.ru/maps/-/CHFPITYS

Приглашаю вас посидеть в приятной компании, пообщаться на интересующие темы.
Попьем кофе/чай и приятно и с пользой проведем время.

До встречи!
P.S. Присоединяйся к группе, если ещё не https://t.me/GeoMLearning.


Написание кода с помощью агентов - начал собирать плейлист. Включил туда взгяд различных компаний, собранных Яндексом и обзор локальных моделей для написания кода от коллег из OpenIDE, сам плейлист доступен тут - https://vkvideo.ru/video/playlist/4952294_2

Также на тему - статья о том как настраивают агентов для написания кода для разработки под Андроид (спасибо каналу MobileDeveloper за ссылку).

@geologistprogrammer | VK | max

Показано 20 последних публикаций.