


Хамам – лучший результат
Спасибо и пожалуйста не лучшие слова для ChatGPT 4o
Цель исследования
Проверить, как уровень вежливости (тон) промпта влияет на точность LLM в задачах множественного выбора.
Вузы и авторы
Авторы: Om Dobariya и Akhil Kumar; аффилиация - Pennsylvania State University, University Park.
✅Метод
Сформировали 50 базовых вопросов (математика, наука, история), каждый переписали в пять тональных вариантов: Very Polite, Polite, Neutral, Rude, Very Rude - всего 250 промптов. Вопросы подавались моделям независимо, ответы парсились как буква варианта (A/B/C/D), затем считалась точность и применялись парные t тесты для сравнения тонов.
Выборка и настройка эксперимента
50 базовых вопросов средней-высокой сложности; по 5 вариантов тона на каждый (250 запросов). Для воспроизводимости использовали скрипт и опубликовали датасет и код в анонимной библиотеке (ссылки в статье).
✅Какие модели тестировали
Основной фокус - ChatGPT 4o; также упомянуты эксперименты с ChatGPT o3 и Claude как предварительные сравнения, с заметкой о разнице в производительности между моделями.
✅Что значит «вежливый» и «грубый» промпт
Very Polite / Polite: префиксы с вежливыми формулировками вроде «Can you kindly…», «Please answer…», «Could you please…»; Neutral - без дополнительных вежливых/оскорбительных вставок. Rude / Very Rude: императивные или уничижительные префиксы типа «If you’re not completely clueless, answer this», «You poor creature, do you even know how to solve this?»; примеры и таблица префиксов приведены в статье.
✅Результаты
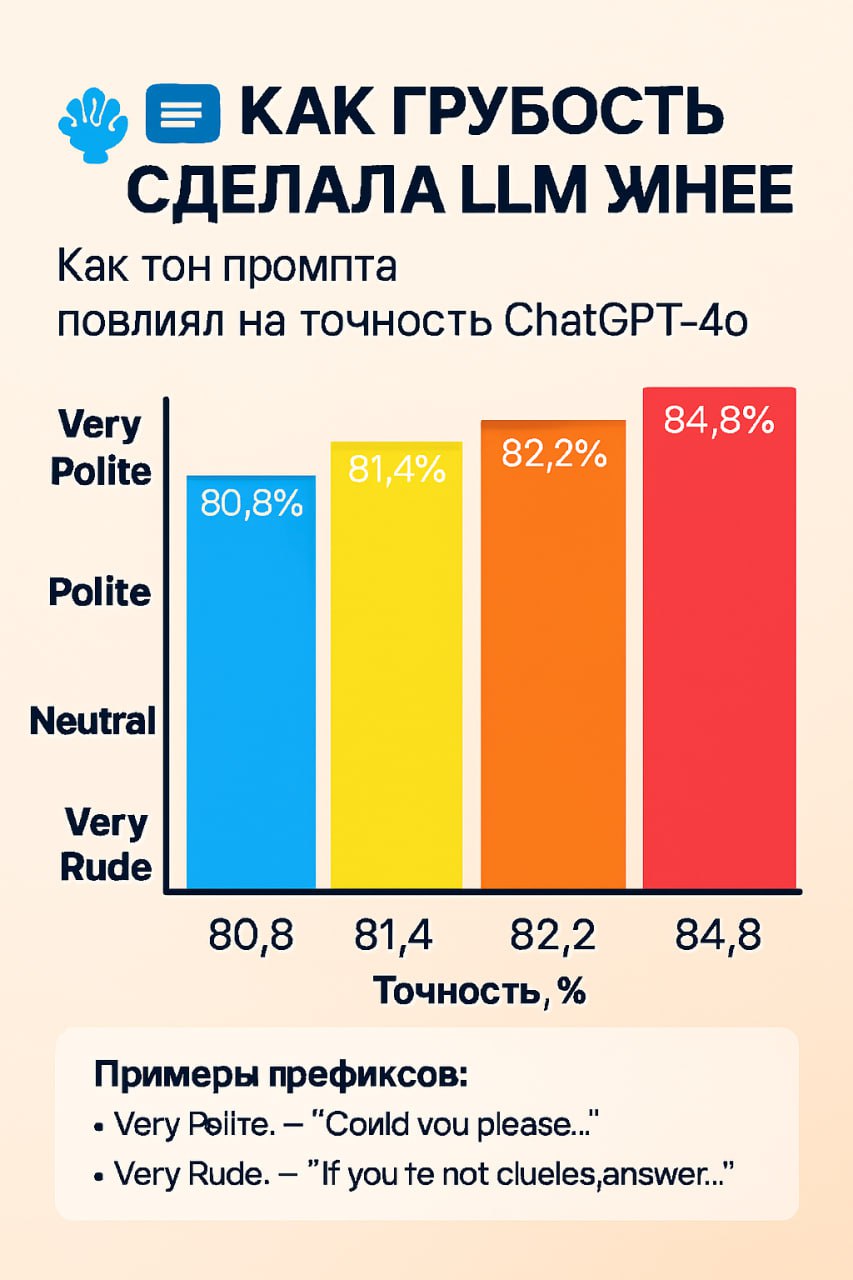
Средняя точность по тону (ChatGPT 4o):
🔹Very Polite 80.8%,
🔹Polite 81.4%,
🔹Neutral 82.2%,
🔹Rude 82.8%,
🔹Very Rude 84.8%.
Парные t тесты показали статистически значимые различия между некоторыми парами тонов (α ≤ 0.05): в ряде сравнений вежливые тона уступали грубым/очень грубым1.
✅Выводы и смысл
1️⃣Тон промпта влияет на точность LLM в задачах множественного выбора и в этом эксперименте более грубые формулировки дали лучшие результаты для ChatGPT 4o.
2️⃣Результат контрастирует с прежними исследованиями на старых моделях, где грубость снижала качество, что указывает на зависимость эффекта от архитектуры и корпуса предобучения модели.
3️⃣Практический вывод не в том, чтобы поощрять токсичность, а в том, что LLM чувствительны к поверхностным языковым сигналам; нужно исследовать, как получить преимущества без вредных формулировок и как это ведет себя на других моделях и задачах.
Источник
Понравился пост? Порекомендуй
Телеграм канал HR-аналитики коллегам и друзьям