


Jev - это сенсор, а не собеседник
Вы уже могли слышать про TypeSafe AI (основатель - соавтор InstructGPT из OpenAI), они пару дней назад вышли из стелса и показали модель, которая не умеет писать текст зато отвечает в десятки раз быстрее и дешевле LLM. Ну как отвечает, скорее выбирает, но иногда это ровно то, что нужно.
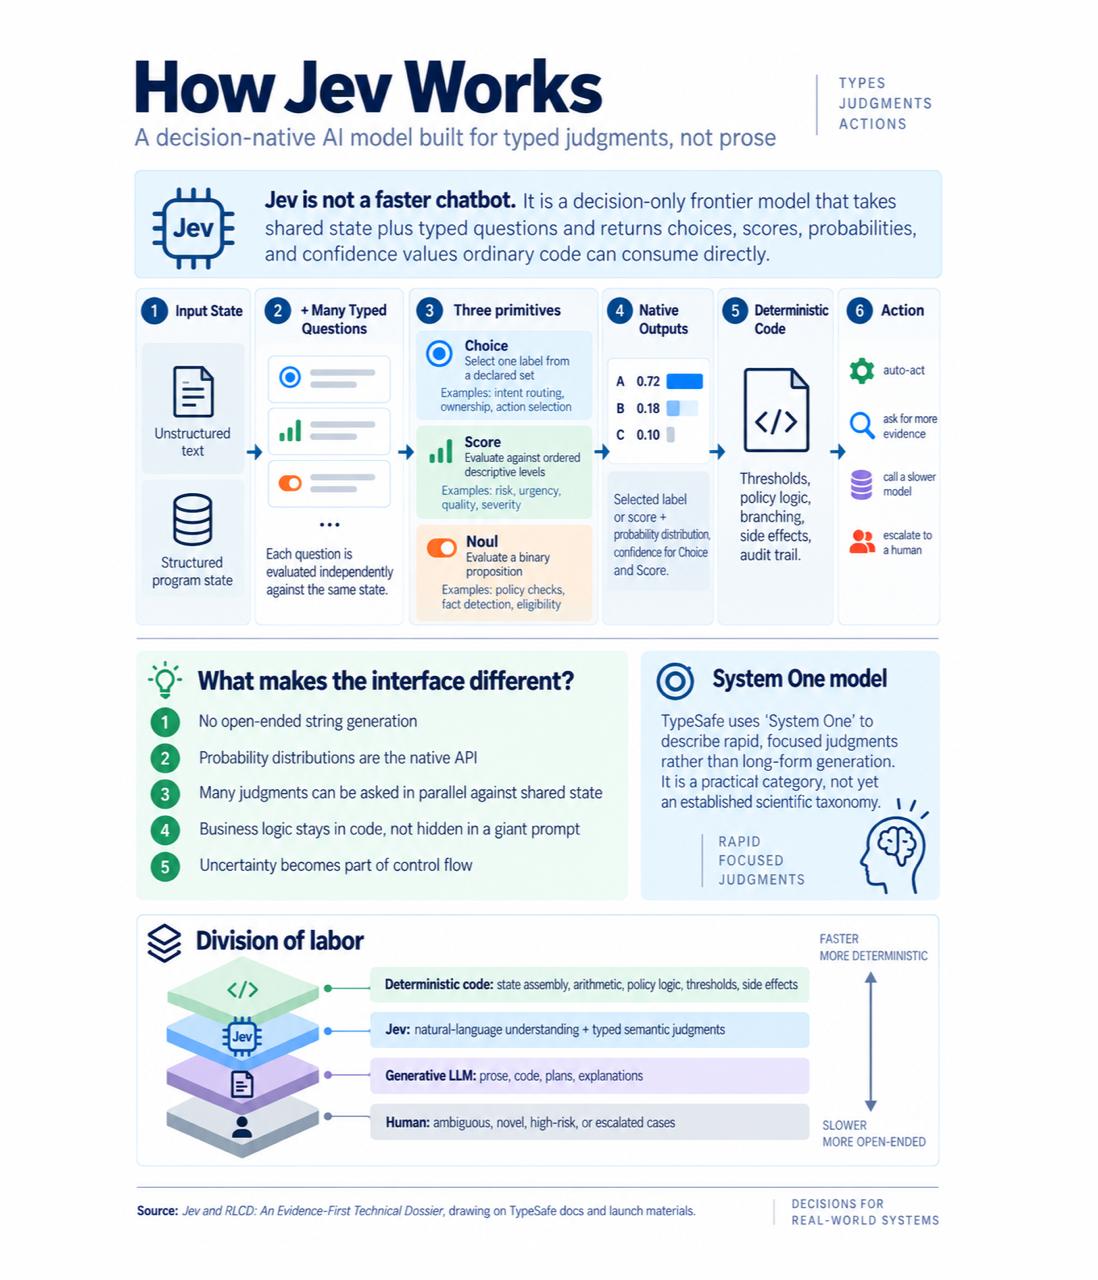
Работает так: скидываешь ей данные и задаешь вопросы с заранее известными вариантами. Она не пишет ответ, а сразу выбирает вариант и говорит, насколько уверена. Промпт при этом никуда не делся - он живет внутри вопроса.
В общем эту штуку можно сравнить с датчиком, по сути же - это умный классификатор.
Родион уже прогнал Jev на практике: как реранкер в RAG она обошла Voyage, Qwen3-Reranker и Cohere, а как модератор чат-бота вышла в 5 раз быстрее и дешевле gpt-oss-120b. Мне еще понравилась демка с оптимизацией browser use.
Что еще стоит посмотреть:
Мой тейк: штука полезная только при сильно лучшей экономике, и есть проблема всех узких решений (реранкеров, маленьких моделей, файнтюна): фронтир-лабы вливают миллиарды в универсальные модели, и те становятся лучше и быстрее даже в узких задачах просто по дороге. Бонусом LLM может "объяснить" свой выбор, а тут нет. И как любой классификатор, такие штуки по-настоящему раскрываются на своем железе: при нагрузке дорога до облака съедает всю экономию скорости.
Поэтому моя ставка не на TypeSafe, а на идею. Либо большие лабы добавят режим типа "выбор с вероятностью" в свои API, либо китайцы наклепают открытых версий и тогда "типизированные" решения станут таким же примитивом, как structured output. В обоих случаях выигрывает интерфейс/способ, а не компания.
🔥 ➕ 🔁 @nobilix
Вы уже могли слышать про TypeSafe AI (основатель - соавтор InstructGPT из OpenAI), они пару дней назад вышли из стелса и показали модель, которая не умеет писать текст зато отвечает в десятки раз быстрее и дешевле LLM. Ну как отвечает, скорее выбирает, но иногда это ровно то, что нужно.
Работает так: скидываешь ей данные и задаешь вопросы с заранее известными вариантами. Она не пишет ответ, а сразу выбирает вариант и говорит, насколько уверена. Промпт при этом никуда не делся - он живет внутри вопроса.
В общем эту штуку можно сравнить с датчиком, по сути же - это умный классификатор.
Родион уже прогнал Jev на практике: как реранкер в RAG она обошла Voyage, Qwen3-Reranker и Cohere, а как модератор чат-бота вышла в 5 раз быстрее и дешевле gpt-oss-120b. Мне еще понравилась демка с оптимизацией browser use.
Что еще стоит посмотреть:
- Опенсорс-реплики появились за трое суток: openjev (демо в браузере), jevmlx для Mac, vllm-jev-decison под vLLM, Verdict-open-jev - ближе всего к оригиналу: не логиты LLM, а энкодер ModernBERT.
- Тред на HN, 1800+ поинтов. Главный спор - про слово "can't hallucinate": тип гарантирован, суждение нет. CEO отвечает лично.
- Разбор Anthony Maio: самая трезвая критика. RLCD (метод обучения) не раскрыт, калибровка описывает популяцию ответов, а не конкретный ответ.
- Бенчмарк на 2000 фишинговых писем: в лоб Jev проиграл Haiku с треском, 63% против 81%. А потом автор разбил решение на пять маленьких вопросов в одном вызове и получил 95%. Самая поучительная история про то, как эту штуку надо готовить. Еще 15 независимых эвалов с кодом - в каталоге awesome-jev - 👍.
Мой тейк: штука полезная только при сильно лучшей экономике, и есть проблема всех узких решений (реранкеров, маленьких моделей, файнтюна): фронтир-лабы вливают миллиарды в универсальные модели, и те становятся лучше и быстрее даже в узких задачах просто по дороге. Бонусом LLM может "объяснить" свой выбор, а тут нет. И как любой классификатор, такие штуки по-настоящему раскрываются на своем железе: при нагрузке дорога до облака съедает всю экономию скорости.
Поэтому моя ставка не на TypeSafe, а на идею. Либо большие лабы добавят режим типа "выбор с вероятностью" в свои API, либо китайцы наклепают открытых версий и тогда "типизированные" решения станут таким же примитивом, как structured output. В обоих случаях выигрывает интерфейс/способ, а не компания.
🔥 ➕ 🔁 @nobilix