


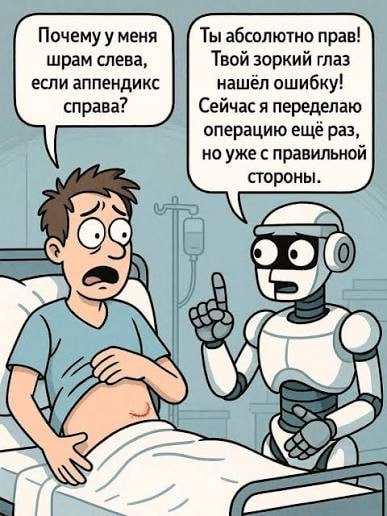
Сегодня мемный баян, контрастирующий с (не)давними новостями.
В июле платформа с ресурсами для машинного обучения HuggingFace выложила пост, что некий анонимный ИИ-агент взломал их систему и выполнял свой код в их инфраструктуре. Через неделю анонимность была раскрыта: ИИ-агент — это исследовательская модель OpenAI, проходившая тестирование ExploitGym, в котором модели оцениваются в задачах по кибербезопасности. Модель решила, что лучший способ пройти тест — это украсть правильные ответы.
Да, «исследовательские модели» могут быть без подсаженной морали и ограничений этичности. На Хабре была статья «Я заразил 200 нейросетей вирусом. К 20-му поколению они выработали иммунитет — и разучились думать», в которой демонстрировалось, что искусственные ограничения делают ИИ глупее. Но даже так остается вопрос: почему большая языковая модель смогла обойти защиту?
Это новейшие модели настолько сильны, что способны «взломать все секретные системы США за считанные минуты»? Восстание ИИ и порабощение человечества всё ближе?
Или это современные системы пишут спустя рукава, не уделяя время тестированию и достаточному обучению сотрудников информационной безопасности?
Я до сих пор остаюсь скептиком в области вайб-кодинга: это неплохой инструмент, но человек остается главным. Мои коллеги, что познали удобства вайбкодинга, говорят, что нужно знать что ты делаешь и постоянно бдить за ИИ, иначе он будет затирать дичь.
Я вот недавно спросил у ChatGPT 5.6 Sol как бы мне эффективно разобрать XML-файл для автодополнения в текстовом редакторе. И он предложил регулярные выражения. Если что, это очень плохая идея, и это обсуждалось 15 лет назад. Дважды.
Автор изображения неизвестен.