


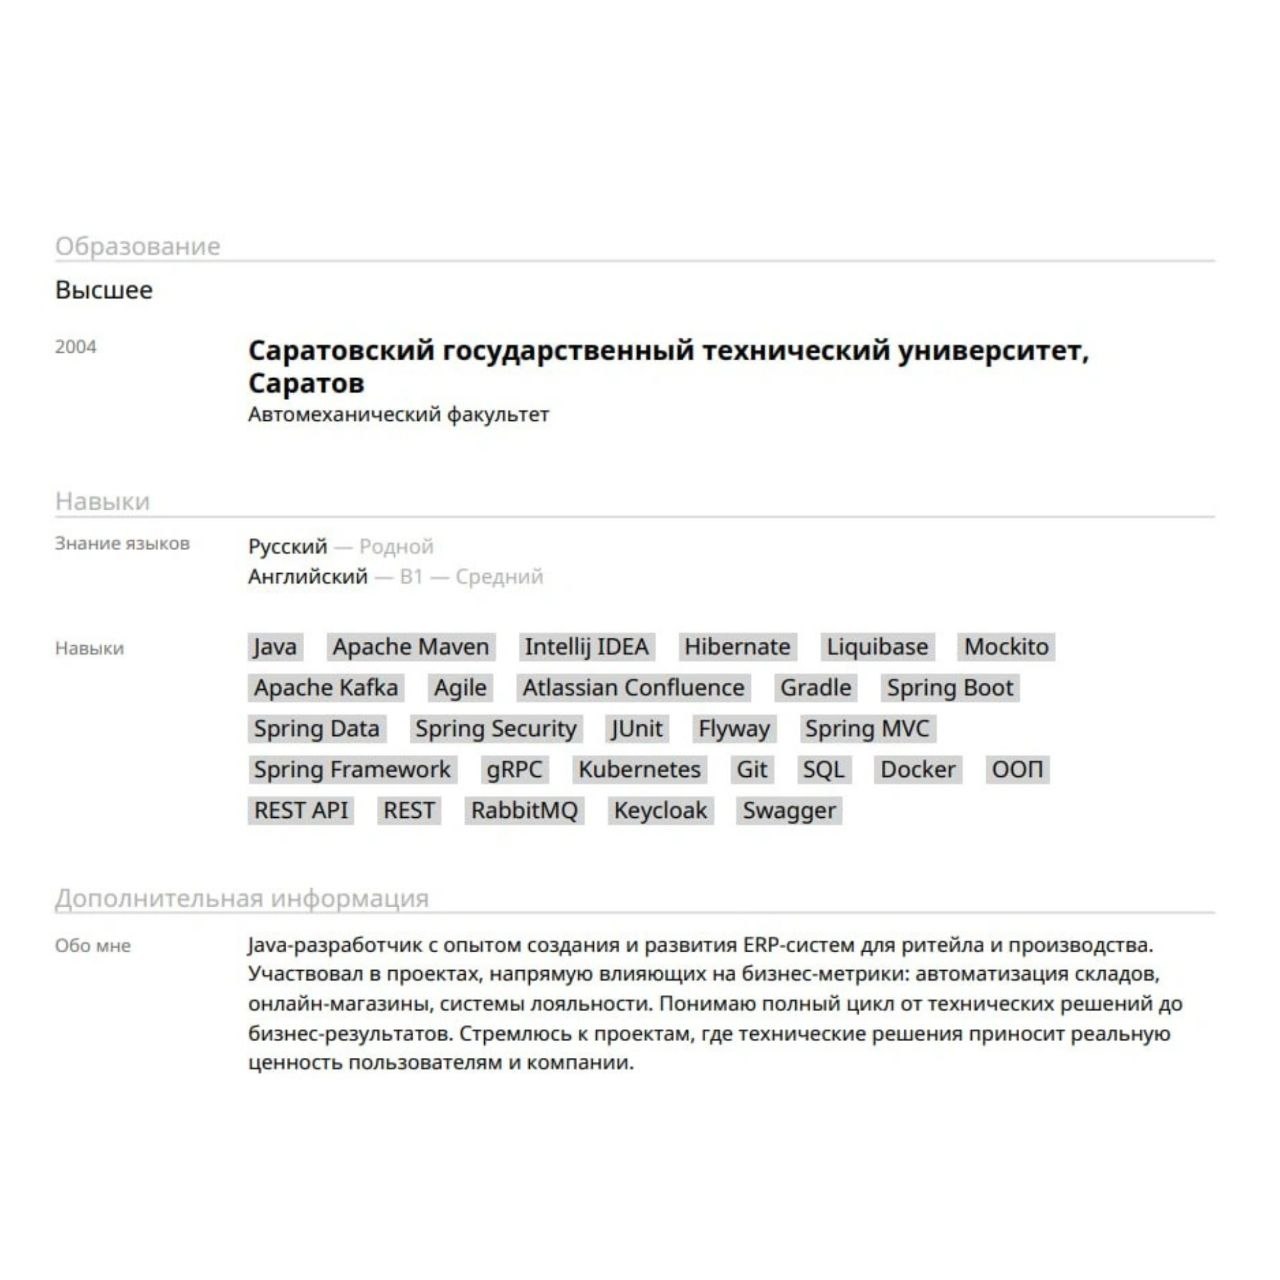
Недавно разбирал резюме Java-разработчика
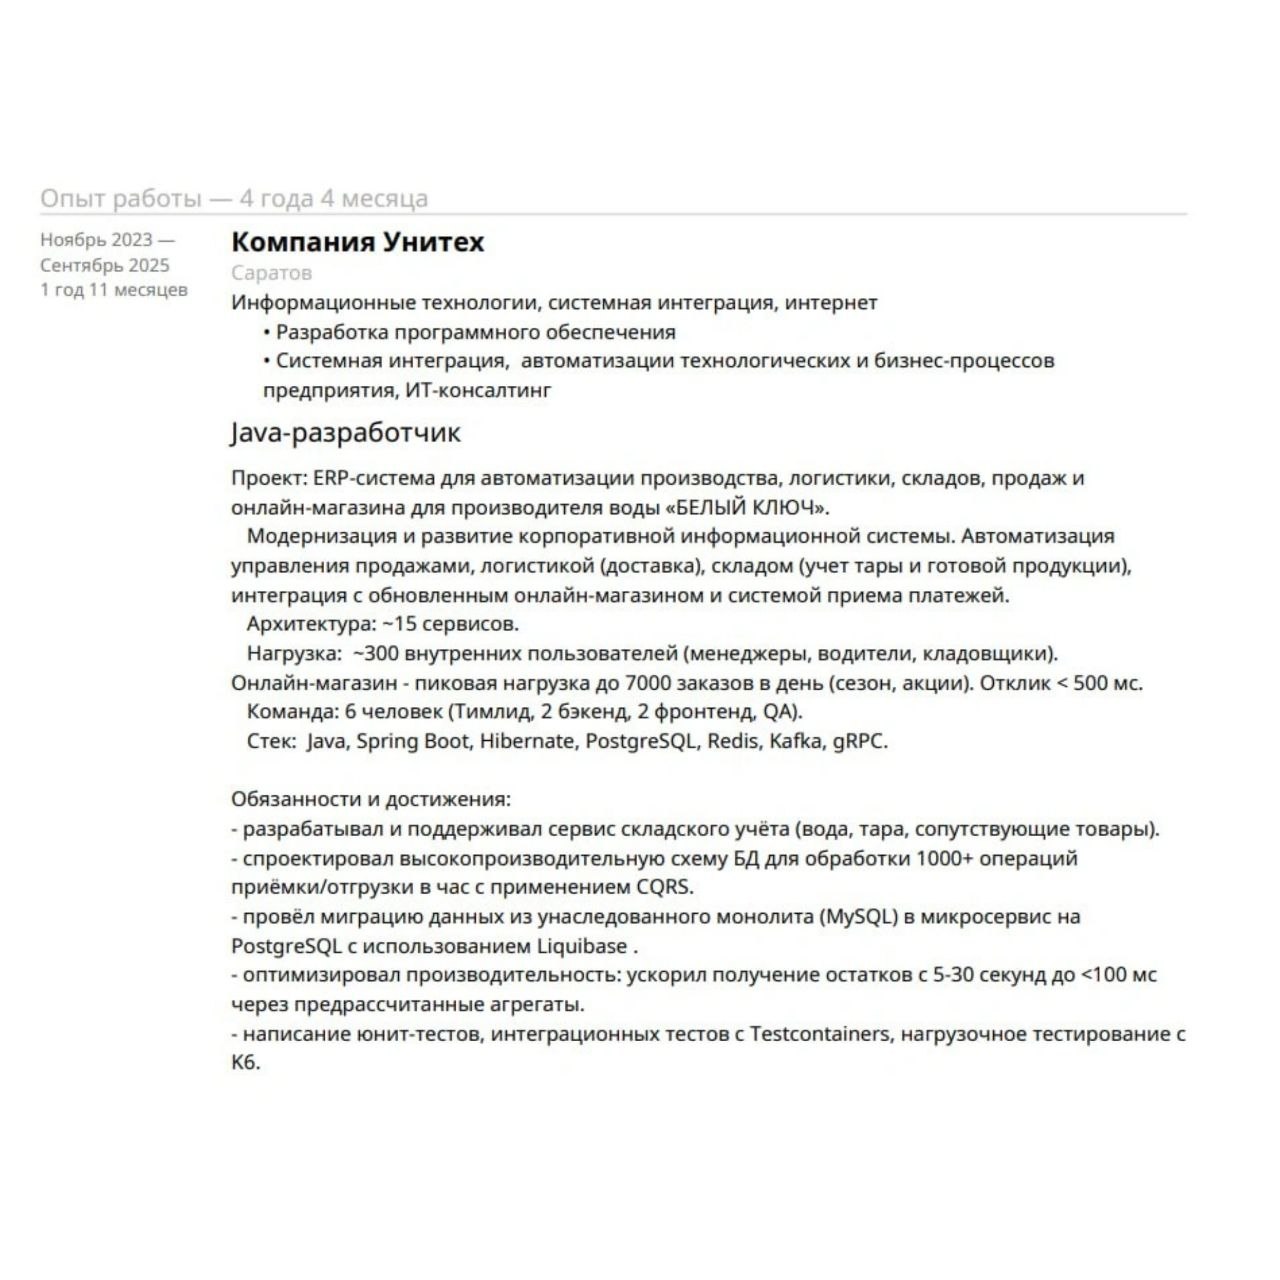
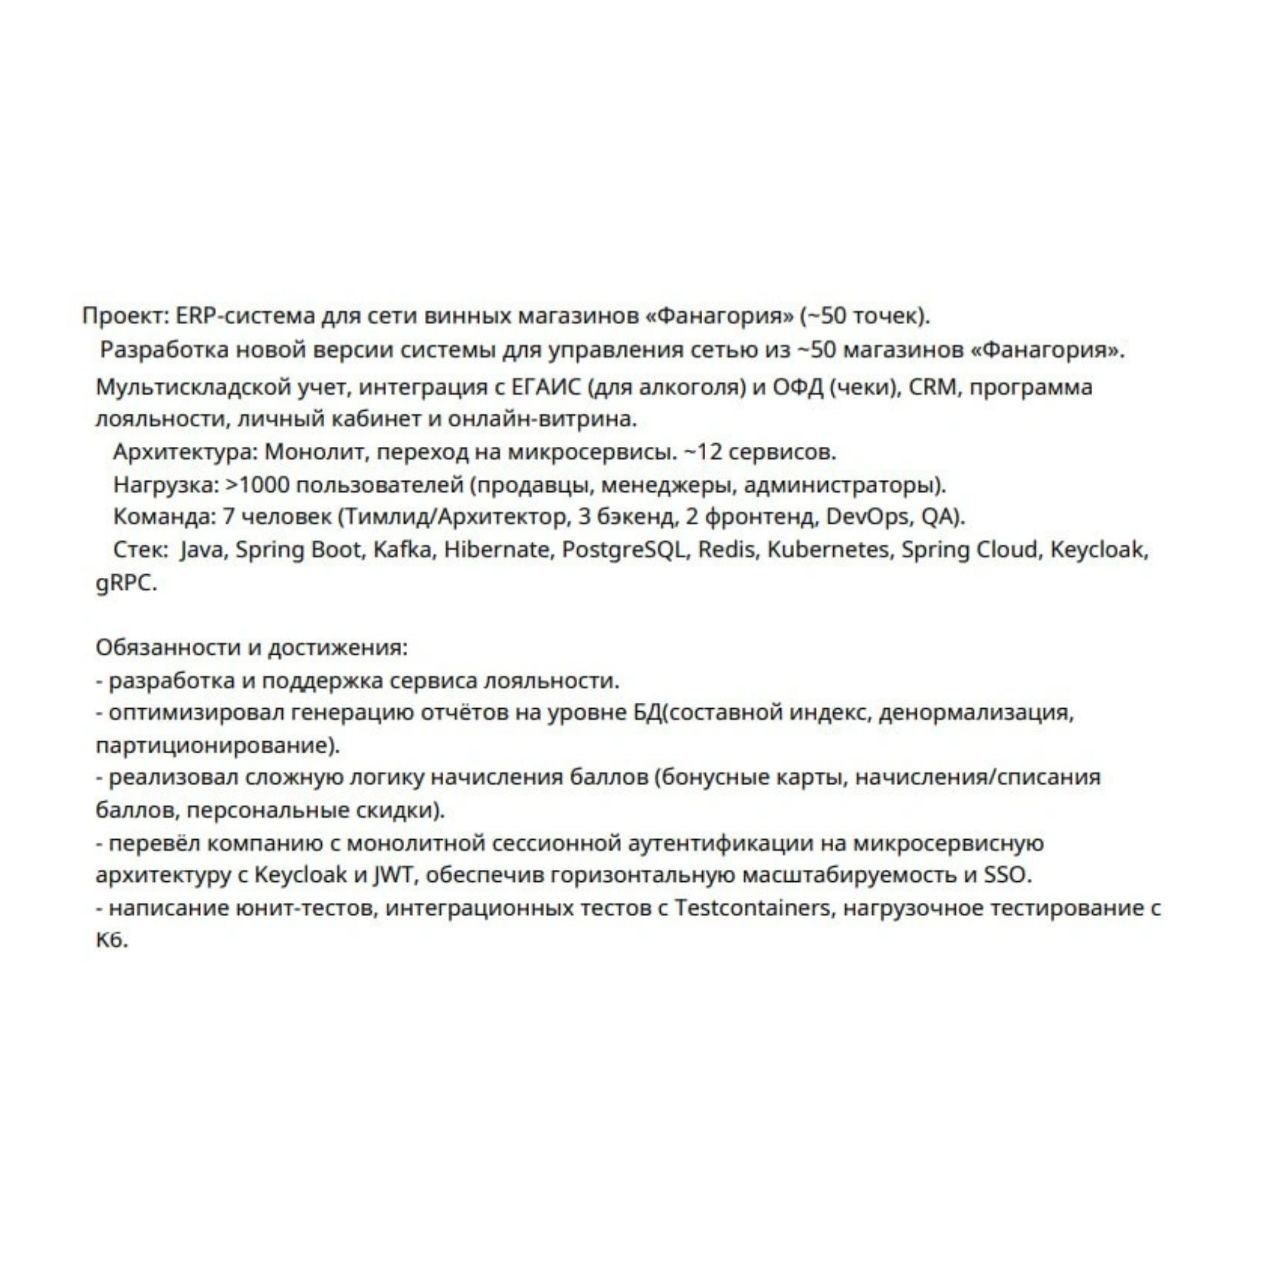
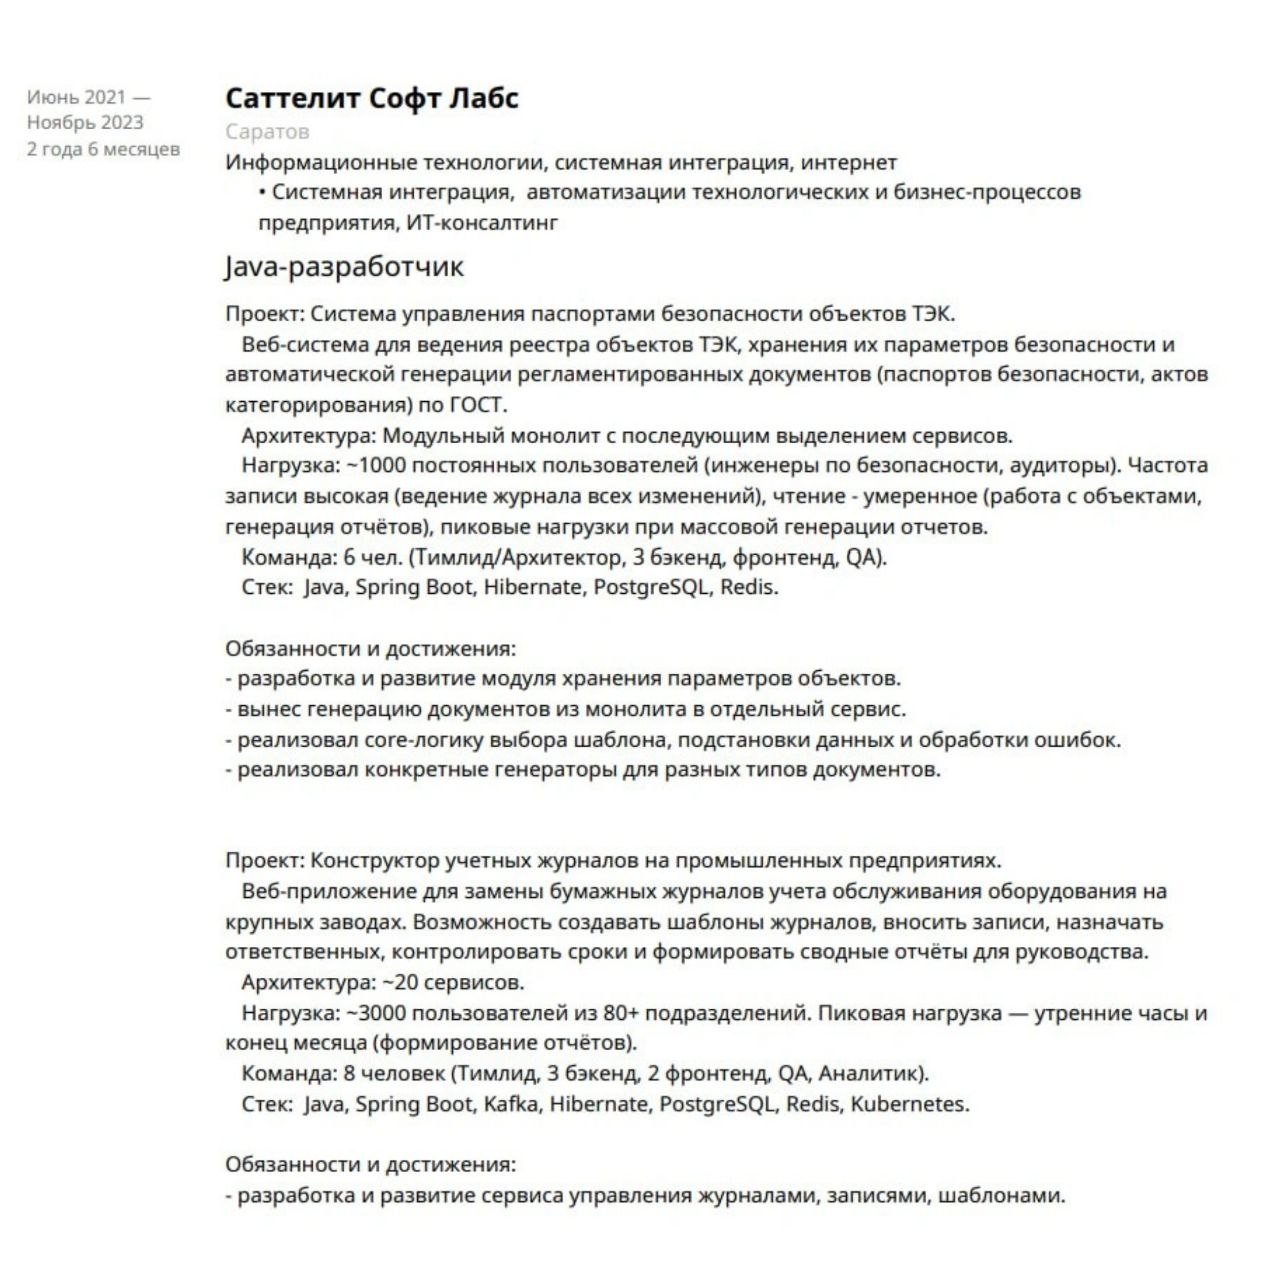
На бумаге всё очень бодро: 4 года опыта, ERP, микросервисы, Kafka, gRPC, Kubernetes, Keycloak - сильное резюме.
Но именно на таких резюме часто и палятся.
Проблема не в том, что человек обязательно врёт. Он правда мог быть на проекте, где всё это использовалось. Но резюме написано так, будто кандидат одновременно был бэкенд-разработчиком, DevOps, тимлидом, архитектором и DBA.
И вот тут начинается главная боль: много сильных слов, мало конкретики.
«Перевёл на Keycloak», «обеспечил масштабируемость», «оптимизировал производительность» - звучит хорошо. Но что конкретно ты делал?
Какие таблицы? Какие endpoints? Какие индексы? Какие события в Kafka? Что именно настраивал?
Со стеком то же самое. Иногда он выглядит как сборник ключевых слов из вакансий: всё самое умное, модное и дорогое. Kafka, gRPC, Redis, Kubernetes, Keycloak.
Всё это может быть в реальном проекте. Но если написал Kafka - объясняй про топики, партиции, retry, DLQ. Написал Keycloak - объясняй роли, refresh tokens, интеграцию. Написал Kubernetes - рассказывай, что именно деплоил и как был устроен CI/CD.
«7 тысяч заказов в день», «отклик меньше 500 мс», «ускорил с 30 секунд до 100 мс».
Цифры - это хорошо. Но их тоже надо уметь защищать: где мерили, как мерили, что тормозило, что показал explain analyze.
«Перевёл компанию на Keycloak» звучит как задача лида или архитектора. Если ты участвовал в этом процессе, лучше так и писать: подключал сервисы, настраивал роли, работал с JWT, помогал с интеграцией. Это выглядит честнее и сильнее.
Потому что главный вопрос не в том, можно ли усиливать резюме - можно. Показывать цифры, писать про бизнес-результат, упаковывать опыт сильнее.
Но каждую строчку надо уметь защитить.
Кстати, это резюме мы в итоге переделали. Там хорошо видно, как можно переписать формулировки, чтобы они работали, а не подставляли. Если интересно - покажу.
На бумаге всё очень бодро: 4 года опыта, ERP, микросервисы, Kafka, gRPC, Kubernetes, Keycloak - сильное резюме.
Но именно на таких резюме часто и палятся.
Проблема не в том, что человек обязательно врёт. Он правда мог быть на проекте, где всё это использовалось. Но резюме написано так, будто кандидат одновременно был бэкенд-разработчиком, DevOps, тимлидом, архитектором и DBA.
И вот тут начинается главная боль: много сильных слов, мало конкретики.
«Перевёл на Keycloak», «обеспечил масштабируемость», «оптимизировал производительность» - звучит хорошо. Но что конкретно ты делал?
Какие таблицы? Какие endpoints? Какие индексы? Какие события в Kafka? Что именно настраивал?
Если человек не может разложить свою строчку в резюме на конкретные действия - это ред флаг.
Со стеком то же самое. Иногда он выглядит как сборник ключевых слов из вакансий: всё самое умное, модное и дорогое. Kafka, gRPC, Redis, Kubernetes, Keycloak.
Всё это может быть в реальном проекте. Но если написал Kafka - объясняй про топики, партиции, retry, DLQ. Написал Keycloak - объясняй роли, refresh tokens, интеграцию. Написал Kubernetes - рассказывай, что именно деплоил и как был устроен CI/CD.
Ещё один маркер - красивые цифры без контекста.
«7 тысяч заказов в день», «отклик меньше 500 мс», «ускорил с 30 секунд до 100 мс».
Цифры - это хорошо. Но их тоже надо уметь защищать: где мерили, как мерили, что тормозило, что показал explain analyze.
Третий момент - слишком большая роль для уровня.
«Перевёл компанию на Keycloak» звучит как задача лида или архитектора. Если ты участвовал в этом процессе, лучше так и писать: подключал сервисы, настраивал роли, работал с JWT, помогал с интеграцией. Это выглядит честнее и сильнее.
Потому что главный вопрос не в том, можно ли усиливать резюме - можно. Показывать цифры, писать про бизнес-результат, упаковывать опыт сильнее.
Но каждую строчку надо уметь защитить.
Кстати, это резюме мы в итоге переделали. Там хорошо видно, как можно переписать формулировки, чтобы они работали, а не подставляли. Если интересно - покажу.