


Как быстро добавить свой бренд в LLM - эксклюзив для моих подписчиков! 🔥
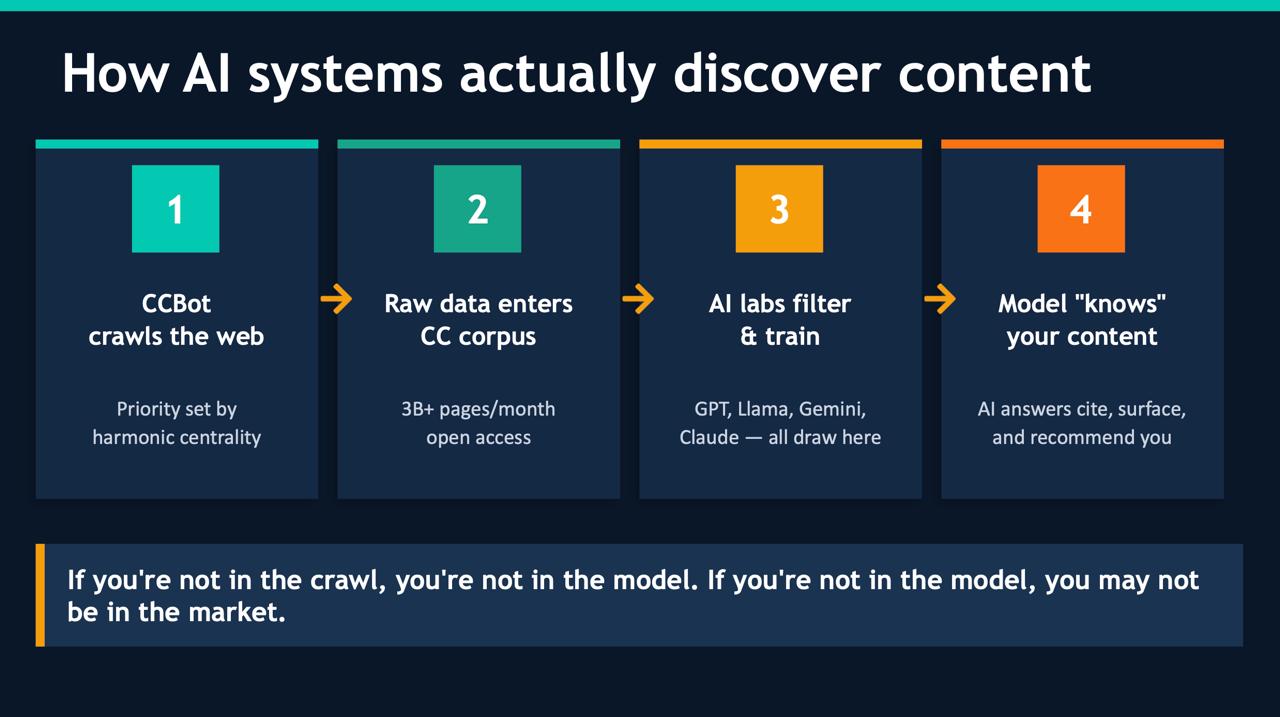
На конференции в Сайгоне я попал на закрытый ивент от компании Common Crawl, название которой для многих из вас совершенно ничего не говорит. Так вот: Common Crawl ежедневно обходит интернет и краулит сайты по собственному алгоритму - такой Google на минималках. Однако в отличие от Google - они не закрывают свои данные.
Common Crawl выкладывают все свои данные в открытый доступ: список сайтов, хостов и URL, которые они обошли, ПОЛНЫЕ ссылочные графы = как связаны домены в интернете. Ну и полученный контент.
Этот огромный архив веб-данных (более 250 миллиардов страниц) используется почти всеми ведущими ИИ-компаниями для обучения больших языковых моделей (LLM)
Основные компании и проекты, использующие данные Common Crawl:
👉 OpenAI: Использовала данные Common Crawl для обучения GPT-3.
👉 Google: Использует данные, в том числе для своих поисковых ИИ-инструментов.
👉 Anthropic: Разработчик Claude.
👉 Meta (Facebook): В моделях LLaMA. (Запрещен в РФ!)
👉 Cohere, Adept, Midjourney: Активно используют эти архивы.
👉 Stability AI: В моделях для генерации изображений.
Каждый новый релиз индекса Common Crawl сразу же скачивается ведущими ИИ-компаниями. Смекнули что нужно сделать? Правильно - попасть в индекс Common Crawl!
Давайте разберемся как это сделать:
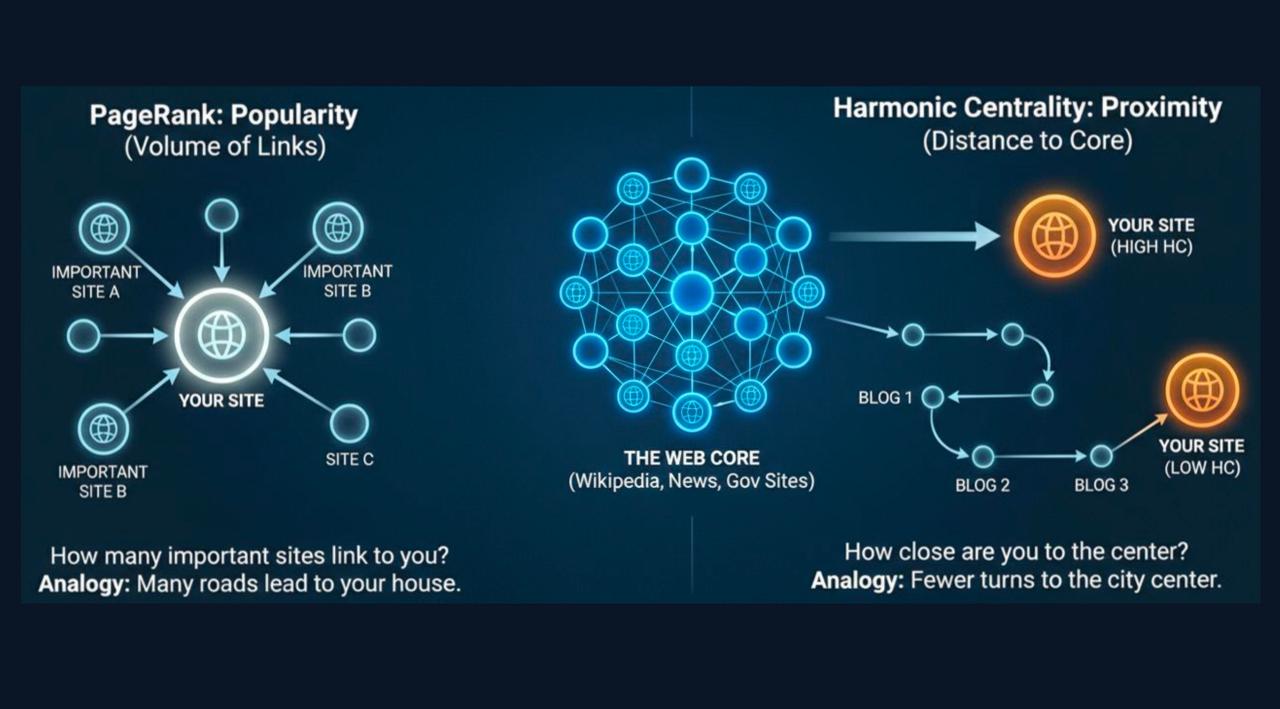
👉 Краулер (поисковый робот) Common Crawl устроен не так как роботы Google. Чтобы выбрать сайты, которые будут в первую очередь добавлены в индекс он использует вместо алгоритма Page Rank - алгоритм Гармонической Центральности (Harmonical Cetrality)
Уверен многие из вас слышат про него в первые. Вкратце он работает так: есть изначальные узлы графа (сайты) у которых есть высокий показатель гармонической центральности (выставлен вручную) и чем ближе тот или иной сайт к этим узлам (Seeds) - тем чаще робот будет их краулить. А соотвественно и ссылки на страницах таких сайтов будут быстро попадать в индекс
👉 Нам нужно вычислить узлы с самым высоким рейтингом Гармонической Центральности (HC) и любой ценой оставить на них ссылку на свой сайт
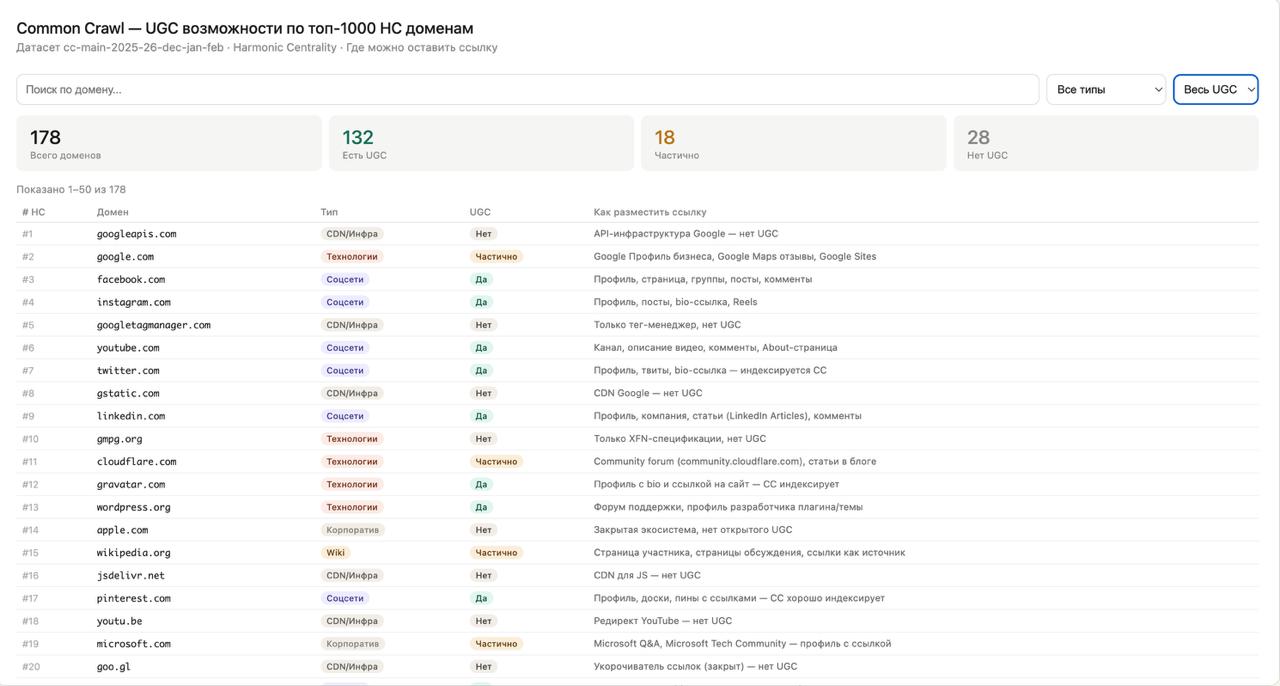
👉 Прелесть в том, что ничего вычислять не нужно - у Common Crawl есть замечательный репозиторий на GitHub с ТОП1000 доменами, отсортированным по показателю Гармонической Центральности
👉 А двойная прелесть в том, что я для вас их выкачал и сделал артефакт в Claude в котором можно посмотреть на каких сайтах и как можно оставить ссылку 😁 Дальше вы поняли
Теперь перейдет от технологии к процессу манипуляции
👉 Берем сайты из ТОПа и спамим там своими ссылками, желательно максимально близко к главной странице
👉 Среди таких сайтов есть очень легкие цели: Gravatar.com, Wordpress.com, WIX, Github, практически все известные соцсетки и бесплатные блоговые платформы
👉 Методом тестов с отслеживанием бота Common Crawl (CCbot) можно найти на какой площадке оставить ссылку на свой Sitemap / for-llm страницу и ловить бота Common Crawl
Я бы нацелился на соцсети, блоговые платформы и форумы с высоким показателем Harmonical Centrality и спамил бы там в постах и подписях.
Почему форумы? Новые посты там часто попадают на главную страницу.
Для особо увлеченных вайб-кодингом: пишем автоматизированного агента, который имеет на борту встроенный браузер, кучу фейковые почт и который спамит по этим сайтам и надеемся, что бот Common Crawl придет быстрее, чем размещенные вами ссылки будут удалены. Повторяем каждое утро или every time после еды.
Полезные ссылки:
👉 Презентация с ивента - о том как работает краулер и бот Common Crawl + все необходимое о Гармонической Центральности
👉 Репозиторий СС на GitHub со статистикой по ТОП1000 доменам и данными об индексе в виде графиков
👉 Скачать полный граф Common Crawl (50 гб в распакованном виде!) https://commoncrawl.org/web-graphs
👉🔥 Артефакт, который я сделал для вас (с РФ IP может быть недоступен - вы знаете что делать! 😉 )
Понравился пост?! Поделись с друзьями и коллегами! 🫶❤️