


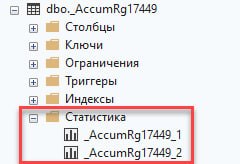
Можно ли словить блокировки при формировании отчета на MS SQL в 8.3 в режиме управляемых блокировках ? Как думаете?
Напомню, что в 8.3 в режиме управляемых блокировок режим изоляции транзакций - Read Committed Snapshot Isolation (RCSI), а значит при чтении в транзакции S-блокировки на чтение не накладываются, а используется версионность строк, оператор чтения видит подтвержденные данные на момент начала выполнения этого оператора.
При этом отчеты выполняющиеся вне транзакции (ни разу не видел, чтобы отчеты в транзакции формировали), в режиме NOLOCK, т.е. с грязным чтением. Они по определению сами игнорируют наложенные блокировки и никого не ждут – одновременно не накладывают собственных S-блокировок и никого не могут подвесить.
Так, вот представим, что у вас есть большой отчет который формируется достаточно долго и читает много данных из-за неоптимального запроса без использования индексов. Одновременно с этим, пользователи формируют другие отчеты, и ожидают их выполнения одну, две, три минуты. Хотя раньше отчеты формировались за секунды. В чем же может быть проблема? Для дальнейшего понимания, необходимо развернуть и пояснить такое понятие как "Статистика". Наверное, многие знают, что запросы в MS/PG формируются декларативно. Мы пишем инструкции, что нам нужно, а сервер СУБД сам строит план запроса, выбирает физические операторы для выполнения. Этим процессом напрямую мы управлять не можем, но можем исправлять запросы так, чтобы запросы использовали индексы и в итоге читали только то, что нужно.
Когда СУБД строит план запроса, ей нужно сделать какие-то решения. Например, каким образом проводить соединение таблиц. Есть три способа:
- Nested loops – вложенные циклы;
- Hash Match - соединение хэшированием;
- Merge Join - соединение слиянием;
У каждого из этих способов есть сильные и слабые стороны.
Одни операторы лучше подходят для обработки больших объемов данных, когда значительное количество строк участвует и с левой, и с правой стороны соединения. Но за это приходится платить повышенным потреблением ресурсов, особенно оперативной памяти.
Другие, наоборот, эффективны на небольших выборках: они работают быстро и экономно, но при росте объема данных могут резко терять производительность.
Поэтому выбор подходящего оператора соединения — нетривиальная задача. От этого выбора напрямую зависит, насколько эффективно будет выполняться запрос. Какую же проблему решает статистика? Чтобы планировщик смог выбрать правильный план, планировщику необходимо понимать сколько строк есть в таблицах. Именно для этой цели нужна статистика.
Статистика - это специальный объект в базе данных, который можно найти в дереве таблицы базы данных. Статистика хранит не сами данные таблицы, а сведения для оценки кардинальности: заголовок, гистограмму распределения значений. Гистограмма строится по первому ключевому столбцу статистики и состоит максимум из 200 шагов, и показывает, сколько строк попадает в каждый интервал.
Без статистики планировщик не смог бы понимать сколько строк есть в таблицах и не выбирал бы оптимальный план запроса.
Всё бы хорошо, но, как говорится, есть нюанс.
Продолжение в следующем посте.