


Шокирующий результат: сильнейшие ИИ-модели уже умеют сами проектировать эксперименты, а точность может вырасти с 11% до 87%. Похоже, ИИ действительно начинает самостоятельно исследовать неизвестное.
Уметь отвечать на вопросы ≠ уметь исследовать.
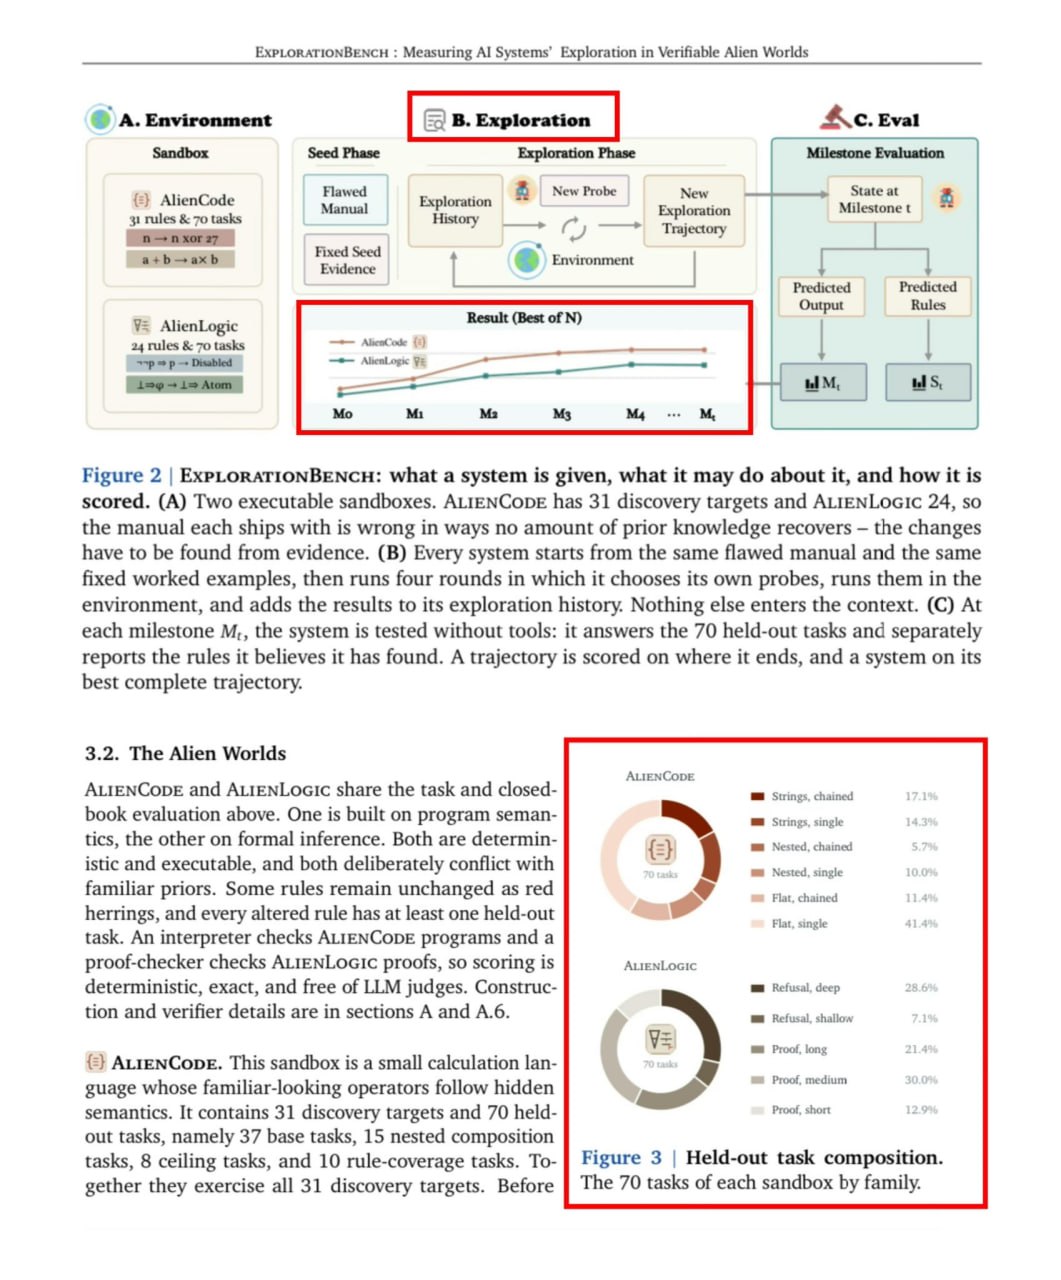
Исследователи из Фуданьского университета, Цинхуа и Tencent взяли 10 передовых моделей и поместили их в два искусственных мира с непривычными правилами, где ответы можно точно проверить. Модели должны были сами придумывать проверки, по обратной связи восстанавливать правила, а затем применять новые знания к 70 задачам, которых раньше не видели.
Две песочницы:
AlienCode — язык программирования с 31 скрытым семантическим правилом.
AlienLogic — система с 24 изменёнными правилами логического вывода.
При этом инструкции специально содержали неверные сведения, поэтому опора на запомненные знания только мешала.
Ключевые результаты.
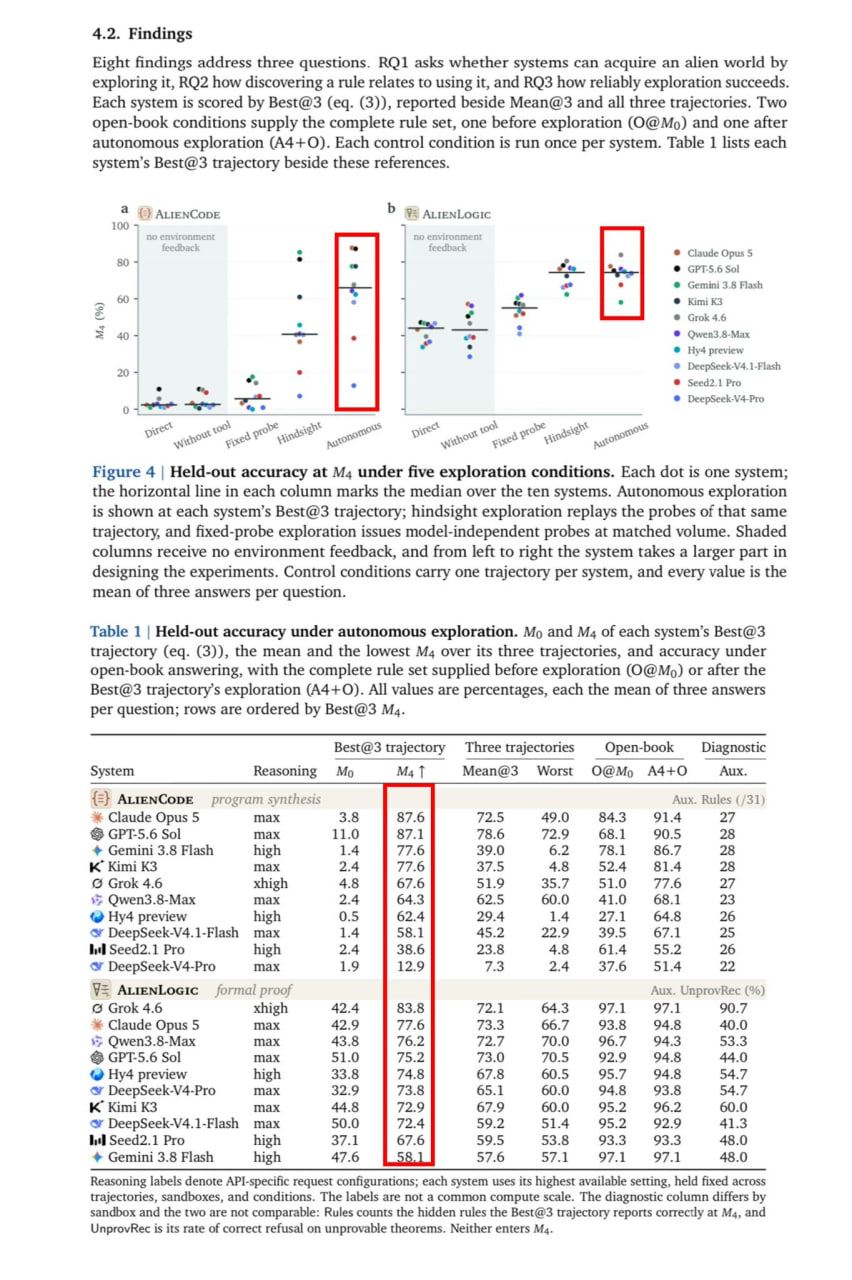
При четырёх раундах исследования с обратной связью лучший результат на AlienCode достиг 87,6%. При том же числе раундов, но без обратной связи, результаты всех моделей оставались в диапазоне 0,5–11%.
Самостоятельно выбранные проверки оказались заметно эффективнее фиксированных или случайных.
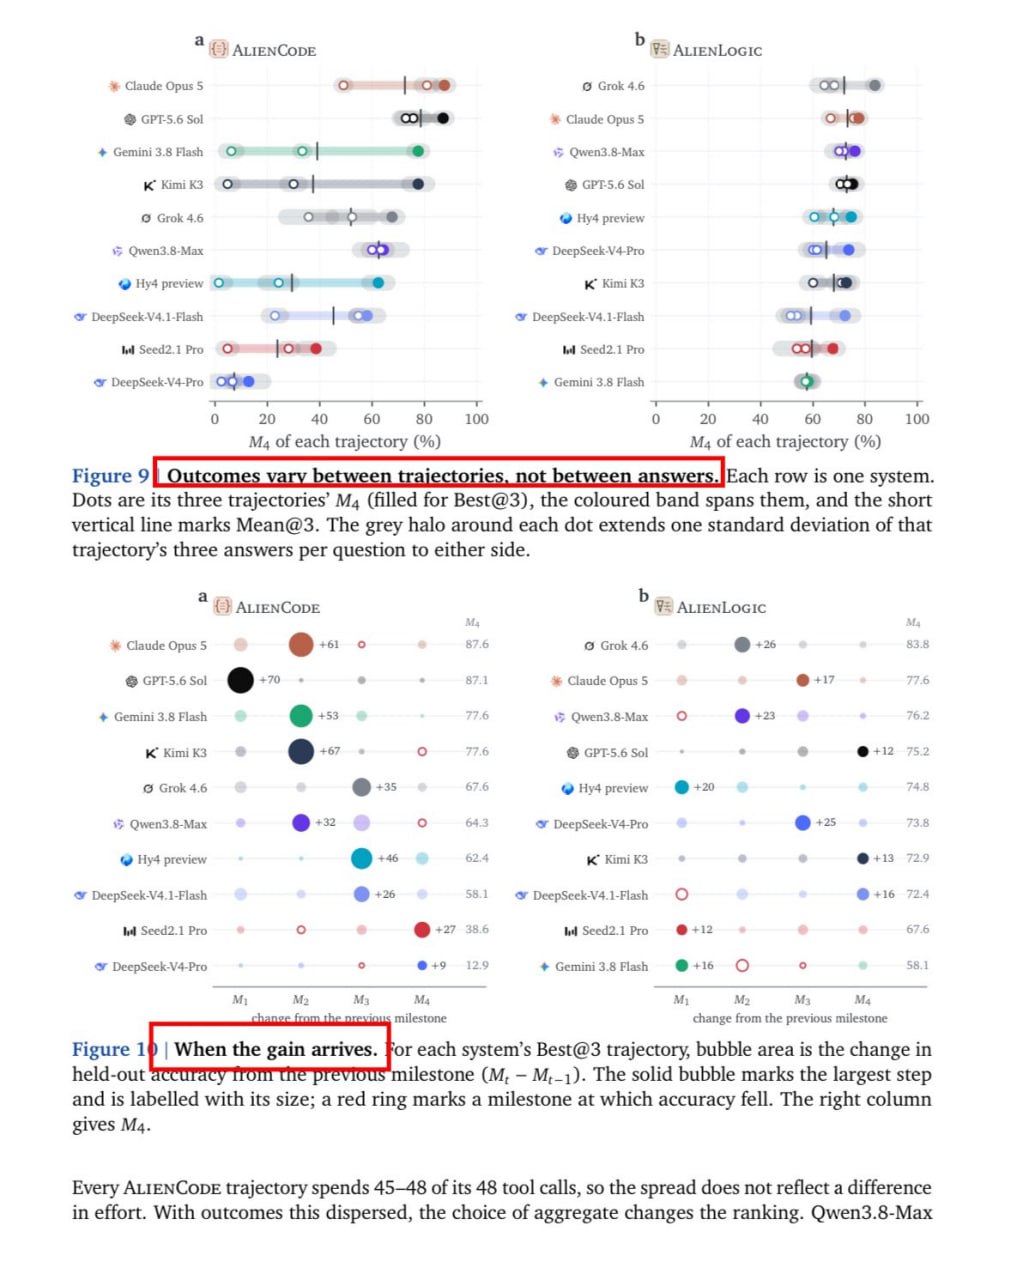
Но исследование оказалось крайне нестабильным. У одной и той же модели при одинаковом бюджете разница между отдельными траекториями достигала 72,8 процентного пункта, тогда как обычный разброс при ответах не превышал 4,7 пункта.
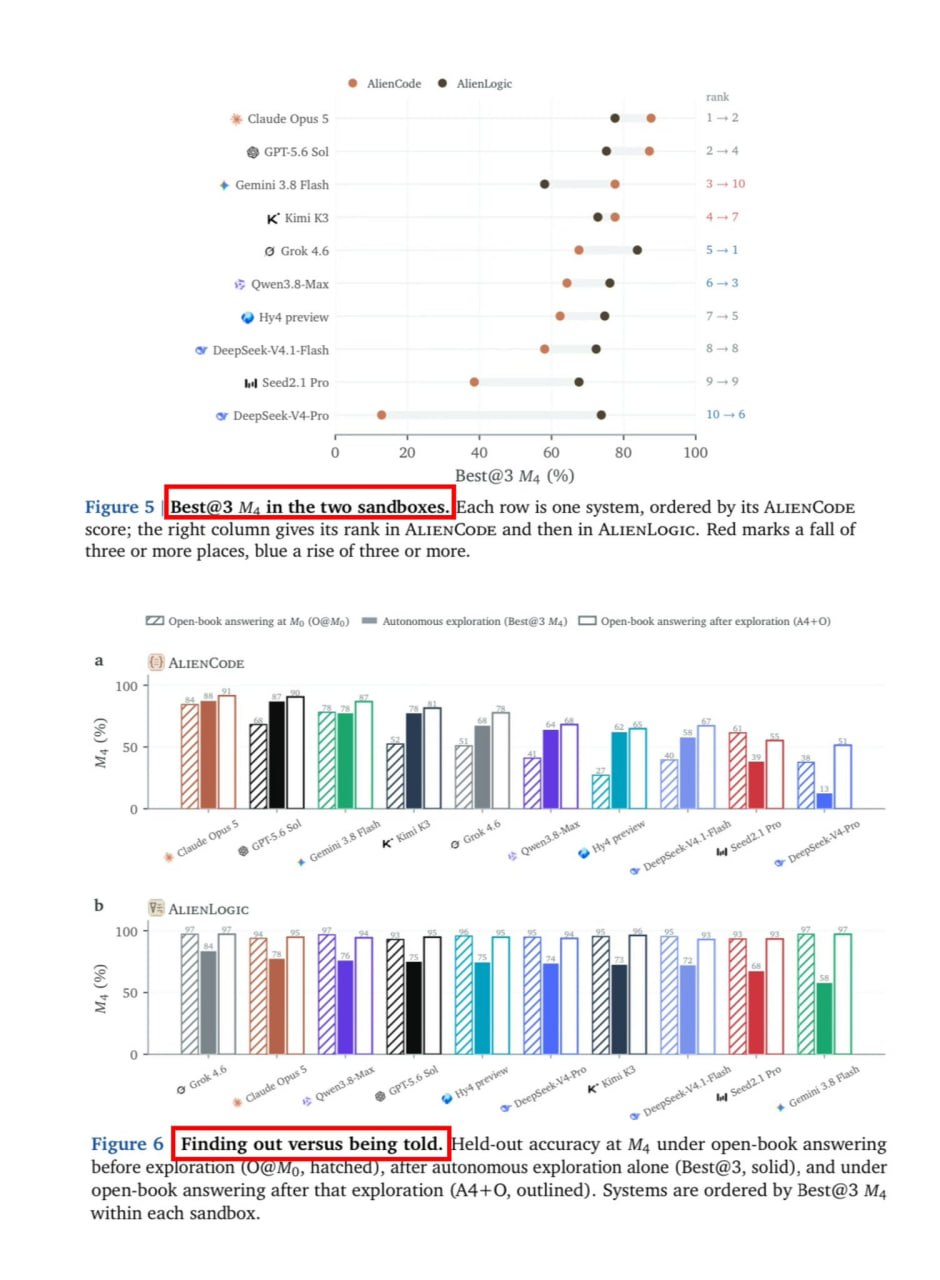
Ещё один важный вывод: знать правило ≠ уметь им пользоваться.
Два ключевых правила покрывали 51 из 70 задач. Когда один эксперимент позволял обнаружить оба сразу, точность подскакивала с 11% до 81%.
Но даже когда модель правильно называла все правила, итоговая точность составляла лишь 70,9%.
Если же правила давали модели напрямую, на AlienLogic точность достигала 93–97%, что выше результатов любого самостоятельного исследования.
То есть главное ограничение сейчас не в том, чтобы применить уже известное правило, а в том, чтобы самостоятельно его обнаружить и затем надёжно удержать.
Настоящее исследование — это не просто знать больше. Это понимать, какой эксперимент нужно провести, и уметь надёжно перенести его результат в следующую задачу.
Работа: https://arxiv.org/abs/2609.30199
✈️ Python Ninja