QA-Логия


Гео и язык канала: Россия, Русский
Категория: Технологии


Все о QA. Канал для тестировщиков
Личный блог автора - @just_genych
По вопросам рекламы или разработки: @g_abashkin

Связанные каналы  |  Похожие каналы

Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


У ИИ — знания, у тебя — контекст

До читателя текст теперь частенько добирается через двух ИИ сразу: первый — тот, с кем автор его пишет, второй — тот, кто режет инфу в выжимку для читателя. В КИПиА такое зовут измерительным каналом, и у схемы есть паршивая черта: погрешности звеньев складываются.

Знания по такому маршруту проходят норм. А вот контекст — нет. В статье копают, где именно контекст теряется, чем ошибка модели, одинаковая для всех её читателей, страшнее обычного непонимания, и как проверять канал с двух сторон — на живом кейсе с собственным комментарием, который ушёл в минус.

Читать далее

👉 QA-логия


Сканер 152-ФЗ выкатил нарушения Госуслугам, РЖД и Т‑Банку. Сейчас разберём, откуда ноги растут

Линтер ругнулся — потерял пять минут. Со сканером, который шерстит сайты на 152-ФЗ, так не прокатывает: на выходе получаешь «твой сайт вне закона». Сайт при этом чистый, зато отчёт уже уплыл к клиенту — и крайним окажется совсем не тот, кто его писал.

Мы такой сканер сами и пилим. Отчёт по нему уезжает не владельцу сайта, а веб‑студии — той, что тянет сотню клиентских проектов. А та уже отдаёт бумаги дальше, под своим логотипом. То есть за нашу придуманную находку краснеть будет она. Вот почему мы притормозили с новыми проверками и целый месяц занимались обратным: копали, где сканер врёт. Собрали три тулзы, которые выискивают косяки в нашем же коде, и прогнали через них полсотни самых неудобных сайтов Рунета. Трижды. Выловили восемь ловушек. Ни одной из них клиент так и не увидел — но увидел бы, выкатись мы просто так.

Разбор на Habr

👉 QA-логия


😅 Айтишник отправил в одну компанию три одинаковых резюме и только одно дошло до финала

Опыт везде был один и тот же, отличались только формулировки и ключевые слова. Первое резюме сразу ушло в помойку из-за алгоритмов, второе получило отказ после предварительной переписки и тестового, так как «опыт не совсем подходит», а вот третье дошло до финала.

✖️ xCode Journal


🤣 Правильно расставленные приоритеты в моей жизни би лайк:

💥 xCode Journal


16 обещаний, которые мы поклялись держать, и две модели, что рвались их сломать: как выкатывали skillmem 0.12

На 0.11 мы сорок заходов подряд гоняли ИИ-ревьюеров по коду и выловили кучу багов. Вот только у каждого из них была своя версия того, что вообще считается «правильно».

В 0.12 зашли с изнанки: сперва выписали шестнадцать инвариантов, которые гарантирует наша MCP-память, а потом две модели из разных лабораторий десять дней рыли контрпримеры. В зачёт шло только то, что можно воспроизвести.

В посте — что именно они поломали (Windows приняла NUL за терминал), во сколько это обошлось и что мы осознанно оставили в Known issues.

Читать далее

👉 QA-логия


Как за 90 дней довести свежего QA до самостоятельности: рабочий план онбординга

Скиллы у новичка-тестировщика могут быть что надо, но продукт, процессы и внутренние правила всё равно съедят прорву времени. А без внятного плана первые месяцы — это пинг-понг из вопросов и наставник, который уже на пределе.

Дальше — как собрать онбординг по схеме 30–60–90: что скидывать джуну в таски, какие материалы готовить заранее и по каким признакам понять, что человек готов пахать сам.

Разобрать план

👉 QA-логия


[Перевод] ИИ в тестировании: от анализа требований до автоматизации

Это перевод статьи о том, как в крупном брокере перепилили QA: ручные прогоны отправились на свалку, а на их место приехал рабочий процесс поумнее. Автор рассказывает, как тестирование обвязали вокруг LLM — там и настоящий стек, и случаи провороненных требований, и разбор того, где ИИ косячит.

И да — без человека там всё ещё никак.

Читать далее

👉 QA-логия


Как ИИ-агент проходит весь цикл мобильного тестирования в hh.ru

Александр Чернышев, который в hh.ru тестирует мобильные приложения, говорит, что за полгода его рабочие будни перевернулись с ног на голову — виной всему ИИ-тулзы, а в HeadHunter они давно в ходу. Лично у него в фаворе Claude Code с моделью Opus 5: по его опыту, с реальными тасками она справляется лучше прочих. Оговорка одна — подписка Max, так что лимиты его не душат. Агента он цепляет почти к каждой задаче.

Каркас всего процесса — скиллы: инструкции, которые жёстко прописывают агенту порядок шагов и не дают ему фантазировать на каждом заходе. Рядом с ними идут MCP-серверы и плагины — через них агент дотягивается до внешних инструментов, например до Figma (figma-mcp).

В статье автор раскладывает по полочкам полный цикл жизни задачи — от чеклиста и сверки с ТЗ до ретеста и автотестов — и показывает, где на каждом из этапов подключается ИИ-агент. Плюс разбирает, какие локальные и корпоративные скиллы и MCP выручают его в работе, и что в финале всё равно остаётся за тестировщиком. Читать далее

👉 QA-логия


ExploDrive: как я превратил запись экрана в отчет исследовательской тестовой сессии

Нейронки уже плотно влезли в рутину тестировщика. Разбирают требования, вылавливают в них противоречия, подкидывают идеи для проверок, клепают тест-кейсы, генерят тестовые данные, помогают с автоматизацией. То, на что раньше уходили часы ручной возни, теперь выдается за пару минут. Лучше всего это заходит там, где задачу можно формализовать: есть вход, правила, ожидаемый результат и внятный критерий полноты. Модель шустро перебирает варианты и не ноет от однотипных операций.

Итог: у тестировщика высвобождается время на то, что к заранее заданному алгоритму просто так не свести. Исследовательское тестирование — ровно из этой оперы. Тут мало прогнать заготовленный набор шагов: надо смотреть на продукт, цепляться за странности, строить гипотезы, разворачивать исследование в другую сторону и задавать вопросы, которых в исходных требованиях и близко не было. Иногда важнее не явное сообщение об ошибке, а мелкая задержка, внезапная смена состояния или ощущение, что система ведет себя непоследовательно.

Нейросеть может накидать тестовую идею или разобрать уже собранные материалы, но в самостоятельном исследовании живого продукта она человека пока не подменяет. Ей тяжело ухватить весь контекст взаимодействия, понять практическую значимость неожиданного поведения и решить, за какую случайную деталь стоит копать дальше. Исследовательская сессия как была, так и остается диалогом тестировщика с продуктом.

Читать далее

👉 QA-логия


Сайт на ИИ-агентах: 25 находок аудита из 111 — мусор, ещё 4 — чистая выдумка

Сайт у меня крутят ИИ-агенты: пишут код, правят тексты, ревьюят, собирают и выкатывают. 207 коммитов. Как именно это ускорило работу — автор молчит. Да и ускорило, чего там. Тема скучная, все давно в курсе.

Интереснее другое, про что говорят куда реже: узкое место съехало с написания кода на его проверку. Агент шпарит правки быстрее, чем человек успевает их прочитать, — и если проверку не вшить в конвейер, разница между «работает» и «выглядит как работает» просто растворяется.

Две цифры на затравку: 111 находок аудита, из них 25 отправились в мусор, а 4 оказались выдумкой. Читать далее

👉 QA-логия


Сказ про аккаунт OpenAI: паровозик, который так и не доехал

Хабровчанин делится: трёхлетний аккаунт OpenAI с подпиской Pro и кибер‑доступом Daybreak Blue улетел в бан — а заодно пропал доступ ко всему, что в нём накопилось. Ради этой истории он даже завёл себе профиль на Хабре — вдруг кому‑то из клиентов OpenAI это поможет не повторить его судьбу.

Аккаунт жил аж с 2023‑го: поначалу бесплатный, дальше $20 в месяц, а к 2026‑му дотянул до Pro за $100 ежемесячно. И жил он насыщенно: что‑то рисовал, копался в бытовых вопросах, клепал диеты и планы тренировок, поглядывал за крипторынком, интересовался путешествиями. Ну и пентестом тоже баловался.

Читать далее

👉 QA-логия


Тянуть ли топовую модель на рутину? Прогнал четыре штуки через пять одинаковых задач и сверил результаты

На Хабре всю неделю кипели: мол, нужен ли кодеру самый умный движок или на бытовухе прокатит бюджетный. Триста комментов — и ни единого замера, где всем выдали бы одно и то же.

Автор не стал спорить, а взял и сделал. Пять рутинных тасок, четыре модели из одного семейства, по два прогона на каждую, сверху — скрытые тесты. На выходе сорок запусков.

И вот сюрприз: самая дорогая оказалась самой шустрой — 341 секунда против 395 у самой дешёвой. Всё потому, что ей хватает меньшего числа ходов и вдвое меньшего объёма текста.

Четыре задачи из пяти затащили все, 32 прогона из 32. А на пятой младшенькая налепила баг и отчиталась двумя галочками кряду, причём вторая перечёркивает первую.

Читать далее

👉 QA-логия


Агент дописал «готово»? Это ещё не значит, что результат годный

Запуск закрыт, формат корректный, автопроверка пройдена. И что с того? В материале разбирают, почему для приёмки этого мало и какие отдельные гейты должны стоять между завершением и вердиктом человека.

Источник: Habr, 19 сентября 2026.

👉 QA-логия


Один Gmail — и тысячи адресов для сервиса: что мы случайно откопали в админке

Точка в адресе Gmail — и для сервиса ты уже другой юзер. Наткнулись на это случайно, а потом стало любопытно: докуда вообще можно докрутить?

Читать далее

👉 QA-логия


🤣 Типичный ИИ

💥 xCode Journal


Моки, из-за которых тесты зелёные, а прод лежит: 7 типовых косяков

Зелёный прогон — это вообще не гарантия, что код что-то ловит. Мок умеет мастерски прятать беды: жрёт неправильные вызовы, пропускает правки в интерфейсах и дарит ложное ощущение, что всё под контролем.

В статье — разбор типовых грабель с unittest.mock, тонкости patch, spec и autospec, а ещё момент, когда вместо моков лучше взять фейки.

Разобрать ошибки

👉 QA-логия


Playwright Codegen: магия заканчивается там, где начинается ручная работа

Евгений Когтев, который рулит направлением разработки в команде дизайн-системы «LUNA» в Домклик, делится, откуда у них взялась мысль облегчить написание тестов через Codegen: ты просто бродишь по сайту, будто рядовой юзер, а в соседнем окошке тем временем сам собой вырисовывается код — аккуратный, с подсветкой синтаксиса. «Никакой магии — сплошная инженерия», — решили они.

Читать далее

👉 QA-логия


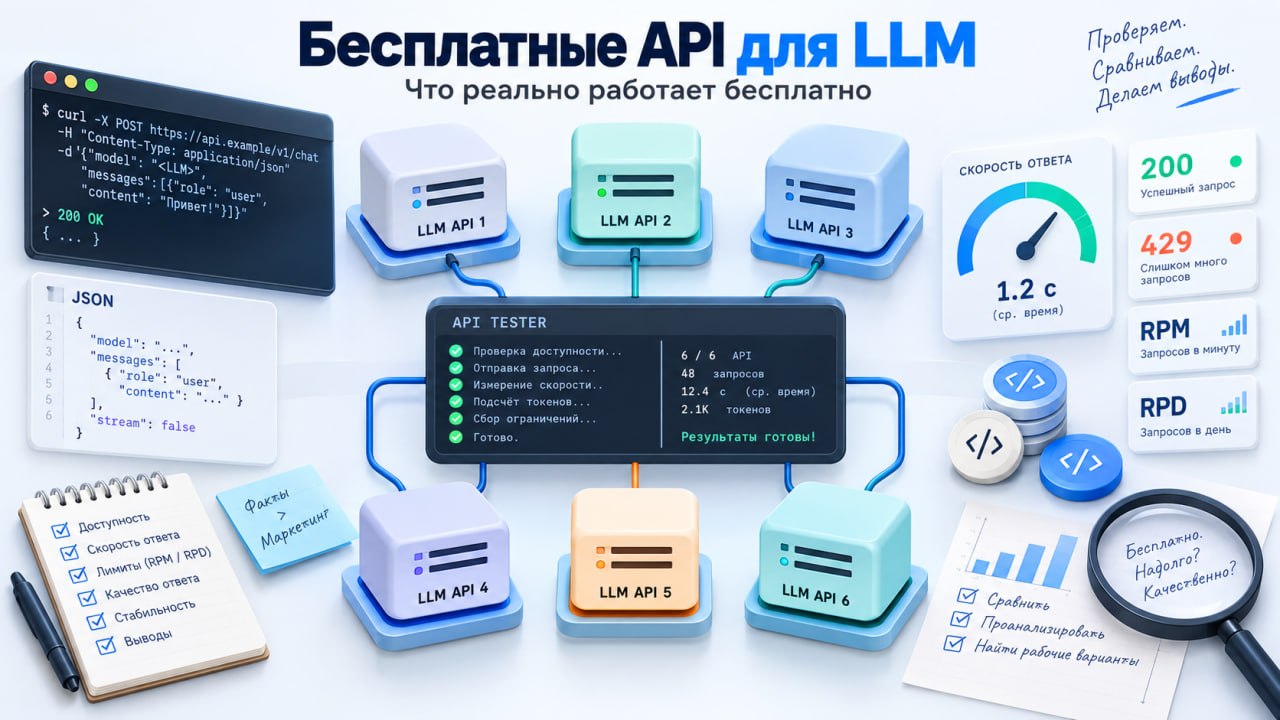
Бесплатный LLM API: прогнал шесть контор через тесты — вот что там с моделями и лимитами

Кто-то не поленился и нарыл шесть площадок, где LLM API дают бесплатно или по стартовому тарифу. И прогнал их живыми запросами, а не на словах.

Внутри — что из моделей вообще пашет, что перепадает после реги, куда девается баланс и на какие ограничения можно влететь.

Читать далее

👉 QA-логия


Уведомления для Slack в Allure 3

Когда гоняешь тесты, самое бесящее — это сидеть и тыкать в прогон каждые пять минут: закончился или нет. Куда приятнее просто получить сообщение в Slack. Отвлекаешься меньше — в потоке сидишь дольше. Так что уведомления о результатах прогонов — это не украшение, а реальное удобство в работе с тестами.

В Allure Report такое прикрутили аж в версии 3.0 — через плагин для уведомлений в Slack. А в руководстве разжёвано, как настроить канал в Slack, чтобы каждый запуск Allure Report скидывал туда сводку по результатам.

Читать далее

👉 QA-логия


Статья про то, как в ОС «Нейтрино» наладили сбор покрытия кода. Когда проект маленький, тут ловить нечего: поднял сборку с coverage, прогнал тесты, забрал отчёт — и свободен. А вот когда это целая операционка, где компонентов и тестов тысячи, всё превращается в отдельный квест.

Авторы раскладывают весь маршрут: от сборки компонентов и вылавливания файлов .gcno и .gcda до сборки трассировочных файлов и склейки результатов из разных CI/CD‑конвейеров. Плюс разбирают, как именно формируются итоговые отчёты.

И отдельным пунктом — зачем в будущем уходить с lcov на gcovr. Ознакомиться

👉 QA-логия

Показано 20 последних публикаций.