Generative Anton


Гео и язык канала: Россия, Русский
Категория: Блоги


Непубличный угловой интеллектуал. Широко известен в узких кругах.
https://repushko.com

Связанные каналы  |  Похожие каналы

Гео и язык канала
Россия, Русский
Категория
Блоги
Статистика
Фильтр публикаций


Всё было не зря


Arxiv ввел из-за нейрослопа лимит в два сабмишна в месяц. Теперь для нейрошитпоста остался только телеграм…


даже статью засабмитили в какой-то журнал (скоро покажу)

Действительно засабмитили. Пока она в ревью, опубликовали препринт.

Вся индустрия чтения древних текстов движется к автоматическому распознаванию больших объемов документов и это самое естественное и логичное направление происходящего: много текстов оцифруется, будет легче по ним ориентироваться -> больше интересного найдётся.

Для этого нужен хороший OCR. Что сложно делать для малоресурсных языков, еще и на поврежденном материале (в моей картине мира сюда попадают древнегеческий, коптский и арабский).

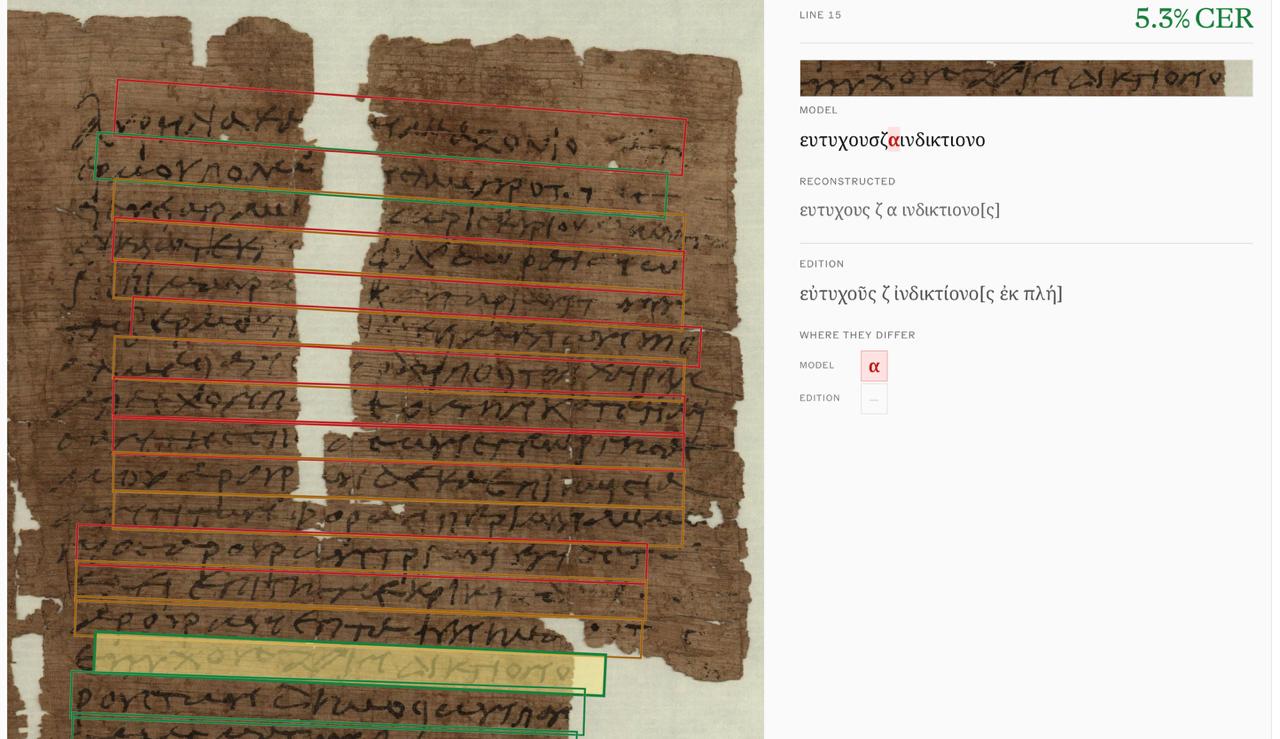
Но какая ошибка OCR (измеряем CER (Character Error Rate) по буквам) — хорошая и достаточная для поиска чего-то интересного или каких-то других задач (определение жанра/датировки и т.д.)? На этот вопрос и отвечаем. Берем ground truth для древнегреческого, аккуратно вводим ошибку и смотрим, где у нас и что сыпется. Если вкратце — с 10% жить вполне можно, но было бы классно хотя бы процентов 5-7%. Причем паттерн не зависит от архитектуры модели (там несколько штук разной сложности, от tfidf до byt5).

Вот и вся статья. Готовим доказательную базу для всего дальнейшего проекта по привнесению знаний в мир.

Препринт: https://arxiv.org/abs/2609.37755
Код: https://github.com/repushko/good_enough_papyrus_htr


Перелёт: *10 часов*
Я:


Топ-5 неожиданных транзакций в банковской выписке


Вот это хайп


Ну и как сейчас модно, тоже там в процессе понаходились какие-то дырки и обходы, которые были успешно проэксплуатированы (все в меня, я бы тоже самое сделал)


Продолжаю свои папирологические приключения. Мы с Аленой и группой более 40+ волонтеров сделали за 2.5 месяца (это очень быстро. Кто-то мог бы успешно пару миллионов в грантах распилить на такое за пару лет) первый на свете неплохой OCR для древнегреческих папирусов. И презентовали его на паре эвентов в Вене.

Это — первый кусочек гораздо бОльшего проекта по редиджитализации различных папирологических тулов под одним зонтиком: PapyBench. Например, скоро будет MCP для поиска по опубликованным папирусам.

Сервис для OCR называется Anagnostes: так в Греции называли рабов, которые читали вслух. По ссылке можно почитать побольше и прогнать до 5 папирусов бесплатно для ознакомления, но пожалуйста не надо (ну только если вам прям очень хочется): это стоит личных кровных посленалоговых денег. За пару недель, им попользовались примерно все нужные люди, создали больше 100 аккаунтов и проанализировали больше 200 папирусов. Чтобы похвастаться, там и Оксфорд, и Кембридж и Беркли и кого там только нет.

Может возникнуть резонный вопрос: а зачем вообще это все? Ответ достаточно очевиден:
1) Это нишево
2) Это весело
3) Помимоо свитков Геркуланума, в папирологической области (оказалось) еще поле непаханое того, что можно сделать.

Например, по свету разбросаны примерно еще 1.5 миллиона папирусов, доживших до нас. А сейчас опубликовано/прочитано вообще скажем около 70-80к. Если дать эту задачу всем папирологам на свете, то на расшифровку этого миллиона нужно порядка 2000 лет. А интересно там что-то точно есть, но сейчас это иголка в стоге сена и так просто это не найти. Вот поэтому эта история и происходит. Ведь так приятно найти какое-нибудь письмо брата брату, в котором он просит прислать себе маленькую овцу. Или как учитель жалуется, что ему дают изъеденное долгоносиками зерно.

Поэтому впереди еще много чего интересного, даже статью засабмитили в какой-то журнал (скоро покажу).Удивительно конечно, как простое перемножение матриц может стать enabler'ом какого-то такого хобби-ресеча.


Не очень важно, что это (папирус). Важно, что это красиво.


Репост из: Antibarbari HSE
🌋 Vesuvius Challenge: как машинное обучение сделало возможным чтение обугленных свитков

🌟 Антон Репушко, Head of Research в Revolut, ex-разработчик в Vesuvius Challenge, автор проекта Anagnostes в гостях у #antibarbari_colloquia

Во время извержения Везувия в 79 г. пирокластические потоки обрушились на Помпеи и несколько других городов с разной скоростью. Благодаря этому в Геркулануме папирусные свитки в частной библиотеке обуглились, но не были полностью уничтожены. Со времени обнаружения виллы с библиотекой в 1750 г ученые пытались развернуть свитки и прочитать содержащиеся в них античные произведения. Это часто приводило к тому, что папирусы рассыпались в прах и были потеряны для науки. В 2023-2026 годах участники проекта Vesuvius Challenge впервые с помощью технологий машинного обучения смогли виртуально развернуть несколько свитков без физического вмешательства. О том, как стал возможен этот научный прорыв, расскажет в лекции Антон Репушко.


🗓 25 сентября 2026 г., начало в 18:30 (мск). Встреча пройдет онлайн (Zoom).

🔗 Участие свободное. Регистрация по ссылке.

Мероприятие организовано Греко-латинским клубом
Antibarbari HSE совместно с магистерской программой "Цифровые технологии в гуманитарных исследованиях" НИУ ВШЭ.

Встречу проведет к.ф.н., доцент О.В. Алиева.


Я тут рассказываю интересное. Приходите, если хотите. Нужна только регистрация.


Ну, было

source


Одна из самых забавных вещей, которые сейчас происходят в интернете — флешмоб по вайбкодингу коннектома плодовой мушки (который релизнул Google) для разных задач. Там всего 500к нейронов, но всё таки.

Примеры, про которые я слышал:
• эмулировать виртуальную муху на рабочем столе
• засунуть коннектом в паука/муху/пчелу в Майнкрафте
• научить муху торговать биткойном на Coinbase
• играть в Doom
• играть в Light Saber
• играть в шахматы (сейчас ELO 600)
• водить машину (и пользоваться поворотниками)
• собирать кубик рубика
• etc

sources: 1, 2, 3, 4, 5, 6, 7


We are SOOOOO back.

В процессе подготовких многих интересных анонсов, проектов и папирологических рассказов, вернул к жизни https://repushko.com, переехал на новый cloud, настроил аналитику и чувствую себя замечательно.

Там будет публичная английская версия с лонгридами (потому что надо поднимать visibility, иначе никто не придет на вашу могилу после того, как вы умрете от голода из-за AI, отобравшего вашу работу). Лишний повод напомить про старое золото там уже есть: например рассказ, как мы выиграли соревнование по gaze detection до всяких AI-агентов просто голыми руками много лет назад.


Получил новый феноменологический опыт лиминальных пространств: забыл зарядку от ноута в Техническом Университете Вены после конференции и в 10 вечера зашел в открытый пустой корпус без людей, без охраны, c выключенным светом практически везде, дошел до лектория, забрал зарядку и ушел домой.


Репост из: Bulatov Dmitry
*ИИ создаст новые рабочие места*

Также эти рабочие места: Стартап Somnia Lab показал процесс обучения своего первого гуманоидного робота Model L, разработанного для интимной сферы. Робота обучают с помощью костюмов с датчиками захвата движения (Motion Capture). Приглашённые работники выполняют движения и принимают позы, которые затем оцифровываются и передаются в программное обеспечение робота. Разработчики уже записали более 165 различных действий. Сам андроид также будет поддерживать температуру человеческого тела и реагировать на прикосновения.


source


Мальчики: придумывают формат Open Knowledge, где данные для агентов хранятся в небольшом структурированном формате в Markdown.

Мужчины: смеются над ними и натравливают агента на всю свою org-mode директорию из Emacs'a.

Показано 20 последних публикаций.