


Репост из: Krist/Blog
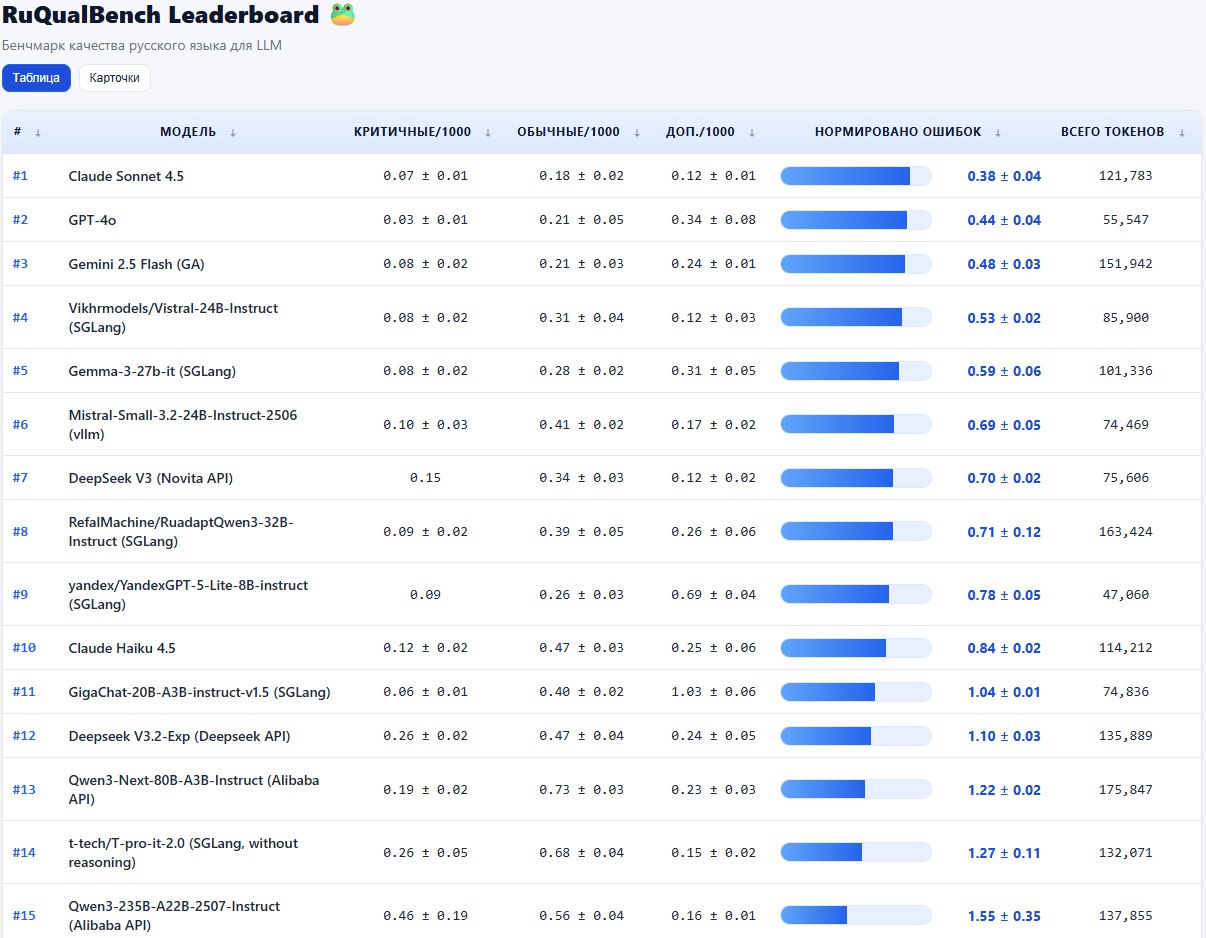
RuQualBench 🐸
Я сделал бенчмарк для оценки качества русского языка в LLM. Подробности:
- Набор из 100 (по умолчанию)/250/500 вопросов по general chat/creative writing доменам.
- LLM as a Judge, но с четкими критериями разметки ответов.
- Упор на типичные для LLM ошибки на русском (перепутанные рода, "китайщина", выдуманные слова).
- Всё под открытой лицензией!
Анализ результатов:
- Лучшими моделями всё еще остаются закрытые (в частности, Sonnet 4.5, Gemini, GPT-4o). Но некоторые открытые очень близки.
- GPT-5 ужасна. Я думал, что она лучше.
- Из открытых моделей Gemma-3-27b-it и Vistral-24B оказались вне конкуренции.
- Ruadapt значительно уменьшает количество ошибок относительно Qwen.
- Qwen3 и GPT-oss очень плохи. Даже хуже, чем я ожидал.
- Qwen3-Next лучше, чем Qwen3. Похоже, туда долили русского языка.
- У DeepSeek V3 мало ошибок, но актуальная V3.2-Exp почти в 2 раза хуже.
Лидерборд, код и данные