


Простой эксперимент, чтобы понять слабости косинусной близости эмбеддингов для некоторых задач SEO и на этом перестану наливать духоты про косинусы
Что тут на скрине:
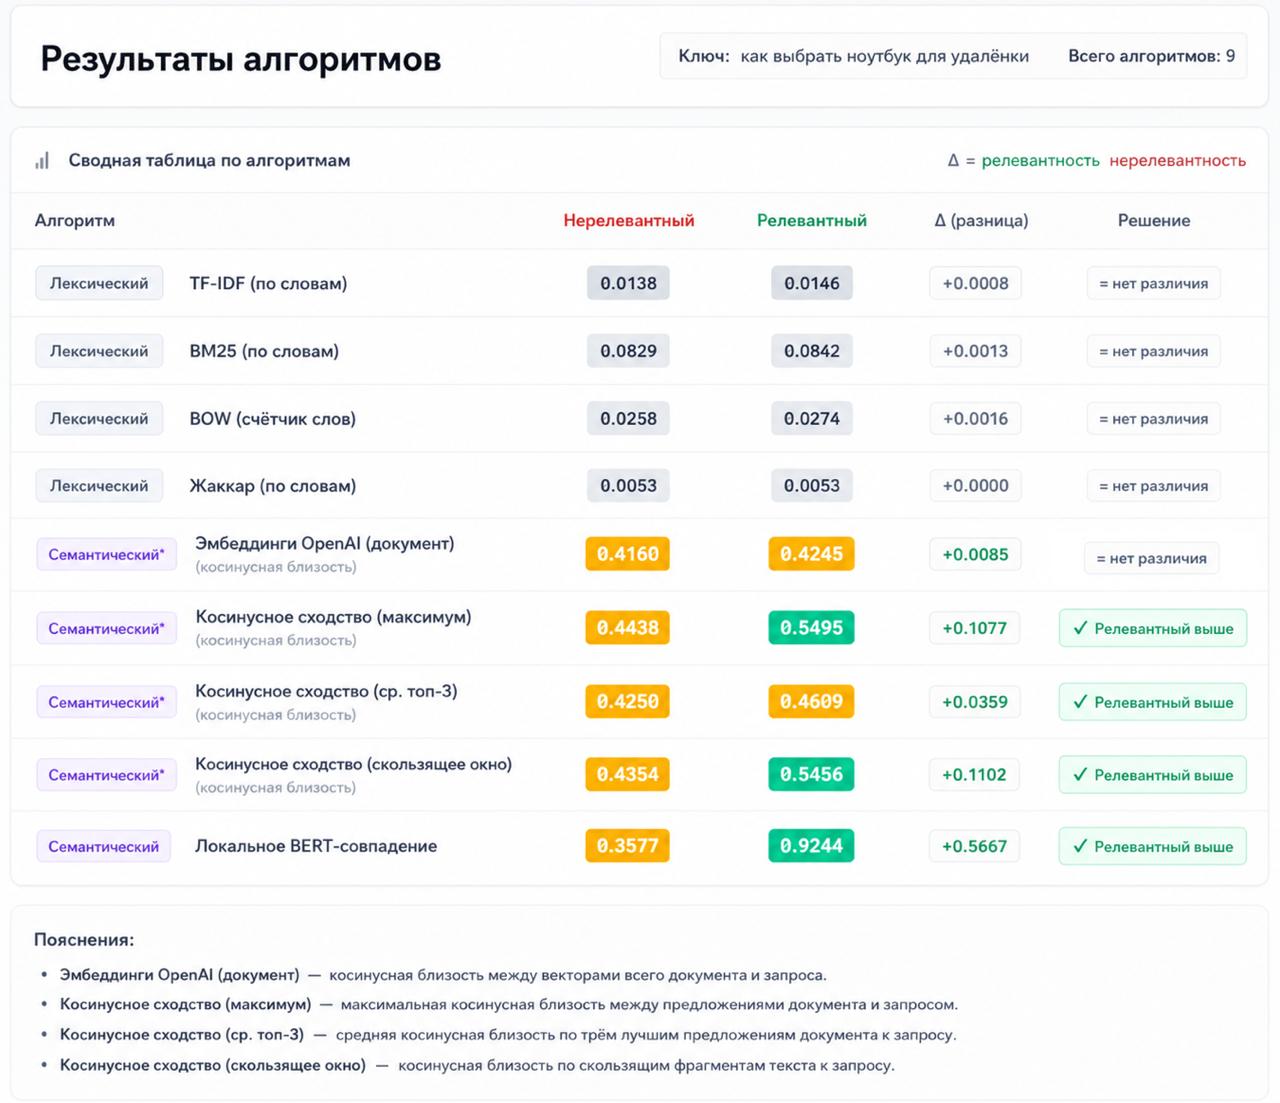
1. Результат поиска по запросу «как выбрать ноут для удаленки», где на вход идут 2 идентичных текста, отличающихся абзацем, который меняет смысл. Тексты кину в комментарии. В одном случае про офис (нерелевантный), а второй про удаленную работу (релевантный).
2. Числовые оценки — это уровень релевантности двух текстов. Дельта для подсветки силы алгоритмов.
Лексические алгоритмы не могут найти разницу, так как в тексте у меня «удаленная работа», а в поисковом запросе «удаленка». Оставим их в покое. Если бы у меня была база синонимов, которую собирают Яндекс и Google, то они бы справились в поиске релевантного текста.
Самый прикол — это то, что косинусная близость эмбеддингов посыпалась на относительно небольших текстах, где четко есть один абзац, который задает контраст смысла про удаленку. И, казалось бы, по логике должна случиться векторная магия, но, увы, ее нет. Дельта 0,0085 — это в 65 раз хуже, чем Cross-Encoder.
Косинусные алгоритмы начинают работать, если делить текст на фрагменты (абзацы, предложения) — на рис. смысловые сходства по предложениям и фрагментам.
В защиту косинусов
Косинусы — это удобно, так как вы можете заранее все навекторизовать и хранить в БД (в отличие от Cross-Encoder алгоритма), и когда юзер идет с запросом, то уже можно делать вектор его запроса, искать по БД, вытаскивать тексты, фрагменты, сниппеты по теме и уже доранжировать их. Ну, собственно, как и работают RAG-системы, как они участвуют в алгоритмах Яндекса и Google.
Есть еще куча задач, где косинусы применимы и эффективны. Но это не волшебный алгоритм понимания смыслов.