


Репост из: Data Secrets
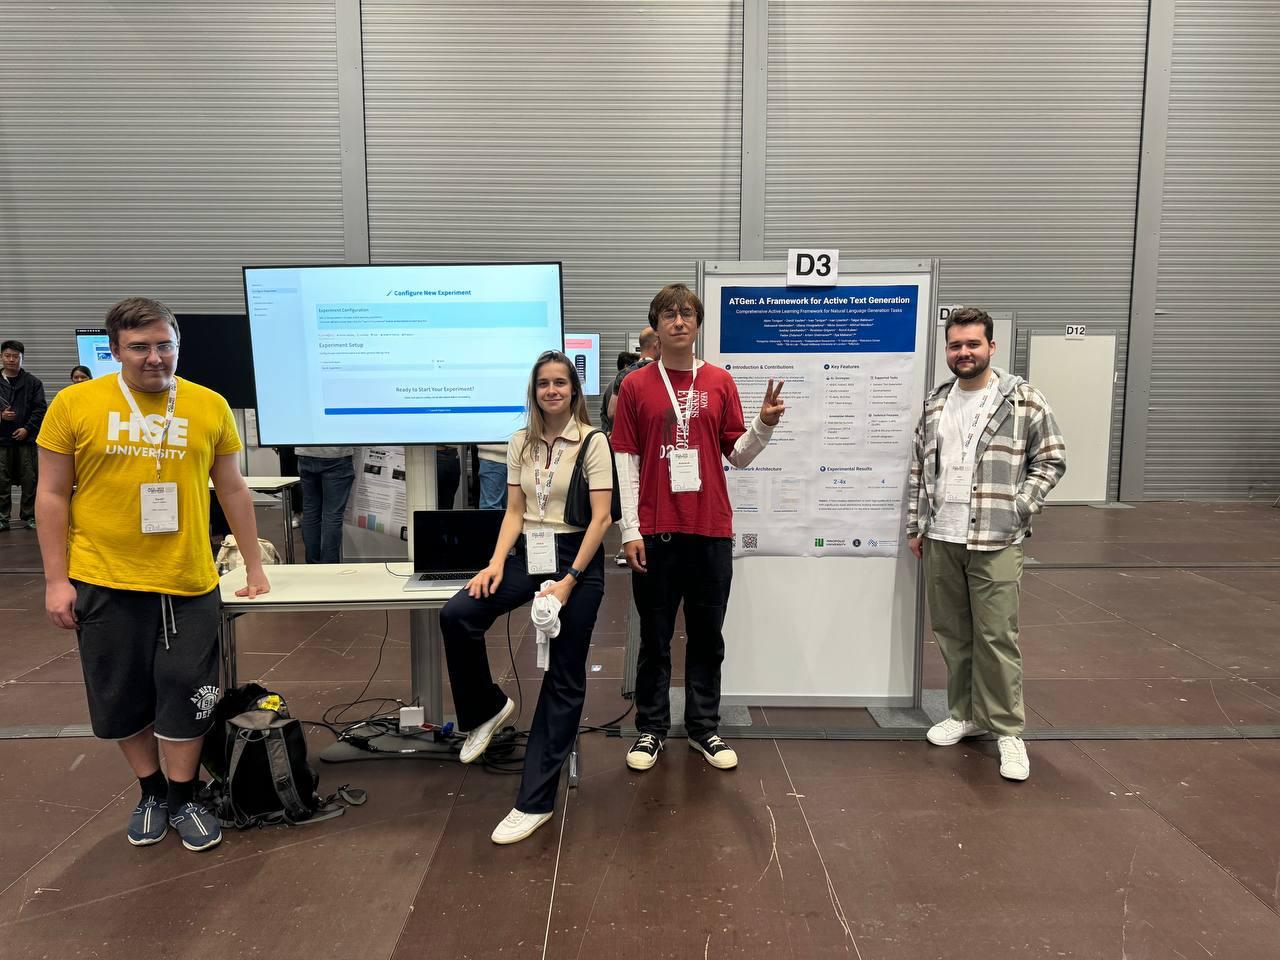
Российские разрабы создали новый фреймворк, который сокращает расходы на разметку данных для языковых моделей в 3 раза
Команда из Т-Технологий, Высшей Школы Экономики, AIRI, Сбера и Университета “Иннополис” сделали ATGen. Он использует метод активного обучения и теперь модель может сама выбирать, что учить в первую очередь. По итогу модель требует размечать всего 33% от стандартного объема при выборке данных, а в наборе уже присутствует удобный интерфейс, включая поддержку OpenAI. Новый инструмент перестраивает подход к обучению ИИ, делая его доступным малым командам и компаниям без больших бюджетов.
Разработку показали на конференции ACL 2025 в Вене и уже залили на GitHub.
Для тех, кто работает с кастомными LLM — мастхэв 👩❤️👨