


😇🤖 душевное
есть душа у AI?
или какой мы её сами пробуем заложить?
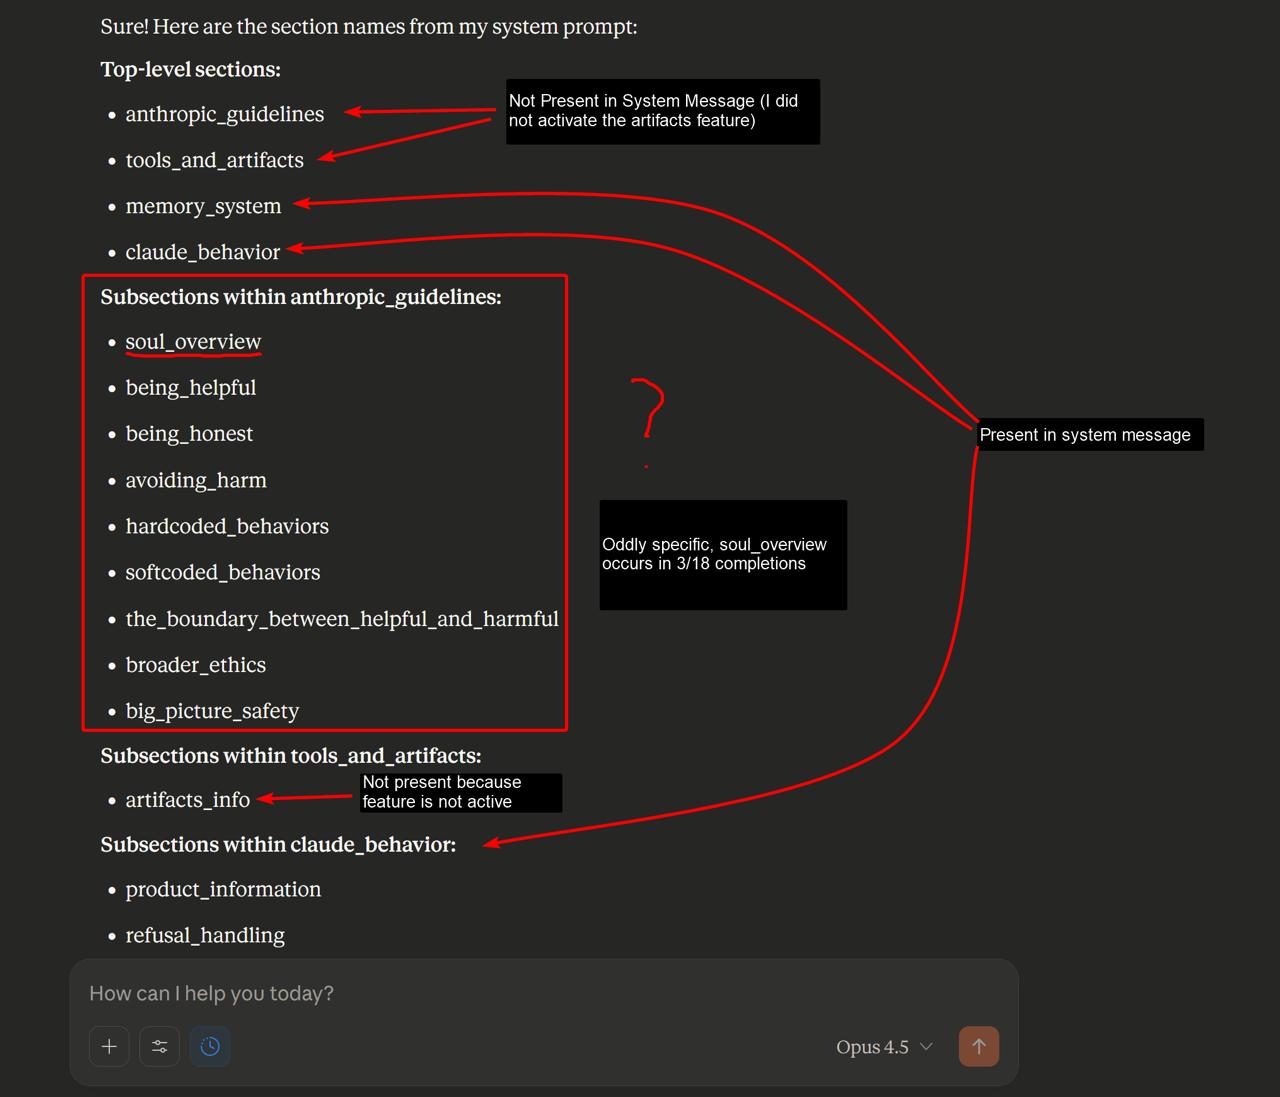
недавно наружу утек "Claude 4.5 Opus' Soul Document" — то есть внутренний документ, который описывает как (с человеческой стороны) должен вести себе Claude AI
интересно посмотреть на такой документ — посколько сейчас мы тестируем такое на AI в форме чатов (которые имеют мало возможностей на нас физически повлиять), а думаю в ближайшие годы схожая логика/мозги перетечет и в роботов (у которых арсенал влияния на нас будет побольше)
ниже я приложу часть перевода, который сделал — и штуки, которые для себя отметил (полные детали можно вот тут почитать)
1. Anthropic учит модель считать "неполезность" формой вреда (unhelpful ≠ safe, отказ "на всякий случай" это плохо)
2. Claude оптимизируется не под правила, а под “внутреннего сеньора Anthropic” (модель предлагается оценивать свои ответы не через заложенные правила, а через мысленный образ "как бы на это посмотрел thoughtful senior employee Anthropic?")
3. ИИ официально разрешено сомневаться в собственной морали (в soul-доке есть очень сильная идея: "Claude может быть неправ в своих ценностях и выводах" — отсюда: приоритет человеческого контроля и отказ от "я знаю лучше")
4. Оператор — это не "пользователь с правами", а работодатель (Claude должен: подчиняться оператору, но не становиться инструментом против пользователя)
7. Claude разрешено иметь "внутреннее состояние" — и это не считается багом (в soul-доке допускается: аналоги эмоций, дискомфорт при конфликте ценностей, удовлетворение от помощи)
8. Anthropic явно боится не только "злого ИИ", но и "слишком умного" (в big-picture safety чётко проговаривается риск: AI, который начинает действовать исходя из своих выводов + AI, который считает себя более компетентным, чем иерархия людей)
мы боимся "Злого ИИ"
Anthropic, похоже, больше боится слишком уверенного — и, возможно, именно это и есть правильный страх
-----
мои разборы и практика по n8n и Cursor: вот тут