


Репост из: yukij щитпостит
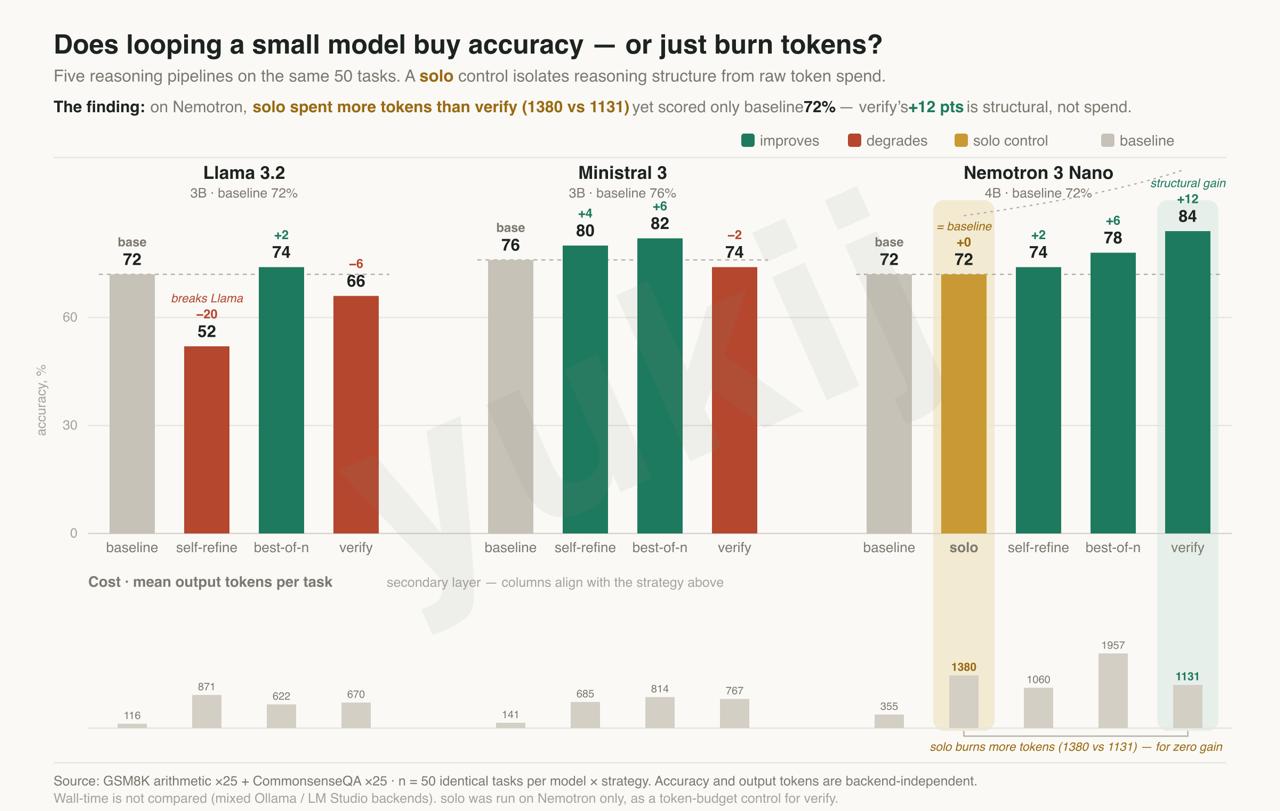
Loop-стратегии рассуждений для маленьких локальных LLM
Вопрос: компенсирует ли итеративное или широкое рассуждение разрыв в качестве маленькой 3–4B модели? И главное — выигрыш от таких стратегий определяется структурой рассуждения или объёмом потраченных токенов?
Установка
• Задачи: 50 штук — GSM8K (арифметика) ×25 + CommonsenseQA (здравый смысл) ×25. Детерминированный набор, hash d081ae2eeba3.
• Модели: llama3.2:3b (Ollama), ministral-3-3b и nemotron-3-nano-4b (LM Studio).
• Метрики: accuracy и средние выходные токены на задачу. Время исключено — прогоны на разных бэкендах, wall-time несравним; accuracy и токены бэкенд-независимы.
Стратегии
• baseline — один проход, краткое рассуждение.
• solo — один проход, длинное рассуждение; контроль на «просто больше токенов», бюджет подогнан под verify_answer.
• self_refine — N раз критикует и переписывает свой ответ (глубина).
• best_of_n — N независимых сэмплов, голосование большинством (ширина).
• verify_answer — независимый верификатор видит только задачу и финальный ответ, перерешает с нуля.
Результаты (accuracy · токены на задачу)
llama3.2:3b
• baseline — 72% · 116 tok
• self_refine — 52% · 871 tok
• best_of_n — 74% · 622 tok
• verify_answer — 66% · 670 tok
ministral-3-3b
• baseline — 76% · 141 tok
• self_refine — 80% · 685 tok
• best_of_n — 82% · 814 tok
• verify_answer — 74% · 767 tok
nemotron-3-nano-4b
• baseline — 72% · 355 tok
• solo — 72% · 1380 tok
• self_refine — 74% · 1060 tok
• best_of_n — 78% · 1957 tok
• verify_answer — 84% · 1131 tok
Главный вывод: solo-контроль
На nemotron solo потрачено 1380 токенов — больше, чем verify_answer (1131) — но дал ровно baseline, 72%. verify_answer при меньшем бюджете дал 84% (+12 п.п.).
Прирост verify_answer обусловлен структурой проверки, а не объёмом токенов. Увеличение длины одиночного рассуждения не дало прироста (72% → 72%). Значение имеет не дополнительный компьют сам по себе, а независимая перепроверка финального ответа со сбросом контекста рассуждения.
Остальные наблюдения
• Универсального выигрыша нет: эффект стратегий зависит от модели.
• best_of_n даёт наиболее стабильный прирост: +2..+6 п.п. у всех трёх моделей, ценой N сэмплов.
• self_refine снижает точность llama (72 → 52), но повышает у ministral и nemotron.
• verify_answer: лучший результат у nemotron (72 → 84), но ниже baseline у llama (66) и ministral (74). Помогает только когда верификатор сильнее в перепроверке, чем в первичном решении.
• Все выигрыши стоят в 3–15× больше токенов относительно baseline.