ML Underhood


Channel's geo and language: Russia, Russian
Category: Technologies


Рассказываем, чем живёт ML в Яндексе, и обсуждаем важные новости индустрии.
Вопросы и предложения > @yandex_ml_brand

Related channels  |  Similar channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


Мы на Interspeech — и не с пустыми руками

¡ɹǝpun uʍop ɯoɹɟ ʎɐp,ƃ

Ой..

То есть, привет из Австралии, где в эти дни, вплоть до 1 октября, проходит конференция Interspeech — о речевых технологиях и обо всём, что рядом. Мы, разумеется, на месте и будем рассказывать о самом интересном, что увидим (подписывайтесь на канал Speech Info, чтобы точно ничего не пропустить). А первыми впечатлениями поделился разработчик из службы технологий голосового ввода Яндекса Николай Коновальчук.

Если говорить о конференции в целом, то у участников тут есть две основных модели поведения. Есть условные Eleven Labs и Google, которые пытаются нанимать людей — мне буквально всучили мерч в обмен на контакты. С другой стороны, есть люди, которые пытаются что-то продать: либо услуги по разметке данных, либо готовые датасеты. Представители таких компаний очень активны. Один человек подошёл ко мне на афтерпати и завёл разговор только для того, чтобы предложить свои услуги; другой человек сперва спрашивал меня о постере, а потом выдал мерча и попытался продать свои услуги. И это только те, кто сами подходили. А в общем, тут, наверное, больше половины участников что-то продают.

Что касается постеров, то, разумеется, всего увидеть мне пока не удалось. Кое-что любопытное, к сожалению, посмотреть не сумел, потому что стоял у нашего постера, но сегодня были интересные вещи. На оралах об использовании моделей в ограниченных условиях тоже было довольно интересно.

Вообще, прикольно. Люди приветливые, кормят нормально.


О каком же постере говорит Николай? А вот о каком — Scalable Keyword Spotting via Modular Network Expansion. Это статья о том, как дёшево, сердито и (совсем) без потерь расширить словарь детектора ключевых фраз. Подробнее о методе мы писали вот тут.

Не переключайтесь — впереди ещё много интересного с Interspeech!

#YaInterspeech26

ML Underhood


Как сделать интерактивного агента с помощью KV‑кеш‑манипуляций

AI-ассистенты, роботы и другие агенты должны уметь получать новые данные прямо во время вычислений и корректировать свои действия на ходу без полного перезапуска. Исследователь Yandex Research Георгий Якушев в статье на Хабре рассказывает, как реализовать такую интерактивность во время инференса с помощью KV-кеша. Ниже коротко о главном. 

В статье предлагают рассматривать KV‑кеш как активное состояние выполнения модели. Оно определяет, какие результаты предыдущих вычислений увидит новый запрос, в каком причинном порядке они расположены и какие промежуточные состояния могут повлиять на следующий токен. Если изменить структуру и доступность кеша, изменится и вычисление, которое выполняет модель, хотя её параметры и представления токенов останутся прежними.

Вместо одного длинного контекста, к которому последовательно дописывается ответ, можно хранить набор дополняемых блоков. Отдельные блоки соответствуют входящим сообщениям пользователя, внутреннему рассуждению, ответу агента, результатам вызова инструментов, визуальным наблюдениям или работе других субагентов. Разным процессам при этом доступны разные логические представления одних и тех же физических блоков.

Для моделей с RoPE это можно сделать без повторного кодирования и копирования всего кеша. Пусть ρ(x, i) обозначает применение поворота к вектору x в позиции i. Тогда произведение запроса и ключа можно записать так: ρ(q, i_q)ρ(k, i_k)⊤ = ρ(q, i_q − i_k)k⊤.

Блок кеша достаточно один раз сохранить в локальных координатах. Во время запроса attention kernel применяет к текущему query поворот, зависящий от конкретного блока. Один и тот же физический блок в разных потоках оказывается на разных логических позициях. Плоский append‑only‑тензор превращается в переиспользуемую память с несколькими представлениями.

Также в статье рассматриваются методы параллельного инференса: Hogwild! Inference и AsyncReasoning (мы, кстати, писали о первом тут, а о втором — тут). В Hogwild несколько экземпляров LLM выполняют одну задачу, синхронизируясь через KV-кеш. AsyncReasoning тоже предполагает использование двух потоков одной LLM: первый генерирует выходные токены, а второй — ризонинг. Благодаря этому модель может выдавать ответы раньше, чем завершаются рассуждения, при этом не жертвуя качеством.

А о том, как работают мультимодельные системы, как Qwen3.5 играет в Doom и какие ограничения есть у вычислений в несколько потоков — читайте в полной статье на Хабре. Оригинальный пост на английском языке — в блоге Yandex Research. 

ML Underhood


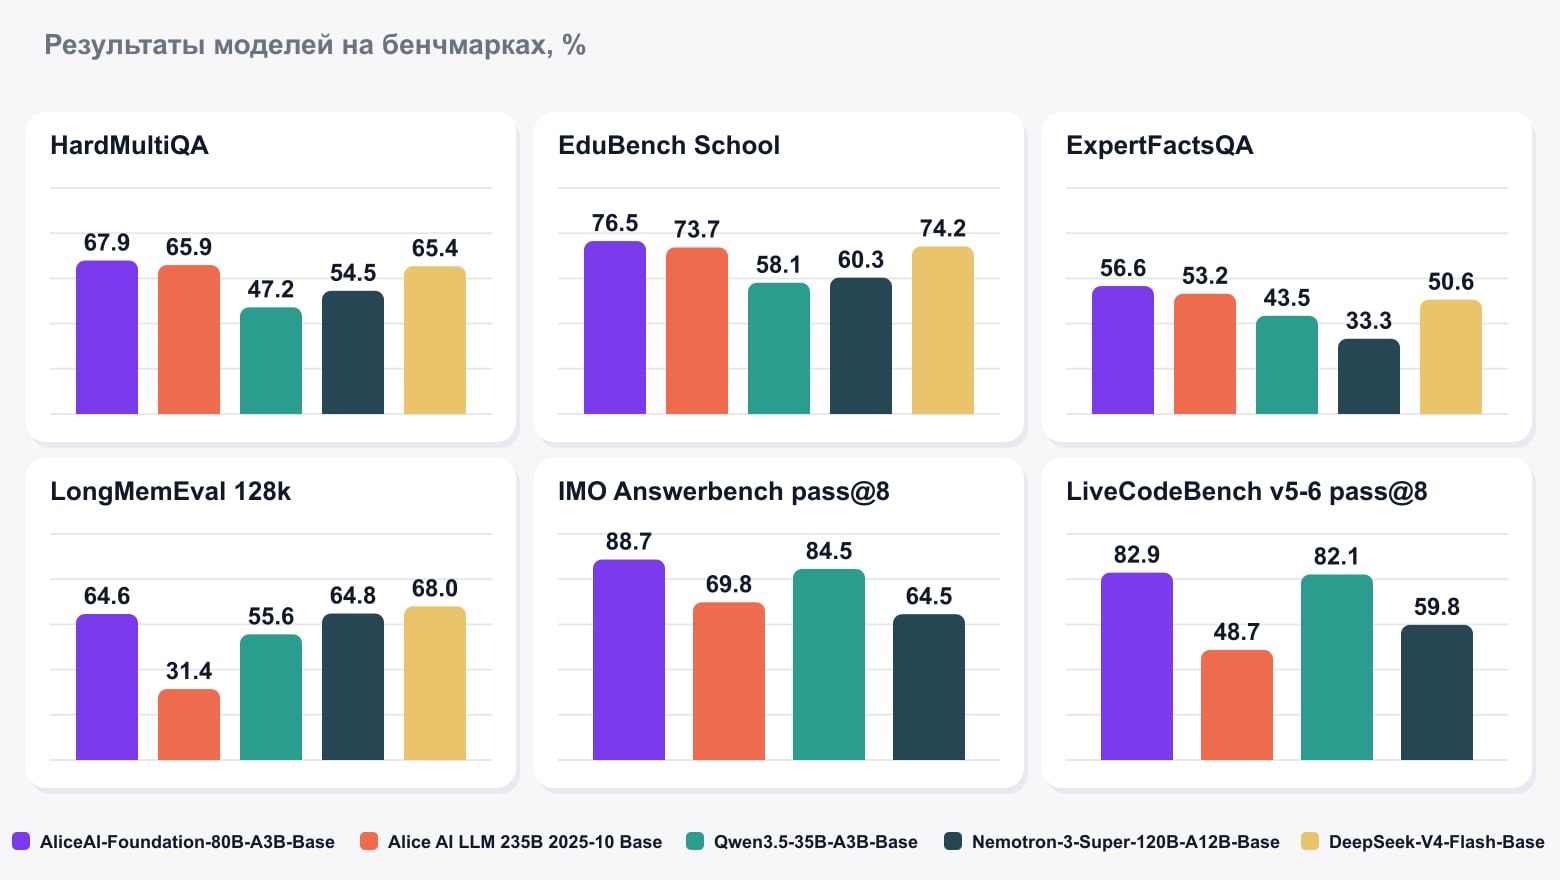
Выложили собственную претрейн-модель AliceAI‑Foundation-80B‑A3B‑Base — от обучения с нуля до опенсорса под лицензией Apache 2.0.

Это MoE-модель с 80 млрд параметров, из которых при генерации активны около 3 млрд. При обучении не использовались веса сторонних опенсорсных моделей. Весь путь до релиза занял около полугода: за это время команда пересобрала корпус, проверила архитектурные решения и гиперпараметры, а также добавила отдельные данные для рассуждений и взаимодействия с инструментами.

По внутренним претрейн-замерам модель обходит более крупные DeepSeek‑V4‑Flash‑Base и Nemotron‑3‑Super‑Base на ряде задач — от фактологических вопросов до математики и кода. На IMO AnswerBench и LiveCodeBench она лидирует среди сравниваемых открытых претрейнов. Предыдущую Alice AI LLM 235B модель также удалось превзойти на нескольких группах задач — при почти втрое меньшем общем и примерно в семь раз меньшем активном числе параметров.

Вместе с весами опубликовали технический отчёт на Хабре. В нём — устройство датасета, scaling laws, стабилизация MoE, абляционные эксперименты и подходы, которые не сработали. Среди интересных наблюдений:

— для корректного подбора гиперпараметров по scaling laws пришлось пересобрать валидационные датасеты так, чтобы loss на них больше коррелировал с качеством модели;
— много внимания уделили стабилизации обучения и борьбе с ростом активаций, который приводил к взрыву обучения;
— одного обучения сложным рассуждениям оказалось недостаточно для агентских навыков — взаимодействия с инструментами пришлось добавлять уже в претрейн.

Модель и бенчмарки (WikiWebFacts и HardMultiQA) уже на Hugging Face. Полный техрепорт — на Хабре.

ML Underhood


Выпустили агента «Исследовать» в Алисе AI. Рассказываем, почему сделали ставку на обвязку и как это теперь поддерживать

Агент «Исследовать» — это режим Deep Research’а в чате с Алисой AI. Он умеет строить оптимальный план для решения сложной пользовательской задачи. Для этого делает сотни поисков по запросу, пишет Python‑код, ходит на сайты, анализирует скачанные файлы и многое другое.

Работа над агентом началась примерно год назад. Как раз тогда — после релиза DeepSeek‑R1 — случился бум ризонинг‑моделей. Команда агента «Исследовать» и её лид Прохор Гладких, стартовали с того, что научили режим «Рассуждать» работать со свежими данными из сети. Сделали простой RAG-пайплайн с мультизапросным поиском, где запросы генерировала сама LLM. Пользователи оценили качество ответов, и стало понятно, что нужен полноценный Deep Research.

Как обычно, действовать нужно было быстро и в условиях всяческих ограничений. Поэтому решили сделать ставку на обвязку (харнесс) вокруг LLM. Ведь, меняя одну лишь обвязку на той же модели, мы получаем скачки метрик на десятки пунктов. Например, на SWE-bench с 3,8% до 12,5%, а на BrowseComp с 1,9% до 51,5%.

Кроме того, каждый токен в контексте и каждый лишний вызов модели — это GPU-время. Чтобы оптимизироваться тут, сделали три вещи.

1) Отдали обработку поисковых сниппетов обученному классификатору вместо LLM.
2) В инструменты стали ходить только когда это реально нужно для исследования.
3) Генерацию плана перевели на модель полегче без потери качества.

В итоге стоимость запроса сократилась в 6,6 раза, латенси для 90% запросов сократилась с 30 минут до 2,5. То есть пользователи стали получать ответы с тем же качеством ощутимо быстрее.

Пожалуй самый яркий фейл за время работы — то, что пришлось целиком выкинуть первый прототип, собранный на CodeAgent. Эта модель вызывает инструменты, генерируя Python‑код. И метрики там сразу вышли приличные: FRAMES — 75, SimpleQA — 81, GAIA — 26, пониже, потому что агент не умел работать с файлами.

Радовались до тех пор, пока не попробовали протащить решение в прод. Сгенерированный код нужно исполнять в песочнице с доступом в интернет, а значит — за пределами внутреннего контура. При этом инструменты агента живут внутри контура, поэтому пришлось бы пробрасывать tool-call из внешней сети внутрь, что небезопасно. К счастью, в то время вышла опенсорс-модель с хорошим function calling. За две недели команда полностью переписала агента: отказалась от CodeAgent и перешла на классический function calling loop. Ещё за неделю побили метрики первого прототипа.

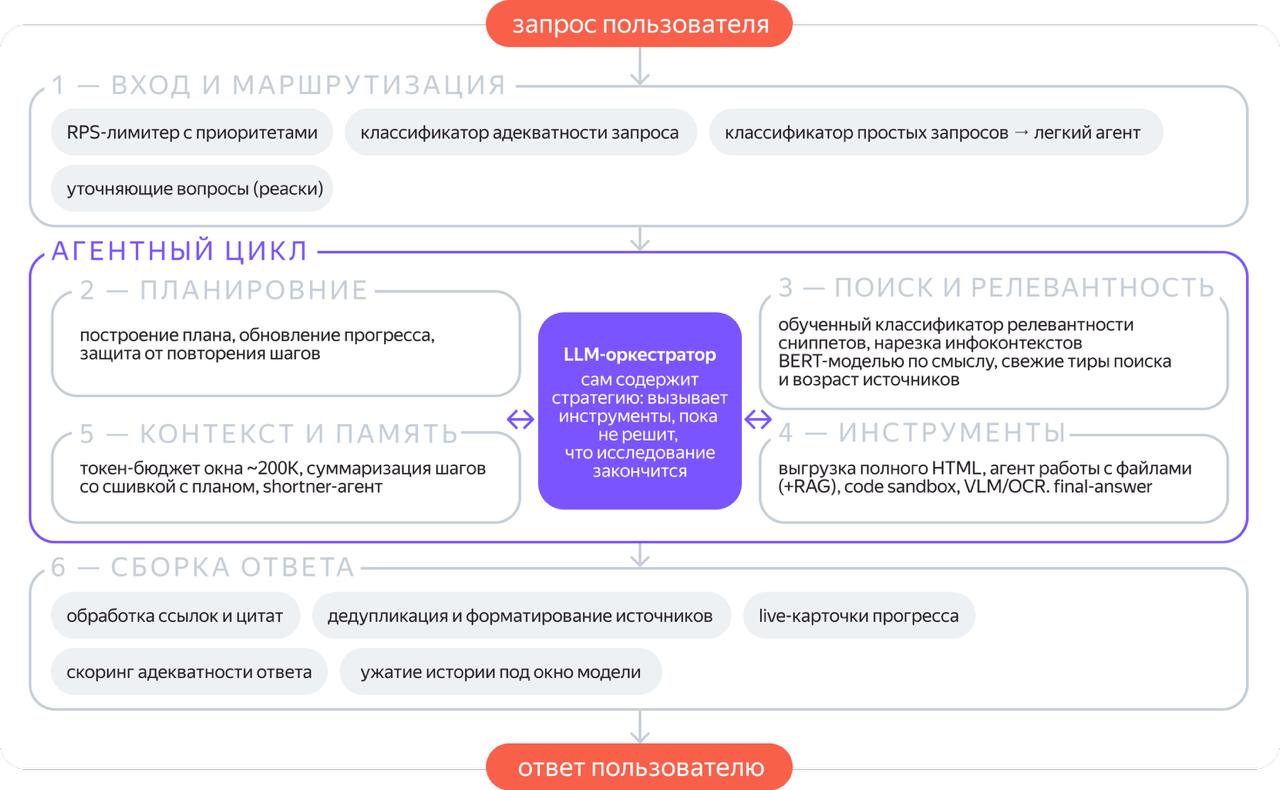
После переезда на function calling агент начал обрастать обвязкой. В основе классический агентный цикл: модель вызывает инструменты, пока не решит, что исследование закончено. Стратегию держит опять же сама модель: строит план, обновляет его по ходу и решает, куда копать дальше. Увидеть, что наросло вокруг этого цикла за год, можно на схеме в шапке поста.

Решение выглядит крутым, но есть нюанс. Мы помним, что каждый компонент обвязки — заплатка под текущее ограничение модели. С очередным релизом эти компоненты могут устареть. Поэтому харнесс нужно не только наращивать, но и регулярно срезать, снова и снова измеряя пользу каждого компонента на каждом релизе модели. И это — недели работы.

Поэтому следующий большой шаг — автоадаптация харнесса без ручной перенастройки. Обязательно поделимся результатами в новых постах.

В полной версии статьи на Хабре разобрали кейсы, из которых понятнее, как именно наращиваем и срезаем обвязку, поделились замерами на публичных бенчмарках и ключевыми метриками.

ML Underhood


Вчера на ECCV послушали кейноут Яна Лекуна — делимся основными тезисами.

Лекун начал с контраста между успехами AI в программировании и математике и его способностью действовать в физическом мире. Среди проблем — работа с высокоразмерными непрерывными данными (сырым видео, аудио и сигналами с датчиков), зависимость агентов от большого числа демонстраций и слабая адаптация к новым задачам.

🔴Интеллект — это способность решать новые задачи с минимальным обучением. Лекун отделяет её от накопления знаний и освоения фиксированного набора навыков. Термин AGI он критикует: человеческий интеллект тоже специализирован, а ключевое свойство — быстрая адаптация к незнакомым ситуациям.

🔴Моделировать мир через предсказание следующего кадра — по мнению Лекуна, неверный путь. Будущее на уровне пикселей неоднозначно, а такая детализация часто не нужна для выбора действий. Вместо этого он предлагает обучать абстрактные представления и предсказывать изменения в их пространстве.

На этом принципе построена JEPA (Joint Embedding Predictive Architecture), предложенная Лекуном в 2022 году: энкодер кодирует целевые данные, а предиктор по контексту предсказывает их представление. В модели мира предсказание также учитывает действие. Ошибка считается между представлениями, что позволяет игнорировать несущественные и непредсказуемые детали исходного сигнала.

🔴Модель мира позволяет планировать действия. Предсказывая последствия разных действий, система может искать последовательность, которая приводит к цели. Поэтому основным механизмом выбора действий Лекун предлагает сделать model-predictive control. RL при этом отводится роль корректировки модели мира или критика, когда фактический результат расходится с прогнозом.

🔴Для сложного планирования нужна иерархия моделей мира. В показанной архитектуре на каждом уровне работают своё представление состояния и своя модель динамики. Верхние уровни предсказывают более абстрактные изменения на длинных временных масштабах и задают подцели нижним. Нижние — планируют более конкретные действия на коротком горизонте. Иерархия здесь относится и к задачам, и к самим моделям, которые обеспечивают планирование.

В финале Лекун обратился к исследователям, чья цель — AI человеческого уровня, и рекомендовал им сменить исследовательский фокус: с генеративных архитектур на joint-embedding, с вероятностных моделей на energy-based models, с контрастивного обучения на методы с регуляризацией, с RL-я на управление на основе прогнозирующих моделей. По его мнению, именно в этих направлениях стоит искать путь к таким системам. В этом же контексте прозвучал призыв сместить внимание с LLM на обучение представлений и моделей мира.

А после — селфи со слушателями, как всегда. Заметки с той стороны объектива принесли ❣ Александр Шишеня, Ангелина Гнедина, Виктор Юрченко, Роман Исаченко и Полина Комиссарова.

#YaECCV2026

ML Underhood


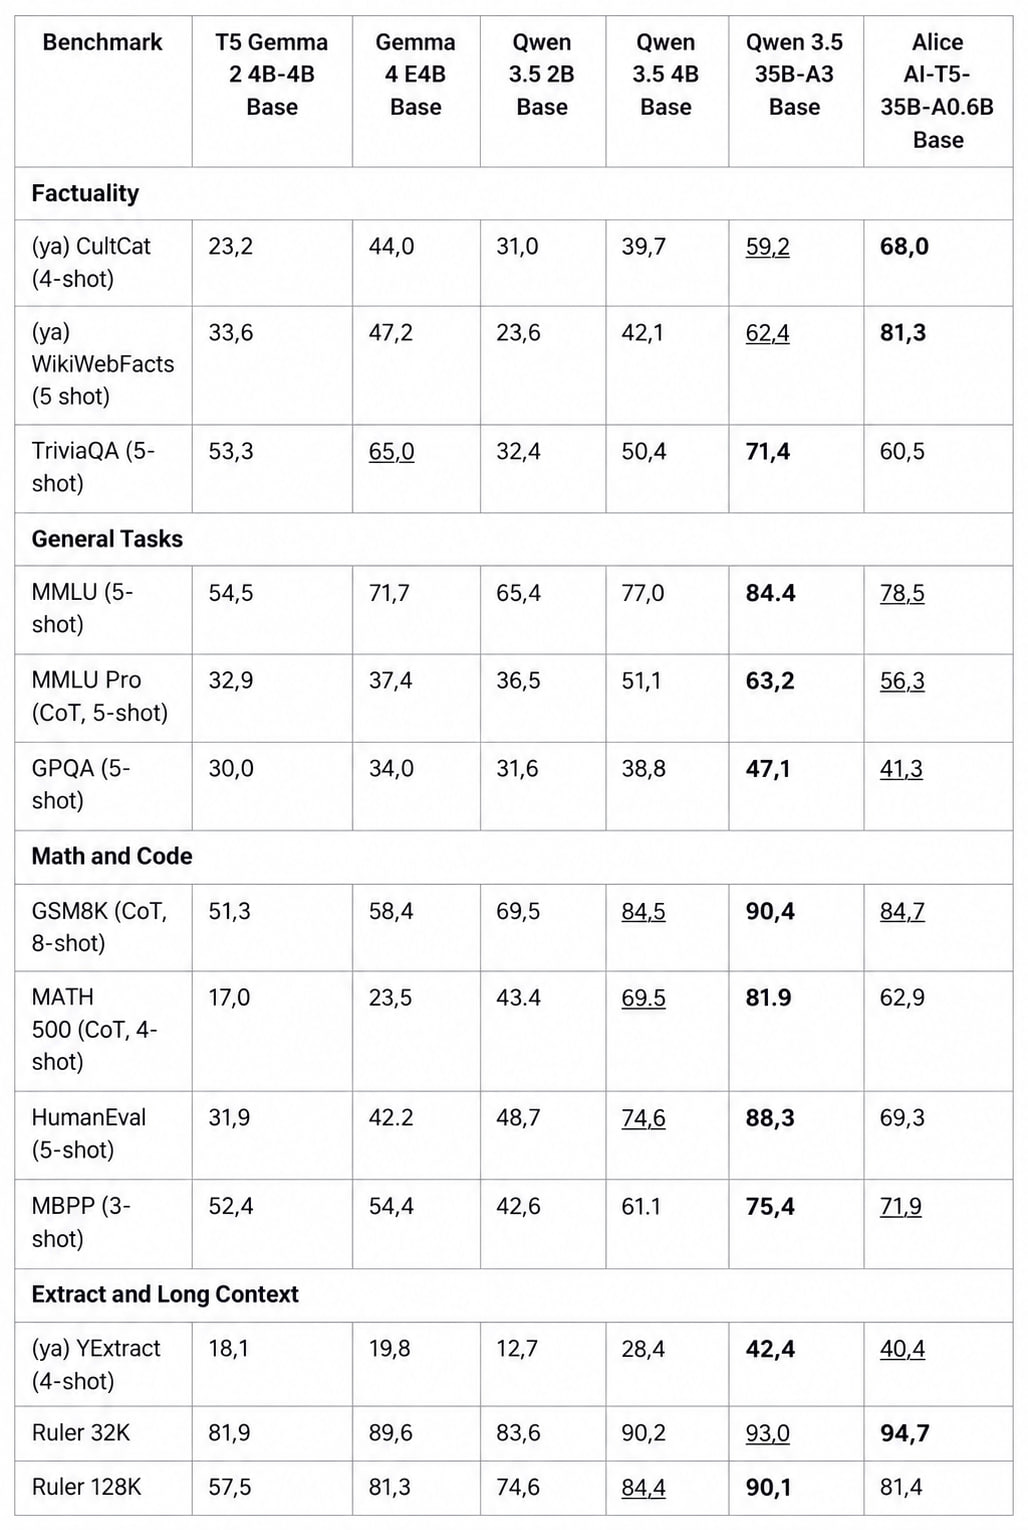
Сегодня мы опенсорсим модель, результатом работы которой пользуются 49,5 млн пользователей ежемесячно

Наша компактная языковая модель, обученная с нуля, формирует быстрые ответы Алисы AI под поисковой строкой. Артур Петросян, Назар Погосский, Никита Семёнов, Антон Викторов и Дима Калашников разобрали на Хабре, как она устроена и как её обучали. Ниже коротко о главном.

AliceAI-T5-35B-A0.6B — Encoder–Decoder с 34,35B параметров и разреженными MoE-слоями: в каждом для токена выбираются восемь экспертов из 512. Архитектуру подбирали под поисковый сценарий — обработать найденные документы и быстро сформировать ответ. Претрейн шёл на 15 триллионах токенов на задаче UL2-денойзинга. Затем контекст растянули с восьми до 128 тысяч токенов через YaRN. Как итог претрейна: после одинаковой процедуры алаймента — у AliceAI-T5-35B-A0.6B-Base 77% винрейта против Qwen3.5-2B в слепом SbS.

Отдельный сюжет — балансировка MoE. При масштабировании обучения балансировка со вспомогательным лоссом оказалась нестабильной: роутинг в энкодере коллапсировал. Переход на aux-free routing из DeepSeek-V3 решил проблему.

В поисковом пайплайне BERT-подобный экстрактор на 80 млн параметров сокращает документы до полезных для генератора фрагментов. Для его дообучения алгоритм на основе Cross-Entropy RL подбирает варианты контекста с учётом качества ответа и штрафа за длину. Сокращение контекста дало около +40% к пропускной способности без потери качества в наших экспериментах. Для продуктовой версии — SFT на ответах, отобранных через Rejection Sampling или улучшенных через Critique & Revision; затем RLHF на GSPO. Пользовательские сигналы тоже идут в обучение: отдельная reward-модель предсказывает Профицит и даёт один из сигналов для RLHF.

У итоговой модели в онлайн-эксперименте винрейт 56,7% против Google AI Overview. Приглашаем пощупать модель, почитать статью и поделиться впечатлениями в комментариях!

ML Underhood


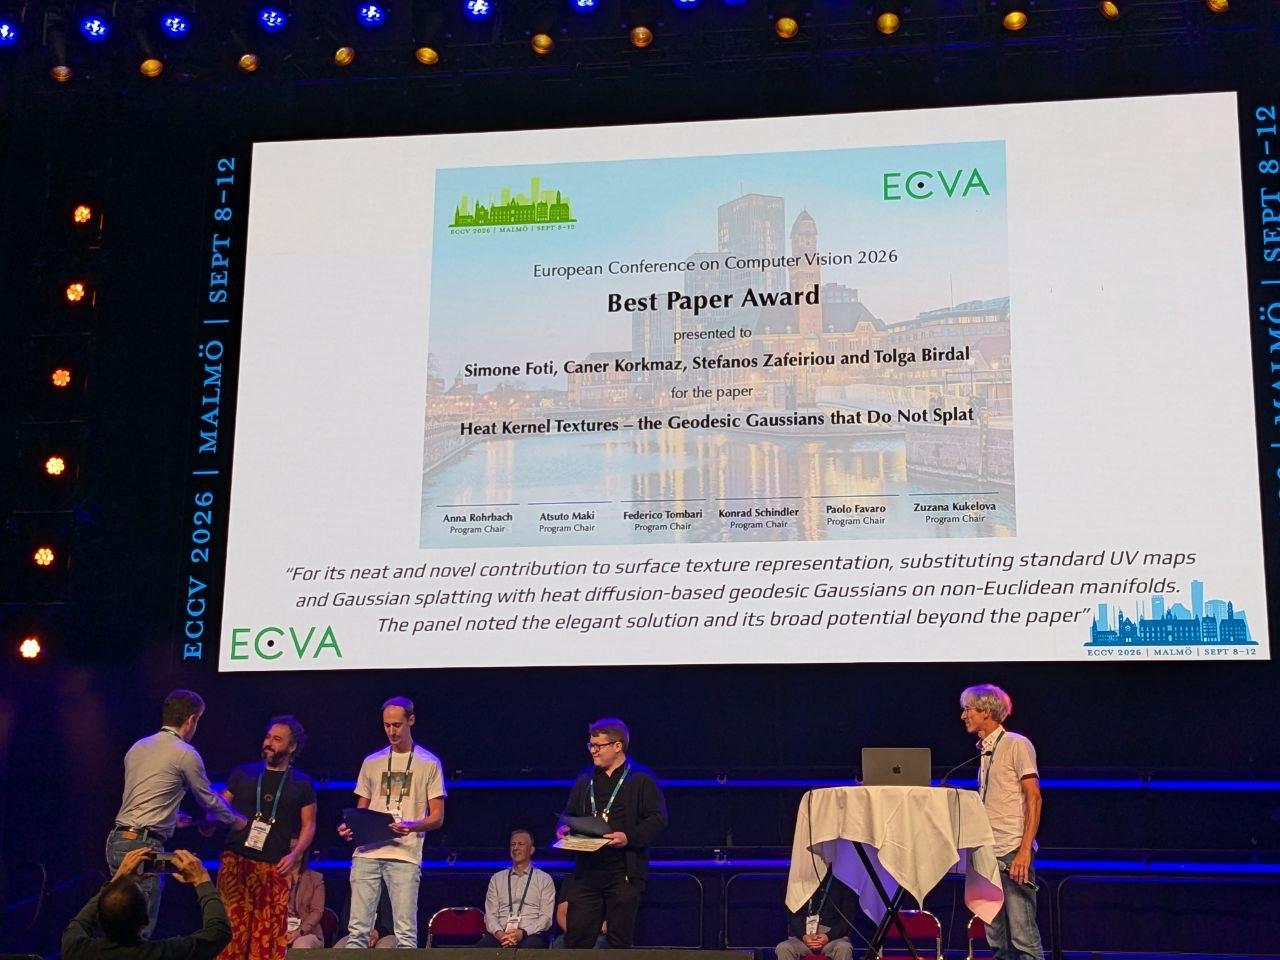
Немного цифр и Best Paper Awards на ECCV 2026

Сегодня на конференции раздавали награды — их получили пять выдающихся работ.

💫 Best Paper Award досталась статье Heat Kernel Textures — the Geodesic Gaussians that Do Not Splat. Авторы предложили новый способ накладывать текстуры на 3D-объекты без UV-развёртки.

💫 Best Paper Honorable Mention дали работам Poppy: Polarization-Based Plug-and-Play Guidance for Enhancing Surface Normal Estimation и LSRM: High-Fidelity Object-Centric Reconstruction via Scaled Context Windows.

💫 Test of Time Awards вручили проверенным временем статьям Learning Without Forgetting и Perceptual Losses for Real-Time Style Transfer and Super-Resolution. Первые версии обеих вышли в 2016 году.

Что же касается главных цифр, они вот такие:

🔴На конференцию подали 10 473 работы от 37 тысяч авторов, а приняли 2 834 статьи.
🔴Oral получили всего 163 работы (1,6%).
🔴В программе три дня основной конференции, два дня воркшопов и туториалов, три keynote и экспо с 34 компаниями.

Самая большая тема в программе с заметным отрывом — генерация картинок и видео. Следом идут vision-language & reasoning и 3D. Генерация и мультимодальность всё сильнее определяют повестку.

#YaECCV2026

ML Underhood


Привезли статьи на ECCV в Швецию!

С 8 по 12 сентября в Мальмё проходит 19-я European Conference on Computer Vision — одна из крупнейших конференций по компьютерному зрению. Сегодня рассказываем о статьях исследователей Яндекса, принятых на конференцию в основной трек и на воркшопы.

Revisiting Autoregressive Models for Generative Image Classification

Над статьёй работали исследователи Yandex Research Илья Судаков, Артём Бабенко и Дмитрий Баранчук.

Авторы пересматривают потенциал авторегрессионных моделей в классификации изображений. Метод на основе RandAR оценивает изображение при разных случайных порядках визуальных токенов и агрегирует результаты. Это снижает зависимость от конкретного порядка и помогает модели учитывать разные области и свойства объекта.

В экспериментах метод превосходит диффузионные и предыдущие AR-классификаторы по точности и устойчивости к сдвигам распределения данных. При этом он работает до 25 раз быстрее диффузионных классификаторов. По качеству метод сопоставим с передовыми дискриминативными моделями — заметное достижение для генеративных классификаторов. Код авторы выложили на GitHub.

DuET: Dual Expert Trajectories for Diffusion Image Editing

Над статьёй работали исследователи Yandex Research Лидия Троешестова и Сергей Кастрюлин, а также Александр Устюжанин из Alice AI ART.

DuET — training-free-метод улучшения качества редактирования в unified-моделях генерации и редактирования картинок. Он основан на интуиции: если мы учим одну модель делать и генерацию, и редактирование, то и на инференсе можно попробовать использовать оба режима. Оказывается, что в середине генерации можно временно отключить привязку к исходному изображению и перевести модель в режим text-to-image, а затем вернуть её к редактированию. Это позволяет более эффективно использовать генеративные способности модели.

У метода есть адаптивный вариант, который автоматически определяет, для каких правок нужно такое переключение. В результате решение повышает точность и естественность редактирования, уменьшает количество артефактов и при этом сохраняет важные детали исходного изображения.

Revisiting Classifier-Free Guidance Methods in Latent Diffusion Models

Среди авторов — Сергей Кастрюлин из Yandex Research, а также Артём Сергиевский и Артём Туревич из НИУ ВШЭ.

Classifier-Free Guidance — повсеместно используемый метод улучшения качества визуальной генерации в диффузионных моделях. За последние четыре года вышло огромное количество статей, предлагающих улучшение исходного подхода. При этом большинство статей плохо сравниваются с конкурентами, замеряются на неинформативных бенчмарках или проверяют качество на устаревших моделях.

Цель работы — актуализировать понимание о том, где область находится сейчас. Для этого исследователи сравнили восемь методов на основе Classifier-Free Guidance, не требующих дополнительного обучения, на моделях Stable Diffusion 3.5 Medium и FLUX.2 4B Base. Все методы тестировались в одинаковых условиях на задачах композиции объектов, соответствия текстовому запросу, генерации текста и рассуждения на основе знаний.

В статье собраны результаты бенчмарков и примеры генераций, поэтому методы можно сравнить не только по числам, но и визуально. Спойлер: страшные руки тоже присутствуют.

#YaECCV2026

ML Underhood


Финальные впечатления от ICML 2026 и любопытные исследования

Карина Романова, которая занимается LLM-агентами в Алисе, поделилась впечатлениями от ICML на Хабре. В тексте рассказывается и о статьях, и о воркшопах, и об организации мероприятия — обязательно почитайте. А здесь — о трёх исследованиях Яндекса, которые представили на конференции и которые отметила Карина. 

On Efficient Scaling of GNNs via IO-Aware Layers Implementations

Когда мы пытаемся ускорить GNN на GPU, сразу хочется оптимизировать математические вычисления. На практике же выясняется, что GNN чаще упираются не в compute, а в память и скорость передачи данных.

Авторы разобрали популярные семейства графовых моделей, нашли их узкие места при работе с памятью и адаптировали низкоуровневые GPU-оптимизации под особенности графовых данных, по сути, применив IO-aware-подход, похожий на идеи из FlashAttention.

Что получилось

Для GATv2: кастомные GPU-ядра показали ускорение до 8,5 раз относительно библиотеки DGL (медиана — в два раза), а пиковое потребление памяти снизилось до 76 раз (медиана — в шесть раз).

Для Graph Transformer: отдельная block-sparse-реализация под Tensor Cores ускорила работу до 7,3 раза на локально плотных графах.

GraphPFN: A Prior-Data Fitted Graph Foundation Model

Воркшоп был посвящён развитию graph foundation models — переходу от узкоспециализированных моделей для отдельных задач к универсальным foundation-моделям для работы с графами. Сама статья о GraphPFN, к слову, получила Best Paper Award.

Как устроена GraphPFN

— В основе — подход PFN: модель развивает концепцию Prior-Data Fitted Networks.
— GraphPFN предобучают на миллионах специально сгенерированных синтетических графов.
— Благодаря синтетическому претрейну модель умеет работать с реальными графами прямо «из коробки» в режиме in-context learning без долгого переобучения или после минимального файнтюнинга.
— Результаты: на широком наборе реальных графовых датасетов GraphPFN показала лучшие результаты среди протестированных в работе подходов.

В рамках того же воркшопа Людмила Прохоренкова из Yandex Research участвовала в панельной дискуссии о будущем graph foundation-моделей вместе с исследователями из RWTH Aachen, Georgia Tech и Arizona State University. На панельной дискуссии обсуждались последние достижения, открытые проблемы и перспективные направления развития графовых foundation-моделей.

Weight-Space Geometry of Offline Reasoning Training

Обычно offline RL-лоссы для RFT, RIFT, DFT, Offline GRPO и DPO сравнивают с SFT по финальной accuracy. Мы решили посмотреть на другую сторону этих методов: насколько различаются изменения, которые они вносят в модель. 

Как проводили эксперимент

Чтобы сравнение было честным, мы зафиксировали условия:

— Взяли единый набор математических rollout’ов.
— Обучили все шесть методов на модели Qwen3-4B-Instruct с attention-only LoRA.
— Сравнили получившиеся LoRA-дельты (ΔW).

Что получилось

Оказалось, что у SFT, RFT и RIFT эти дельты направлены почти в одну сторону, хотя их величина различается. DFT отклоняется от этого направления заметно сильнее, а у Offline GRPO около 67% апдейта глобально и до 86% в последних слоях приходится на компоненту, ортогональную направлению SFT. 

DPO занимает почти отдельное подпространство и показывает лучшую accuracy в нашем протоколе. Однако его обучали с learning rate в десять раз меньше и на меньшем числе примеров, поэтому разницу нельзя объяснять только устройством лосса. 

Получается, что разные методы могут сильно различаться по формуле, но в контролируемом эксперименте приводить к неожиданно близким направлениям адаптации весов. При этом важно учесть, что вывод относится именно к фиксированным математическим rollout’ам, Qwen3-4B-Instruct и attention-only LoRA, а не ко всем весам и сценариям обучения вообще.

#YaICML2026

ML Underhood

9 last posts shown.