Аскер про AI/ИИ в Бизнесе


Channel's geo and language: Russia, Russian


Помогаю владельцам и руководителям использовать ИИ для работы со сложной информацией, подготовки решений и сокращения умственной рутины. Персональные AI-стратегии и организация интеллектуальной работы в компании.
Связь @askerych

Related channels  |  Similar channels
Channel's geo and language
Russia, Russian
Statistics
Posts filter


Не могу не сказать о волне блокировок Claude.

Среди пострадавших и мои знакомые, у которых на моделях Anthropic были выстроены рабочие процессы. В такой ситуации, как продолжать работу и что теперь собирать заново?

У меня тоже был неприятный опыт с Anthropic, когда мы с коллегами пытались стать их сертифицированными партнёрами. Узнав, что команда российская, Антропики закрыли нам доступ к программе, причем мы уже закончили 3й этап программы. Поэтому зависимость от односторонних решений поставщика для меня не отвлечённая тема.

Но дело здесь не только в Anthropic. На её месте может оказаться любая компания. Поставщик меняет условия, ограничивает доступ или просто перестаёт подходить под ваши задачи.

Я не хочу угадывать, кто из них никогда меня не подведёт. Мне важнее, чтобы смена поставщика не разрушала то, что я выстроил.

По этому принципу я и строю Цех - собственную рабочую среду, в которой модель - заменяемый компонент, а не место, где заперта вся моя работа.

В Цехе три части:

1. Локальная база документов, данных, знаний, событий и принятых решений. Всё, что накапливается в работе и формирует её контекст.

2. Инструменты для создания и управления ИИ-агентами, их командами, навыками и интеграциями.

3. Персональный ИИ-помощник, который работает с этой базой и управляет всем этим хозяйством.

Если одна модель становится недоступна, я могу подключить другую. Моя база и настройки рабочей среды при этом остаются у меня.

Это не означает полной неуязвимости. Для работы с облачными моделями по-прежнему нужны связь и доступ к сервисам. А новая модель может иначе выполнять задачи: что-то придётся проверить и перенастроить.

Но перенастраивать существующую систему и восстанавливать её с нуля — разные вещи.


Для меня в этом и смысл Цеха. Пользоваться возможностями внешнего ИИ, сохраняя под своим контролем накопленные знания и организацию собственной работы.

Поставщик ИИ может измениться. Вы не должны из-за этого начинать с нуля.

Пишите, если хотите разобраться, насколько ваша работа зависит от конкретного сервиса, или поставить себе Цех.

P. S. Готовлю большое обновление Цеха. Мы с Яром работаем над ним уже три недели. На днях отдельно покажу, что изменилось и какие задачи теперь можно решать.


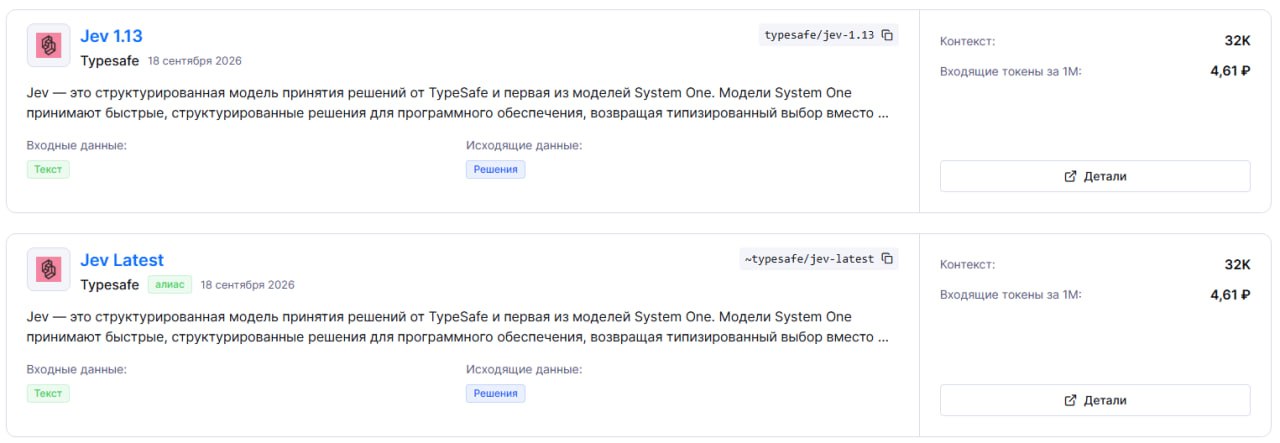
Сегодня начинаю собирать корпус данных для тестирования Jev — AI-модели от TypeSafe AI. Разработчики относят её к классу System One: моделям для быстрых структурированных решений. Например, определить, к какой из заданных категорий относится задача, и вернуть оценку уверенности.

Дело в том, что в когнитивно-архитектурном анализе такой работы очень много. Уже в моём первом тестовом корпусе было 200 процессов, в каждом из которых от 10 до 50 задач. Тысячи задач, которые нужно разобрать, сопоставить и классифицировать. При работе через ChatGPT и Claude я постоянно упирался в лимиты, а эксперименты обходились в ощутимые деньги.

Jev заинтересовала меня заявленными скоростью и низкой стоимостью обработки. Хочу проверить, насколько эти преимущества сохраняются на моих данных и какое качество классификации получается.

В моём понимании здесь может хорошо работать связка моделей. Сначала вместе с сильной языковой моделью — например, Sol или Astra от OpenAI — исследовать материал, уточнить категории и сформулировать критерии. После проверки этих критериев подключить Jev для массовой классификации. Неоднозначные случаи возвращать на отдельный разбор.

Именно такую схему я и собираюсь тестировать: сравнивать точность, скорость и стоимость обработки.

Впереди целая серия экспериментов. Буду делиться результатами. А с методологией когнитивной архитектуры бизнеса можно познакомиться по ссылке https://ai09t.tech/ru/methodology.html


Сегодня зафиксировал ещё одну важную для себя точку в работе над «Когнитивной архитектурой бизнеса».

Опубликовал первую публичную версию прикладной статьи о КАБ в Zenodo с присвоением DOI (цифровой паспорт для статьи). Эту же версию дополнительно депонировал в Национальном реестре интеллектуальной собственности n’RIS.

Для меня здесь важен не столько формальный вопрос авторства. Последние месяцы КАБ постепенно превращалась из набора наблюдений и рабочих гипотез в довольно определённую концептуальную конструкцию. И в какой-то момент стало понятно, что её текущее состояние пора просто зафиксировать публично и с конкретным текстом, автором и датой.

Научная работа при этом идёт отдельно. Первая академическая статья по КАБ уже находится на рассмотрении в научном журнале. А опубликованный сегодня материал - именно прикладное изложение: как я сейчас смотрю на интеллектуальную работу компании, информационно-когнитивные преобразования и проектирование совместной работы человека и ИИ.

Прочитать полный текст КАБ-методологии на Zenodo

Сегодня же опубликую публичную версию статьи у себя на сайте и в рассылке LinkedIn


Оценивая эффективность работы компании, измеряйте не время работы, а время от появления сигнала до реакции компании

Мне кажется, при оценке эффективности компании полезно держать в голове два разных времени.
Первое — сколько сотрудники непосредственно работают над вопросом.
Второе — сколько времени проходит, пока ситуация дожидается их действий.

Эти величины могут различаться очень существенно.

Допустим, в понедельник поставщик предупредил, что ключевая партия задержится. Закупщик быстро внёс изменение в учётную систему. Во вторник сведения попали в отчёт. В четверг отчёт посмотрел руководитель. В пятницу вопрос обсудили с производством, а менять план начали уже после выходных.

На внесение данных ушли минуты. На подготовку отчёта ещё немного времени. Обсуждение тоже не было долгим. Но компания начала перестраивать работу через неделю после предупреждения.

Теперь представим, что мы автоматизировали подготовку отчёта и сократили её с сорока минут до пяти. Это может быть полезно: сотрудник освободил время для других задач. Однако если отчёт по-прежнему смотрят в четверг, дата начала действий не сдвинется.

Поэтому вместе с трудозатратами я бы измерял время от доступного компании значимого сигнала до конкретной реакции.

Здесь нужно заранее договориться, что считать началом и концом. В нашем примере начало — получение предупреждения от поставщика. Конец — запуск необходимых изменений в плане. Само прочтение сообщения ещё не означает, что компания начала справляться с последствиями.

Есть важная оговорка: ранний сигнал редко приходит с подписью «Это точно серьёзная проблема». Предупреждение может быть предварительным, сведения — противоречивыми, а изменение плана — дорогим. Вполне разумно потратить время на проверку. После случившегося легко объявить очевидным то, что заранее выглядело неоднозначно.

Поэтому в таком разборе я бы различал необходимую проверку и обычное ожидание. Пока сотрудник выяснял реальную дату поставки, компания уменьшала неопределённость. Пока готовое подтверждение лежало до еженедельного совещания, вопрос просто ждал своей очереди.

Задержка важна ещё и потому, что со временем могут исчезать варианты действий. В понедельник производство, возможно, успело бы поменять последовательность заказов или найти временную замену. Через неделю остаются срочная перевозка, простой или перенос обязательств перед клиентом. Значение имеет и то, какие возможности ещё доступны к моменту реакции.

При проектировании AI здесь можно поставить задачу раньше выделять значимые изменения и направлять их человеку, который вправе вмешаться. Но нужно проверить, помогает ли это начать нужное действие вовремя. Если система только увеличит число уведомлений, получателю придётся тратить ещё больше времени на их разбор.

Я бы начал с одного недавнего сбоя и восстановил его хронологию по сообщениям и действиям.
Какой первый сигнал действительно позволял заподозрить проблему?
Что компания знала в тот момент?
Сколько времени ушло на проверку, а сколько — на ожидание?

Возможно, после такого разбора главным вопросом станет: зачем мы ускоряем подготовку документа, который потом три дня никто не открывает?


Самая важная система компании может отсутствовать в вашей IT-архитектуре

Если попросить показать информационные системы компании, вам, скорее всего, расскажут, где ведутся продажи, где учитываются деньги, как работает склад и куда собирается отчётность. Возможно, покажут аккуратную схему связей и обмена данными.

А потом при разборе конкретной задачи выяснится, что каждое утро один сотрудник выгружает две таблицы, вручную сопоставляет строки, уточняет непонятные расхождения в общем чате и отправляет руководителю короткое письмо: «Вот эти три вопроса требуют вашего внимания».

На схеме есть обе программы. Даже обмен данными между ними предусмотрен. Но работа, благодаря которой руководитель получает понятную картину, происходит ещё и за их пределами.

Я бы посмотрел на этого сотрудника внимательнее.
Что именно он делает между выгрузкой и письмом?


Допустим, в одной таблице указана согласованная дата поставки, в другой — текущая ожидаемая. Их можно автоматически сравнить. Но сотрудник дополнительно знает, что по одному заказу клиент уже согласился подождать, по второму менеджер обещал найти замену, а третий связан с запуском нового объекта. Поэтому одинаковое расхождение в датах получает разный приоритет.

Его вклад в этом примере включает понимание ситуации, уточнение договорённостей и отбор вопросов, с которыми действительно должен разбираться руководитель. Всё это легко не заметить, если описать задачу словами «сводит таблицы».

Такую работу я рассматриваю как часть фактической системы движения информации в компании. Она может складываться из программ, сообщений, личных контактов и привычек, которые появились за годы. Через неё сведения приобретают объяснение и попадают к людям, способным что-то изменить.

В хорошо описанной архитектуре предприятия подобные связи тоже могут быть отражены. Но конкретная схема приложений и интеграций ещё не гарантирует, что они исследованы.

Есть соблазн сразу объявить всё происходящее в переписке хаосом и потребовать перенести в единую систему. Я бы не спешил. Возможность быстро связаться с коллегой и уточнить необычную ситуацию бывает очень полезной. Попытка заранее формализовать каждый разговор может только затруднить работу.

Меня здесь интересует вот какая зависимость: какая существенная часть результата держится на личной осведомлённости конкретного человека?
Если он уйдёт в отпуск, заместителю достанутся доступы и инструкция по выгрузке. Достанется ли понимание того, почему из тридцати расхождений руководителю отправили именно три?

При автоматизации легко воспроизвести видимое действие и потерять суждение, ради которого оно выполнялось.


Поэтому перед постановкой задачи AI я бы разобрал содержание этого короткого письма.
Откуда взялись пояснения?
Почему один вопрос признан срочным?
Какие сведения позволили исключить остальные?
Ответы покажут, что требуется сохранять и проверять, чтобы автоматизированный результат имел ту же практическую ценность.

Возможно, компании действительно нужна новая платформа. Но начать я бы предложил с одного человека, который, по общему мнению, «просто собирает информацию». Иногда именно в этой формулировке скрывается работа, без которой дорогие корпоративные системы так и останутся отдельными источниками данных.


Получил только что свой ORCID ID

Что это такое?

ORCID (Open Researcher and Contributor ID) — это уникальный цифровой идентификатор, который бесплатно выдается ученым и исследователям для связи их имени с результатами научной деятельности.Он выглядит как 16-значный номер (например, https://orcid.org) и выполняет роль своеобразного «номера паспорта» в международном научном сообществе.

Для чего он нужен:

- Различение авторов. Он решает проблему однофамильцев, смены фамилий или разных вариантов написания имени на латинице (например, Ivanov, Iwanow, Ivanoff).

- Автоматический учет публикаций. Позволяет легко собирать все свои статьи, монографии и гранты в едином профиле.

- Требование журналов и грантодателей. Большинство международных научных издательств и фондов требуют указывать ORCID при подаче статей или заявок на финансирование.

- Интеграция с научными базами. Синхронизируется со Scopus, Web of Science, Google Scholar и другими системами, автоматически связывая ваши достижения между ними.


В общем, теперь все мои статьи и исследования будут закреплены за этим ID. Эдакий «исследовательский ИНН» =)

Профиль, кстати, публичный и там скоро начнут появляться мои работы.


Video is unavailable for watching
Show in Telegram
Еще одна классная новость.

Цех теперь работает у меня не только на компьютере, но и в отдельном приложении на iPhone.

При этом это не две разные системы. На десктопе и телефоне доступен один и тот же рабочий контур: общие сессии, память, задачи, агенты и инструменты.

Можно начать большую задачу за компьютером, а потом продолжить её с телефона. Или наоборот: зафиксировать мысль на ходу, поставить задачу, проверить статус проекта, а к глубокой работе вернуться уже на десктопе. Контекст при этом не теряется, ничего не нужно пересылать самому себе или заново объяснять системе.

По сути, Цех перестал быть программой, привязанной к конкретному устройству. Теперь это постоянно доступная рабочая среда: компьютер нужен для вдумчивой и объёмной работы, а телефон позволяет оставаться в процессе, когда компьютера рядом нет.


Когнитивная архитектура бизнеса

Друзья, это самый важный для меня пост. Он делит на «до» и «после» все, что я делаю. Прошу вашего максимального внимания.

Последние несколько месяцев значительная часть моей работы была связана с одной темой, о которой я до сих пор публично почти не говорил. Сегодня хочу впервые зафиксировать её здесь.

Я разрабатываю подход, который назвал «Когнитивная архитектура бизнеса». У этой работы постепенно сформировались две связанные части: научный поиск и прикладная методология.

Отправная точка довольно простая.

Когда мы смотрим на компанию, мы обычно видим оргструктуру, процессы, должности и информационные системы. Меня же интересует другой слой:
как внутри компании информация превращается в выводы, решения и действия.


Что именно люди ищут, сопоставляют, интерпретируют и проверяют; где теряется контекст; как устроены реальные цепочки интеллектуальной работы; где нужны человеческое суждение, полномочия и ответственность — и как всё это меняется, когда частью системы становится искусственный интеллект.

В научной части я исследую, можно ли описывать такую работу через дополнительный уровень представления и даёт ли он что-то сверх уже существующих подходов.

Здесь я намеренно осторожен с выводами: у КАБ есть серьёзные научные предшественники, а предполагаемая оригинальность отдельных элементов и практическая ценность всей конструкции требуют дальнейшей сравнительной и эмпирической проверки.

В прикладной части задача конкретнее:
превратить этот взгляд в метод анализа и проектирования работы, позволяющий обоснованно определять, что должен делать человек, что AI, что обычная автоматизация, как должен быть устроен контроль и где должны проходить границы автономности и ответственности.


Дальше я буду постепенно раскрывать здесь отдельные идеи, наблюдения и некоторые элементы методологии без попытки уместить всю конструкцию в один пост.

Параллельно заканчиваю работу над учредительными статьями, в которых Когнитивная архитектура бизнеса будет описана уже системно: её исследовательская проблема, научные основания, гипотезы, единицы анализа, границы применимости, прикладной метод и программа дальнейшей проверки.
Скоро опубликую их отдельно.


Что на самом деле происходит между появлением информации и действием компании?

На совещании прозвучало: «Вся информация у нас была».
И сразу возникает неприятный вопрос: почему в таком случае компания ничего не сделала?

Проще всего предположить, что кто-то недосмотрел. Но мне кажется полезным сначала разобраться, в каком виде эта информация существовала и что ещё требовалось сделать, чтобы на её основании можно было действовать.

Представим сеть магазинов бытовой техники. В нескольких точках растёт число возвратов одной модели. Отдельные обращения зарегистрированы, сотрудники оформляют документы, покупателям возвращают деньги. На уровне каждой операции работа идёт.

Однако несколько возвратов ещё не объясняют происходящее. Возможно, модель просто стали больше продавать. Возможно, проблема связана с конкретной партией. А может быть, покупателям обещают функцию, которой у устройства нет.

Чтобы разобраться, кому-то нужно сопоставить обращения с объёмом продаж, посмотреть причины возвратов, проверить партии и прочитать, как товар описан на сайте. Здесь появляются первые содержательные выводы: отклонение действительно есть, оно сосредоточено в определённых магазинах, а жалобы похожи между собой.

Обратите внимание: компания уже знает больше, чем в начале. Хотя новых внешних сведений могло почти не появиться. Изменилось то, как были связаны и поняты имеющиеся данные.

Дальше выясняется, что в карточке товара неверно описана совместимость. Возникает рекомендация исправить описание и предупредить продавцов. Казалось бы, теперь всё очевидно.

Но аналитический вывод сам по себе не назначает исполнителя, не меняет приоритеты и не определяет, кто вправе временно остановить продвижение товара. Нужно, чтобы кто-то с соответствующими полномочиями принял решение, а затем работа действительно изменилась.

Для себя я разделяю эти моменты: сведения появились, ситуация стала понятнее, компания получила основание для действия, действие было разрешено и выполнено. Это удобный для меня способ разбирать происходящее. В реальности движение может быть куда сложнее: люди спорят о причинах, возвращаются за данными, принимают временные меры ещё до завершения проверки.

Именно поэтому фраза «информация у нас была» так мало объясняет. Обращения покупателей могли быть доступны всем заинтересованным сотрудникам. Но заключения о причинах возвратов ещё не существовало — его предстояло получить в ходе работы.

Доступ к сведениям не означает, что компания уже понимает их последствия.


Мне кажется, этот промежуток особенно важен при обсуждении искусственного интеллекта. Запрос «сделайте нам анализ обращений» может закончиться качественной сводкой, которая ни на что не влияет. Тогда стоит выяснить, какой конкретный вопрос она должна помочь решить и что произойдёт после получения ответа.

В нашем примере полезная задача для AI могла бы состоять в предварительном сопоставлении жалоб и выделении повторяющихся причин для проверки специалистом. Но качество такой работы нужно оценивать по тому, насколько верно она помогает разобраться в ситуации. Красиво написанного объяснения недостаточно: ошибочная версия причины способна направить всю последующую работу не туда.

И даже верная версия не устраняет остальных препятствий. Если никто не отвечает за исправление карточки товара, ещё один аналитический отчёт вряд ли изменит положение.

Я бы хотел, чтобы в разговорах об эффективности AI мы чаще доходили до этого места. Какой результат его работы должен появиться перед человеком, какое решение этот человек сможет принять и что после этого изменится для компании? На ответе «у нас будет больше аналитики» я бы пока не останавливался.


Бизнес запоминает принятые решения, но забывает почему их приняли..

У некоторых управленческих решений бывает удивительно длинная жизнь. Люди, которые их принимали, уже ушли. Обстоятельства изменились. А решение продолжает определять работу компании, потому что однажды стало правилом.

Допустим, в период нехватки денег руководитель ввёл дополнительное согласование закупок. Тогда это было вполне разумно: каждый крупный платёж приходилось сопоставлять с ближайшими поступлениями, и свобода отдельных подразделений могла поставить компанию в сложное положение.

Через несколько лет финансовая ситуация стабилизировалась, появились бюджеты и понятные лимиты. Но дополнительное согласование осталось. Теперь через него проходят стандартные закупки, которые уже укладываются во все утверждённые ограничения.

На вопрос «Зачем мы это делаем?» находится безупречный ответ: так распорядился генеральный директор.

Это объясняет происхождение правила. Но пока не объясняет его сегодняшнюю необходимость.

Мне кажется, здесь легко перепутать две разные вещи: память о принятом решении и память о рассуждении, которое к нему привело. Первая может прекрасно сохраняться в приказах, протоколах и регламентах. Со второй сложнее: часть аргументов прозвучала на совещании, часть была понятна участникам без пояснений, часть осталась в личной переписке.

В результате будущим сотрудникам достаётся предписание без условий его применимости. Они не знают, какую проблему оно решало и какое изменение обстоятельств позволило бы его пересмотреть. Самостоятельно отменять его рискованно, поэтому правило продолжает работать по инерции.

При этом было бы странно считать устаревшим любое старое решение. Возможно, то самое согласование теперь защищает компанию от другой существенной угрозы. Возможно, его отмена действительно принесёт больше проблем, чем экономии времени. Возраст правила сам по себе ничего не доказывает.

Но полезно уметь объяснить его необходимость сегодняшними обстоятельствами.


Поэтому в памяти компании мне хотелось бы видеть рядом с решением его основания: какую ситуацию мы рассматривали, на какие предположения опирались, почему отказались от альтернативы. Иногда одна фраза «вводим до восстановления платёжного резерва» спустя годы оказывается полезнее нескольких страниц протокола.

И здесь есть содержательная задача для AI:
помогать находить зафиксированные основания старых решений и сопоставлять их с новыми обстоятельствами.
Однако система должна различать найденный аргумент и правдоподобное объяснение, которое она построила сама. Если причина нигде не записана, убедительный рассказ о ней ещё не становится памятью компании.

Есть и человеческая сторона. Если запись сомнений впоследствии используется только для поиска виноватого, рассчитывать на честное сохранение логики решений трудно. Вместо неё будут появляться безопасные формулировки, по которым невозможно восстановить реальный выбор.

Попробуйте взять одно действующее правило, необходимость которого регулярно вызывает вопросы. Сможет ли компания объяснить, при каких условиях она согласилась бы его изменить? Возможно, именно этот ответ когда-то и потерялся.


Почему смысл теряется при передаче работы между людьми

Иногда мне кажется, что самая неприятная фраза в разборе ошибки рабочей коммуникации между сотрудниками - это «Я же всё верно передал».

Дело в том, что человек действительно мог передать всю информацию корректно. Заполнить заявку, приложить документ, поставить задачу, получить подтверждение. И всё равно следующий участник процесса примет решение, которое первый никогда бы не принял.

Представим простую ситуацию. Клиент согласовал замену оборудования на другую модель, но с условием, что она должна работать с уже установленной системой. Менеджер обсудил это с техническим специалистом, получил предварительное подтверждение и передал закупкам новую спецификацию.

В ней есть название модели, количество и цена. А условие совместимости осталось в переписке. Как и оговорка специалиста: «Должно подойти, но нужно проверить версию программного обеспечения».

Закупщик получает документ, который выглядит окончательным. Для него вопрос выбора уже решён, осталось разместить заказ. Через неделю оборудование приезжает, и выясняется, что без дополнительной доработки оно не заработает.

Здесь потерялась вполне конкретная вещь - предварительный вариант заявки по дороге превратился в утверждённый.

Сведения сохранились, а степень уверенности в них изменилась.


В процессе передачи заявки по цепочке, мы почти неизбежно сокращаем исходную ситуацию. Невозможно каждый раз пересказывать всю историю переговоров, все сомнения и все обсуждавшиеся варианты. Следующему человеку нужен материал, с которым он способен работать.

Но сокращаем мы его со своей позиции. Менеджеру после разговора со специалистом может казаться очевидным, что совместимость ещё предстоит проверить. Закупщик же самого разговора не слышал. Для него отсутствие оговорки вполне может означать отсутствие проблемы.

Так возникает разрыв: один человек передаёт то, что считает главным, а другому для его действия нужна подробность, которую первый счёл второстепенной.

Решение «давайте прикладывать всю переписку» выглядит естественным. Только тогда каждому следующему участнику придётся заново восстанавливать ситуацию из десятков сообщений. Формально контекст доступен, практически его ещё нужно найти и правильно понять.

Мне интереснее другой вопрос: какие условия должны обязательно соблюдаться, чтобы следующий человек не изменил смысл договорённости? В нашем примере достаточно сохранить статус предварительного выбора и необходимость проверки совместимости. Полная история переговоров для размещения заказа может и не понадобиться.

При проектировании AI-помощника я бы поставил задачу сохранять такие условия рядом с результатом: что подтверждено, что предполагается, что ещё требует проверки. Причём со ссылкой на исходное сообщение. Иначе автоматическое сокращение переписки может сделать ту же ошибку, только быстрее и аккуратнее по форме.

Поэтому при следующем разборе я бы задержался на фразе «Я всё передал». Что именно получил следующий человек: готовое решение, рабочую гипотезу или вариант с условиями? И совпадало ли его понимание с тем, что имел в виду отправитель?


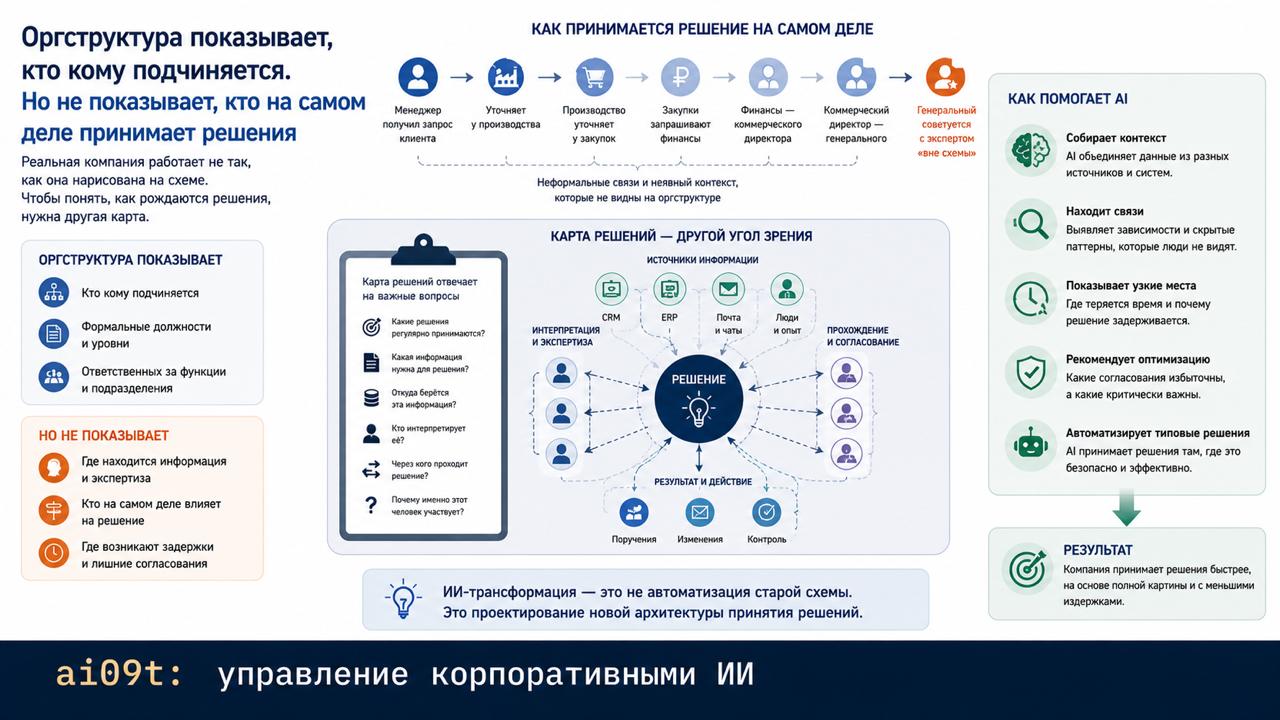
Оргструктура показывает, кто кому подчиняется. Но не показывает, кто на самом деле принимает решения

Когда мы хотим понять, как устроена компания, одним из первых документов обычно становится организационная структура.

Вот генеральный директор.

Под ним функциональные директора.

Дальше департаменты, управления, отделы.


Очень удобная схема.

Только есть проблема:

реальная компания работает совсем не так аккуратно, как она нарисована

Представим, что менеджеру нужно принять нестандартное решение по крупному клиенту.

По оргструктуре всё выглядит достаточно понятно.

Но в реальности:

Менеджер сначала звонит в производство.

Производство уточняет что-то у закупок.

Закупки спрашивают финансы.

Финансы отправляют вопрос коммерческому директору.

Тот обсуждает ситуацию с генеральным.

А генеральный перед окончательным решением звонит человеку, который формально вообще не участвует в этом процессе, но пятнадцать лет работает с данным клиентом и помнит три похожих случая.


И вот эта схема мне гораздо интереснее.

Потому что здесь начинает проявляться реальное устройство организации.

Мы видим, где находится информация.

У кого находится опыт.

Кому доверяют.

Кто способен интерпретировать ситуацию.

Кто имеет право принять решение.

Кому оно должно быть передано дальше.

Где возникает задержка.

Где требуется дополнительное согласование.

И что особенно интересно — часть этой структуры вообще нигде не записана.

Она просто сложилась за годы работы.

Поэтому мне кажется, что организационной структуры и даже традиционной карты бизнес-процессов иногда недостаточно, если мы действительно хотим понять, как работает компания.

Полезно попробовать нарисовать ещё одну карту.

Карту решений.

• Какие значимые решения регулярно принимает организация?
• Какая информация нужна для каждого из них?
• Откуда эта информация появляется?
• Кто её интерпретирует?
• Через кого проходит решение?
• Где необходима профессиональная экспертиза?
• Какие ситуации требуют эскалации?

И самое интересное: почему именно этот человек вообще участвует в принятии этого решения?

Последний вопрос может оказаться особенно полезным.

Потому что иногда ответ будет:

«Так исторически сложилось».

И вот здесь мы постепенно подходим к вопросу об искусственном интеллекте.

Если AI начинает участвовать в поиске информации, анализе, проверке, подготовке рекомендаций и в некоторых случаях в принятии типовых решений, недостаточно просто «добавить AI» в существующую организационную структуру.

Нужно понять, как после этого вообще должна выглядеть архитектура принятия решений.

• Какой контекст собирает машина.
• Что она может решить самостоятельно.
• Что должен проверить специалист.
• Какие случаи необходимо передать руководителю.
• И какие согласования после этого вообще перестают быть нужны.

Поэтому я всё меньше думаю об AI-трансформации как об автоматизации существующей компании.

Гораздо интереснее другой вопрос:

Как должна быть устроена компания, если часть интеллектуальной работы внутри неё теперь способен выполнять не только человек?

И подозреваю, что ответ на этот вопрос со временем изменит не только процессы.

Он изменит и сами организационные структуры.


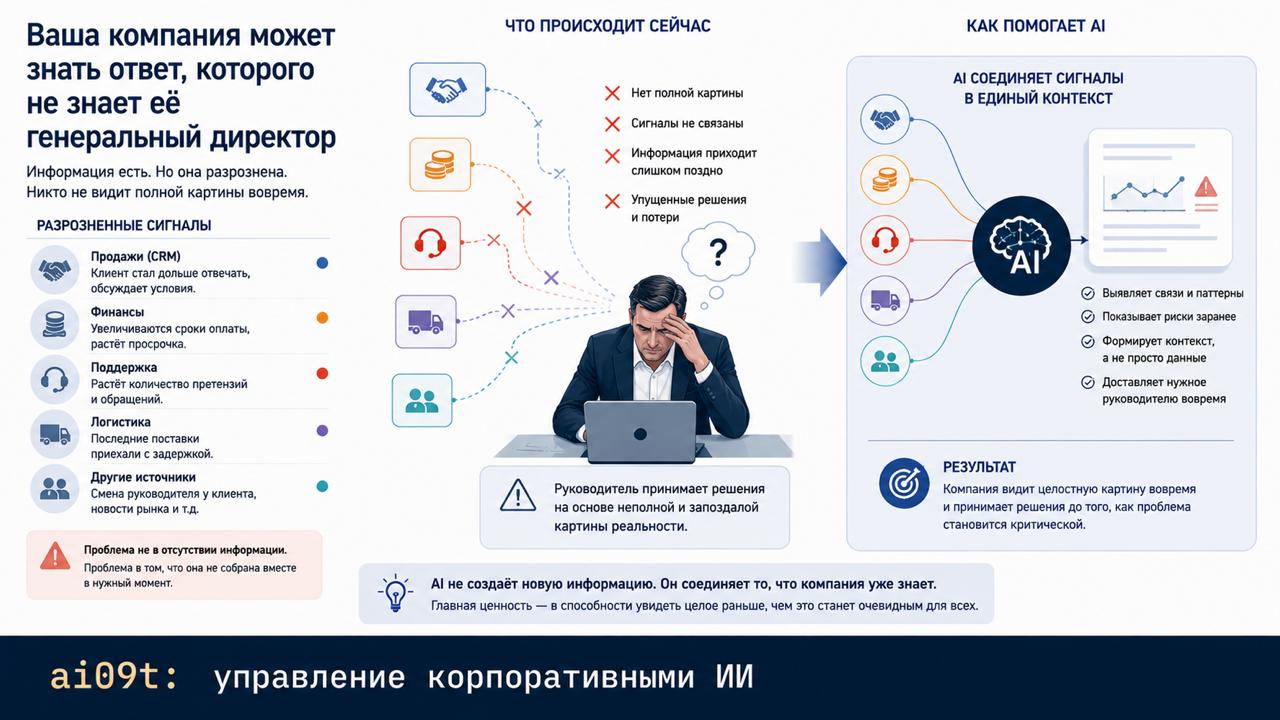
В вашей компании уже есть ответ на проблемную ситуацию. Просто никто не видит его целиком

Представьте достаточно обычную ситуацию.

У крупного клиента компании постепенно начинаются проблемы.

Менеджер по продажам замечает, что клиент стал дольше отвечать и неожиданно начал обсуждать условия, которые раньше его совершенно устраивали.

Финансовый отдел видит, что сроки оплаты понемногу увеличиваются.

Служба поддержки фиксирует рост количества претензий.

Логистика знает, что две последние поставки приехали с задержкой.

А кто-то из руководителей случайно слышал, что у клиента появился новый коммерческий директор.

Ничего из этого по отдельности не выглядит катастрофой.

Менеджер продолжает работать с клиентом.

Финансисты следят за дебиторкой.

Поддержка разбирается с обращениями.

Логистика решает свою проблему.

То есть каждый делает именно то, что должен.


Но если собрать все эти события вместе, картина может выглядеть совершенно иначе.

Возможно, компания прямо сейчас теряет одного из крупнейших клиентов.

И здесь возникает очень странная ситуация:

организация уже располагает информацией о проблеме, но сама ещё не знает, что проблема существует

Меня в последнее время вообще очень занимает это различие.

Есть огромная разница между тем, чтобы информация находилась внутри компании, и тем, чтобы компания что-то знала.

В крупном бизнесе практически любое значимое событие оставляет множество следов.

Что-то происходит в CRM.

Что-то — в финансовой системе.

Что-то обсуждается по электронной почте.

Что-то попадает в службу поддержки.

Что-то замечает конкретный сотрудник.

Каждая система и каждый человек видят небольшой кусочек происходящего.

Но реальность клиента, поставщика, проекта или рынка не разделена на ваши департаменты.

Это мы разделили компанию на продажи, финансы, маркетинг, юридический отдел и логистику.

Событие же происходит сразу целиком.

И поэтому иногда для правильного решения нужно соединить информацию, которая организационно вообще принадлежит разным людям.

Традиционно мы решаем эту проблему людьми.

• Совещаниями.
• Отчётами.
• Аналитиками.

Руководителями, которые должны собирать информацию от нескольких подразделений.

И всё это работает.

Но чем больше становится компания, тем тяжелее поддерживать такую связность вручную.

И здесь мне особенно интересен искусственный интеллект.

Потому что, возможно, одна из его наиболее ценных функций внутри крупной организации — вообще ничего нового не создавать.

• Не писать.
• Не рисовать.
• Не генерировать.

А постоянно сопоставлять то, что компания уже знает.

Увидеть, что изменение поведения клиента в CRM совпало с ростом просрочки, увеличением количества претензий и сменой руководителя на стороне клиента.

И не принять за человека решение, а сказать:

«Посмотрите сюда. Возможно, эти четыре события связаны».

По сути, речь идёт о способности компании превращать огромное количество распределённых сигналов в осмысленный контекст.

И мне кажется, это будет одним из важных направлений развития корпоративных AI-систем.

Потому что крупному бизнесу далеко не всегда нужно ещё больше информации.

Информации у него обычно и так предостаточно.

Иногда ему гораздо нужнее научиться вовремя понимать то, что он уже знает.


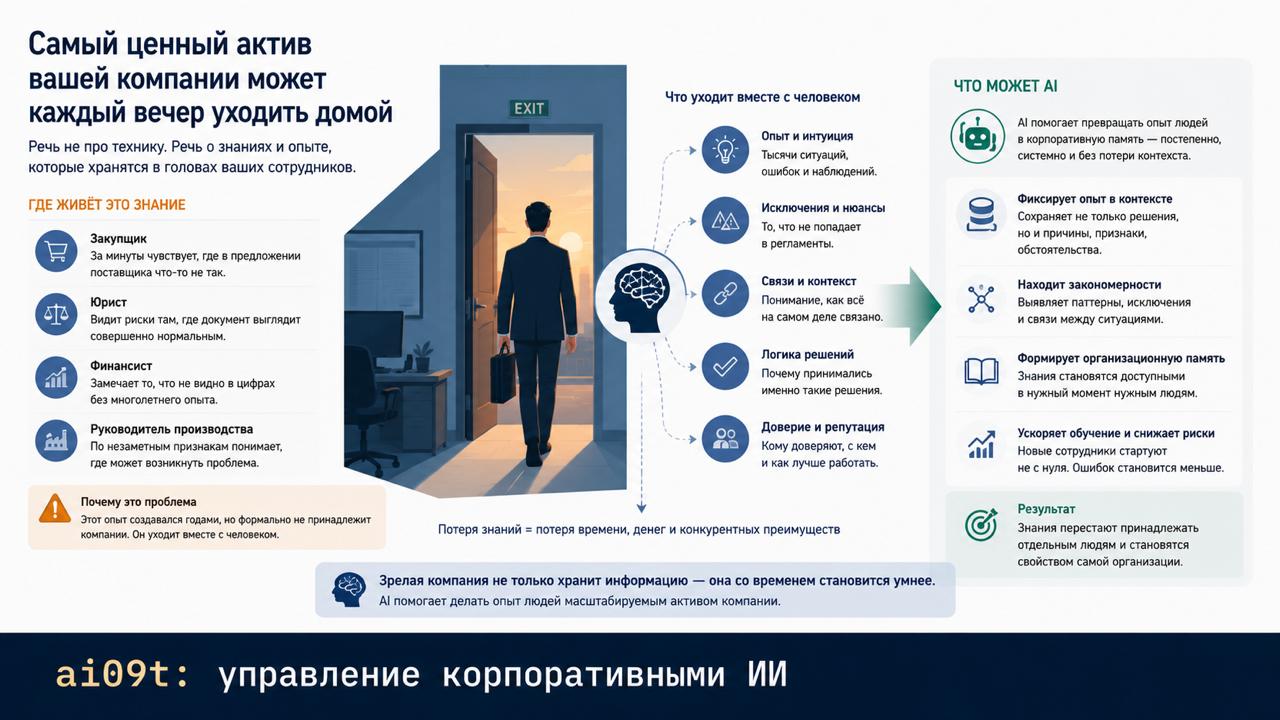
Самый ценный актив вашей компании каждый вечер уходит домой

Есть фраза, которую я бы очень не хотел услышать от руководителя крупной компании:

«Это знает только Иван Иванович».

Причём чем важнее вопрос, тем сильнее меня бы эта фраза настораживает.

Практически в любом давно работающем бизнесе есть такие люди.

Опытный закупщик смотрит на коммерческое предложение и практически сразу замечает что-то подозрительное.

Юрист читает совершенно нормальный на первый взгляд договор и почему-то останавливается на одном конкретном пункте.

Финансист видит отчёт и задаёт вопрос к цифре, мимо которой десять других людей спокойно прошли.

Руководитель производства по нескольким совершенно незначительным признакам понимает, что через неделю может возникнуть проблема.


Если спросить такого человека, как именно он это понял, ответ иногда будет довольно невнятным:

«Ну, я просто это вижу».

И это «просто вижу» на самом деле может стоить компании огромных денег, ведь за ним находятся:
- годы опыта,
- сотни похожих ситуаций,
- ошибки, которые человек когда-то совершил,
- исключения, с которыми столкнулся,
- признаки, которые научился замечать,
- связи, которые для новичка вообще не существуют.

Формально этот опыт создавался внутри компании. Компания платила зарплату. Предоставляла проекты. Получала и переживала ошибки. Накапливала клиентскую и отраслевую историю.

Но есть одна неприятная деталь.

Значительная часть полученного знания может так и не стать знанием самой компании. Она остаётся знанием конкретного человека и каждый вечер вместе с ним уходит домой.

Мне кажется, мы вообще несколько упрощённо понимаем корпоративные знания.

Обычно разговор быстро приходит к базе знаний.

Давайте всё задокументируем. Напишем регламенты. Соберём инструкции. Сохраним документы.

Это безусловно полезно, но документ и знание — далеко не одно и то же.

Можно записать, как проводится проверка поставщика. Гораздо сложнее записать, почему опытный закупщик в одном из ста случаев решает проверить что-то дополнительно.

Можно сохранить тысячу договоров, но это ещё не означает, что компания сохранила знания юриста о том, какие комбинации условий когда-то привели к проблемам.

Можно сохранить решения совета директоров, но потерять причины, сомнения, альтернативы и обстоятельства, при которых эти решения принимались.


И именно здесь, на мой взгляд, появляется одна из гораздо более интересных возможностей искусственного интеллекта, чем привычная автоматизация.

Мы постепенно получаем техническую возможность сохранять не только документы, но и часть контекста вокруг человеческой работы.
- Почему сотрудник обратил внимание именно на это.
- Какие признаки использовал.
- С чем сравнивал.
- Какие исключения встречались раньше.
- Какое решение было принято.
- Почему было принято именно оно.
- Что произошло после.

Конечно, далеко не всё человеческое знание можно взять и выгрузить из головы в компьютер. Профессиональная интуиция устроена значительно сложнее, но нам и не обязательно сразу пытаться сохранить всё.

Даже если компания научится систематически удерживать значительно большую часть опыта своих сотрудников, это уже меняет ситуацию.

Потому что тогда каждый следующий человек начинает работу не практически с нуля, а поверх накопленного опыта организации.

И вот это для меня один из наиболее интересных признаков действительно зрелого внедрения AI.

Не только сотрудники становятся производительнее благодаря искусственному интеллекту.

Сама компания постепенно учится на собственной работе.

- Она лучше помнит, что происходило.
- Почему происходило.
- Какие решения оказались правильными.
- Где ошиблась.
- Какие признаки однажды уже предупреждали о проблеме.

И в какой-то момент опыт перестаёт принадлежать исключительно тем людям, которым довелось лично его получить.
Он начинает становиться свойством самой организации.


Ну что, кто уже успел астру попробовать? Новую модель от OpenAI.. я готов уже на дорогой тариф вкинуться)


Почему совершенно разные профессии иногда делают одну и ту же работу

Я раньше довольно естественно воспринимал профессию как определённый вид работы.

Финансист работает с финансами. Маркетолог — с маркетингом. Специалист технической поддержки — с техническими проблемами. Специалист по качеству — с качеством продукции.

Вроде бы все очевидно.

Но чем больше я разбираю реальную работу людей на то, что конкретно они делают в течение дня, тем меньше мне нравится такое представление.

Возьмём, например, финансового контролёра. Если посмотреть на его должность со стороны, можно сказать, что человек занимается контролем финансовых операций.

Но что это означает на уровне конкретной работы?

В течение дня он может искать информацию в нескольких системах, проверять документы, сопоставлять цифры из разных источников, искать отклонения и пытаться понять их причины, собирать данные в общую картину, оценивать риски, готовить отчёт, отвечать на вопросы руководителя и подготавливать информацию для принятия решений.

И вот в чем тут вопрос: Какая именно из этих работ является уникально «финансовой»?

Сами цифры, правила, показатели, знания о бизнесе — безусловно. Но многие действия над информацией — нет.

Например, финансовый контролёр замечает неожиданное изменение расходов и начинает разбираться, что произошло.
Специалист технической поддержки видит необычное поведение системы и тоже пытается понять, что произошло.
Специалист по качеству обнаруживает отклонение показателя и выясняет, почему оно возникло.
Маркетинговый аналитик видит внезапное падение конверсии и начинает искать причину.

Один работает с деньгами.
Другой — с программной системой.
Третий — с производством.
Четвёртый — с маркетинговыми показателями.


Это совершенно разные профессии. Для каждой нужны свои знания, опыт, критерии и понимание предметной области.
Но в какой-то части своей работы все четверо делают очень похожую вещь:

Замечают отклонение, собирают контекст, пытаются понять, что изменилось, проверяют возможные объяснения и готовят вывод.

И это касается далеко не только поиска отклонений. Поиск нужной информации встречается в огромном количестве профессий. Сопоставление факта с требованиями — тоже.

Проверка >
классификация >
сведение большого количества информации в короткий вывод >
оценка по определённым критериям >
подготовка первого варианта документа, отчёта или решения.

Получается довольно любопытная картина.

Мы привыкли воспринимать профессию почти как монолит. Есть финансист, аналитик, специалист поддержки, закупщик, маркетолог, но если посмотреть внутрь их реальной работы, каждый такой монолит начинает рассыпаться на множество разных видов интеллектуальных действий. Причём часть этих действий снова обнаруживается в других профессиях.

Тогда профессию можно попробовать представить немного иначе, как определённую комбинацию разных видов работы, предметных знаний, контекста, критериев, опыта и ответственности.

Комбинация у финансового контролёра одна.
У маркетингового аналитика — другая.
У специалиста технической поддержки — третья.

Именно поэтому они не становятся взаимозаменяемыми только потому, что часть их работы устроена похожим образом.

Но для искусственного интеллекта здесь возникает очень интересное следствие.

Допустим, машина становится значительно лучше в поиске нужной информации. Эта способность начинает влиять на работу десятков совершенно разных специалистов, внутри профессий которых есть поиск информации.

То же самое происходит со способностью извлекать данные из документов.
Сопоставлять информацию.
Находить отклонения.
Сводить большой объём материала в короткий результат.
Готовить первый осмысленный вариант документа.
Оценивать объект по достаточно хорошо заданным критериям.

То есть искусственный интеллект не обязательно входит в компанию по границам профессий.
Он может входить сразу в десятки профессий через отдельные виды интеллектуальной работы, которые в них повторяются.


Video is unavailable for watching
Show in Telegram


Работа над собственной методологией сильно прокачивает в многих отношениях.

В частности, я осознаю как формируется инструментарий и кнтекст нового взгляда на предмет и объект моей работы.

Такое ощущение, что ты раньше наблюдал за процессами в компании и, хоть и казалось, что ты их понимаешь, но понимал, что ты чего-то важного не видишь. Что-то ключевое упускаешь.

А теперь, когда формируется методология, инструменты анализа, язык описания, у тебя словно глаза раскрываются. Волшебное ощущение.

Да и сам целостнее становишься, перестает швырять от темы к теме..

субботние инсайты

20 last posts shown.