


🌟 Tencent HPC-Ops: решение, которое выжмет максимум из H100 и H200.
Продакшен больших моделей — штука дорогая и в таких масштабах реально бьются за каждый процент скорости.
Tencent Hunyuan AI Infra выложила в открытый доступ HPC-Ops - рабочую библиотеку, на которой, в том числе, крутится их собственная инфраструктура.
Разработчики решили не латать старое, а переписали все с нуля на чистой CUDA и CuTe специально под архитектуру Hopper.
И это логично: популярные решения вроде vLLM или дефолтного FlashAttention часто не до конца утилизируют возможности железа. В HPC-Ops же целью была максимальная загрузка GPU.
Внутри есть все, что нужно для сборки серьезного инференса: оптимизированные ядра внимания с paged attention, квантованный Grouped GEMM с поддержкой FP8 и блочным скейлингом, Fused MoE и инструменты связи нод для распределенных систем.
На своих моделях с HPC-Ops у Tencent пропускная способность выросла на 30%, а для DeepSeek на 17%. Но интереснее всего дела обстоят с H20: там библиотека бустит ускорение до 2.22x по сравнению с тем, что было раньше.
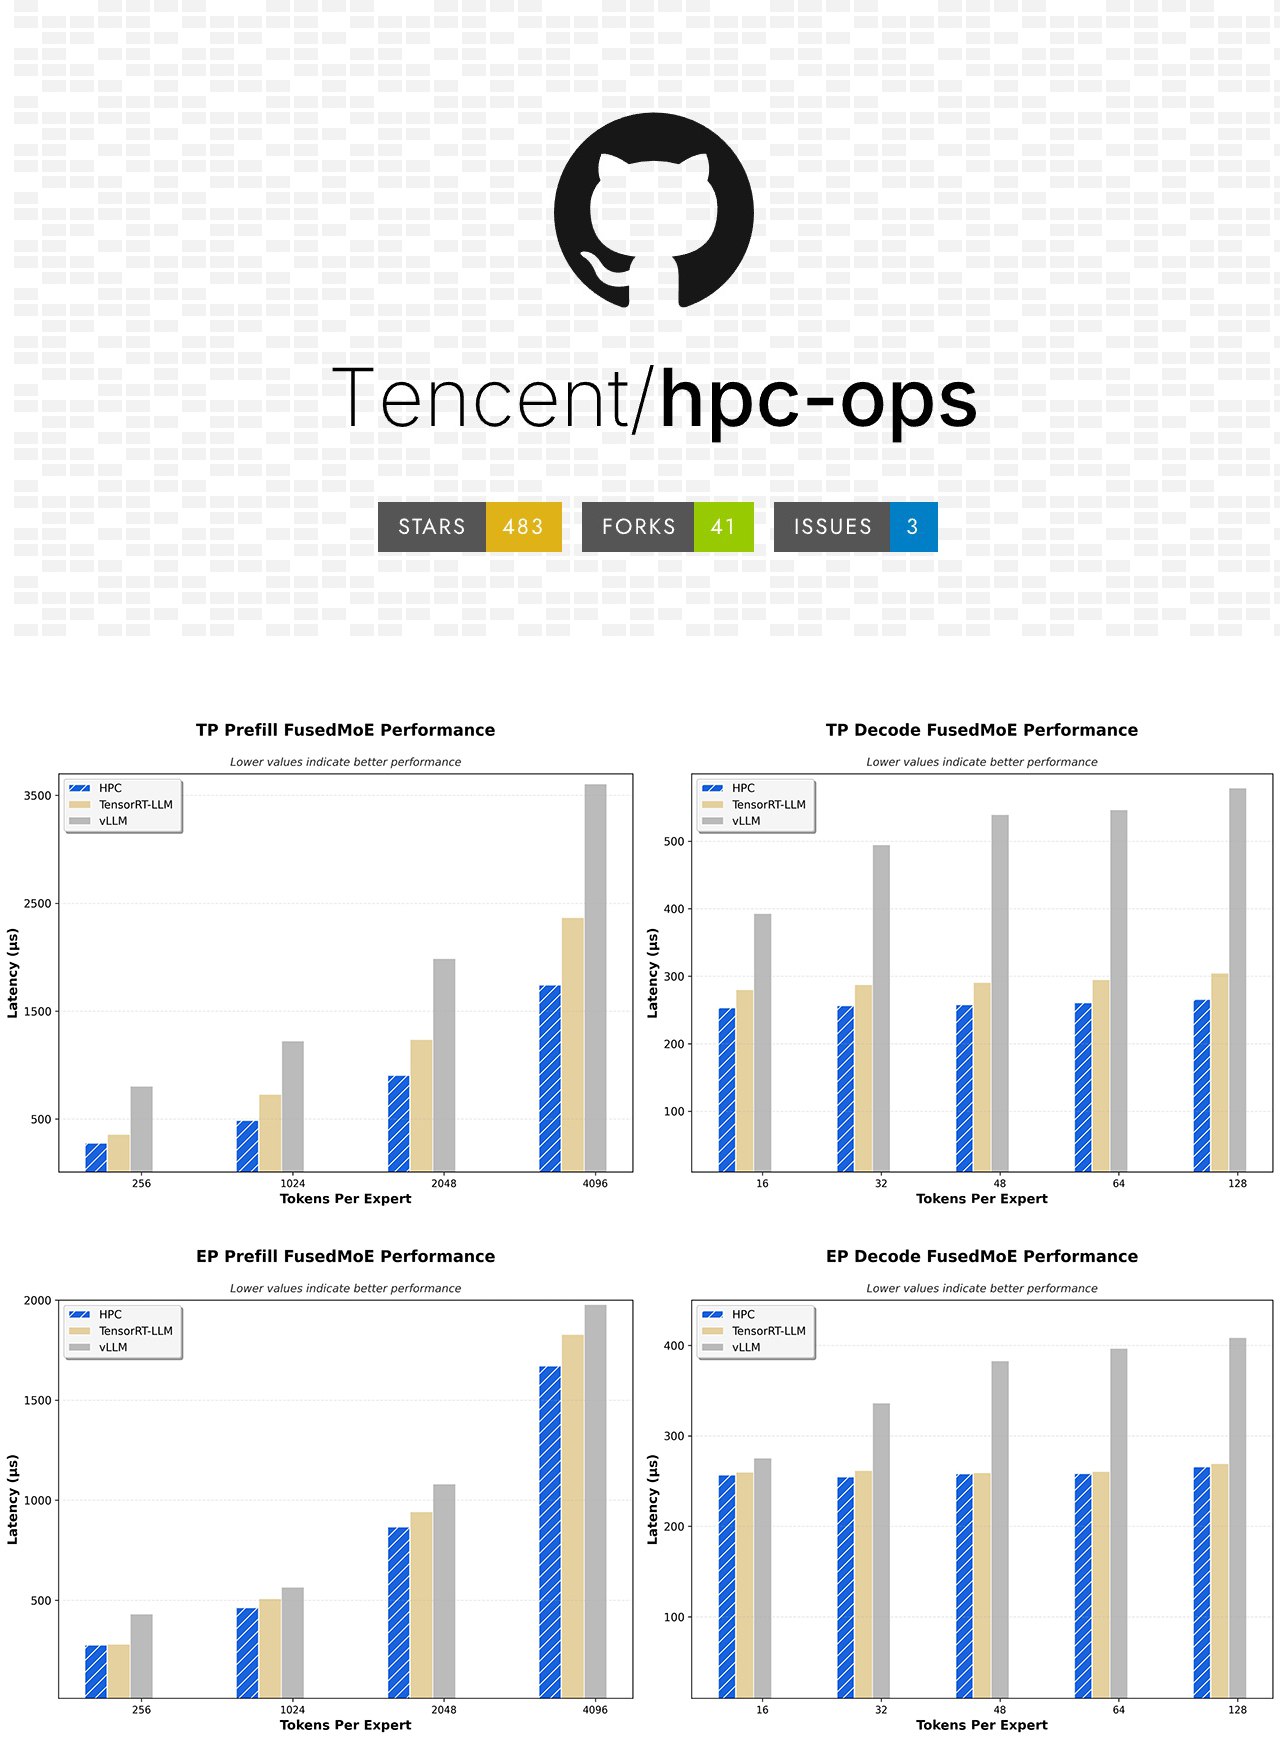
Если закопаться в цифры, то самый большой прирост на декодинге. Механизм внимания в BF16 на декоде работает в 2.2 раза быстрее, чем связка из FlashInfer, FlashAttention и TensorRT-LLM.
На префилле профит поменьше — около 1.33x, но это тоже очень ощутимо.
С FP8 история похожая: ускорение в 2 раза на декодинге и небольшие, но приятные 12% на префилле. Тот же FusedMoE в FP8 прибавляет почти 50% скорости в режиме префилла.
HPC-Ops дружелюбен к vLLM и SGLang, но имейте в виду, что старое железо тут не поддерживается, это инструмент для карт SM90.
В планах на будущее:
🟢sparse attention;
🟢поддержка 4-битного квантования;
🟢новые ядра, которые будут схлопывать вычисления и передачу данных между GPU.
Если вы сейчас оптимизируете инференс на Хопперах и боретесь за каждый токен в секунду эту штуку стоит как минимум потестить.
📌Лицензирование: MIT License.
🖥GitHub
@ai_machinelearning_big_data
#AI #ML #LLM #HPCOps #Tencent