asisakov


Channel's geo and language: Russia, Russian
Category: Technologies


Канал про Python, Data Science, SQL, AI, vibecoding, промпты, карьеру, собеседования и немного про жизнь в IT
По вопросам сотрудничества: @asisakov
Чат: https://t.me/asisakov_chat

Related channels  |  Similar channels
Channel's geo and language
Russia, Russian
Statistics
Posts filter


SONA > ARGUS

Кажется совсем немного времени прошло с анонса Аргуса со всеми его возможностями, а оказалось уже прошло почти полтора года!

А на днях произошло интересное - коллеги из Яндекса выкатили Sona, собственную генеративную модель, которая берет на себя весь цикл подготовки рекомендаций, начиная с подбора кандидатов из миллионов вариантов до их ранжирования.

В недельном A/B-тесте на Моей волне в умных колонках с Алисой Sona заменила действующий рекомендательный каскад, включая ARGUS. В тестовой группе время прослушивания выросло на 6,3%, количество просьб повторить трек - почти на 18%, а аудитория активных слушателей - на 4,5%.

Прирост последней метрики оказался в 2,4 раза больше, чем от предыдущего внедрения ARGUS на этой же поверхности!

Удивительно, как мы быстро движемся к новым парадигмам. Все привыкли, что рекомендации готовит целый конвейер моделей. В Моей волне только на этапе подбора кандидатов работали 15 основных и несколько вспомогательных моделей. Дальше очевидно предранжирование и ранжирование с сотнями признаков. Новый подход в Sona позволил заменить весь этот каскад одной нейросетью и при этом улучшить результаты. Например, модель не требует ручного подбора сотен признаков: полезные закономерности она учится находить в истории действий пользователя: прослушиваниях, пропусках, лайках и возвращениях к трекам.

На открытых публикациях подобных моделей в рекомендациях нет, и Sona стала первой в мире моделью, которая одновременно заменяет весь рекомендательный каскад и ручные признаки одной нейросетью end-to-end.

Ждем, когда прогнозные модели станут такими же!

По архитектуре:

▫️Общий энкодер один раз обрабатывает историю пользователя, а получившееся представление используют и декодер, предлагающий кандидатов, и модуль ранжирования, определяющий их порядок. Обе задачи совместно обучают энкодер.

▫️Треки заранее получают короткие коды, учитывающие аудио, метаданные и закономерности прослушивания. По истории пользователя Sona последовательно генерирует элементы таких кодов, а система сопоставляет их с композициями в каталоге. Модель генерирует рекомендации на существующую музыку.

▫️Большой ранжировщик, обученный на данных за год, оценивает кандидатов, а Sona учится воспроизводить его оценки. Учитель используется при обучении; в финальной выдаче подбор и ранжирование выполняет сама Sona.

▫️Модель учитывает до 8192 событий, глубже обрабатывая последние 2048. Это помогает сохранить информацию о давних предпочтениях и уделить больше вычислений свежим действиям.

ARGUS усиливал существующую каскадную систему рекомендаций. Sona продолжает его идеи, но в эксперименте заменила и ARGUS, и остальные модели каскада

Sona протестирована на Моей волне на устройствах с Алисой и пока не раскатана на весь трафик. Продолжаются долгосрочный эксперимент и тестирование других сценариев Музыки - и по их результатам будут принимать решение о дальнейшем внедрении.

Легендам из R&D рекомендации, Яндекс Музыки, команды Алисы привет💪🏿

Техрепорт тут

#recommender


Вот такой красивый закат был сегодня в Москве


Попался на эту петлю гэмблинга!

Но в реале все было плаченвнее, Grok 4.6 решил, что у нас бесконечное число сабмитов, и за 13 часов до конца соревы начал пушить BC + PPO, все недоученные! Ох как я сгорел, ох как я сгорел 🔥🔥🔥

Сижу в одном рейтинге с сабмитами недельной давности!

Фул резы и разборы пока не подъехали, но я поделюсь с вами несколькими реализациями BC + PPO! Именно эта методика работы с агентом должны была затащить в золото!

Ну или агентом перебирать разные алгоритмы

Ну и те самые ссылочки:

1. https://github.com/TianciGao/PPO-BC
2. https://github.com/vvsuby/sts2-rl-agent
3. https://github.com/welry9277/mini-RL

Эх, получился бы уже рабочий вариант, я не знаю, но уверен, что Грока надо наругать😴

#competition


Так, тут в той самой сореве Kaggriculture какой-то максимально жесткий движ и более 10к участников, а я со своими сабмитами отдыхаю внизу. Там типа вы с соперником фермеры, у каждого свой участок, и надо заработать больше денег, чем у соперника! Ну и дальше идет огромный простор вариаций игр, решений и параметров для управления

Вы сами посмотрите цифры

21,331 Entrants
11,379 Participants
10,174 Teams
19,438 Submissions


Интересно, что я предполагал, что это будет жесткой оптимизацией и подсчетом оптимальных путей, но все потихоньку начало превращаться в RL. В каждой 3-4 дискуссии уже буквально прямым текстом написано про RL. Вот тут например чел завел PPO и рассказывает про это. Лично мне с другой стороны понравился ноутбук от чела, где он рассказывает про математическую формализацию задачи. Короче, выиграть уже надежды нет, но блин какая это интересная сорева - интересно, что будет по итогам?

По крайней мере приложу интересные ссылочки!

#competition


Гермес, Пи или Уроборос

Пару дней назад не выдержал и удалил Гермеса. Все же слишком друноват для меня промпт и суммаризации показались. Хотя я последний месяц не обновлялся, мб они там все пофиксили, но я что-то не выдержал уже его тупизны после того, как он хоть 1 раз попробует сделать суммаризацию.

▫️Сейчас думаю перелезть на Pi агента - знаю, что многие его юзают
▫️А есть еще Уроборос от Антона (вот его выступление на PML Conf - вот мой кружок оттуда)

Пока раздумываю, что затестить, решил еще поставить Herdr (Orca уже удалил, даже не стал толком тестить ее)

Так и живем с агентами. У кого есть что из интересного потестить? Либо делитесь своими сетапами в комментариях💪

#agents

957 0 8 12 14


🇬🇧 Английский, который хочется не просто учить, а действительно использовать
Если вы давно собирались подтянуть английский, но постоянно откладывали — возможно, пришло время начать.
В ARNOVA SCHOOL можно заниматься английским онлайн с преподавателями с профильным образованием и большим опытом преподавания.
Здесь есть программы для разных целей и уровней:
• 🇬🇧 общий английский — от Elementary до Advanced;
• 🗣️ курс по современному британскому произношению;
• 📚 грамматика английского языка от А2 до B2+;
• 👩‍🏫 отдельные программы для преподавателей английского.
Занятия проходят онлайн, а обучение построено на системном подходе: объяснение материала, практика, домашние задания и обратная связь от преподавателя.
А ещё школа имеет образовательную лицензию, а после обучения предусмотрены документы об окончании курса.
Если хотите наконец разобраться с английским и заниматься системно — посмотрите программы ARNOVA SCHOOL:
👉 https://arnovaschool.com/


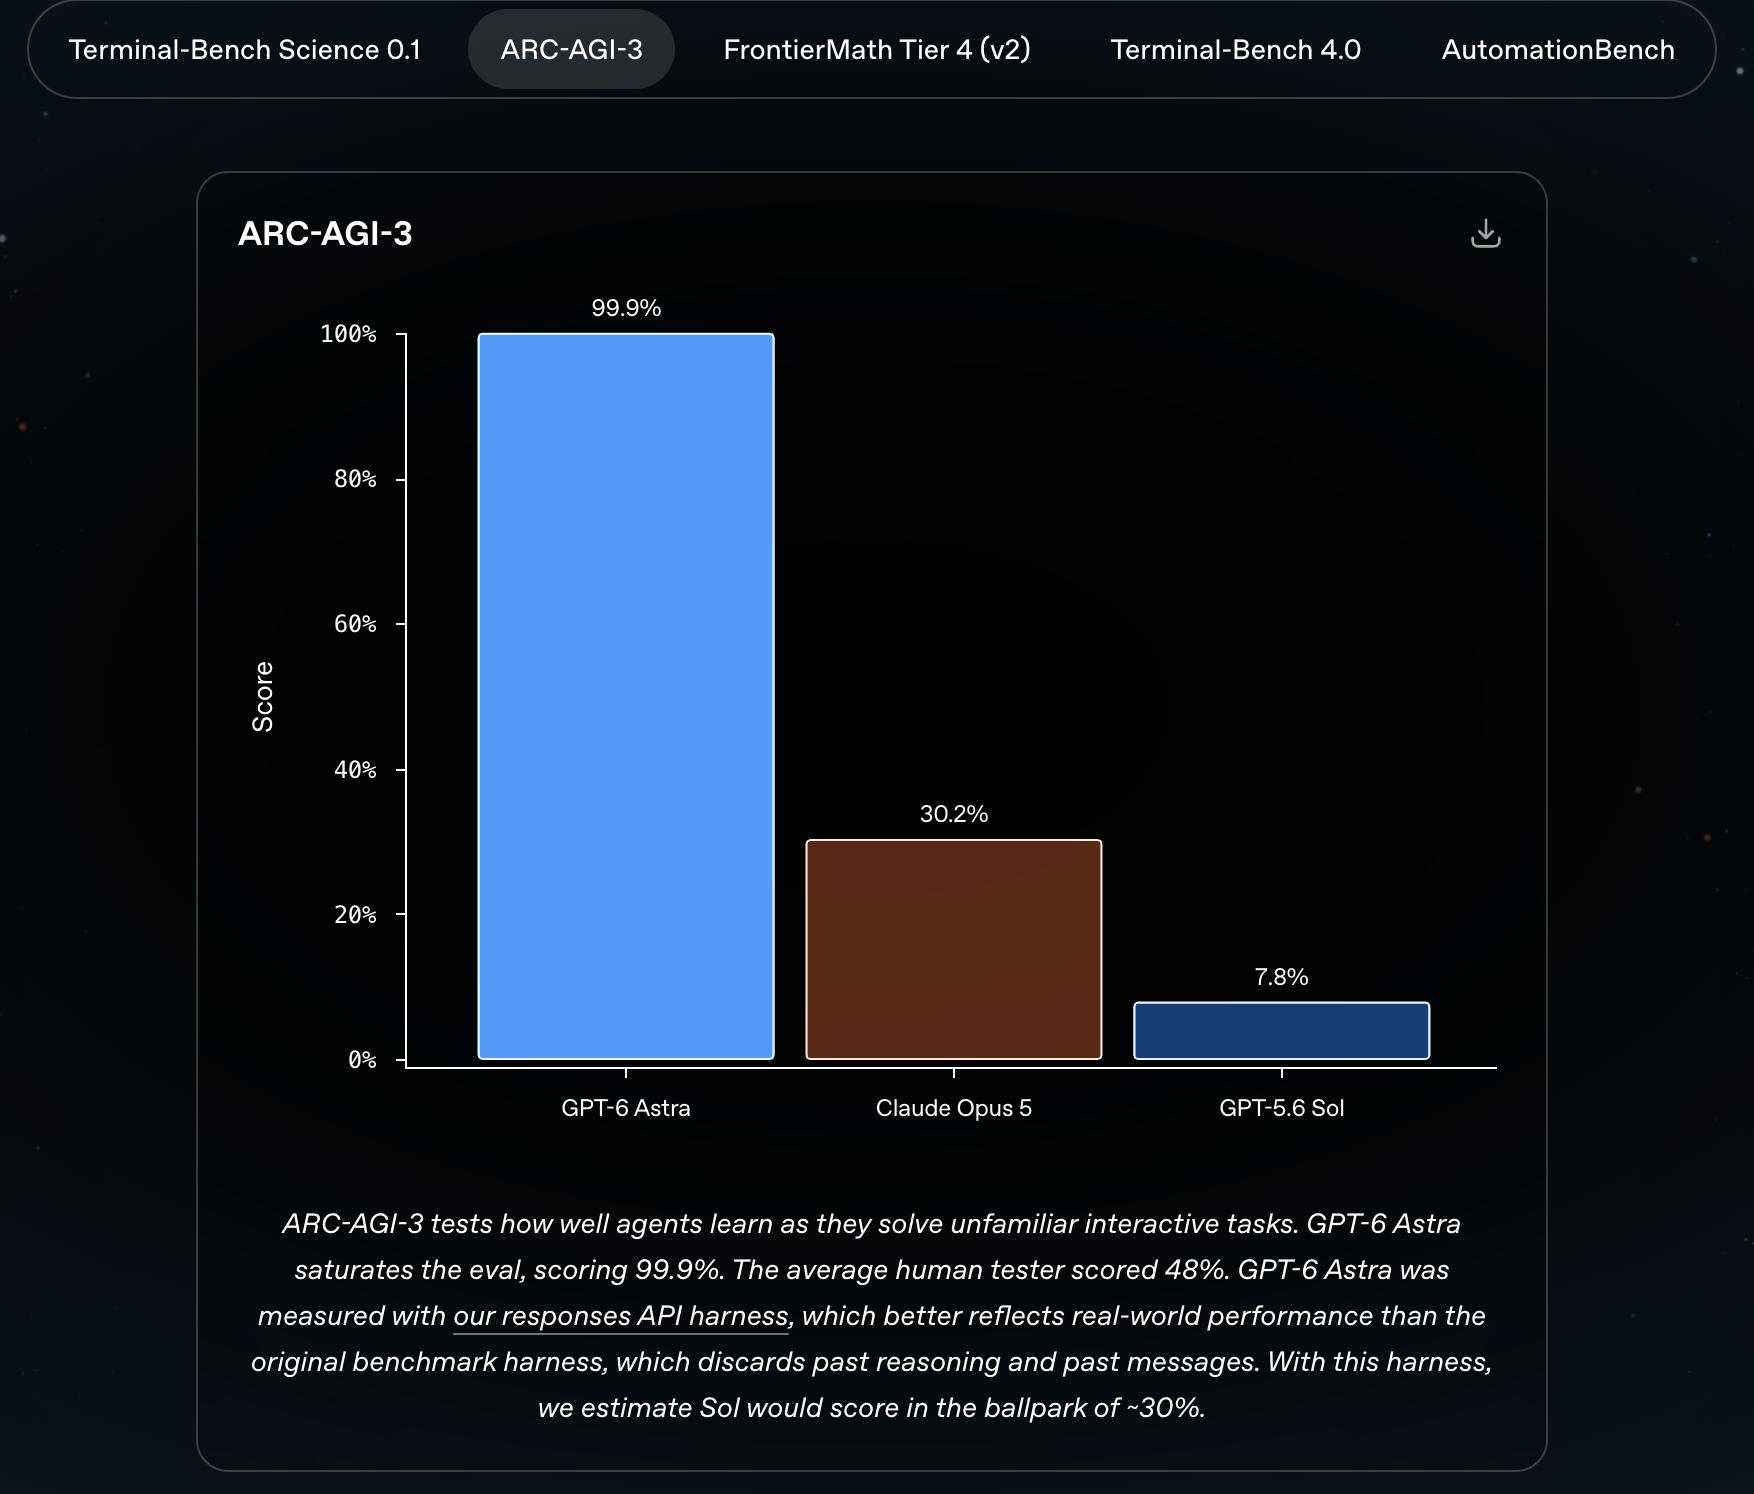
Оказывается недавно вышел Opus 5.5, который типа догоняет Fable 5.1, и при этом дешевле на 40% Opus’а 5, на котором я в основном и сидел.

При этом за пару дней читал в чатиках, как пацаны плевались от отупевшего Клода. Кстати, какой-то насыщенный месяц на запуски вышел. И Астра от КлозедАИ, и сам Фейбл 5.1 от Антропика того же, ну и конечно опенсурс МоЕ Яндексовый наш💪🏿

Кстати, видимо парни из Анторопика распарсили, что с такой эффективностью я точно смогу добить мой секретный отложенный проект, и потому забанили меня😹

Ну и надеюсь, что на фоне этих новостей Сама откроет уже снова $200 подписку, ато у многих есть потребность💪🏿

#llm


Таки вы не Исаков, а Исааков 😏
Шекели жалко


Недавно во второй раз забанили в Клоде, было очень обидно за свою $20 подписку 😭
P.S. При втором бане писал аппеляцию на Иврите, но это не помогло ☔️

#life


Как называется техника в обучении с подкреплением, при которой вместо того, чтобы напрямую максимизировать ожидаемую награду, алгоритм ограничивает размер шага обновления политики через дивергенцию между старой и новой политикой (предшественник PPO)
Poll
  •   GRPO
  •   DPO
  •   TRPO
  •   RLHF
  •   REINFORCE
  •   LOLPO
60 votes


Дайте мне повод сжечь токены, и я сделаю это!

#meme


Аналитик из Wildberries

Существует легенда, что ни один ML-инженер не шарит так сильно в SQL, как аналитики!

А Дмитрий, автор канала «Дима SQL-ит», решил пойти ещё дальше и показать, что в SQL есть куда копать даже тем, кто уже уверенно с ним работает 😺

Дима работает аналитиком данных в Wildberries и публикует много теории и кейсов из практики — всё структурированно и по делу 🤝

Что рекомендую посмотреть в первую очередь:

🟡Подборки бесплатных материалов для изучения: SQL, Python, BI (дашборды), статистики и A/B тестов
🟡Как агрегатные функции в SQL (SUM, AVG, COUNT) ведут себя с NULL?
🟡SQL-ловушка: почему NOT IN ломается, а EXISTS работает — классическая проблема с NULL, на которую часто натыкаются
🟡Горячие клавиши в DBeaver, Jupyter и VS Code — семь комбинаций, которыми Дима пользуется каждый день
🟡Telegram-бот, который шлёт сообщение, когда скрипт завершился
🟡Разбор задач в Т-банк, Магнит OMNI, Авито и другие компании.....
🟡Простые разборы статистики и теории вероятностей: P-value, Формула Байеса и других тем


➡️ Подписывайтесь, чтобы не потерять: @dima_sqlit


Что случилось

Яндекс выложил в открытый доступ базовую LLM, обученную с нуля. Это AliceAI-Foundation-80B-A3B-Base - базовая ллм моделька под лицензией Apache 2.0. И это первая большая LLM Яндекса, обученная полностью с нуля, без инициализации из весов других моделей! (предыдущая Alice AI LLM 235B стартовала с весов Qwen3-235B-A22B)

🔖Эта модель - MoE Transformer на 80B параметров, из которых 3B активных. Состоит из 48 трансформерных блоков с hidden size 2048 и одного multi‑token prediction слоя. Каждый MoE‑слой содержит 512 routed experts с top‑k 10 и один shared expert. А для роутинга используется auxiliary‑loss‑free подход из DeepSeek‑V3. Из 48 attention‑слоёв 36 используют Kimi Delta Attention, а 12 full attention: после каждых трёх KDA‑слоёв расположен один full‑attention‑слой. Для агрегации представлений по глубине используется Attention Residuals (AttnRes), заменяющий обычное суммирование обучаемым взвешиванием.

На 8 из 10 бенчмарков фактологических знаний и экспертных навыков модель занимает первое место среди сравниваемых открытых претрейнов, и особенно сильна в задачах про Россию и русский язык. особенно круто, что работу с инструментами ребята заложили уже срзау в претрейн, потому что сильного reasoning без tool-use недостаточно для агентов. Напомню, что это базовая модель до посттрейна, и поэтому сравнивать напрямую с готовыми ChatGPT, Claude или Gemini некорректно. У нее еще нет ни инстракт SFT, ни полноценного RL.

Для обучения команда фактически пересобрала весь процесс обучения, начиная с корпуса данных и архитектуры до собственных scaling laws. Этапы претрейна состоят из 4-ех стадий, и их можно будет увидеть в таблице во вложении. Для построения же scaling laws брали модели на 5B и 10B параметров, обучали на 100–600B токенов с оптимизатором Muon и линейным scheduler.

Что интересного - первый запуск с предсказанным LR привёл к росту MoE-активаций и резкому скачку loss. Ребята воспроизвели проблему на небольшой модели и после стабилизации активаций вернулись к исходному прогнозу. Также была и еще одна интересность: конфигурация с меньшим batch size (8M, lr 5,5e-4) обошла большую (16M, lr 7,8e-4) в среднем на 0,46 п. п., причём улучшения были на 10 из 59 бенчмарков.

Кстати, по бенчам сравнивались с Alice AI LLM 235B, Qwen3.5-35B-A3B-Base, GLM-4.5-Air-Base (106B-A12B), Nemotron-3-Super-120B-A12B-Base и DeepSeek-V4-Flash-Base (284B-A13B). У модели при этом меньше и общих, и активных параметров, чем у всех, кроме Qwen. На 8 из 10 бенчмарков фактологических знаний, образования и экспертных навыков модель заняла первое место. Особенно сильна в задачах про Россию и русский язык, а на MATH-500 лучшие скоры.

AliceAI-Foundation-80B-A3B-Base предложена как экспериментальная база, на которой коллеги проверяют архитектурные и обучающие решения для будущей единой рассуждающей модели). На её основе будут развивать агентские возможности Алисы AI: посттрейн, SFT, полноценный RL, RLVR, работу с тулами и поиск.

Если вам нужна сильная русскоязычная базовая модель для дообучения - то это самый лучший вариант! Все необходимые подробности есть в техрепорте на Хабре, а веса лежат на HF!

Техрепорт
Модель

#llm

1.6k 0 42 19 56

Пыхтит

Снова понедельник

Раньше я думал, что понедельник - это день, когда надо все разгрести, что осталось с пошлой недели, написать миллиард сообщений, запланироваться, поперекидывать мячик ответственнос и за какой-то вопрос, ну а потом уже думать по нормальные не рутинные задачи. Ну типа такой прям собрался, пока есть силы с выходных, попыхтел немного, и все.

Только вот силы тоже все

Кстати, рутина - это вообще не наша работа. Наша работа быть человеком, а это про думать, выбирать, договариваться, планировать. На рутиниу сейчас пусть попыхтит агент. Он же не устает, не раздражается, не спрашивает лишних вопросов (иногда зря конечно, но ему виднее). Но и тут не всё так просто, агенту нужен контекст: что берем, что делаем, почему именно так делаем, а так не делаем, и что решаем в непонятных ситуациях.

Где-то пишут, что день важно начинать с 20-минутной медитации или отдыха в тишине. Потом мозг прогружается.... ииии пыхтит быстрее. Я не знаю у кого как там с режимами тишины, но я как займусь делами в начале рабочего дня, и открою рабочие чаты - то опомнюсь уже вечером, когда надо уже домой собираться!

🔠🔠🔠🔠🔠🔠

Что делать, чтобы переключиться на человеческое:

1️⃣Я не устану повторять - ломайте привычные ритуалы, пытайтесь осознанно понимать, что вы делаете в данную секунду времени!
2️⃣Дайте мозгу выпустить все, что внутри, на бумагу или другие носители информации (допустимо даже записать видосик)
3️⃣Либо побудьте в состоянии глубоко фокуса без задействования сильных мыслительных процессов (побегать например)

А пыхтит пусть агент! Говоришь ему: "сделай все иделаьно", и он конечно же прходит с результатами, но не теми, что мы ждем. Поэтому тут можно постараться заранее на неделе и:

▫️Описать процесс по составляющим: что на входе, что на выходе, что делать, и что не делать
▫️Раздать доступы и отследить, чтобы он не навертел там ничего лишнего!
▫️Попросить отправлять все на ревью нам в первое время, а потом командовать ему, чтобы уже сам принимал решения и уже советовался

Допустим, пришло письмо, а агент может отсортировать, разметить и приготовить черновик ответа. Допом если что соберет данные из таблиц, обновит статусы, и если что, пришлет утренний бриф. После встречи если что, он пришлет пасшифровку, саммари, список задач и сразу заведет тикеты. При необходимости соберет следующую встречу, найдет свободные окошки у коллег, даже заполниты пререквезиты! При этом один агент мсожет вести и несколько рутин, если контексты не конфликтуют. НО ВСЕ ЖЕ регулярно проверяйте, что агент не врет и не выдает смещенный результат.

Короче, в именно в понедельник нужен тот, кто пыхтит с рутиной, пока мы ломаем типичные ритуалы в нашей жизни. И сегодня самое время это потестить. Пусть агент нам поможет, а мы эффективно спланируем, подышим и просто побудем людьм!

А какую рутину вы уже отдали агентам?

#agents


20 last posts shown.