Big Ledovsky | AI изнутри


Channel's geo and language: Russia, Russian
Category: Blogs


Александр Ледовский
Head of AI @ Listee, ex: Avito, Сбер, ШАД
@aledovsky

Related channels  |  Similar channels
Channel's geo and language
Russia, Russian
Category
Blogs
Statistics
Posts filter


Разбирался в текущих железках NVIDIA

Моя текущая роль предполагает отвечать на вопросы в духе "а какое железо и в каком количестве нам реально нужно" 🧐

На выходных я решил почитать сайт NVIDIA и получше разобраться в каком виде продаются карты. И обнаружил, что их сайт откровенно вводит людей в заблуждение. Абсолютно все у них называется платформой (неважно что это на самом деле 😐), а некоторые продукты (например DGX B300 NVL8, или все H200) скрыты из основных каталогов. Потребовалось посидеть с клодом несколько часов, чтобы понять что к чему

💎 Не вдаваясь глубоко в детали

• Есть отдельные серверные карты RTX 6000 PRO и 4500 PRO. У них много памяти, но они не поддерживают NVLink и поставляются только PCIe. Подходят для инференса

• Карты поколения Blackwell B200/300 идут в серверах по 8 карт или в стойках по 72. У них нет PCIe версий, а есть только т.н. SXM версия на специальной плате со встроенными NVLink. В таких серверах могут быть процы от NVIDIA (Grace CPU, например в DGX GB300 NVL8), они ускоряют обмен RAM память GPU

• H100/200, карты прошлого поколения Hopper, можно купить в версиях с PCIe. Поэтому бывают сервера, например, на 4 карты. NVLink подключается отдельно и соединяет карты напрямую друг с другом (не через плату как в SXM)

• NVIDIA делает железо в двух версиях. Первая - это полностью готовые сервера, которые идут под брендом DGX. Вторая - условно запчасти в виде карт и плат, обвязку для которых делают так называемые OEM производители, вроде Gigabyte. Например: питание, охлаждение и другое. OEM версия серверов на 8 карт продается под брендом HGX

• Карты нового поколения Rubin с точки зрения продуктов повторяют Blackwell, но пока не дошли до свободной продажи

💸 Про сравнение карт

У RTX 6000 PRO сильно дешевле память и низкая цена за одну карту, что делает ее привлекательной для инференса небольших и средних моделей. А вот разница, например, B200 и H200 не такая очевидная. Если не учишь свои LLM. Да, в B200 несколько выгоднее компьют, но при этом нужно сразу выложить цену за 8 карт. А H200 можно купить в сервере на 4 карты.

Мы сами сейчас учим модели на H200, а инферим на RTX 6000 PRO. H200 в целом хорошие, но с другой стороны довольно старые карты. И вопрос, если расширяться, то чем?

503 0 5 12 17

Блокировка ChatGPT

Никогда такого не было и вот опять 🙂

Теперь уже мой личный аккаунт, которому было пару лет. Что такое рецедивизм - понятия не имею 🥑 посмотрел в словаре, не понял

Аппеляция в этот раз не помогла. Может быть проблема была в том, что я оплачивал акк через plati market. Мою киргизскую карту они почему-то отказывались принимать.

Вот думаю - что купить вместо Codex подписки для OpenClaw 🧠

- Либо купить новый аккаунт OpenAI (который с еще большей вероятностью забанят)
- Либо попробовать другую подписку (Кими?)
- Либо вообще попробовать платить токенами за не топ модели? 😏

Что посоветуете?

1k 0 20 20 24

Про openspec

Решил попробовать openspec для adhoc задач, фреймворк для spec driven development. У меня был репозиторий с конфигом клода, через который я делал небольшие задачи. Например дорабатывал и деплоил label studio для сбора разметки, делал аналитику, писал ботов итд

🚲 Для таких задач у меня была своя система ведения спек в md клодом, без привязки к джире. В целом работало, но спеки содержали довольно много лишней инфы, замусоривались, а еще часть тасок висели недоделанными.

😌 Openspec - это фреймворк ведения спек и пока мне он нравится. Я до этого пробовал getting shit done и superpowers - от них осталось ощущение велосипедов и непрактичности за пределами прототипов. И неадекватного хайпа, конечно.

📚 Openspec оставляет иное впечатление. Во-первых, его гранулярность - это задача, а не проект целиком. Во-вторых, мне понравилась его система документов. Достаточно понятная и строгая по содержанию

• Proposal - требования к задаче
• Architecture - техническое решение как делать
• Tasks - план разбитый на подзадачи
• Spec - технический документ со стейтом системы в виде требований

🤔 Эти документы нормально смотреть глазами. Ощущения нейрослопа у меня не возникло

Посмотрим как пойдет. Я вдохновился после этого подкаста. Какое-то время назад мне казалось что каждый сам должен сделать свою систему, но сейчас кажется, что хороший фреймворк правда сильно помогает. Просто этот фреймворк - не superpowers 🫠

На рабочие проекты я пока не планирую внедрять. У нас сейчас каждый работает как хочет. В data science своя специфика. Задачи более творческие, с неопределенным планом действий 🤷‍♂️


Годный курс по AI для менеджеров

Меня довольно часто спрашивают, что я могу порекомендовать посмотреть по AI для менеджеров. И честно говоря я точно не знал, что ответить 😏

Появился хороший курс, который сделал мой друг Никита Зелинский вместе с коллегами в школе ML Inside.

Называется AI-агенты для продактов, первый поток в октябре. Обратите внимание)

PS. Не реклама, пишу чисто по-дружески 🙂 🤝


Про Jev

1. Наконец-то! Появились LLM, которые отвечают не текстом, а сразу тем что нужно. В данном случае вероятностями классов. Модель явно очень удачная

2. Про Jev мы забудем через несколько месяцев. Топ-тир компании сделают свои аналоги

PS. Ждем когда появится ризонинг не через текст


Что станет с поиском и рекомендациями в эпоху LLM

🦜 По следам дискуссии на Practical ML

Раньше было два способа как пользователь находит айтем: это поиск и рекомендации. Теперь к ним добавился ассистент. Что же будет дальше?

1. Веб поиск

На первый взгляд кажется, что веб-поиск скоро полностью вытеснится агентами. По факту, у обычного поиска остаются навигационные запросы, короткие частотные запросы, которые не исчезнут.

💎 Очень своевременный мув был сделан Гуглом, а затем Яндексом и другими классическими поисками с добавлением нейропоиска в UI веб поиска с невероятно быстрой скоростью ответа. Я думаю, что все несложные запросы они таким образом отбили. На внешних агентов останется только маленький хвост рисерчей, которые в любом случае долгие.

2. Поиск и рекомендации в маркетплейсах

Ни для кого ни секрет, что ассистенты пока ни у кого не взлетели. Там много проблем

🤯 Не получается найти хороший сценарий. «Подбери мне Х» оказался не очень удобным по сравнению с поисковым запросом.

В добавок, в UI агента неудобно смотреть айтемы. Я видел вариант где агент кидает по три айтема, чего мало. Либо виджет горизонтального скролла, который конечно плохо просматривается, но хоть что-то.

🔮 Мой прогноз. Традиционный поиск и рекомендации никуда не уйдут. В агента уйдет сценарий рисерчей.

- В этом кейсе агент принимает подробное задание от пользователя
- Его результат - это ссылки на поиски, может быть в виде виджетов

🏄‍♂ Например

«Под твои требования можно посмотреть недорогие новые Самсунги если хочешь android (ссылка) или БУ iphone (ссылка). Можем рассмотреть детально плюсы-минусы моделей»

Что думаете?

🐳 - агенты рано или поздно все заменят
🗿 - традиционный поиск и реки никуда не уйдут


А еще в следующую субботу будет PracticalML. Одна из моих любимых конференций. Я на ней выступал 3 года назад с рассказом про VCG аукцион в продвижении Авито, который я же потом и выпилил 😂. Как давно это было..

На PracticalML, во-первых, очень хороший состав докладов, которые кропотливо собирает Петя Ермаков, один из создателей ODS, которому я пообещал сделать этот пост 🙂. Во-вторых, топовый афтепати и нетворкинг. В общем, нужно идти


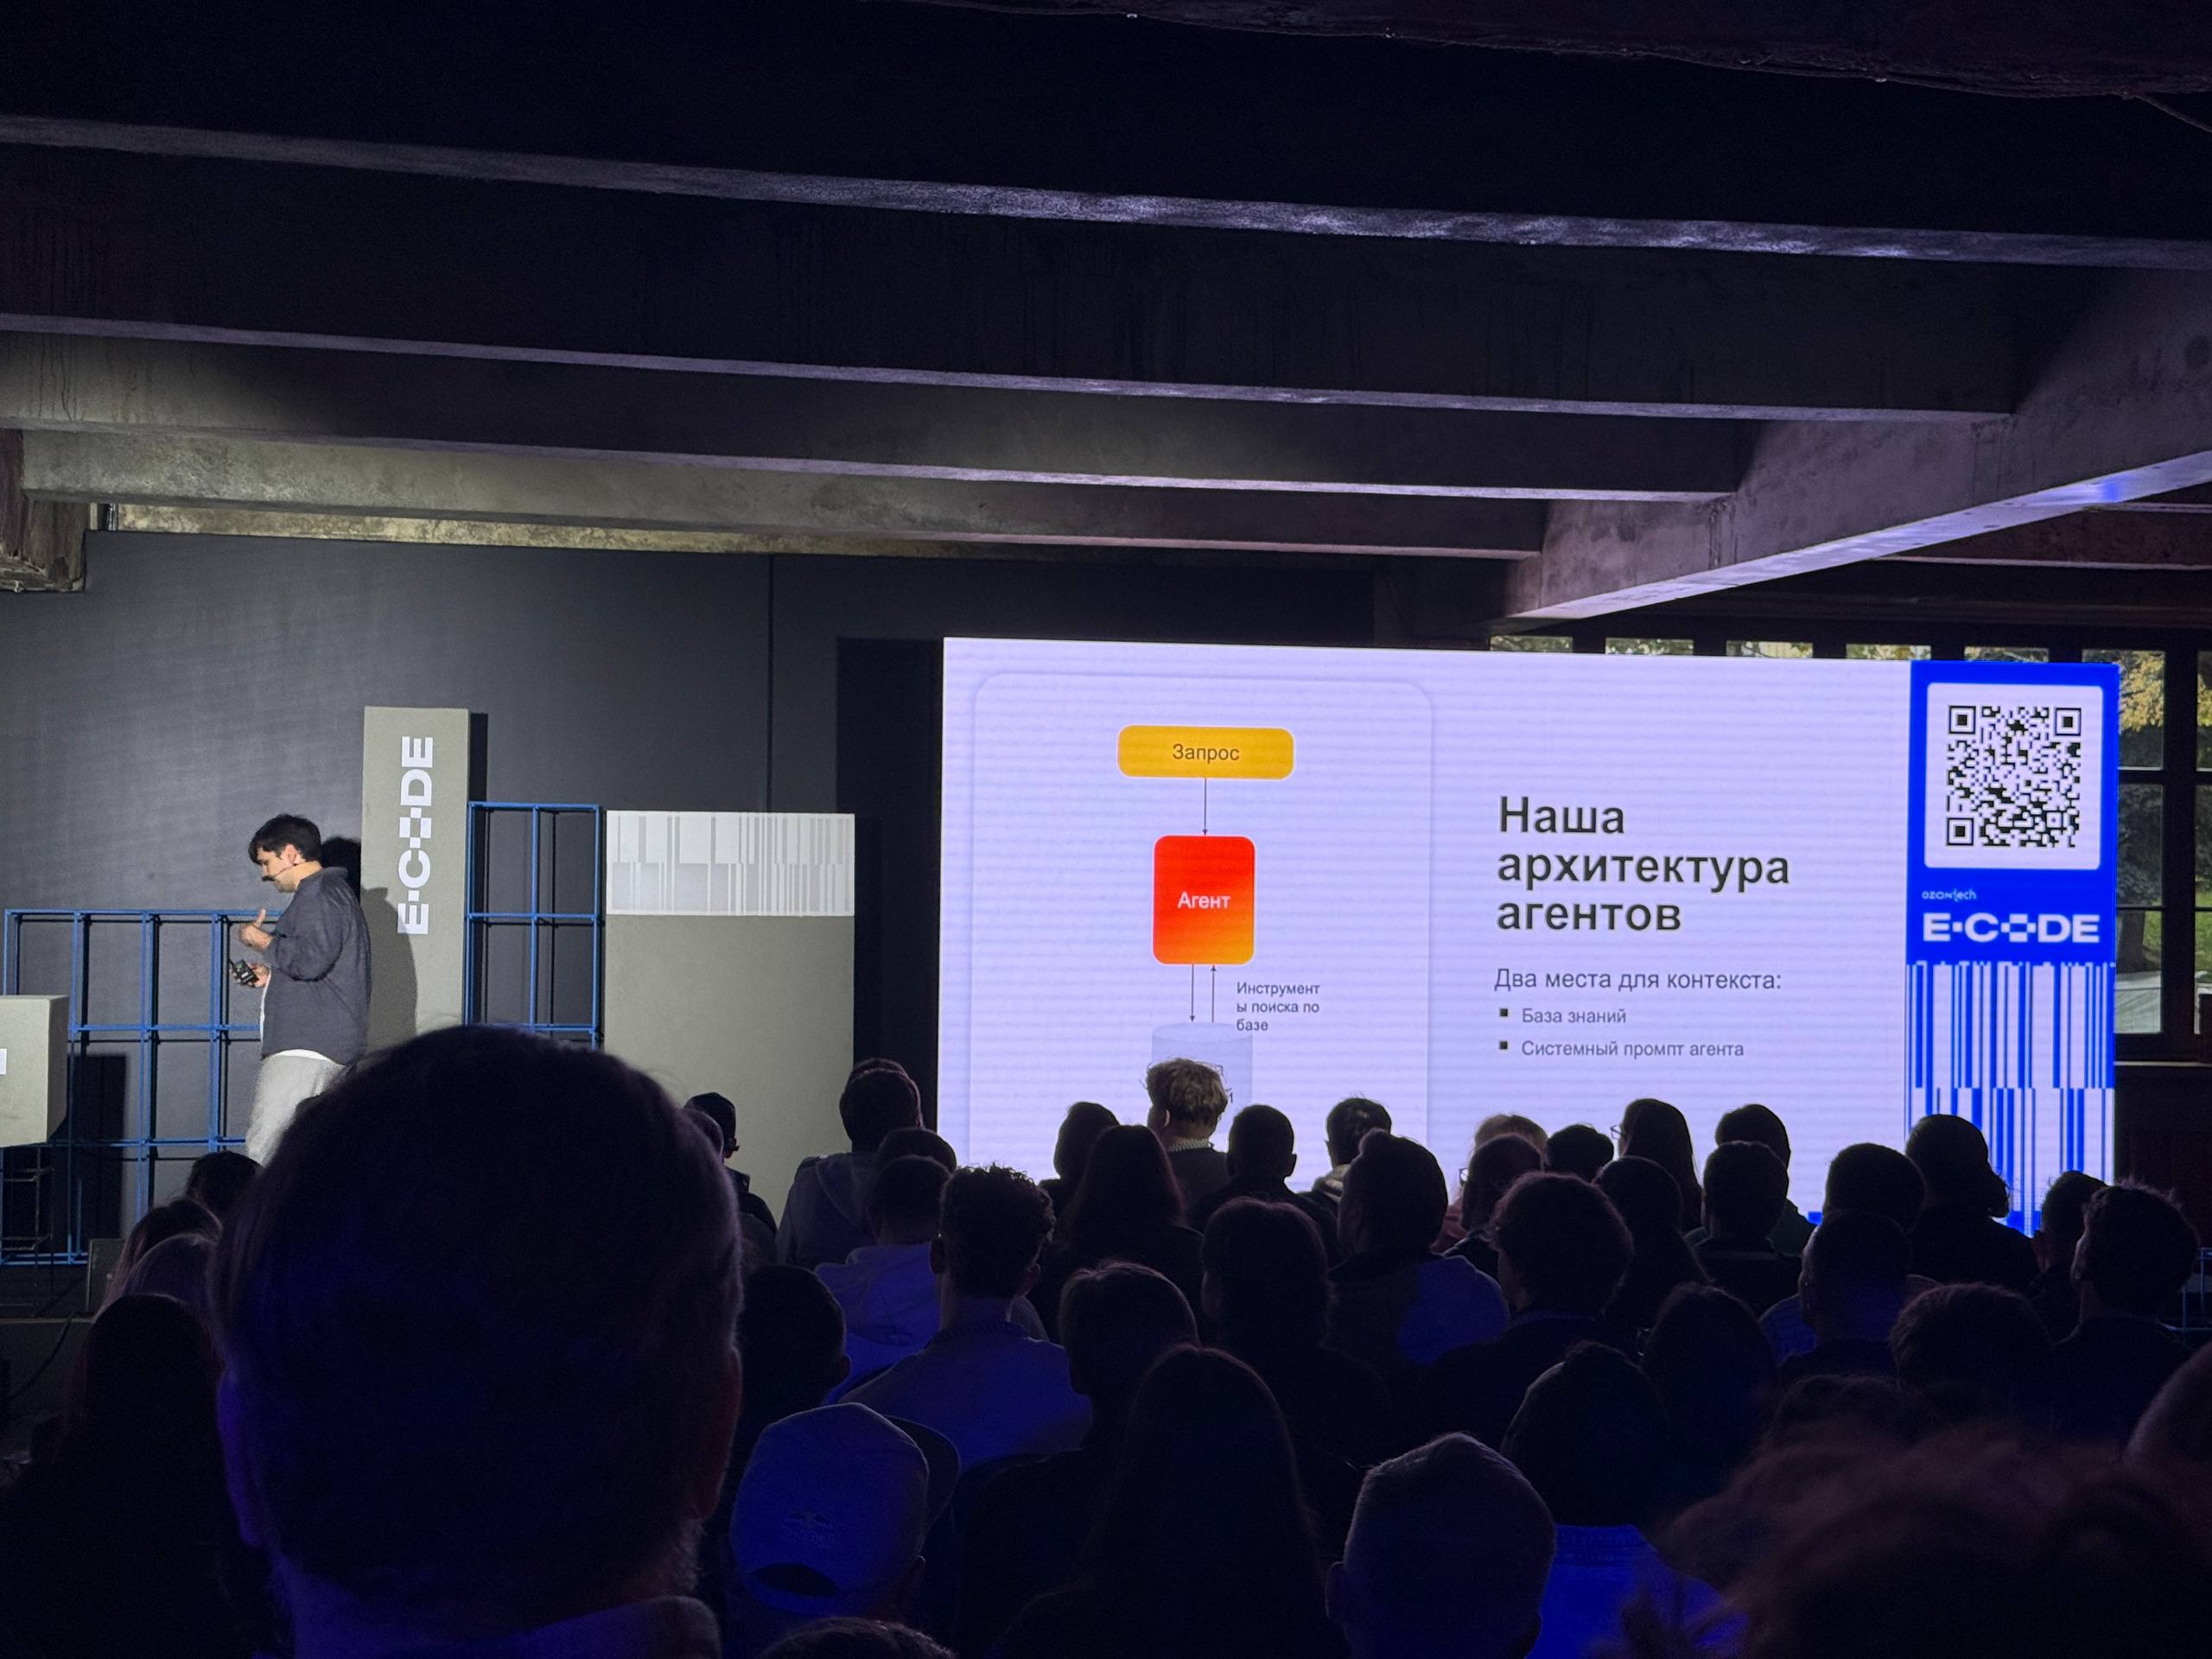
Вчера был на E-CODE, на ML-треке

Там выступал парень, который автоматизирует поддержку Тбанка агентами. Фраза из доклада, примерно дословно: «Большинство внедрений агентов проваливаются, но, кажется, наша команда напала на след, как это всё-таки делать. Пока не точно, но кажется мы его почуяли». Вайб очень жизненный и религиозный одновременно 👌 очень его разделяю))

Мысли на самом деле у него довольно здравые
— дообучать LLM не нужно
— агенту нужна поддерживаемая база знаний
— поддержку самой базы тоже стоит автоматизировать агентами, через разные хитрости и фидбек-лупы

Например, прогонять LLM-судью по человеческим сессиям поддержки и спрашивать: есть ли в базе знаний информация, чтобы решить данное обращение


Data Driven пройдет 26 сентября

Data Driven от Яндекса - знаковая в конференция для аналитиков. Потому что на ней ежегодно рассказывают про аналитические кейсы очень серьезного уровня: про критичные бизнес процессы, про нагруженный продакшн, про сложные задачи, требующие и продуктовых, и технических знаний.

Как и в прошлом году, основной фокус остается на аналитике вокруг LLM. В том числе будет про аналитику Алисы, аналитику внутренних агентов, разметку с помощью LLM и многое другое.

Рекомендую сходить оффлайн, так как конференция - это не только доклады, но и живое общение.

👉 Москва + онлайн, 26 сентября. Регистрируйтесь по ссылке


Написал гайд по подключению Google Workspace к агентам

Казалось бы, что проще, чем подключить агента к календарю? Выдал токен, дал его агенту и работай. Но в гугл так нельзя 🤯

Я потратил слишком много времени на то чтобы в разобраться. И решил что нужно уберечь других от траты сил.

https://habr.com/ru/articles/1078890/

PS. Недавно возмущался политикой Хабра. Но идти больше некуда, увы 🤷‍♂️

1.5k 0 18 12 19

Про выход GPT-6 Astra и пришедший AGI

Во-первых, нужно ждать. Мб они затюнились под бенчмарки.

Во-вторых, то что модель умеет решать задачи на IQ, не обязательно приведет к улучшению "бытовых" навыков.

Субъективно, заметный качественный прорыв был прошлой зимой. А дальше было эволюционное улучшение, которое в моменте не ощущается.

PS. Вот, можете потыкать ARC-AGI-3 бенчмарк, где модель набрала 98%

https://arcprize.org/tasks/ls20


Про удаленку

Обсуждали с друзьями, что западные компании возвращают людей в офисы. И не только западные

Я в своей карьере собирал команды несколько раз. И лично придерживаюсь следующих принципов

1️⃣ Поддерживать как можно больший процент локальных сотрудников, которые могут ходить в офис

2️⃣ Фул ремоут нанимать только сильных и опытных

3️⃣ Поощрять гибридный режим. Иногда офис, иногда дом

Общение в офисе создает более глубокие отношения между людьми. Многие проблемы решаются за 5 минут. А полные удаленщики в ограниченном количестве хорошо вливаются за счет общей сплоченности коллектива

👨‍🦽Нанимать джунов на полную удаленку контр-продуктивно. А фул ремоут команды - это компромисс, а не благо

Хейтеры - можете расчехлять ружья 🏄‍♂️


Апдейты по моему прохождению cs336

Про который писал

Потратил на него примерно 40 часов. Сделал только одно задание. Ну.. это было жестко. Нужно было написать все с нуля: токенизатор, небольшую LLM с современными слоями, оптимизатор adam w (!) и код для обучения. И на всем этом провести десяток экспериментов

Учитывая что задание дают на 2 недели, я думаю люди отключают запрет на агентов

Признавать что я просто медленный я конечно не собираюсь 🗿

Да, и знаете что? Даже понимая внутренности современных LLM-ок и обучив все своими руками, я все равно поражаюсь что они все-таки работают 👁


Мнение про свежий гайд Claude Code

Как клодовод со стажем, могу вставить несколько копеек 😎

Выбор модели и уровня усилий

Абсолютно нереально этим управлять. Модели так часто меняются, даже в стеке антропика. Невозможно успевать вырабатывать интуицию, поставить фейбл или опус или соннет. Я тупо пользуюсь fable.

Уменьшение контекста и сабагенты

Ральф луп и контекст задачи в маркдаун файле - все еще лучшее решение на мой взгляд.

Управлять сабагентами сложно, потому что они включаются непредсказуемо. Теоретически можно аккуратно прописать правила когда и как их запускать в Claude.md, но я до этого не дошел. Сабагенты - это автоматический способ экономии контекста. Ральф луп - это ручной, но достаточно хорошо управляемый.

Совет запускать компактизацию когда уходишь от компьютера странный. Это требует огромной ментальной энергии, а в агентах наоборот хочешь ее экономить. Да и не доверяю я компактизации. Не понятно насколько она ухудшает качество контекста.

Совет тегать файлы через @ в моем случае работает плохо, потому что я читаю файлы из разных мест и работаю с несколькими репозиториям сразу.

Про часовое кеширование

А вот на этом хочу акцентировать внимание. Часовое кеширование - это самый важный геймченджер антропика. Это причина, почему если просто включить API на Гермесе через OpenRouter агенты становятся золотыми. Я плохо понимаю, как работает подписка кодекса. Но в обычных API у других провайдеров нет нормального предсказуемого способа кеширования. Обычно они говорят, что кешируют, но как и на сколько - не гарантируют. Обычно кешируют на несколько минут и часто мы отвечаем агенту с большим лагом. В подписке Claude часовое кеширование включено по умолчанию и именно это позволяет укладываться в лимиты на больших задачах.

https://claude.com/blog/maximizing-the-value-of-your-claude-code-sessions


Что я думаю про Conductor

Conductor - это приложение для оркестрации агентов, которое я периодически видел в разных ютубах. Это что-то среднее между UI Claude Code и Codex и полноценной IDE типа курсора. IDE вайбкодера короче 🤪

Основа рабочего процесса состоит из двух элементов. Традиционные сессии с агентами. И код ревью того, что наделал агент. Conductor сам не ходит в модели, как курсор, а подключается к уже установленным Claude, Codex итд.

Я посидел на нем над одним личным проектом. Тул прикольный, подойдет для неинженеров. Для инженеров скорее нерабочий.

Что понравилось

Conductor форсит свой подход к работе. Проект обязательно должен быть git репозиторием, подключенным к гитхабу или другой платформе с механизмом PR. Каждая новая задача агенту создается в виде workspace - 1 или более сессия с агентом + git worktree, который мерджится исключительно через PR.

Что не понравилось

В рабочих проектах вы не хотите плодить PR-ы на каждое изменение агента. Почему не поддерживаются локальные ветки и мерджи - я не понимаю. Вторая проблема - там нет полноценной поддержки синтаксиса - go to definition итд. Без этого раскапывать километры вайбкода очень больно. Третья проблема - нельзя делать фичу сразу в нескольких репозиториях. А в ds это постоянно (сервис + рисерч репозиторий)

Итого

Интересный инструмент, но моя перемотанная скотчем фабрика задачи решает лучше 😎


Правда жизни про поиск

После того, как на конференции вы вдохновились очередным докладом про супер-пупер нейронку для поиска, может сложиться впечатление, что поиск - уже решенная задача

Вот вам простой пример, что это не так 😄

Запрос: "гермомешок 50л". Можете посмотреть как с ним справляются крупные ecom площадки. Ozon, Avito, Amazon, Ebay. Все выдают гермомешки неправильных размеров (Авито кстати меньше всех!)

С числовыми параметрами справляется Lamoda, потому что у них относительно узкая область и есть разбор запроса и преобразование его в фильтры. Но на большом ассортименте это очень тяжело поддерживать.

Короче есть еще чем позаниматься в поиске 😎


Какое-то время сидел на Opus 5 как на основной модели в Claude Code. Понял, что страдаю 🦶

Агент тратит много времени на простые задачи, выдает полотна ненужной информации и прочее. В итоге, на сложных проектах переключился на Fable, на простых вернулся на Opus 4.8 (если не знаете как - /model claude-opus-4-8)

Пошел смотреть что пишут другие, у других людей 🫁 тоже много негатива раз два

Тем временем Boris Cherny в свежем выступлении на YC рассказал, что под каждую новую модель они на самом деле почти полностью переделывают систем промпт Claude Code.

Не факт, что Opus 5 правда настолько плох, думаю его допилят за счет систем промпта и он будет лучше ощущаться. У меня такое уже было, кажется, на Opus 4.6. Сперва страдал, а потом стало ничего 👌


Marimo побеждает Streamlit в нашей команде

К моему удивлению. Потому что сам я два раза пробовал пересесть на Marimo, и оба раза не выдерживал из-за неудобного UI

Вообще, marimo - это современная альтернатива jupyter ноутбукам. Еще у него есть режим публикации, который позволяет делать хорошие интерфейсы, по функционалу примерно как стримлит. Т.е. на нем можно сделать смотрелку предсказаний, или тестовый интерфейс для модели, или интерактивный дашборд.

Причем ребята говорят, что де-факто не работают в UI marimo и все делают через агента. Мне лично работая с агентами больше нравится комбинация python-скрипты + streamlit. Но мб нужно еще раз попробовать.


2-го августа будет конфа UrbanML. Собираюсь сам и могу порекомендовать вам.

—

18 докладов по RecSys, NLP, антифроду и агентным системам, выступления специалистов из MTS Web Services, ВТБ, «Звук», Wildberries, Альфа-Банка и других компаний. После основной части — спортивные активности (мастер-класс по баскетболу, настольный теннис и ИИ-шахматы) нетворкинг и афтепати.

Вход бесплатный, но нужна регистрация (на площадку необходимо взять с собой паспорт или права): ссылка

📅 2 августа, 11:00–21:00 (первый доклад в 12:00)
📍 Москва, офлайн

20 last posts shown.