


Reversing the Flow: Generation-to-Understanding Synergy in Large Multimodal Models
[кода/весов не вижу]
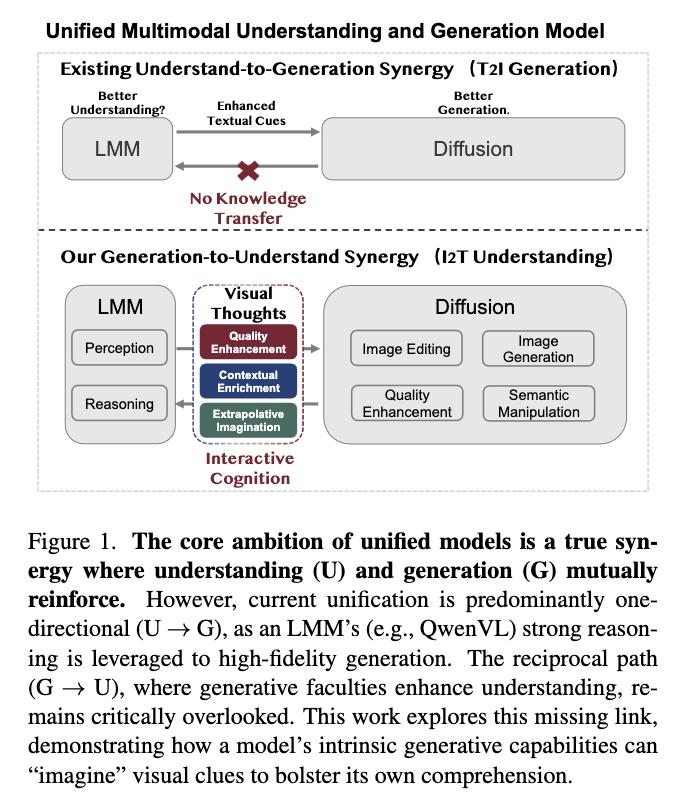
Интересная работа про unified multimodal models, но не про улучшение генерации через понимание, как обычно в BAGEL/BLIP3-o-like системах, а наоборот: может ли генерация улучшать понимание?
Авторы называют это G2U (Generation-to-Understanding). Идея простая: перед ответом на вопрос модель сначала генерирует вспомогательную картинку — visual thought — а потом использует и исходное изображение, и эту сгенерированную версию для финального ризонинга.
Пайплайн
1. Visual Thought Generation: модель делает контролируемое редактирование исходного изображения.
2. Understanding via Feedback: исходное изображение + visual thought + вопрос подаются обратно в ветку понимания.
3. Edit prompt пишет отдельный prompt writer (GPT-4o-mini, 5-shot ICL).
Типы visual thoughts:
• Enhancement: denoise, deblur, exposure correction.
• Expansion: outpainting, zoom-in, viewpoint translation, removing distractors, structural visualization.
Результаты
Модель тестируют BAGEL 7B. Сравнивают ванильный BAGEL, textual CoT и разные варианты G2U. Забавно, что textual CoT в среднем хуже бейзлайна, а visual thinking лучше: BAGEL+G2U даёт прирост на HallusionBench (+4.2), R-Bench (+1.6), MMStar (+1.2), MMBench (+1.8). На их VisThink-Bench (1595 семплой, 34 задач) самые большие улучшения в 3D height estimation, illusion reasoning и color recognition.
Главное наблюдение: качество generated visual thought реально ограничивает прирост понимания. Чем выше semantic consistency и perceptual quality у сгенерированной картинки, тем больше итоговый прирост качества. То есть “воображение” помогает только пока оно достаточно “правдоподобное”.
Ограничения тоже понятные:
• text/charts/symbol-heavy задачи могут проседать из-за потери мелких деталей;
• Абстрактные промты для редактирования иногда создают циклический ризонинг (но это как будто проблема +- всех моделей);
• модель пока плохо выбирает, что именно ей надо “вообразить” для задачи. Self-prompt работает хуже, чем внешний GPT-4o-mini prompt writer.
Мне нравится эта работа скорее как правильная постановка вопроса. Unified models часто продаются как “понимание + генерация в одной системе”, но на практике связь почти всегда односторонняя: поняли → нарисовали. Здесь проверяют обратную сторону: нарисовали → лучше поняли.