Канал влияния


Channel's geo and language: Russia, Russian
Category: Economics


Канал Анны Ставнийчук (к.э.н., н.с. ЭФ МГУ) и Ольги Марковой (к.э.н., с.н.с. ЭФ МГУ)* об оценке эффектов, поведенческой экономике и антитрасте с юмором и полезными материалами
causal.channel@gmail.com
*Мнение авторов не является позицией ЭФ МГУ

Related channels

Channel's geo and language
Russia, Russian
Category
Economics
Statistics
Posts filter


В комментариях под прошлым постом нам бросили челлендж — и мы его решили принять! 👋

Если этот пост наберёт 300 реакций, мы идём записывать подкаст

А если вы ведёте свой подкаст и хотите позвать нас в гости — пишите в личные сообщения или в комментарии. Мы открыты к приглашениям и с радостью обсудим интересные форматы

Ну что, насколько вы готовы слушать нас, а не только читать? 😄

#канал_празднует
@causal_channel

406 0 5 1 187

🎂 Нам два года!

Друзья, сегодня Каналу влияния исполнилось два года. Мы до сих пор немного удивляемся, что нас читает столько разных людей, и очень этому рады. Спасибо, что вы с нами!

За два года мы написали 223 поста, а вы поставили почти 6 800 реакций и переслали наши посты больше 5 тысяч раз – нас уже больше 1 400 человек!

Во второй год мы писали чуть реже, но длиннее: в среднем 2 780 знаков против 2 260 в первый. Медианный пост собирает теперь 1 200 просмотров. Когда-то мы проверяли, правда ли, что длинные посты собирают больше реакций, и честно признали, что причинной эту связь назвать не можем. Писать длиннее мы после этого всё равно стали – считайте это решением, принятым без доказательств :)

Самым читаемым постом оказалась «Иерархия доказательств», самым пересылаемым – анонс летней школы по анализу данных, а самая активная дискуссия в комментариях развернулась вокруг The Causal Summit. А комментариев, кстати, за второй год стало вдвое больше – из некоторых ваших вопросов потом даже получались отдельные посты. Отвечаем мы пока не всегда быстро, но мы стараемся, всё читаем и очень этим дорожим. Постараемся в третьем году отвечать чаще и быстрее

Мы очень благодарны вам за то, что вы делитесь нашими постами: пересылаете ссылки в рабочие чаты и свои каналы, советуете нас коллегам и студентам, рассказываете о нас на семинарах. Это лучший подарок, какой вы можете нам сделать: благодаря вам канал растёт и развивается, а мы в ответ стараемся радовать вас новыми постами

С любовью,
ваш Канал влияния ❤️

#канал_празднует
@causal_channel

495 0 5 3 161

⏳ Сколько живут научные идеи?

12 октября объявят лауреатов Нобелевской премии по экономике (можете попробовать их угадать вместе со СМУч ЭФ), но сегодня мы решили поговорить не о лауреатах, а об идеях

Как измерить скорость научного прогресса? Считать статьи бессмысленно: их выходит около 15 млн в год, и по этой мерке мы живём в золотой век. Считать деньги тоже так себе идея: каждое следующее открытие обходится дороже, и растущие расходы лишь удерживают прежний темп

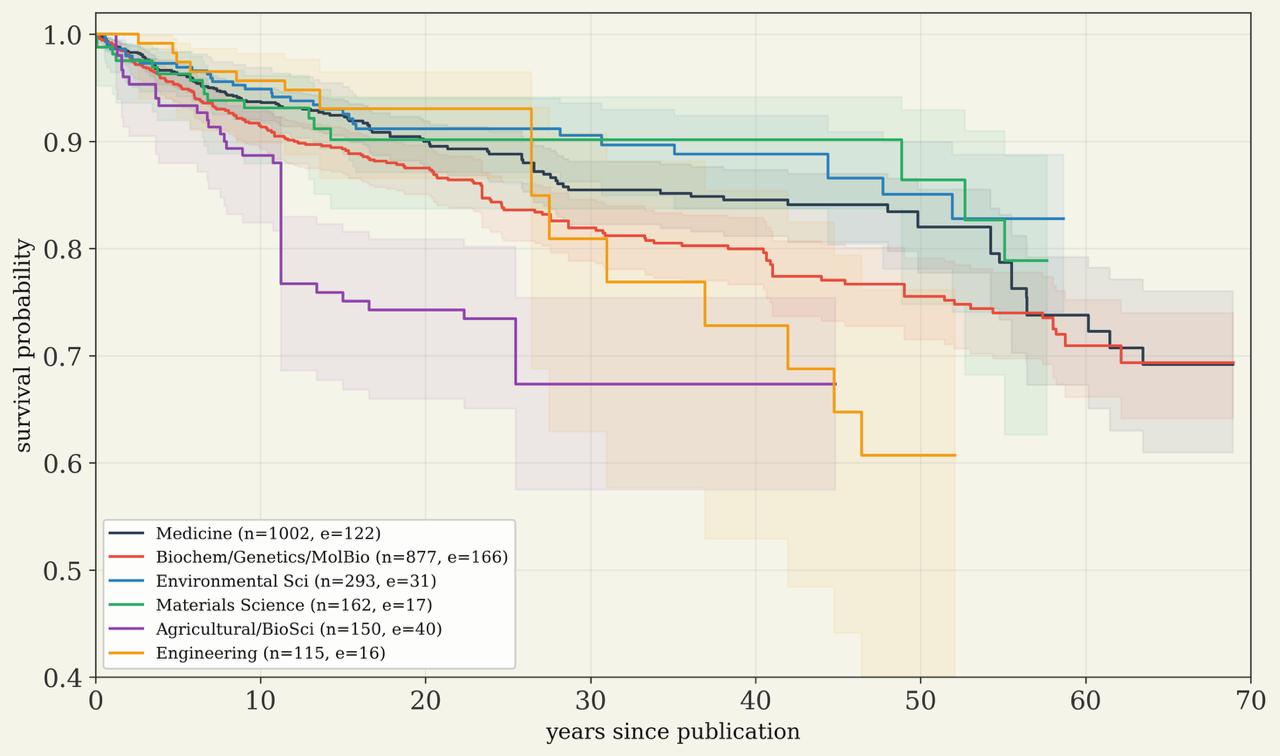
Эндрю Уайт предлагает мерить иначе – временем жизни научного утверждения (claim): сколько оно держится, прежде чем его пересмотрят или опровергнут (White, 2026). По сути это взгляд на прогресс по Томасу Куну: наука движется не объёмом написанного, а тем, как часто приходится переписывать уже написанное

⏮ Как это посчитано?
Утверждения здесь рассматривают как пациентов в клиническом исследовании. Берётся 151 обзорная статья по химии, медицине, биологии, материаловедению и другим областям, с 1950-х по 2010-е. Из них языковой моделью извлечены 3 444 утверждения, и момент попадания в обзор считается «рождением». Дальше поисковый агент PaperQA3 ищет, не пересмотрено ли утверждение: чтобы признать его изменённым или опровергнутым, нужен DOI опровергающей работы. Сдвиги меньше 20% от заявленной величины засчитываются как «выжило», пересмотр считается «смертью». Далее автор строит кривые Каплана-Мейера

Выглядит это так. В обзоре 1966 года сказано, что пятая жаберная дуга аорты исчезает после пятой недели развития и не оставляет никаких структур. Современные работы по эмбрионам мыши и человека показали, что такая артерия вообще не формируется, а то, что за неё принимали, – коллатерали и аномалии. Утверждение прожило полвека и умерло

⏮ Что получилось?
• Период полураспада научного утверждения – 115 лет: столько нужно, чтобы пересмотру подверглась половина. Зато уже через десять лет пересмотренными оказываются около 10%
• Интереснее разбивка по десятилетиям: у утверждений 1950-х ожидаемый полураспад около 250 лет, у 2000-х – уже 70. Если разгон продолжится, к 2212 году полураспад сократится до года, а к 2494-му – до суток. Автор называет это сингулярностью: картина мира переписывается быстрее, чем человек успевает её прочесть

⏮ Где нужно быть осторожным?
Автор признаёт ограничения:
• экстраполяция уходит далеко за пределы данных: пересмотров всего 529 на 3 444 утверждения, а у недавних десятилетий их мало просто потому, что прошло слишком мало времени. Само предположение об экспоненциальном ускорении ничем не проверено
• выборка смещена дважды: в обзоры попадают только утверждения, которые уже стали заметны, а открытый доступ перекошен в сторону последних десятилетий
• разметку делала языковая модель: эксперты соглашались с её оценками в 70% случаев, да и проверяли это на моделях двухлетней давности (Skarlinski et al., 2024)
• трудно решить, что считать утверждением: у слишком узких формулировок нет продолжения в литературе, и «выжило» не отличить от «никто не проверял»

От себя добавим, что это хоть и очень интересный, но пока всего лишь пост в блоге, а не рецензируемая статья. Но зато автор открыто поделился своими данными

⏮ Зачем это нам?
• Сюжет спорит с привычной картиной замедления науки: идеи становится всё труднее находить (Bloom et al., 2020) [см. пост], статьи и патенты теряют прорывность (Park et al., 2023), а разрыв между работой и Нобелевской премией растёт (Mitsis, 2022). Здесь же выходит, что оборот фактов ускоряется
• К разговорам о скором скачке наука привыкла давно: Генри Адамс делил историю на эпохи – механическая триста лет, электрическая двадцать – и ждал сингулярности к 1921 году. Он не так уж промахнулся: модель атома с 1904 по 1926 год сменилась примерно восемь раз, а каково было издателям учебников физики, можно только гадать

Хотя, если вдуматься, Уайт измерил не то, как быстро мы узнаём правду, а то, как быстро правим прежние записи. Тогда рост числа пересмотров может означать и ускорение науки, и просто удешевление проверки – теми же языковыми моделями, с помощью которых сделана эта работа

#канал_обозревает
@causal_channel


А ты купи слона осла: как торговые счета помогли искать города бронзового века

Недавно мы писали про то, как экономисты на основе данных о генах идентифицируют паттерны миграции доисторических людей. Сегодня обсудим еще один пример неожиданного включения экономистов: если у вас есть нескольких тысяч глиняных табличек возрастом почти 4 тысячи лет — писем купцов, счетов за перевозку олова, договоров, сведений о пошлинах и жалоб на опасные дороги — и вы не знаете, где находится город, о котором в этих табличках написано — то мы можем его "найти". Именно этим занялись экономисты и ассириологи в статье о торговлле староассирийских купцов в Анатолии XIX–XVIII веков до н. э. [Barjamovic et al., 2019]

Шаг 1: Таблички превращаются в таблицы
Авторы обработали около 12 тысяч клинописных текстов из Канеша (город, который в начале II тысячелетия до н. э. был одним из ключевых узлов торговли между Ассирией и Анатолией). Из них они восстановили 391 поездку между 25 городами: купцы записывали, откуда и куда отправляли товары, сколько платили погонщикам ослов, где взимали пошлины, какие дороги считались опасными и в каких городах заключали сделки. Каждая такая запись сама по себе мало что говорит о географии, но вместе они образуют торговую сеть

Важно, что из 25 городов авторы знали координаты только 15, но еще 10 считаются "потерянными": их названия регулярно встречаются в текстах, однако точное расположение неизвестно до сих пор

Шаг 2: Добавим гравитационную модель
Дальше в дело вступает гравитационная модель, известная всем экономистам из курсов по международной торговле: два города, при прочих равных, торгуют интенсивнее, если они крупнее и расположены ближе друг к другу

Логика проста. Если неизвестный город связан с Канешем частыми перевозками, но почти не торгует с удаленными центрами сети, это дает информацию о его вероятном положении. При этом частота торговли зависит не только от расстояния: важны размер города, его специализация и место в торговой сети. Поэтому авторы одновременно оценивали: размеры городов, как расстояние снижало интенсивность торговли и наиболее вероятные координаты "потерянных" городов

Оцененная эластичность торговли по расстоянию оказалась равна примерно 1,9: с ростом расстояния торговые связи заметно слабели. Это очень похоже на современные оценки для наземной торговли. Иными словами, "тирания расстояния" все еще работает четыре тысячи лет спустя

Но как оценить, где находятся потерянные города?

Шаг 3: Потерянные города - а все-таки где они?
Далее авторы по очереди убирали известные города, что позволило позже оценить, где именно находились неизвестные. Слово "найти" здесь стоит употреблять осторожно. Авторы получили статистические оценки наиболее вероятных координат вместе с "доверительными" областями нахождения города

Дальше эти оценки сравнили с независимыми гипотезами историков, которые опирались на маршруты, древние названия, топографию и археологические данные

Пока нет информации о том, что какой-то из определенных "потерянных" городов реально "нашли" с помощью гравитационной модели, так как для доказывания того, что найденный город — это именно тот, который упоминается в клинописных табличках, необходимо найти табличку с названием города или другие артефакты, которые однозначно определят название города, а многие из таких артефактов утеряны

Мы все иногда задумываемся о вкладе в историю — и оказывается, что даже простая запись о найме осла, размере пошлины или небезопасной дороге становится важной частью сохранения данных об наших предках. Недавно мы ездили в Нижний Новгород — и там мы узнали, что в "заповедных кварталах" классные ребята из Том Сойер Фест @tsfnnov занимаюся восстановлением домов и находят данные о жителях этих домов в архивах — и данных о людях, которые жили всего 100-200 лет назад катастрофически мало!

#канал_рекомендует
@causal_channel


Forward from: доказательный ⎵ пробел
Как-то мы уже писали про нестандартные treatment'ы (например, здесь). Относительно недавно вышла отличная статья исследователей Калифорнийского, Токийского университетов и Лондонской школы экономики «Geodesic Difference-in-Differences». Статья предлагает новый метод оценки причинно-следственных эффектов, позволяющий исследовать влияние госполитики на сложные показатели: распределения доходов и смертности, структуру производства, энергетический баланс и даже сети взаимодействий между экономическими агентами. Вместо оценки изменения среднего показателя можно оценивать, как госполитика изменила целое распределение или структуру исследуемого объекта.

В статье рассматривается переход от анализа отдельных числовых показателей к анализу сложных объектов, находящихся в неевклидовых метрических пространствах (non-Euclidean metric spaces). К таким объектам относятся распределения вероятностей, сети, функциональные данные и композиционные данные (например структура производства или энергобаланса). Проблема заключается в том, что с такими объектами не всегда можно выполнять обычные арифметические операции.

Допустим, структура производства региона состоит из трех секторов: добыча полезных ископаемых - 60%; обрабатывающая промышленность - 20%; услуги - 20%. После реализации программы диверсификации структура изменилась: 40%, 30% и 30% соответственно. Все три доли связаны между собой и должны в сумме составлять 100%. Поэтому их нельзя рассматривать как полностью независимые показатели. Авторы предлагают использовать геодезические линии (геодезики) - кратчайшие пути между объектами в соответствующем метрическом пространстве. Геодезическая линия описывает переход от одной структуры экономики к другой с учетом геометрических свойств пространства, в котором находятся эти структуры. На этой основе строится контрфактический результат: какой была бы структура экономики или распределение исследуемого показателя без государственной программы. Новизна Geodesic DiD заключается в обобщении подхода DiD на более широкий класс объектов, для которых линейные операции неприменимы.

В статье, на наш взгляд, не совсем удачные кейсы имплементации метода на примере оценок последствий распада СССР на распределение смертности (не совсем очевидная интервенция) и либерализации электроэнергетического рынка США на структуру генерации (сравнение охватывает 25 лет, за которые изменились технологии генерации, энергетическая политика и рыночные условия). Но потенциал у метода большой: оценка мер по привлечению кадров на территории (через кадровое распределение и трудовую структуру); оценка структурной трансформации экономики муниципалитетов; оценка влияния государственной поддержки на распределение доходов населения и т.д. Тут git метода из статьи.

@evidencespace


Телеграм-канал «Зоопарк из слоновой кости» снова подготовил тематическую подборку каналов о гуманитарных науках, и наш канал стал частью этой коллекции

Приглашаем познакомиться с подборкой и найти для себя что-нибудь новое и интересное

Ссылка на подборку https://t.me/addlist/obDLEfpYEgI0ZTli


Твои, мои, наши...

Представьте пару, где у обоих супругов есть накопления, но с разными условиями. У жены более "приятные" условия (например, работодатель доплачивает рубль на каждый рубль взносов). У мужа - только 50%. Какое оптимальное решение для семьи? А если в случае развода эти деньги делятся поровну?


Часто экономисты рассматривают домохозяйство как одного агента: если решение может улучшить положение обоих, то пара это сделает. Но проверить это почти невозможно: почти любое неэффективное решение семьи можно списать на предпочтения

В американской пенсионной системе есть деталь, которая решает эту проблему: условия софинансирования (match) пенсионных накоплений различаются между работодателями, поэтому у супругов часто разная "цена" дополнительного доллара сбережений

Этой особенностью воспользовались (Choukhmane, Goodman, O'Dea, 2025): они вручную закодировали условия шести тысяч пенсионных планов, соединили их с налоговыми данными и для каждой из 185 тысяч пар посчитали "упущенную доплату": сколько денег работодателя семья теряет, распределяя взносы неэффективно. Это чистая арифметика, не зависящая ни от чьих вкусов

Что оказалось?
Каждая пятая пара (19,3%) теряет деньги: в среднем $757 в год, у самых пострадавших — почти 2 тысячи долларов (Choukhmane, Goodman, O'Dea, 2025). И это не разовая невнимательность: 70% таких пар повторяют ошибку через год, а 42% даже через семь лет. В итоге за все время работы набегает около 13 тыс. долларов недополученного дохода

А остальные 80,7% — образцовые команды? Чтобы понять это, авторы собирают "фальшивые" пары: случайные комбинации людей похожего возраста, пола и дохода, которые заведомо не координируются. У псевдопар неэффективность наблюдается в 33–34% случаев — это почти вдвое чаще, чем у настоящих супругов. Вывод: около 57–58% реальных пар вообще не согласовывают взносы. Им просто везет, что независимые решения случайно совпали с эффективными

При этом брак "работает" в правильную сторону: за четыре года до свадьбы неэффективность у пары составляет в среднем 32%, а через четыре года после — уже у 18%

Ошибка или принципиальная позиция?
Авторы исследования спрашивают людей напрямую - откуда возникает такая неэффективность? В опросе неоптимально распределяют сбережения 40% женатых респондентов. Половина из них и вправду совершают ошибку: когда им показали упущенную выгоду - они захотели исправить выбор. Вторая половина занимает принципиальную позицию: "это мои деньги", "так честнее", "а вдруг развод"... При этом больше трети опрошенных ошибочно уверены, что при разводе сохранят свои пенсионные накопления — и именно они чаще сознательно отказываются от общей выгоды

Но значит ли это, что оптимальным решением всегда будут общие счета?
Короткий ответ (как обычно) - все не так просто. (Gladstone, Garbinsky, Mogilner, 2022) показывают, что пары с полностью общими счетами реже расходятся и сообщают о более высокой удовлетворенности браком, чем пары с раздельными финансами — независимо от дохода — но это только корреляция. А в эксперименте (Olson, Rick, Small, Finkel, 2023), где молодоженов случайно распределили в группу с общими и раздельными счетами, положительные эффекты наблюдались все два года: у пар с общим счетом типичное для новобрачных охлаждение просто не произошло, в отличие от тех, кому достались раздельные счета

Впрочем, стоит отметить, что общий счет — не универсальное решение: авторы статей сами признаются, что слияние финансов требует отказа от части независимости, и в неблагополучных или потенциально токсичных отношениях общий счет создает риск контроля над партнером, а не гармонию

#канал_обозревает
@causal_channel



📚 Обещанного месяц ждут :)

В начале августа мы писали про книгу Мартина Хубера «Impact Evaluation in Firms and Organizations» и упомянули, что автор собирается выложить лекционные слайды по её мотивам [см. пост]. И вот буквально вчера профессор Хубер ими поделился

Слайды доступны и готовыми PDF, и исходниками в LaTeX, так что их можно пересобрать под свои нужды. Материалы готовили коллеги автора: K. Lötscher, S. Oberhänsli и A. Stoller

Заодно на странице появился код на Stata (раньше там лежали только R и Python), так что теперь доступны все три языка, а к ним и датасеты из примеров книги

Все материалы можно найти здесь https://www.unifr.ch/appecon/en/research/text-book-impact-evaluation-in-firms-and-organisations.html

#канал_рекомендует
@causal_channel

927 0 15 1 24

Forward from: Совет молодых учёных ЭФ МГУ (СМУч)
🎓Осенняя серия семинаров Chamberlain, 2026–27

11 сентября 2026 в 19:00 (МСК) — тематическая сессия: Новые методы эконометрики в экономике развития и рандомизированных экспериментах

В программе:
– Michael Gechter (University of Arkansas):
Selecting Experimental Sites for External Validity
– José Luis Montiel Olea (Cornell):
Externally Valid Selection of Sites via the k-Median Problem
– Davide Viviano (Harvard):
Evidence Aggregation with Ignorance in Mind: Learning what we do not know for archetypes discovery

Формат: онлайн (подробности подключения — на сайте и в рассылке организаторов)

Также открыт приём заявок на тематические сессии 2026–27. Организаторы отдельно приглашают исследователей, которые сейчас находятся в начале своей карьеры. Там же можно предложить будущих спикеров

Подробности


Коллеги из Совета молодых учёных поделились анонсом онлайн-семинара по эконометрике имени Гэри Чемберлена, который пройдет в ближайшую пятницу

Тема в этот раз очень интересная и продолжает обсуждение, начатое в июле на NBER Summer Institute [см. пост]. Все три доклада семинара посвящены тому, где проводить эксперимент, чтобы его результатами потом можно было пользоваться в других местах. Один из них уже звучал на секции Frontier Econometric Methods

Мы уже подходили к этому вопросу с другой стороны, когда разбирали эффект «падения напряжения» (voltage drop) [см. пост]. Среди пяти угроз масштабирования List (2022) называл репрезентативность: программу проверяют на одних, а разворачивают на других, и эффект от неё снижается. Интересно, что здесь за эту угрозу берутся на стадии дизайна, пока эксперимент ещё не проведён

• Michael Gechter снова расскажет о той самой работе с байесовским теоретико-решающим выбором площадок, где и случайный выбор, и выбор регионов с максимальным ожидаемым эффектом заметно проигрывают оптимальному (Gechter et al., 2024)
• José Luis Montiel Olea подходит к этой задаче иначе и сводит выбор площадок к задаче о k медианах из комбинаторной оптимизации (Olea et al., 2024)
• Davide Viviano в июле рассказывал, как планировать эксперимент, результаты которого потом будут объединены с наблюдаемыми данными (слайды, R-пакет). В этот раз вместе с соавторами они сделали следующий шаг и расскажут, как агрегировать накопленные свидетельства с явным учётом того, чего мы про них не знаем (Breza et al., 2025)

#канал_зовёт
@causal_channel


О роли пауз

Представьте хирурга, который полгода провел в командировке, почти не держа в руках скальпель. Или акушера, который девять месяцев не принимал сложные роды. Что происходит с навыками, если профессионал долго не практикует?


Экономическая теория утверждает, что навыки не хранятся вечно, они требуют подкрепления практикой. Но проверить это на практике почти невозможно из-за проблемы самоотбора

В системе здравоохранения США есть интересное правило назначения командировок для военных врачей, которая решает эту проблему: врачей отправляют в командировки квазислучайно, независимо от их квалификации и желаний [Fitzgerald, Gupta, Schwab, 2026]. Средняя командировка длится около полугода, и в это время врачи в основном обрабатывают раны и стабилизируют пострадавших, то есть делают совсем не то, чем обычно занимались по основному месту работы

Что происходит после возвращения?
Когда хирург возвращается из командировки, первые два месяца риски негативных исходов для пациентов растут: вероятность повторной госпитализации после операции увеличивается почти на 48% относительно базового уровня [Fitzgerald, Gupta, Schwab, 2026]

Хорошая новость заключается в том, что это временно: к третьему месяцу эффект ослабевает вдвое, а к шестому месяцу хирург статистически неотличим от себя самого "до командировки"

С акушерами история интереснее и тревожнее. После возвращения из командировки они начинают на 74% чаще выбирать кесарево сечение [Fitzgerald, Gupta, Schwab, 2026]. И вот тут авторы исследования делают ключевую проверку: может, случаи просто становятся объективно сложнее? Выясляется, что связи с риск-профилем женщит нет. Значит, изменения связаны не с пациентками, а с врачами. А еще этот эффект держится куда дольше — до девяти месяцев!

Но почему эффекты отличаются?
Авторы интерпретируют различия как разницу между двумя видами мастерства: исполнением процедуры руками и клиническим суждением — способностью принять правильное решение в условиях неопределенности. "Ручные" навыки восстанавливаются быстро, а вот для восстановления суждений требуется гораздо больше времени

Сколько именно "стирается"?
Авторы показывают, что удвоение количества недавно рассмотренных случаев снижает риск повторной госпитализации у хирургов на 17%, а частоту выбора кесарева сечения у акушеров — на 11% [Fitzgerald, Gupta, Schwab, 2026]. То есть свежий опыт работает. Похожий, хотя более слабый, эффект обучения на практике находили и у парамедиков в Миссисипи: удвоение числа вызовов сокращало время до госпитализации на 2,6% [David, Brachet, 2011]

Но самое интересное — в том, как врачи накапливают свой профессиональный капитал. Хирурги ежегодно сохраняют около 60% накопленного профессионального капитала. У акушеров эта цифра близка к нулю: их эффективность почти полностью определяется недавней практикой, а не многолетним стажем [Fitzgerald, Gupta, Schwab, 2026]. Другими словами, "ручные навыки" возможно сохранить, а вот для профессий, связанных с суждениями перерывы приводят к значительному откату профессиональных компетенций: стаж в двадцать лет назад не спасает, если последние девять месяцев вы не принимали сложные роды

Как облегчить возвращение?
Здесь у исследования есть практический совет: хирурги, которые после возвращения сначала брали больше простых, похожих операций, показывали примерно вдвое меньший рост осложнений на сложных случаях [Fitzgerald, Gupta, Schwab, 2026]. То есть возвращение маленькими шагами реально работает. Это согласуется и с более ранними наблюдениями о пользе смежной практики для восстановления квалификации [Schilling et al., 2003]

Не только про врачей?
История про хирургов и акушеров — это, по сути, история про любую сложную профессию, где решения принимаются в условиях неопределенности. Технические навыки восстанавливаются относительно быстро. А вот профессиональная интуиция, чувство границы приемлемого риска, готовность действовать без подстраховки — восстанавливаются медленнее и требуют не одного дня, а систематического возвращения в практику


#канал_обозревает
@causal_channel


📚 Книга по причинному выводу

Недавно мы писали про прикладное и облегчённое введение в причинный анализ от Мартина Хубера и упомянули его более раннюю и фундаментальную книгу «Causal Analysis: Impact Evaluation and Causal Machine Learning with Applications in R». Книга вошла в финалисты PROSE Award 2024 в категории Computing and Information Sciences – и заслуженно: по охвату методов идентификации это весьма достойный текст

Структура учебника строится по нарастающей сложности идентификационных стратегий: от эксперимента и линейной регрессии к selection on observables, causal machine learning, instrumental variables, DiD, synthetic control, RDD/kink/bunching designs. Автор рассчитывает на наличие у читателя базовых знаний теории вероятностей, регрессионного анализа и навыка тестирования гипотез, но не перегибает с избыточной детализацией, погружая читателя лишь в необходимые для повествования детали

Относительно конкурентов книга выгодно выделяется наличием современных инструментов, которые редко встречаются в стандартных учебниках по causal inference. Вместе с разрывной регрессией Хубер разбирает regression kink design и bunching designs, обсуждает ситуацию частичного выполнения предпосылок в главах про partial identification и sensitivity analysis, а также разбирает нарушения SUTVA в главе про interference effects

Рынок учебников по causal inference за последние годы сильно вырос. На наш взгляд книга Хубера занимает нишу между двумя лагерями. С одной стороны – популярные онлайн-учебники вроде «Causal Inference: The Mixtape» Каннингема и «The Effect» Хантингтона-Кляйна, которые выбирают разговорный, интуитивный тон изложения и осознанно жертвуют частью формальной строгости ради доступности для более широкой аудитории. С другой стороны рынка — классические тексты типа Angrist & Pischke, которые дают строгий формальный аппарат, но почти не касаются causal machine learning и не покрывают такие узкоспециализированные темы, как bunching designs или interference effects

Книга подходит продвинутым в статистике студентам, аспирантам и исследователям. Каждую главу сопровождают примеры на R, но, в отличие от «Firms and Organizations», без дублирования на Python. Тем не менее учебник хорошо закрывает задачу понимания границ применимости методов и даёт обзор тем, которые обычно остаются за рамками стандартных курсов

Напоминаем, что про другие книги по причинному выводу можно почитать тут, тут и тут

#канал_рекомендует
@causal_channel


📵 Аппарат абонента выключен?

С 1 сентября 2026 года миллионы российских школьников больше не смогут использовать телефон на уроке. Приказ Минпросвещения № 316 закрепляет обязанность не пользоваться мобильной связью на занятиях, исключение – только угроза жизни и здоровью или другие экстренные случаи


Такой подход был принят не только в России. По данным ЮНЕСКО, к марту 2026 года подобные ограничения действовали уже в 114 образовательных системах мира – это 58% всех стран (UNESCO GEM)

А есть ли доказательства, что запрет телефонов реально повышает успеваемость и улучшает атмосферу в школе?

В прошлом году мы уже разбирали, как форма взаимодействия с учебным материалом влияет на его усвоение, в посте про рукописные и электронные конспекты. Тогда выяснилось: дело не в самом устройстве, а в том, что оно провоцирует — многозадачность или концентрацию. Со школьными телефонами логика похожая: убрать девайс – не значит автоматически убрать проблему внимания

Почему гипотеза вообще звучит правдоподобно
• Эксперименты показывают, что само присутствие смартфона на столе – даже выключенного – снижает доступную рабочую память и способность к сложным рассуждениям (Ward, Duke, Gneezy, Bos, 2017)
• Здесь работает классический эффект отвлечённого внимания: если часть учеников тайком листает ленту, страдает концентрация не только у них, но и у соседей по парте (Glass, Kang, 2019)

Первые доказательства выглядели впечатляюще
• Самое цитируемое исследование в этой области – работа Луи-Филипп Беланд и Ричард Мерфи по Англии. Используя difference-in-differences на данных 91 школы и 130 482 учеников, они показали рост результатов итоговых экзаменов GCSE в британской средней школе на 0,064 стандартного отклонения, причём почти весь эффект достался слабоуспевающим ученикам – рост на 0,142 SD против нуля у сильных (Beland, Murphy, 2016)
• Похожий результат был получен для Испании: синтетический контроль по региональным запретам в Галисии и Кастилии-Ла-Манче показал рост успеваемости учащихся, эквивалентный 0,6–0,8 годам обучения, и снижение случаев буллинга на 15–18% в Галисии и 9,5–18% в Кастилии-Ла-Манче (Beneito, Vicente-Chirivella, 2022)

А потом начались сюрпризы
• Швеция первой поставила под сомнение универсальность этого рецепта: DiD на 1423 школах не нашёл вообще никакого эффекта на тестовые результаты, причём точность оценок позволяла отвергнуть даже прирост в 0,02 SD (Kessel, Hardardottir, Tyrefors, 2020)
• Флорида добавила неожиданный сюжетный поворот: в первый год после запрета выросли дисциплинарные инциденты и отстранения, а тесты вообще не сдвинулись – положительный эффект появился только на второй год (Figlio, Özek, 2025)
• Для Норвегии был получен, пожалуй, самый поучительный результат. На данных 161 371 ученика средний эффект на успеваемость и психическое здоровье оказался нулевым. Но за этим нулём скрывалась существенная неоднородность: у девочек средний балл по всем предметам вырос на 0,08 SD, результаты по математике – на 0,22 SD, а обращения к специалистам по психологическим симптомам сократились почти на 60% (Abrahamsson, 2026)

Самые свежие результаты ещё любопытнее
• В Чили запрет действительно снизил рекреационное использование телефона на уроке, но тестовые результаты вообще не изменились: эффект статистически неотличим от нуля. Более того, ученики стали немного хуже оценивать собственные способности к предмету – снижение примерно на 3% относительно исходного уровня, при полном отсутствии выигрыша в знаниях (Shi, Villarroel, 2026)
• В крупнейшом американском исследовании школ, где использовались запирающиеся чехлы Yondr (около 4600 школ), тоже обнаружился близкий к нулю средний эффект на результаты тестов (Allcott et al., 2026)
• Но! Единственный крупный предзарегистрированный эксперимент, проведённый в Индии на 16 955 студентах: обязательная сдача телефонов перед парой повысила средний балл по всем предметам на 0,086 SD, причём выигрыш снова достался в первую очередь слабоуспевающим и первокурсникам. Интересная деталь: студенты, испытавшие запрет на себе, стали заметно лояльнее к самой идее ограничений (Sungu, Choudhury, Bjerre-Nielsen, 2025)

Так работает или нет?
Если честно суммировать всю эту разноголосицу, то получается, что запреты телефонов надёжнее меняют поведение в классе, чем средние академические результаты. Они действительно уменьшают использование устройств на уроках, но не гарантируют заметного роста успеваемости для всех – часть эффекта съедают конфликты внедрения, неполное соблюдение правил и перенос экранного времени на дом. Выгоды почти везде концентрируются у одних и тех же групп – слабоуспевающих, девочек, детей из менее обеспеченных семей. А какие эффекты покажет эта практика в России мы узнаем только через несколько лет

Сегодня же – прекрасный повод не грустить о статистике, а просто порадоваться началу нового учебного года. Поздравляем всех причастных с Днём знаний! Пусть в этом году будет больше настоящей вовлеченности и концентрации – на паре, за исследованиями, в разговоре с коллегами – и поменьше поводов лишний раз потянуться за телефоном 🎉📚

#канал_обозревает
@causal_channel


📊 Причинный вывод для реальных данных

Предостерегающий штамп прикладного исследователя о том, что корреляция не означает причинность распространился довольно широко, и это хорошо. Но обратной стороной медали стало то, что исследователи стали изобретать обтекаемые обороты, которые намекают на причинность, но позволяют им от этого намёка откреститься: «уникально предсказывает», «связан после контроля на», «объясняет вариацию»
Джулия Рорер собрала эту претензию в лекцию и назвала её нарочито иронично: «Уникально ли практики причинного вывода предсказывают качество причинного вывода?» (слайды, запись)

Лекция входит в годовую серию Люксембургского института здоровья про причинный вывод для реальных данных. Несмотря на то, что организаторы и спикеры часто связаны с медициной, эпидемиологией и биостатистикой, содержание докладов может заинтересовать широкий круг исследователей

🧱 Основания
• Питер Теннант открывал серию введением в направленные ациклические графы (directed acyclic graph, DAG)
• Джорджия Томова разбирала композиционные данные (compositional data), где переменные связаны условием суммы: доли нутриентов или бактерий нельзя менять по одной, потому что рост одной означает падение остальных (запись)

🎯 Что считать эффектом
• Матс Стенсруд разбирал, что стоит за словами «угасание защиты» (waning), «гетерогенные эффекты» и «перетекание эффекта» (spillover) в вакцинных исследованиях, на материале малярии, ВИЧ, гриппа и ковида (запись)
• Фабриция Меалли говорила про двудольную интерференцию (bipartite interference), когда воздействие применяется к одним единицам, а исходы измеряются у других (запись)
• Микела Баччини переводила эффекты загрязнения воздуха на язык потенциальных исходов (potential outcomes) ради осмысленной кривой доза-ответ (запись)

🤖 Можно ли это автоматизировать
• Мигель Эрнан вынес вопрос прямо в заголовок и сразу оговорился: чтобы ИИ ускорил причинные исследования по медицинским базам, надо сначала разобраться, чем являются и ИИ, и сам причинный вывод (запись)
• Сара Мальякане представляла масштабируемые методы поиска причинной структуры по данным (causal discovery) (запись)
• Мартин Хубер читал про каузальные леса (causal forests) и двойное машинное обучение (double machine learning) с примерами на R (запись)

Любопытно, но пока мы писали этот обзор, заметили, что эти три направления очень хорошо ложатся в двенадцать вызовов, которые статистики поставили себе на десятилетие

Новый сезон лекций обычно объявляют осенью – будем следить за анонсами!

#канал_рекомендует
@causal_channel


Разделяй и властвуй?

Периодически звучат предложения о необходимости разделить слишком большие компании (например, тут, тут и тут), но что в этом случае значит "большие"?

Представим, что компания контролирует 80% рынка. Должны ли антимонопольные органы немедленно вмешаться — запретить её практики или даже разделить бизнес?


Интуитивно кажется, что 80% — это уже много, но новая работа Рикардо Перес-Трульи и Джеффри Юсофа показывает, что людей волнует не размер компании сам по себе, а то, во что этот размер превращается для потребителей [Perez-Truglia, Yusof, 2026]

Авторы опросили более 4000 респонденов на материале пяти реальных антимонопольных дел против крупнейших компаний — Google, Meta, Apple и др. Участникм давали один из четырех фактов о компании: долю рынка, аргументы о вреде потребителям (в виде высокой цены/снижения качества), нечестные практики или не относящийся ко вреду потребителям скандал

Перед стартом опроса авторы опросили экспертов-экономистов, и большинство предсказывали, что главным триггером в ответах о необходимости разделения компаний станет огромная доля рынка

Эксперты ошиблись:
🔵Доля рынка не повлияла на желание поддержать иск или разделить компанию: люди, по-видимому, не считают большую долю рынка проблемой сама по себе, так как она может отражать удобство, качество продукта или другие преимущества
🔵Репутационные скандалы вызывали неприязнь к компаниям, но не привели к требованию реформ
🔵Аргумент о нечестных практиках (блокировке соперников, эксклюзивных соглашениях и т.д.) работал внутри конкретного дела, но слабее переносился в общую поддержку антимонопольной политики
🔵Прямой ущерб потребителям (высокие цены, падение качества) оказался самым усточнивым триггером поддержки действий антимонопольного ведомства: он заметно поднял поддержку разделения фирм, этот эффект сохранился через месяц после первого опроса и перенесся в целом на антимонопольную политику

А если компанию всё-таки делят — это работает?

Даже если суд одобряет разделение, механически "распилить" монополиста недостататочно. Эмпирические исследования показывают, где проходит грань между успехом и провалом:

🔵Нельзя отдавать "обрезки". Чтобы возник жизнеспособный соперник, отчуждаемый дивизион обязан включать ключевые технологии, патенты и команду, иначе бизнес быстро деградирует [Kwoka and Valletti, 2021]. Структурные меры восстанавливают конкуренцию только тогда, когда продается работающее, автономное предприятие, а не набор разрозненных складов и оборудования [FTC, 2017]
🔵Риск сброса балласта. В ритейле корпорации стараются продать слабейшие точки [Dong et al., 2026]

Раньше мы писали, что люди могут ошибаться и строить расходящуюся с реальностью картину мира, но оказалось, что в антимонопольных вопросах общество интуитивно рассуждает как академические экономисты: размер компании — это не порок, если от него выигрывает потребитель

Проще говоря, размер компании сам по себе мало кого убеждает. Продуктивный разговор в сфере антимонопольной политики начинается не с цифры доли рынка, а с обсуждения конкретного механизма вреда: становятся ли из-за рыночной власти компании цены выше, выбор меньше, качество ниже, а вход для конкурентов — труднее

#канал_обозревает
@causal_channel


20 last posts shown.
