


Как посчитать миллиарды уникальных значений, используя всего несколько килобайт памяти
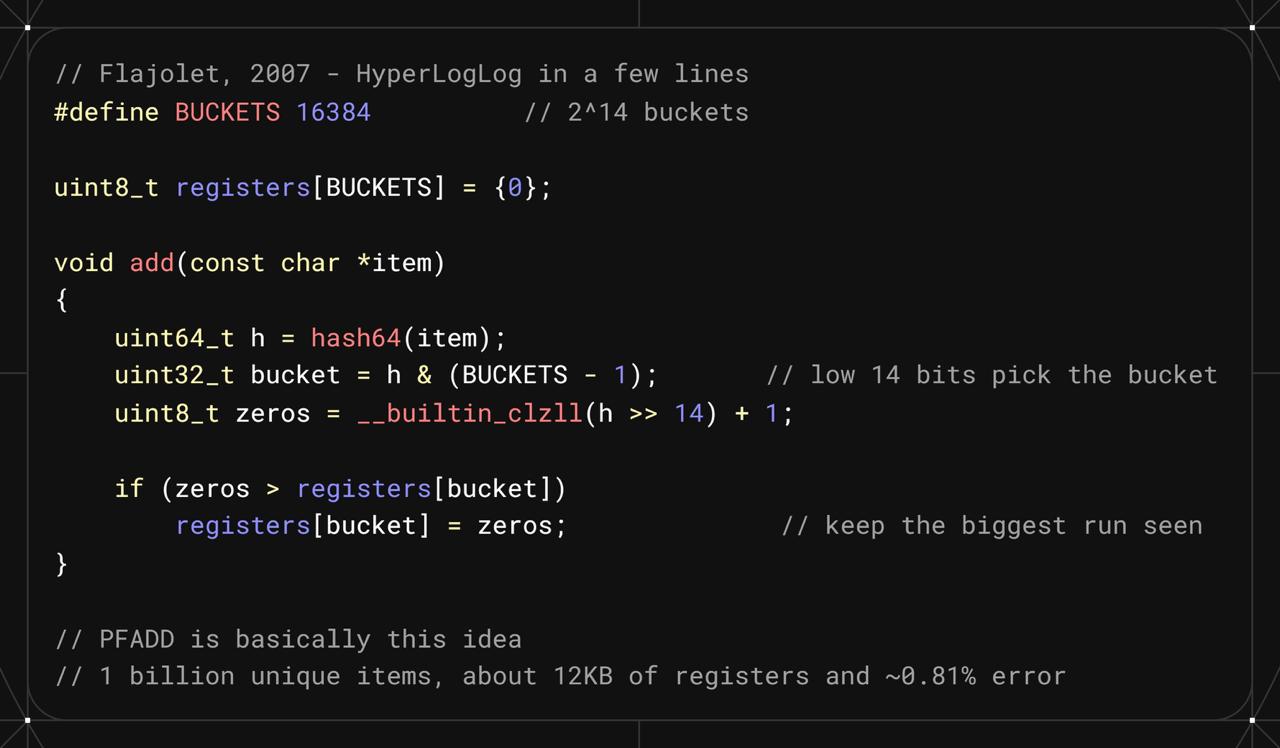
Для этого существует HyperLogLog - вероятностный алгоритм оценки количества уникальных элементов.
Вместо хранения каждого значения он:
— хеширует элементы
— распределяет их по buckets
— отслеживает необычно длинные последовательности нулей в хэшах
— по этой статистике оценивает cardinality
Например, с 16384 регистрами можно оценивать даже огромные множества, занимая порядка десятков килобайт памяти.
При этом ошибка может оставаться около 1%.
Именно поэтому HyperLogLog любят в аналитике и больших данных: посчитать COUNT(DISTINCT ...) для миллиардов объектов можно без хранения миллиардов ID.
Магия тут не в точности до последнего элемента, а в очень хорошем компромиссе между памятью и результатом.