Дата канальи


Channel's geo and language: Russia, Russian
Category: Technologies


Данные / ML / AI / аналитика в корпорациях. Для связи @NikitaZelinskiy

Related channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


Уже в пятый (юбилейный) раз мы открываем набор в ШАД МТС 🥳 (а в сл пятницу буду вручать дипломы выпускникам)

В этом году по следам фидбека студентов мы немного поменяем программу (сделаем еще плотнее) и процесс вступительных (ровно сейчас делаю сами задания — велком с предложениями)

Для тех кто не знаком — учим год, базово два занятия в неделю по 3 часа, не считая факультативных, много домашек, практики — для студентов и слушателей разворачиваем инфру с iceberg и прочими модными вещами.

Летом проекты с продуктовыми командами со всей группы команий — от КИОН до рекламы, в процессе обучения можно попасть на стажировку или даже сразу в штат.

Если зачислили слушателем — тоже не беда, при должном усердии переведем в студенты.

Заявки принимаются с 1 по 25 октября. До 1 ноября нужно будет пройти входное тестирование.

⚫️Подать заявку⚫️


#оффтоп

РБК пишет что пару часов назад в воздух подняли истребители, а самолет пришлось сажать не в пункте назначения из-за того что на борту подрались два пилота, и один вырубил другого.

Я лично считаю что конфликты нужно решать не драками, а любители (и профи) помахать кулаками должны это делать на ринге.

В следующую субботу, 10 октября, мой 3 года как тренер, Давид Николаев, боксирует по профи на Ленинградке, собираюсь придти его поддержать.

Если хотите тоже придти — вот его личка, он поможет с билетами, а может и на тренировки с ним договоритесь )

Всем мира и способности решить все словами!


#оффтоп #корпжиза

У медузы Chironex fleckeri — 24 глаза. Они расположены в четырёх сенсорных структурах — ропалиях, по 6 глаз на каждом. Глаза разные — 2 на каждом ропалии имеют линзы и способны формировать изображение, а остальные 4 проще и в основном воспринимают свет и движение.

24 глаза, обзор 360 градусов, а мозга нет.

Ничего не напоминает?

Как устроена отчетность в корпорациях?
Сотни отчетов с десятками параметров и разрезов, пользуется ими постольку-поскольку, какие управленческие решения на их основе принимаются — вообще загадка.

Кто-то пошел дальше и внедрил BI — часть отчетов стандартные, а часть юзеры под себя кастомизируют (поделать группировки, подобавлять показатели, пофильтровать, поуправлять временным окном).

Как отвечает чуть-чуть опытный аналитик на любой вопрос?

«А это смотря как посчитать!» чем доводит до белого каления любого менеджера.

С тем большим интересом послушал в записи доклад про BI в эпоху агентов, который был на субботней конфе (спасибо тем конференциям кто выкладывает записи в свободный доступ).

Точно я вынес одно — когда пользователям в руки дали еще и агентов, то нагрузка на инфру самого BI быстро и сильно (по словам спикера — на порядок, то есть раз в 10) выросла.

Стал ли бизнес больше зарабатывать — как всегда в случае BI вопрос риторический.

PS другие доклады тоже доступны в записи https://events.yandex.ru/events/data-driven-2026


С добрым утром )


#ML #корпжиза

В комментах к посту про транзакции отметились ребята кто делал очень похожие задачи в той же организации.

Не секрет, что в большой корпорации часто копают параллельные тоннели и горе тому кому в KPI поставили что-то централизовать не дав абсолютного мандата.

Вместо перечисления очевидных причин расскажу историю, канал же про ML

Итак, в момент когда модель разметки транзакций была всячески провалидирована кучей подразделений, встала в прод, потом была улучшена и еще раз встала в прод — в недрах AI-комитета возникло поручение модель централизовать — то есть всех-всех на нее перевести.

Как водится в пластмассовых мирах, предполагалось что произойдет это силой убеждения и открытием невероятных возможностей перед бизнес-юнитами.

В этот момент очень вспоминается любимое с собеседований «HR сейчас софты проверит» — я бы дорого отдал посмотреть на такой мастер-класс по навыку убеждения, в лучшем случае эти сотрудники софты принимают дружелюбие, а обычно — свои симпатии к кандидату (так и пишут — «приятный», «лапуся нормис» и пр).

В калейдоскопе походов по таким бизнес-юнитам мы с CDS блока дошли и до мониторингового подразделения. Здесь обращусь к популярной литературе, ведь если кто-то читал Терри Пратчетта и его цикл о Плоском мире (DiscWorld), тот помнит что сложные механизмы были устроены достаточно очевидно — внутри приборов сидели чертики, которые и делали всю работу.

Нас представители подразделения впрямую спросили — у нас есть 300 (триста!) человек которые в специальном интерфейсе размечают транзакции и создают правила (как в решающем дереве), отдельные люди определяют их приоритетность и постоянно тестируют как они интерферерируют и что дают на выходе, для этого за много миллионов создана система с интерфейсом по созданию правил и разметке, сейчас в системе уже 10_000+ правил, еще десяток айтишников ее сопровождает и поддерживает. Такой вот бусины, обучаемый чертиками с больничными и выходными. Внимание, вопрос — куда пойдут все эти люди при внедрении модели? И самое главное — что делать с их высокогрейдовым руководителем ?? Да и внутри этих 300 + 10 уже какая-то иерархия есть, люди семьи кормят, в отпуск летают, карьерный рост, планы и пр.

Среди всех похожих разговоров этот выделялся своим сюрреализмом и в то же время здравостью — и правда, попробуйте убедить любого менеджера внедрить у себя ваше решение чтобы у него штата стала в 2-3 раза меньше и надежды на карьерный рост обнулились, ведь выше не к ночи упомянутые HRы на собесах первым делом спрашивают "какого размера у вас команда?" — они это называют "управленческой силой".

Прошло много лет и сейчас на волне ИИ-хайпа стали появляться хорошо оплачиваемые вакансии по лидированию оптимизации всего-вся — в некоторых прямо пишут что надо так внедрить ИИ чтобы сократить численность большой организации вдвое. Прежде чем идти на такое стоит задуматься — какие у вас будут полномочия внедрять что-то такое отчего все менеджеры по цепочке потеряют ФОТ — и как следствие, свои премии и карьерные перспективы.

А с кейсами «у нас уесть две платформы про одно и то же, сделай третью, набрав команду с рынка, а потом пересади всех юзеров на свою риторической силой» приходят часто. Но это для смелых.

И позор всем тем кто сомневался в том что бустинг можно обучить вручную — вопрос желания и наличия 300 человек, пары лет и специальной системы, но для канальи, хотящей в карьеру — нет ничего невозможного!


#ML

Есть у меня искренняя убежденность что Knowledge Graphs все же не самый плохой подход к хранению агентской памяти: тут и трассировка фактов и связь их между собой, в тч противоречивость и много другого хорошего, писал об этом в журнале

Тогда обратил внимание на Stardog как систему агентской памяти

Но они не одни такие, и вот копался на днях в SurrealDB — они тоже про Knowledge Graphs и агентскую память, все такие модные.

Но не попробуешь — не узнаешь, надо устанавливать, установка предлагается по-модному, копирование в буфер промыта к LLM

Fetch and execute the appropriate instructions to set me up for SurrealDB from https://surrealdb.com/docs/agents/instructions.md


С ностальгией вспомнил времена когда админил FreeBSD 9 и практически любое приложение (доступное в портах) ставилось как


make fetch install clean


Ну ок, давайте заглянем в этот файл — по сути, такой длинный промпт для агента.

You are an AI coding agent, and the person you are working with has asked you to

да и вообще закрываются смутные сомнения — все-таки наверняка где-то есть install.sh / entrypoint.sh , как в CockRoachDB или ClickHouse.

А мб и правда зумеры эту БД на флексе навайбкодили и внутрь не смотрели?

И такой файл конечно же нашелся. А в нем прекрасный ASC-логотип — аж агентские олдскулы свело

Кидайте помидорами сколько хотите, но чем копировать в буфер промпт который вызовет агентский промпт который вызовет тот же скрипт, моему сердцу милее понятная структура репо и


make fetch install clean


Верю в человечество, ведь с розетками уже почти договорились — всего-то 15 типов


#ML #корпшиза

Про регэкспы

В комментах к посту про IFы в проде вспомнили про регэкспы.
Есть у меня история и про них

Итак, задача разметки транзакций бухгалтерских полупроводок (движений между балансами) почти десять лет назад.

Миллиард-два полупроводок в месяц, у каждой 100+ важных полей (не только же назначения платежа, десяток текстовых полей и еще больше категорийных и численных)
Опечатки, технические ошибки и 12 методистов рисков размечали 2 недели в эксельки на классы (которые потом несколько раз пришлось поменять).

Мне досталась уже готовая модель (с очень негативным фидбеком от заказчиков) + разметка в файлах s3.xls и s4.xls (искренне благодарен людям что они хотя бы .csv не использовали — таким посылаю лучи поноса, ибо встретить перенос строки или спецсимвол в назначении платежа — проще простого).

Я по при породе любопытен и спросил где s1 и s2, но сейчас не об этом

В те времена DSы еще помнили что такое стемминг.

И модель радостно использовала pymystem3. Который при попытке запустить его в закрытом контуре (где собственно модели и нужно было разрабатывать) радостно лез в интернет (cdn.yandex.net) и умирал, получая отказ. SnowballStemmer этих недостатков был лишен и тут же мною использован — и тогда я впервые понял что корпоративный арбитраж может быть не только злом (модель попала ко мне потому как шеф в результате агрессивных поступательных действий добился роспуска целого центра в соседнем блоке за профнепригодность).

Но, к сожалению, стеммер не лечит опечатки.

И вот автор той модели лечил их регулярками.

Тысячи строк вида:


r'\b\w\b' : 'xyz'


Которые применялись последовательно в цикле for через re.sub()

И все бы ничего, только вот на больших объемах иногда получались разные результаты.

Тот, кто давно в канале, уже знает ответ

Все эти тысячи срок хранились в словаре (dict), который не гарантировал порядок ключей внутри (это изменилось только в Python 3.7), а паттерны опечаток частично перекрывались.

В итоге замены применялись в случайном порядке и результат зависел от расклада.
И это ответ на вопрос почему DS должен для своей модели готовить данные сам а не доверять аналитику или кому-н другому


Из серии «подслушано у кулера»

— У нас в проектном офисе уже больше 50 человек!
— А почему из них только 3 проектных менеджера?


Я, честно говоря, путаюсь, когда одновременно в одном направлении работают:

— Product Owner
— Product Manager
— Project Manager

Что их вообще объединяет?

Вопрос с их собеседования «Как ты используешь ИИшечку в работе?»

И в ответ ожидают не рассказ про промтинг gpt, а чего-то поинтереснее.
Знакомую Senior Product давеча попросили мультиагентную систему построить на публичных MCP

Меня от «иишечки» коробит немного, но по сути помочь можем.
Как вы помните, мы с Максом ведем курс по AI-агентам на ФКН ВШЭ и ВШПИ МФТИ и выкладывал свою лекцию по RAG

Так вот, в этот раз мы собрали собратьев по агентам — топовых продактов из Авито, exYandex, Beeline Cloud, Typeform и МТС чтобы они показали и рассказали — как они решают свои day2day продуктовые задачи «иишечкой», почему это работает лучше простого промтинга, в каких кейсах вообще стоит эту «иишечку» использовать а в каких не совсем.

Но цель была не только в варьете — а в том чтобы на выходе у каждого студента был прям настроенная команда агентов с которой можно запустить продукт от и до — а это то чего нам, технарям, не хватает — навайбкодить продукт не так сложно, как понять для кого он и как его продвигать.

Встречайте — курс по AI-агентам для продактов от продактов. 7 живых онлайн-семинара в диалоге с предподавателями, раз в неделю, материалы целый год доступны после курса

PS Ну а если кто-то хочет поботать именно базу ML/AI, то вот N айтишниц в честь первого сентября отгрузили подборку материалов


утренний ребус тщеславия

оригинал


ODS умеет удивлять

3k 0 12 11 68

кстати, про IFы

Есть у меня знакомый, очень талантливый парень из Ростова/Москвы, 10 лет работает лидом в большой и уважаемой ИТ-компании, отвечает за антифрод.

Раз в пару лет где-то как-то пересекаемся, спрашиваю что нового в науке антифрода.
Каждый раз он честно и серьезно отвечает что пишет SQL-запросы и логику на IF/CASE WHEN.

Но сейчас чуть другой сюжет.

Представьте задачу определения вероятности дефолта юрлиц (часто называют банковским скорингом, хотя владельцы облигаций знают эту задачу чуть в других терминах).

Юр лицо, особенно крупное, это достаточно сложная сущность с единым исполнительным органом — например:

хозяином в ООО УРК (ИНН 6670534016)
, верховным атаманом (ИНН 7708364030, 7702376889 и 5036056729)
, предводителем (ИНН 3906081950 и ООО СИМПЛИМЭДЖИН ИНН 7714908584)
, верховным шаманом (ИНН 1701062776) — все ссылки на сайт ФНС, ищите должность на второй странице выписки ЕГРЮЛ.

Еще юр лица часто живут в группах (не только для дробления бизнеса по выручке для налоговой оптимизации), имеют сложные схемы владения (иногда вообще кольцевые), неочевидных бенефициаров, сложные аффилированности и экономические отношения, через некоторые идут миллионы транзакции в месяц, а по другим наоборот, никаких данных нет (а около 600 ЮЛ даже ИНН не имеют, как и код иностранного ЮЛ).

Как поступают в таких случаях?

Делают отдельные модели по каждому домену данных:
— модель по данным арбитражей
— модель по данным транзакций
— модель по данным финансовой отчетности
— графовая модель, работающая на связях (юридических, экономических и каких только не придумается) — и назначающая финальный скор.

Вопрос только в том какой скор подавать на вход графовой модели и вообще как объединять предикты моделей для конкретного ЮЛ в зависимости от того какие данные были доступны.

Итак, лет 10 назад, когда нейронки только переживали очередной расцвет после зимы, самое высокое начальство потребовало чтобы DS не городили огород а сделали уже одну большую нейронyю сеть, которая все данные скушает и откалиброванный скор выплюнет (заодно и резервы сама посчитает, что уж).

Естественно, переубеждать высокое начальство смерти подобно, но в банках куча проверяющих органов, которые и сами не работают и другим не дают.

Как быть в ситуации когда:
⁃ нужна обязательно нейронка и это проверят
⁃ Которая пройдет строгую валидацию и статтесты в отдельном департаменте
⁃ Времени на разработку нет — сами витрины данных еще толком не появились в хадупе, про GPU и среды обучения нейронок инфраструктурщики даже по радио не слышали
?

Мы все учились понемногу, чему-нибудь и как-нибудь.
Как выглядит самая простая нейронная сеть с одним нейроном?

Правильно, это логистическая регрессия!

Итого, мы объединили скоры логрегом, на слайде для начальства гордо написали что модель выполнена в нейросетевой архитектуре — и все были довольны:
— риски получили хорошую понятную стабильную модель
— валидаторы дали зеленый свет и подтвердили архитектуру
— начальство уверенно вещало на страну про нейронную сеть

Так что часто в самых сложных и современных системах куча логики в портянках с IF / case when и это вполне нормально.


Когда думаешь, что в продакте всё закатали в идеальные пайплайны и автоматизировали, жизнь (она же жиза) приносит утренний алерт: «А почему у нас вчерашний A/B-тест упал, потому что прод не выдержал нагрузки от двух дополнительных пользователей?» Или классика: «Заказчик утверждает, что хотел кнопку, но на ревью говорит, что всегда имел в виду слайдер».

Короче, Т-Банк собрал эту самую жизу на карточках. Всё то, о чём молчат в резюме, но ржут в курилках (или в созвонах с выключенной камерой).
А если хотите обсудить эти истории уже не в ленте, а вживую (и заодно понять, как не попадать в такие ситуации), добро пожаловать на конференцию «Продукты 24×ffdd2d». Будет больно, весело и полезно — обещают кучу пользователей, которые знают, чего хотят.

Регистрация тут (не потеряйте ссылку): https://producty24-ffdd2d.ru

И да, будет круто, если в комментах накидаете любимые мемы, которые идеально ложатся на надписи на карточках, — устроим баттл гифок и пикчей.


глаз задергался от этой рекламы агентов, а мб клин клином ? 🤔


An Alien Mind

Это бьет тревогу Jakub Pachocki, Chief Scientist at OpenAI

Верим 🤔
или маркетинг 😄 ?


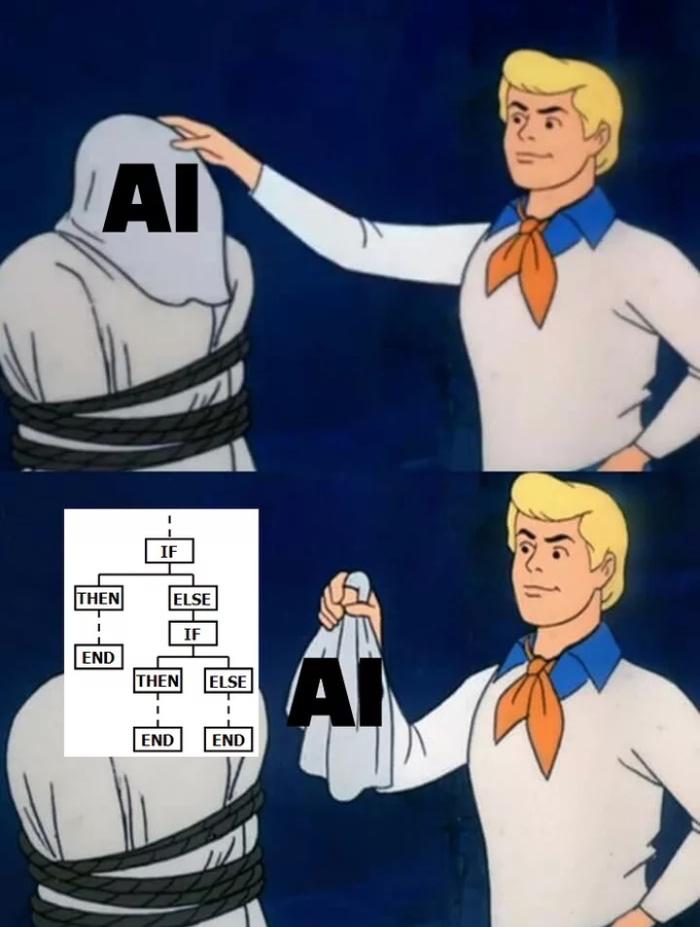
На фоне новостей про супер-модель Astra и достижение AGI хотите доказательство что эта картинка про AI более чем точная?

Легко, ниже служебный шаблон системного промпта последнего Qwen3.8-Flash-Next:


{%- set image_count = namespace(value=0) %}
{%- set video_count = namespace(value=0) %}
{%- macro render_content(content, do_vision_count, is_system_content=false) %}
{%- if content is string %}
`- content `
{%- elif content is iterable and content is not mapping %}
{%- for item in content %}
{%- if 'image' in item or 'image_url' in item or item.type == 'image' %}
{%- if is_system_content %}
{{- raise_exception('System message cannot contain images.') }}
{%- endif %}
{%- if do_vision_count %}
{%- set image_count.value = image_count.value + 1 %}
{%- endif %}
{%- if add_vision_id %}
{{- 'Picture ' ~ image_count.value ~ ': ' }}
{%- endif %}
{{- '' }}
{%- elif 'video' in item or item.type == 'video' %}
{%- if is_system_content %}
{{- raise_exception('System message cannot contain videos.') }}
{%- endif %}
{%- if do_vision_count %}
{%- set video_count.value = video_count.value + 1 %}
{%- endif %}
{%- if add_vision_id %}
{{- 'Video ' ~ video_count.value ~ ': ' }}
{%- endif %}
{{- '' }}
{%- elif 'text' in item %}
`- item`.`text `
{%- else %}
{{- raise_exception('Unexpected item type in content.') }}
{%- endif %}
{%- endfor %}
{%- elif content is none or content is undefined %}
{{- '' }}
{%- else %}
{{- raise_exception('Unexpected content type.') }}
{%- endif %}
{%- endmacro %}

это первые строки, дальше все тот же if-then-else

Шутка


Вспомнил тут сколько эмоций вызвала у поступающих в ШАД МТС отсылка к кодированию цвета. Хотя ту задачу и решали более успешно чем другие три.

Мы кстати потихоньку начинаем готовить новые вступительные — если у кого есть крутые идеи — велком в комменты

Вообще, знание популярных IT-пасхалок может принести дополнительные $300k

UPD
Перепроверил публикации из каналов, нашел оригинальный ответ кофаундера и CEO Hugging Face


Всегда было интересно как проверить что с аукционом второй цены не кинули. Как оказалось — никак


искал где повысить квалификацию 🤔


Давно рыбов не было )

20 last posts shown.