





Deckhouse | Для инженеров
Делаем инфраструктурную платформу с контейнерами, VM, ML-нагрузками и сервисами данных под единым управлением:
deckhouse.ru
Информационный канал с релизами и материалами для инженеров и технических специалистов.
Русскоязычное сообщество:
@deckhouse_ru Related channels | Similar channels
1 173
subscribers
Popular in the channel
Сколько лучших инженеров на самом деле заняты продуктом, а сколько — тем, чтобы инфраструктура пр...
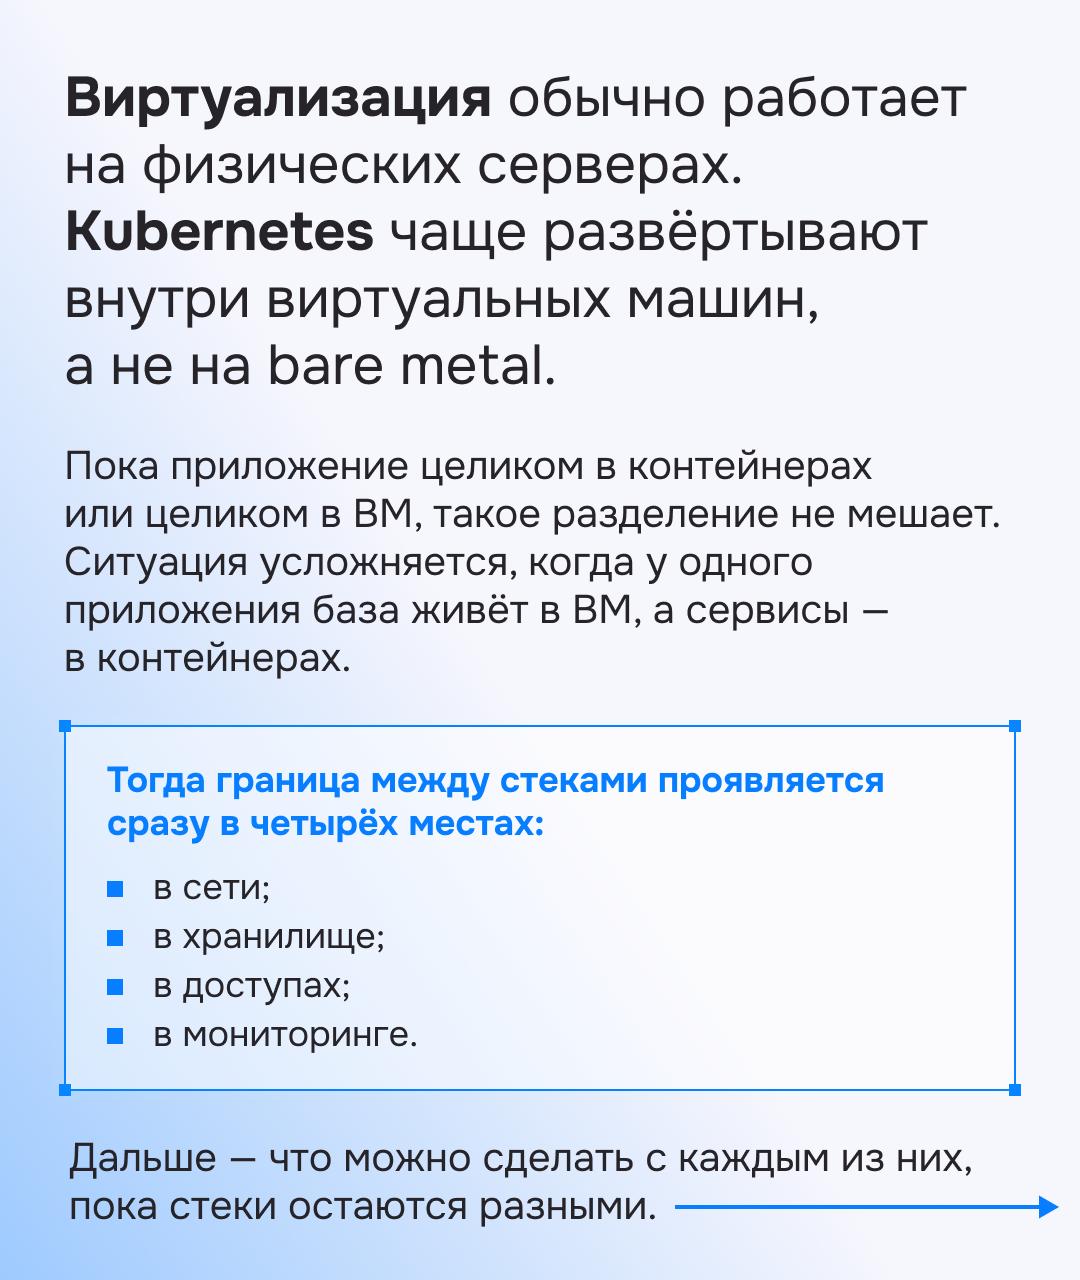
Часто виртуализацией и Kubernetes в компании занимаются разные команды. Пока приложение целиком р...
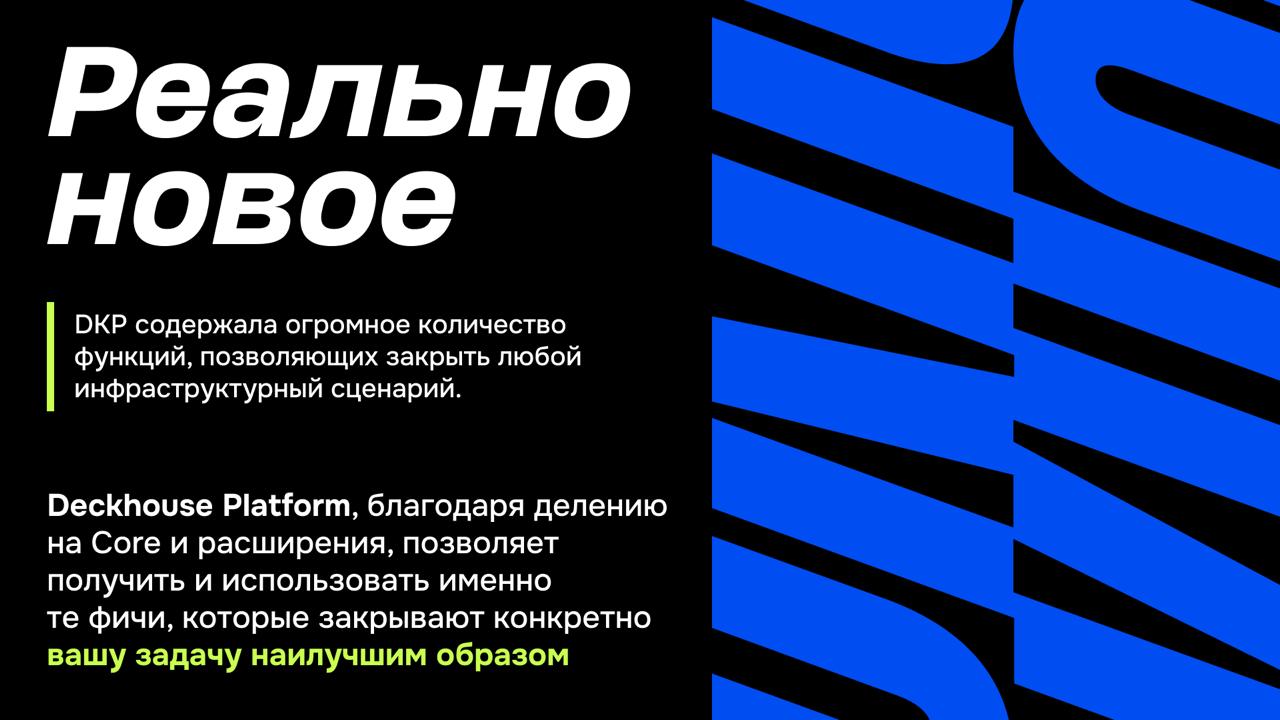
Если вы работаете с DKP, у вас наверняка есть вопрос: что с ней произошло после анонса Deckhouse ...
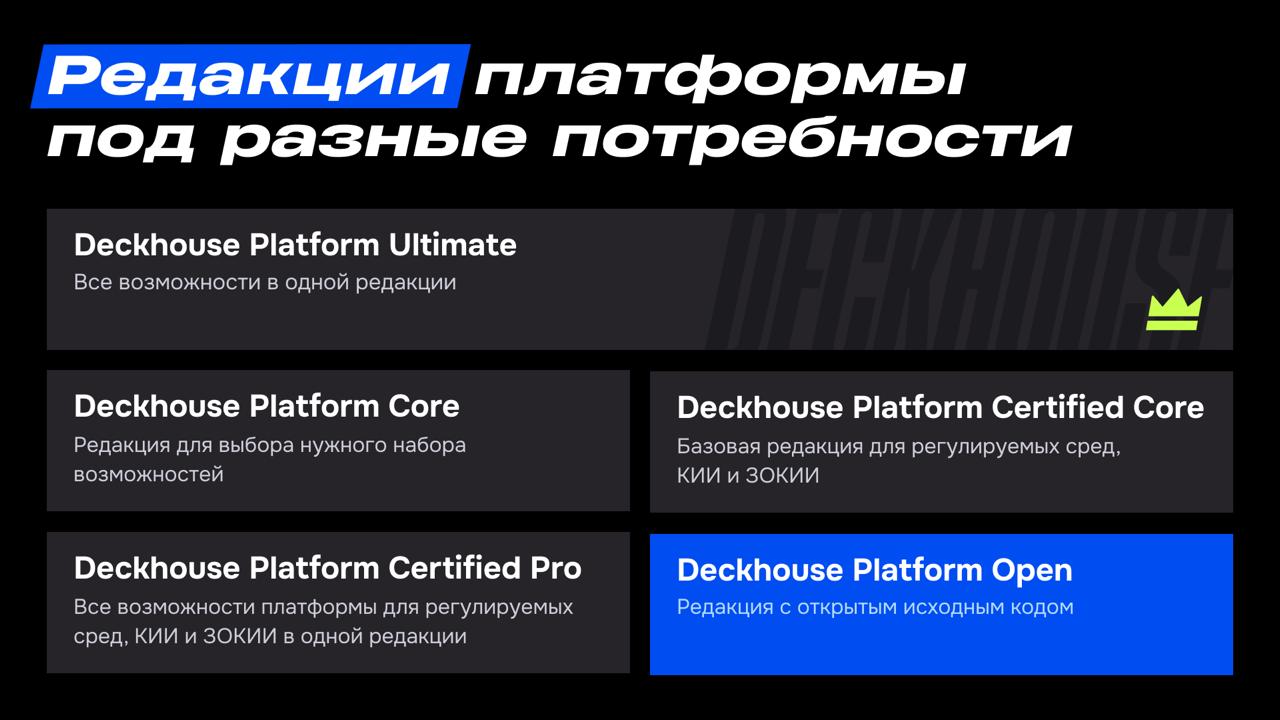
Deckhouse Platform закрывает большую часть рутины по обслуживанию инфраструктуры, поэтому у инжен...
«Уберу перед пушем в мастер…» — так токены и остаются в истории гита навсегда. За 2025 год из-за ...