Машинное обучение в биологии и биомедицине | OpenBio.Edu


Channel's geo and language: Russia, Russian
Category: Education


Актуальные новости, вакансии и образовательные материалы о машинном обучении в биологии и биомедицине.
Старт нового потока запланирован на февраль 2027 года
Подробнее: https://clck.ru/3Cjbu5

Related channels  |  Similar channels

Channel's geo and language
Russia, Russian
Category
Education
Statistics
Posts filter


Forward from: openbio.ru
OpenBio-2026: наука, технологии и биотех-бизнес

22–25 сентября в наукограде Кольцово состоится XIII Российский форум биотехнологий OpenBio.

Мультиформатная площадка открытых коммуникаций включает:

🔺 Научная конференция молодых учёных в 6 секциях: молекулярная биология, вирусология, биофизика, биотехнология, биоинформатика и биомедицина.

🔺 Научную программу дополнят установочные лекции ведущих ученых об архитектуре и пластичности генома, осповирусах, молекулярном моделировании вирусных белков, микробиом-направленной терапии, микроорганизмах-биофабриках, вычислительном дизайне лекарств и предиктивной диагностике.

🔺Экспертная программа форума охватит экспериментальную вирусологию, (м)РНК- и генетические технологии, ИИ и данные в медицине, биобанкирование, новые правила депонирования, особенности защиты биотех и мед разработок и вопросы поиска и развития промышленных штаммов-продуцентов.

✅ Отдельный фокус — карьера учёного и возможности развития в науке и индустрии, а также практические потребности отрасли: аналитика доступности оборудования и реагентов, перспективные разработки и решения, закрывающие существующие дефициты.

Также в программе — бизнес-форум, выставка биотехнологических компаний и встречи учёных, разработчиков, инвесторов и представителей индустрии.

🗓️ 22–25 сентября 2026 года
наукоград Кольцово и интерактивная онлайн-трансляция

➡️ Регистрация и подробная программа


Forward from: Биомолекула
Предсказание пространственной структуры белка — задача, сформулированная еще Кристианом Анфинсеном, — на протяжении десятилетий решалась лишь косвенно. Ситуация радикально изменилась с появлением AlphaFold 1/2. Его успех был настолько значительным, что уже ознаменовался Нобелевской премией (в 2024 г.) и породил ощущение, что проблема в целом «закрыта».

Однако история этим не закончилась: современная версия — AlphaFold 3 — объединяет эволюционный подход, унаследованный от предыдущих поколений, и диффузионные модели, пришедшие из генерации изображений. Такое сочетание позволяет выйти за пределы белковых структур и предсказывать целые «молекулярные сцены» с участием малых молекул или нуклеиновых кислот. Станет ли AlphaFold3 панацеей — или структуры белок-лигандных комплексов требуют новых подходов?
Георгий Куракин, постоянный автор «Биомолекулы», пытается разобраться в этом вопросе с помощью Алексея Орлова, руководителя Лаборатории вычислительной биомедицины и молекулярной диагностики Центрального университета.

Читайте на нашем сайте.

Автор: Георгий Куракин

#Биомолекула_спецпроект


🧬 10 июня, 19:00 мск — уже скоро

Через несколько дней три лида из BostonGene выходят в эфир и честно рассказывают, как выглядит найм в биоинформатике с другой стороны стола.

Первый час — живой разговор про red flags, резюме и то, что нанимающий менеджер думает, но обычно не говорит. Второй — мок-собеседования вживую с разбором 3–4 участников.

🔥 Ещё можно попасть на разбор
Если хотите, чтобы ваше резюме разобрали прямо на эфире — осталось два дня. Заявки принимаем до 8 июня включительно.

Бесплатный фидбэк от людей, которые сами закрывают позиции — такое не повторяется по расписанию.

👉 Отправить анкету участника

📅 Сам вебинар — 10 июня, 19:00 мск: регистрация

Зовите тех, кто в поиске — пусть успеют подать заявку или просто придут на общение с экспертами👆


Мы позвали настоящих экспертов-технарей поговорить с вами про собеседование и найм

Мы тут подумали — а что если провести открытый семинар по карьере в новом формате? Не просто «послушайте лекцию», а реально разобраться, как устроено собеседование в биоинформатическую компанию — фактурненько, от начала до конца, глазами тех, кто нанимает.

Собрали сразу трёх лидов из BostonGene — с разных сторон биоинформатики:
Александр Сарачаков — Team Lead AI/ML, к.б.н., спикер курса «Машинное обучение в биологии и биомедицине» от OpenBio
Константин Чернышев — руководитель отдела биоинформатика (NGS division), опыт работы в биотехе 10 лет
Андрей Кравец — тимлид команды биоинформатиков (дата аналитики) с опытом 6 лет в биотехе

🎙 Первая часть — формат подкаста/интервью
Задавайте вопросы вживую. Мы поотвечаем на всё:
— на что смотрят при найме
— как правильно отвечать на вопросы
— какие red flags видит нанимающий менеджер
— и что наоборот даёт плюс в карму
— как вообще выглядит собеседование от начала до конца — с точки зрения лидов

🎯 Вторая часть — mock-собеседования вживую
Разберём 3–4 человека: коротко прогоним по резюме и по собеседованию. Скажем честно — прошёл бы / не прошёл, и почему. Что говоришь правильно, что нет. Никакой воды — только конкретный фидбэк.

Эксперты — народ занятой, но нашим самим интересно — так что формат будет живым. Зовите всех, кто ищет работу в биоинформатике или хочет понять, как проходят собеседования в топовые компании индустрии 👇

Регистрация для получения доступа на семинар тут.

Отправить свою анкету на конкурс резюме можно здесь.


📅 Ориентировочная дата — 10 июня 19.00 по мск


💡 Серия спринтов OpenBio

У нас много новеньких на канале (👋) и перед стартом курса «Машинное обучение в биологии и биомедицине» мы решили напомнить о трех спринтах, которые стали для многих первой точкой входа в ML.
Если вы проходили их раньше — самое время освежить материалы, а если нет — это отличный шанс быстрее втянуться в курс.

🔥 ML Bootcamp 🌤🌥☁️
Пятидневный интенсив по основам машинного о
бучения.Мы говорили о метриках регрессии, кластеризации, нейросетях и мультиомике.
Все это на реальных биомедицинских данных.
➡️ Bootcamp помогает познакомиться с различными разделами машинного обучения: с учителем, без и куда же без нейронных сетей! (А еще это хорошая возможность посмотреть на наших преподавателей в деле).

❤️‍🔥
LLM Sprint 🤫🫠🤥😶
Неделя, посвященная большим языковым моделям.Мы разбирали промптинг, сравнивали модели, учились использовать LLM в анализе статей, код-ревью, в планировании экспериментов и обсуждали риски addiction to LLM и даже
этические вопросы.
➡️ Этот спринт особенно полезен тем, кто работает с биологическими данными — он показывает, как встроить LLM в исследовательскую практику и повысить эффективность без потери научной точности.

🧨
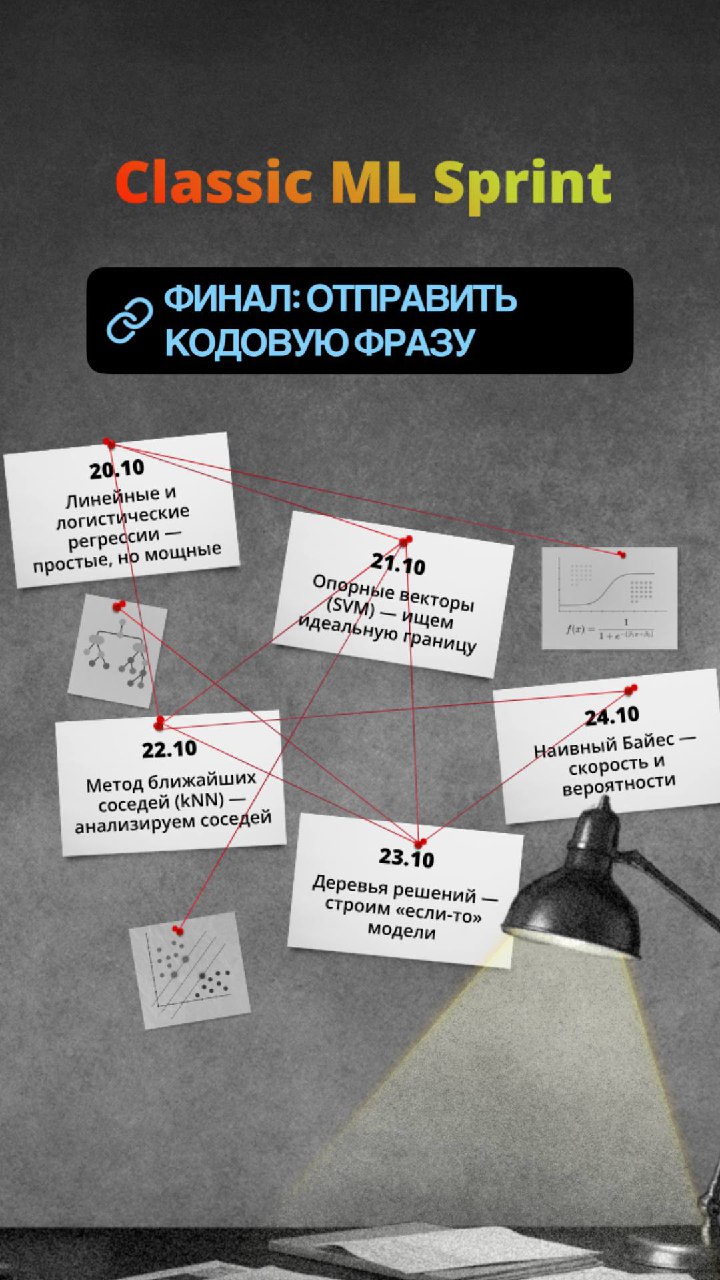
Classic ML Sprint 1⃣2⃣3⃣4⃣5⃣6⃣
Пять моделей за пять дней — регрессия, SVM, kNN,
деревья решений и Наивный Байес. Каждый день — возможность познакомится с одним из классических методов машинного обучения и попробовать себя в интерпретации результатов обучения моделей.
➡️ Идеальная разминка перед первым модулем курса — именно он основан на этих «классиках» машинного обучения.

Мы создаем спринты, чтобы вы не просто узнали о трендах, а прочувствовали их в работе. Это ваша возможность увидеть логику моделей, проникнуться вайбом мира ML и пойти на курс максимально подготовленным.

❕ Старт курса — 3 ноября! Это идеальный момент, чтобы разогреться перед основной программой.

P.S. И это не шутка:
следующий поток курса "Машинное обучение в биологии и биомедицине" запланирован аж на 2027 год. Если вы ждали знак — возможно, это он, повод весомый ✨.

#openbio_education

📌 Машинное обучение в биологии и биомедицине | OpenBio.Edu — подписывайтесь!


Начинаем через 10 минут!

Первый вебинар нового формата Open Code — уже на старте.
Сегодня вместе с Ильей Воронцовым разбираем batch-эффект:

➡️ Визуализируем данные,
➡️ Применим PCA,
➡️ Оценим вклад batch-эффекта
➡️ Посмотрим, как меняются результаты после коррекции.

Если еще не с нами — подключайтесь сейчас!
Успеете попасть в прямой эфир и задать вопросы

👉 [ссылка на подключение]

Заполняйте анкету что бы получить запись вебинара и готовый ноутбук!
Open code с Ильей Воронцовым
Смотрите онлайн Open code с Ильей Воронцовым 2 ч 6 мин 24 с. Видео от 28 октября 2025 в хорошем качестве, без регистрации в бесплатном видеокаталоге ВКонтакте! 214 — просмотрели. 6 — оценили.


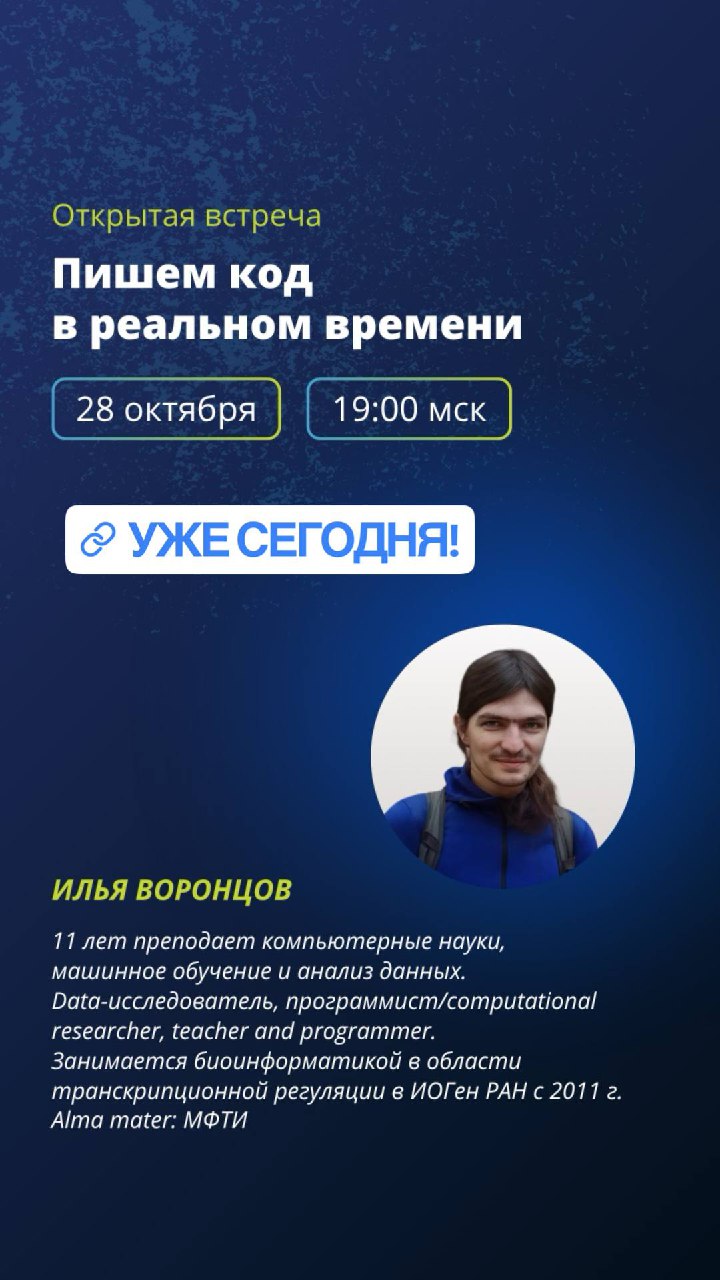
📲 Мы начинаем новый формат! Open Code — никаких слайдов, только данные и дискуссия, только live-коддинг 🤟

❕ Тема сегодня — batch-эффект в экспрессионных данных.

Он проявляется тогда, когда клетки группируются не по типам, а по тому, из какого образца они пришли. Из-за этого искажаются результаты кластеризации, определения типов клеток и реконструкции траекторий.

Но не всякая разница — batch-эффект. Иногда отличия между образцами действительно отражают биологическую реальность — например, в случае опухолевых клеток.

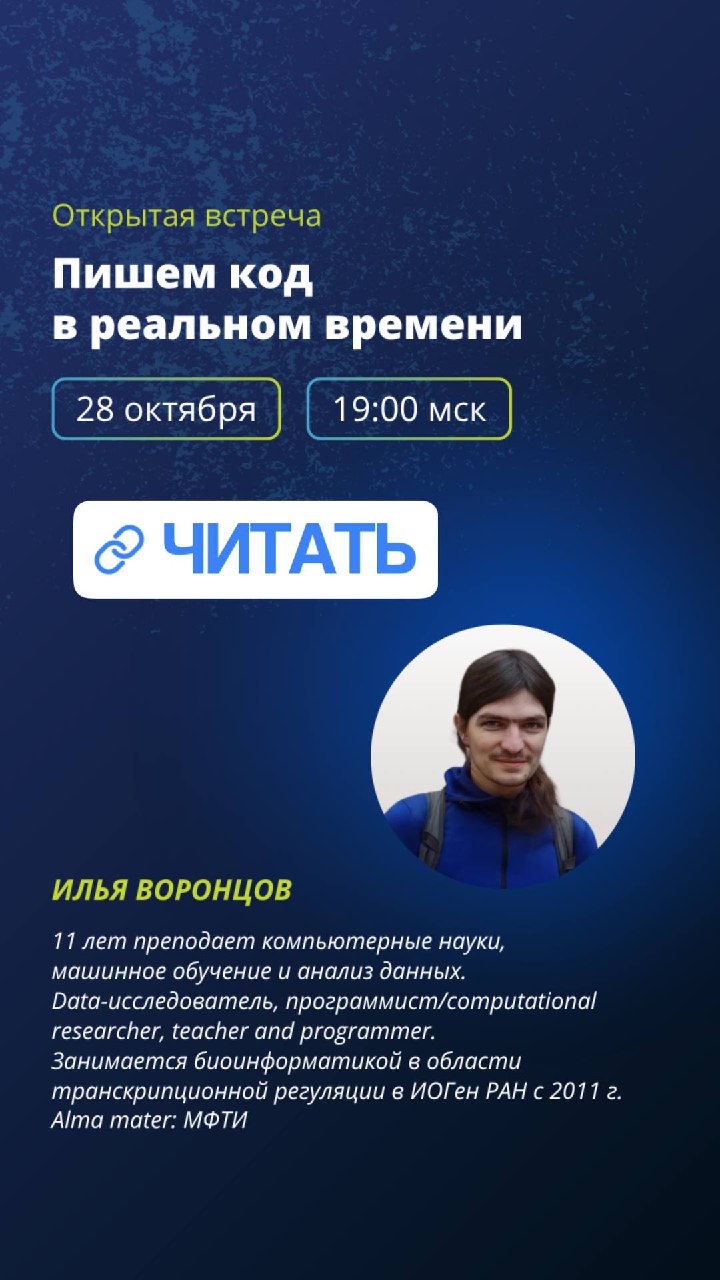
➡️ Разберемся в этом вместе с нашим постоянным спикером — Ильей Воронцовым, преподавателем первого модуля курса «Классические методы машинного обучения». Илья более 10 лет преподает машинное обучение и анализ данных, занимается биоинформатикой в области транскрипционной регуляции в ИОГен РАН, Alma mater: МФТИ.

📅 Сегодня в 19:00

Идет последняя неделя до старта курса, и мы хотим, чтобы у вас была возможность продолжить обучение с Ильей на самых лучших условиях.

Поэтому для участников вебинара мы подготовили самое щедрое предложение сезона. Подробности и промокод на максимальную скидку объявим в прямом эфире. Это наш способ поблагодарить тех, кто готов учиться и действовать.

✅ Не успеваете на эфир? Оставьте ваши контакты по ссылке — мы пришлем запись вебинара и ноутбук с готовым кодом.

📌 Курс "Машинное обучение в биологии и биомедицине" | OpenBio.Edu — подписывайтесь!

#openbio_OpenCode


💡 Истории наших выпускников

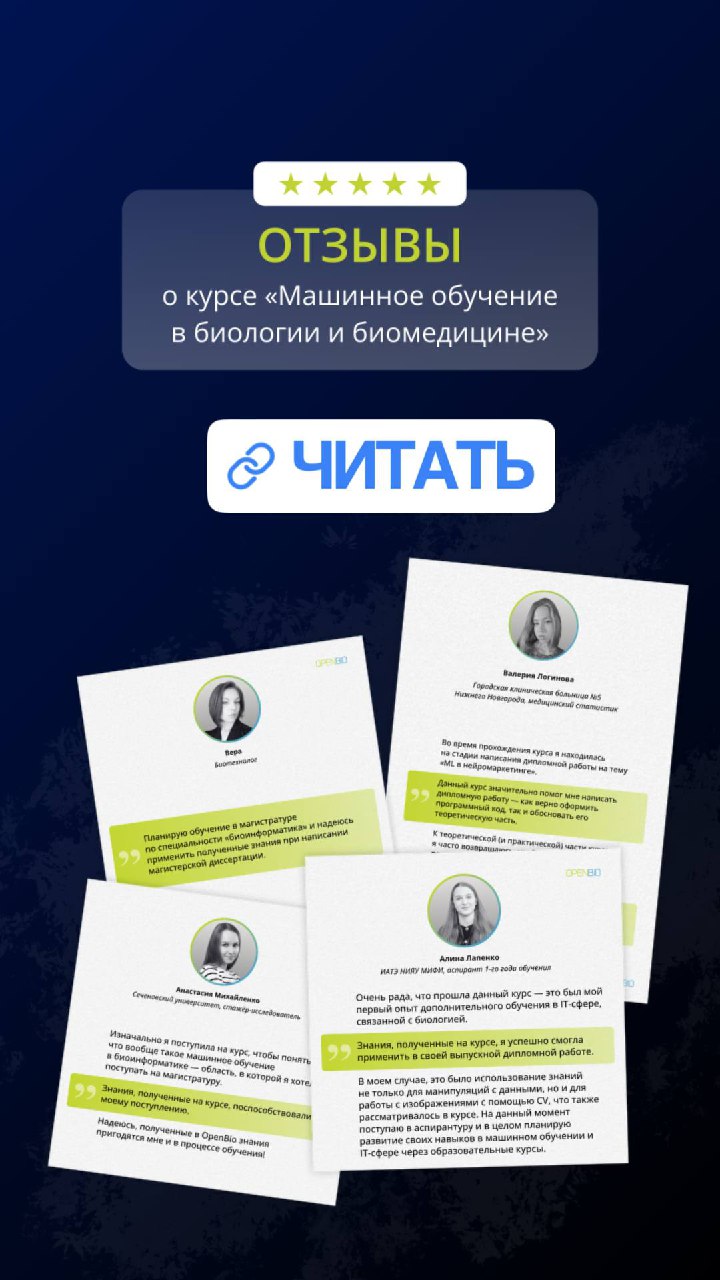
Мы вновь делимся нашей главной гордостью — выпускниками! Нам особенно приятно видеть, что выпускники OpenBio не останавливаются на достигнутом: поступают в магистратуры, защищают дипломные работы, развиваются в биоинформатике и смежных областях. Для нас это подтверждение тогочто наш курс стал тем самым кирпичиком в фундаменте знаний, на который можно уверенно опираться дальше.

🔺Валерия Логинова применяла машинное обучение в дипломной работе по нейромаркетингу и решила развиваться в направлении IT-медицины.

🔺Алина Лапенко использовала методы курса для анализа изображений и поступила в аспирантуру МИФИ.

🔺Вера планирует обучение в магистратуре по биоинформатике.

🔺Анастасия Михайленко после курса успешно поступила в магистратуру Сеченовского университета.

Эти истории показывают, как знания, полученные на курсе, становятся частью профессионального пути.
Для нас это лучший показатель того, что OpenBio действительно помогает расти — в профессии и в науке!

#openbio_graduates

📌Курс "Машинное обучение в биологии и биомедицине" | OpenBio.Edu — подписывайтесь!


❔Open Code: разберемся в данных вместе

28 октября в 19:00 — приглашаем на открытый вебинар с лайв-кодингом в прямом эфире.

На этот раз мы посмотрим на batch-эффект в экспрессионных данных и разберем, как его увидеть и скорректировать с помощью классических методов машинного обучения.

Вместе:
🔺Визуализируем данные и посмотрим, как проявляется батч-эффект;
🔺Применим PCA для уменьшения размерности;
🔺Используем линейную регрессию, чтобы количественно оценить вклад батчей и удалить его;
🔺Сравним результаты «до» и «после» коррекции.

Формат — open code session: все, что происходит на экране, можно повторить шаг за шагом.

↗️ Присоединяйтесь!

📅 Когда: 28 октября, 19:00 (МСК)

📌 Машинное обучение в биологии и биомедицине|OpenBio.Edu — подписывайтесь!


Анонс возможности попасть на первый модуль основной программы курса "Задачи классического ML для биологии и биомедицины".

📲Чтобы уверенно ориентироваться на любой карте, нужно научиться прокладывать маршрут самостоятельно: выбирать правильную дорогу, обходить препятствия и добираться до цели. Именно для этого мы запускаем отдельный доступ к первому модулю нашей основной программы «Классические методы ML» - 17 часов лекций, 9 часов семинаров, домашних проект с развернутой обратной связью.

Это уже не беглый обзор, а полноценная экспедиция, где мы вместе:
🔺Разберем теорию досконально: вы поймете не только что делает модель, но и почему она работает именно так.
🔺Перейдем к практике: на семинарах вы своими руками обучите модели, научитесь настраивать их и интерпретировать результаты.
🔺Выполните проект: закрепите знания на реальной задаче и получите подробную обратную связь от наших экспертов.

❕ Полная стоимость модуля — 29 900 ₽. Но вы уже сделали первый и самый важный шаг. В награду за ваше упорство мы дарим вам скидку 10 000 ₽ по кодовой фразе из викторины. Итоговая цена для самых пытливых исследователей — 19 900 ₽.

Это ваш шанс превратить недельный интерес в прочный и востребованный навык. Готовы перейти от карты к построению маршрутов — ждем вас на первом модуле!

➡️ Записаться на модуль по классическим методам машинного обучения


Поздравляем тех, кто дошел с нами до финала спринта ❤️

Наш экспресс-маршрут по миру классического машинного обучения окончен. В течение пять дней мы знакомили вас с логикой регрессий, мощью SVM, интуитивностью деревьев и скоростью Наивного Байеса. Надеемся, что нам удалось показать вам "карту местности": где находятся ключевые «города» и «реки» в области классических методов ML.

↗️ Спасибо тем, кто не просто читал посты, а анализировал графики и искал ответы в викторине и честно хотел заработать бонус от нашего проекта – мы ценим энтузиазм и настоящую мотивацию исследователя!

🎁 Для вас остался финальный штрих: соберите кодовую фразу из ваших ответов и отправьте ее в форму ниже. Для тех, кто дойдет до конца, приготовили бонус: скидку 10 000 ₽ на весь курс или…..при покупке первого модуля отдельно.

Отправить кодовую фразу и зачислить на счет бонус

В подарок вам сделали карточки-памятки по рассмотренным методам!

📩📥📤

📌 Машинное обучение в биологии и биомедицине | OpenBio.Edu — подписывайтесь!


Перед вами три графика: confusion matrix, ROC-кривая и распределение вероятностей.Попробуйте по ним понять, насколько уверенно модель делает предсказания и где остается зона неопределенности.
Poll
  •   На confusion matrix видно, что ошибок чуть больше у класса 0, чем у класса 1. Слово: верно
  •   Модель допустила одинаковое количество FP и FN. Слово: точно
  •   Вероятности в основном у краев (0 и 1), значит модель уверена лишь в редких случаях Слово:корректно
  •   AUC у ROC-графика около 0.7, модель работает посредственно. Слово: стабильно
  •   На гистограмме видно два пика около 0и1, значит модель часто уверена в предсказаниях. Слово:надежно
  •   На гистограмме видно, что большинство предсказаний сосредоточено около 0.5 Слово: уверенно
  •   Независимость признаков чаще всего выполняется, поэтому Байес идеален.Слово: правильно
  •   Нет верного ответа.


❔ Сегодня финальный день нашего спринта — и на сцене Наивный Байесовский классификатор.
После всех деревьев, соседей и опорных векторов он может показаться слишком простым. Но именно в этой простоте - его сила: Байес не ищет сложных границ, он просто оценивает вероятности и выбирает наиболее правдоподобный вариант.

Этот алгоритм часто недооценивают - а зря. Иногда именно он оказывается первым, кто находит закономерность, когда другие методы теряются в деталях.
И да, именно сегодня вы сможете собрать последнюю часть кодовой фразы.

📌 Машинное обучение в биологии и биомедицине | OpenBio.Edu — подписывайтесь!


Video is unavailable for watching
Show in Telegram
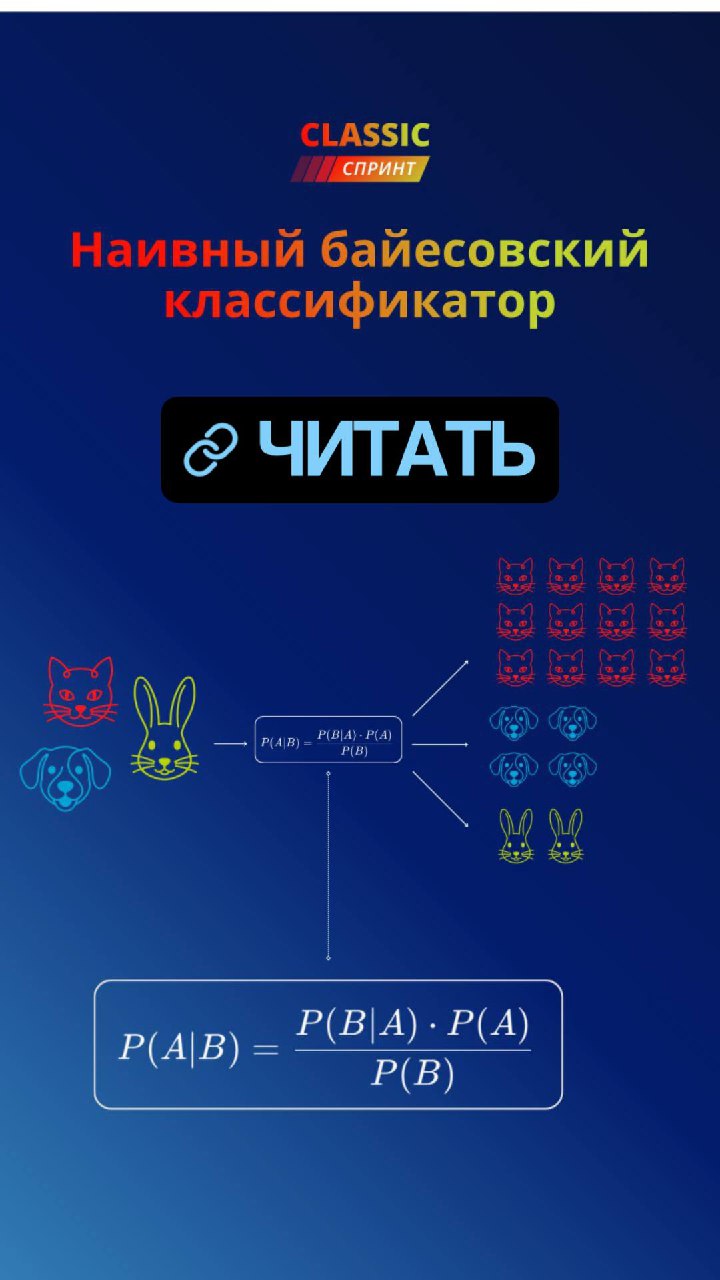
🧪 Наивный байесовский классификатор

Некоторые алгоритмы поражают своей силой именно в простоте. Наивный Байесовский классификатор - как раз такой случай. Несмотря на слово «наивный», он остается одним из самых популярных алгоритмов в медицине и биологии.

Как работает
Идея основана на формуле Байеса:

P(A|B) = [P(B|A) · P(A)] / P(B)

где P(A|B) - вероятность гипотезы А при условии признаков B

➡️ В классификации алгоритм считает вероятность, что объект принадлежит каждому классу, и выбирает класс с максимальным значением.

➡️ «Наивность» в том, что признаки считаются независимыми друг от друга. В реальности это редко так, но модель все равно часто работает хорошо.

✔️ Наивный Байес применяется, например, для первичной сортировки пациентов по симптомам.

Если в базе есть данные о том, как часто те или иные признаки встречаются при разных диагнозах, алгоритм быстро оценит вероятность болезни и выделит группу риска.
Такой инструмент может стать первым фильтром перед более сложной диагностикой.

▪️Давайте попробуем посчитать вместе, допустим, у нас есть данные о пациентах:

1️⃣ Вероятность гриппа в популяции — 10% (P(грипп)=0.1)

2️⃣ При гриппе 80% пациентов имеют температуру (P(температура ∣ грипп)=0.8)

3️⃣ Без гриппа только 20% имеют температуру (P(температура ∣ нет гриппа)=0.2)

Вероятность гриппа у пациента с температурой в нашем примере возрастает с исходных 10% (распространенность в популяции) до примерно 31%.
Алгоритм Байеса не говорит болен или здоров пациент, а пересчитывает шансы, учитывая новые данные

❕ Главное приемущество этого метода - его скорость: нет сложных гиперпараметров и настроек, можно обучить на тысячах пациентов за секунды.

❕ Ограничения

🔷Сильное упрощение. Независимость признаков почти никогда не выполняется. Например, давление и возраст часто связаны.

🔸Чувствительность к качеству данных. Если данные неполные или плохо подготовленные, результат сильно искажается.

🔷Не ловит сложные зависимости. Когда исход зависит от комбинации факторов, модель упрощает картину.

Наивный Байес — отличный финал нашего спринта ❤️

↗️ Вы уже собрали целый набор инструментов, с которыми можно смело заходить в биомедицинские данные: от регрессий до деревьев.

Спринт был коротким путешествием, но дальше начинается полноценная экспедиция — курс, где мы разбираем эти методы глубже, с практикой, проектом и поддержкой преподавателей.

📩📥📤

#openbio_education #openbio_MLSprint

📌 Машинное обучение в биологии и биомедицине | OpenBio.Edu — подписывайтесь!


Перед вами три блока: confusion matrix, ROC-кривая и feature importance. По этим графикам оцените, где модель ошибается чаще, насколько уверенно она разделяет классы и какие признаки действительно «тянут» решение.
Poll
  •   Feature importance показывает, что «worst radius» сильно доминирует среди признаков Слово: образцы
  •   На confusion matrix видно только ложноположительные ошибки. Слово: пациентов
  •   ROC-кривая дает AUC≈1.0, значит дерево разделяет классы идеально. Слово: индивидуумов
  •   На ROC-кривой видно, что AUC меньше 0.7, классификация почти случайная. Слово: респондентов
  •   Деревья решений почти всегда дают вероятность прогноза близкую к 0.5. Слово: испытуемых
  •   Важности признаков распределены равномерно Слово: объекты
  •   В confusion matrix видно, что ошибок больше у класса 0, чем у класса 1. Слово: точки
  •   Нет верного ответа.
2 votes


❔ Вчера мы смотрели, как kNN принимает решения «по соседям». Сегодня — разберёмся с деревьями решений

Дерево — это не чёрный ящик: каждое разветвление — конкретное правило «если → то». Посмотрим, насколько прозрачность помогает понять поведение модели на практике.
Каждый правильный ответ снова приближает вас к полной кодовой фразе.

📌 Машинное обучение в биологии и биомедицине | OpenBio.Edu — подписывайтесь!

16 last posts shown.