ideasAI / Идеи для ИИ - Анисимов Андрей


Channel's geo and language: Russia, Russian
Category: Technologies


Андрей Анисимов
Идеи для искусственного интеллекта
Канал про Data Science, ML/AI и карьеру в сфере анализа данных
AI BP в Альфа Банке, Согаз, ГПБ, Сбер, ВТБ
SKOLKOVO MBA15
Бег 1x42.2, 3х21.1
Пишите @aaanisimovvv

Related channels  |  Similar channels
Channel's geo and language
Russia, Russian
Statistics
Posts filter


Что было за неделю:

➡️Google давно написал инструкцию, как не сделать из ИИ ещё одну бесполезную кнопку в продукте 🧐 прочитать пост⁠

➡️400 000 - это сколько? Почти целая электростанция в Мытищах 🧐 прочитать пост⁠

➡️Пробую Дзен - подпишитесь 🧐 https://dzen.ru/ideasforai

➡️Meta* показала карманного AI-агента. *Meta Platforms Inc. признана в России экстремистской организацией, её деятельность запрещена 🧐 прочитать пост⁠

➡️ИИ может убрать технический долг и создать два новых 🧐 прочитать пост⁠

➡️4000 лет никто не может прочитать этот текст. А что, если дать его ИИ? 🧐 прочитать пост⁠

➡️У почвы тоже есть микробиом. ИИ уже пытается читать его почти как анализ крови 🧐 прочитать пост⁠

➡️У 2ГИС появился MCP-сервер. Посмотрел, есть ли в нём польза...🧐 прочитать пост⁠

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai

#дайджест


У 2ГИС появился MCP-сервер. Посмотрел, есть ли в нём польза...

Сам по себе MCP тут ничего магического не делает. Он просто даёт ИИ-агенту доступ к функциям 2ГИС.

⭐️ Сейчас их шесть: поиск объектов рядом, геокодирование адресов, обратный поиск адреса по координатам, маршруты между точками, расчёт зон доступности по времени и генерация статических карт.

Агент уже может не просто "найти кофейню рядом", а собрать цепочку из нескольких действий. На скринах - карта пешей доступности от метро в 5 и 10 минутах.

Также пробовали - подключили MCP к Codex и дали бизнес-задачу: сравнить две точки для доставки цветов в Екатеринбурге - у "Геологической" и у "Ботанической".

Условие простое: на машине доставка не должна занимать больше 20 минут. Для проверки взяли четыре адреса в разных частях города. Codex сам:

➡️нашёл координаты обеих точек;
➡️запросил у 2ГИС две зоны двадцатиминутной доступности;
➡️построил маршруты до контрольных адресов;
➡️сравнил время в пути;
➡️подготовил данные для итоговой карты.

Цветные области на карте - изохроны: реальные зоны, куда можно доехать за заданное время по существующим дорогам. Для выбора точки доставки это уже гораздо полезнее.

Можно сравнивать какая локация реально покрывает больше нужных районов за 20 минут. Одну такую задачу, конечно, можно сделать руками в картах.

Но если у вас 30 будущих точек, 200 адресов клиентов, разные интервалы доставки и это надо пересчитывать каждую неделю - тогда MCP начинает экономить время. Его можно использовать для:

1️⃣проверки новых точек перед арендой;
2️⃣расчёта зон доставки;
3️⃣сравнения филиалов между собой;
4️⃣поиска ближайших объектов по заданным условиям;
5️⃣геоаналитики внутри корпоративного AI-ассистента.

Пока продукт сыроват. Геокодер, например, не сразу понял названия станций метро. Итоговую красивую визуализацию тоже пришлось собирать отдельно - MCP дал данные, но не готовый аналитический отчёт в один клик.

Сам сервер бесплатный. Для запросов к 2ГИС нужен API-ключ. Сейчас есть деморежим на 30 дней, а в тестовом кабинете было по 1000 запросов на подключённые сервисы, дальше API уже платный.

P.S. попытался для примера проанализировать карту кофеен - из полезного карта пешей доступности, можно крутить много разной функциональности...

Полезные ссылки:

🔵Официальная документация MCP-сервера 2ГИС
🔵Официальный репозиторий MCP-сервера на GitHub
🔵Менеджер Платформы 2ГИС

#AI_и_работа

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


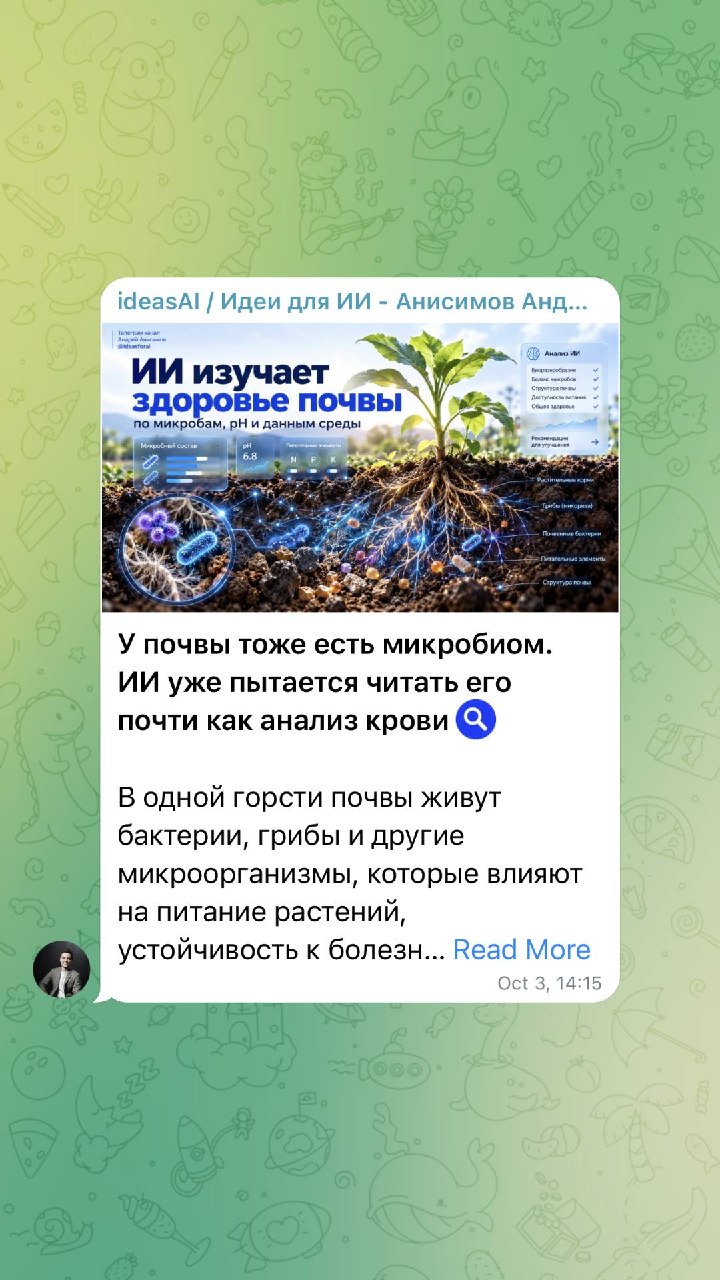
У почвы тоже есть микробиом. ИИ уже пытается читать его почти как анализ крови 🔍

В одной горсти почвы живут бактерии, грибы и другие микроорганизмы, которые влияют на питание растений, устойчивость к болезням и круговорот веществ. Сейчас исследователи собирают этот микробный "портрет", добавляют pH, углерод, влажность, погоду - и отдают всё машинному обучению.

Задачи очень практические: оценить здоровье почвы, заметить риск болезней, понять доступность питательных веществ и в перспективе точнее прогнозировать урожайность.

Есть уже занятные результаты.

1️⃣В исследовании 2025 года модель по данным бактерий, грибов и свойствам почвы предсказывала, насколько почва способна подавлять грибной патоген Rhizoctonia solani. Лучший вариант показал 98,56% точности на данных этого эксперимента. Это не "диагноз любой грядки с точностью 98%", но само направление уже выглядит серьёзно.

2️⃣А в работе 2026 года по томатам лучший результат получился, когда модели дали сразу микробиом + химические свойства почвы. Отдельно эти данные работали хуже. Исследователи также нашли связь избытка доступного фосфора, изменений микробного сообщества и болезней растений.

В будущем анализ почвы может выглядеть как гораздо более подробная картина: кто там живёт, что эти микроорганизмы делают и что это говорит о состоянии участка.

Но до сервиса "принёс банку земли - AI сказал, что сеять" пока далеко. Авторы прямо пишут, что большая часть таких систем остаётся на уровне исследований и пилотов. Почва очень локальна: модель из одного региона может плохо переноситься на другой климат, состав почвы и набор культур.

Кому интересно почитать:

🔵Обзор 2026 года по AI и микробиому почвы
🔵Исследование про Rhizoctonia solani и 98,56%
🔵Исследование 2026 года по томатам и микробиому почвы

#AI_и_наука

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


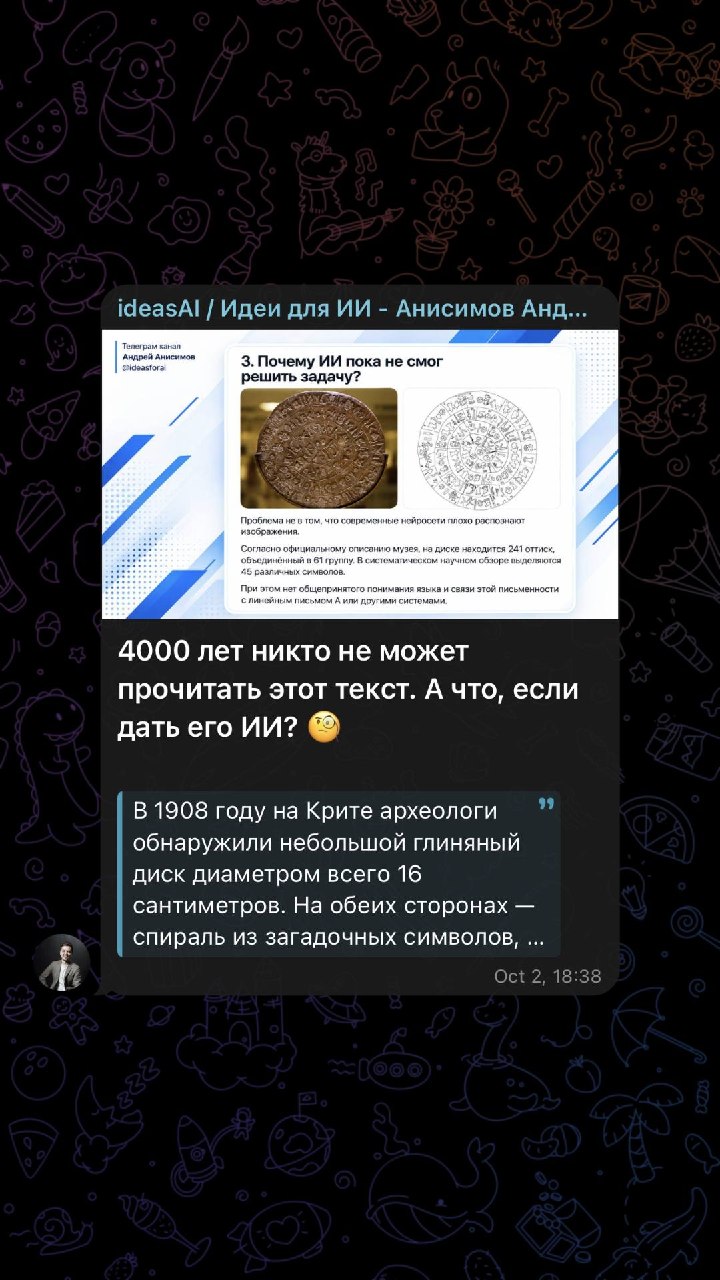
4000 лет никто не может прочитать этот текст. А что, если дать его ИИ? 🧐

В 1908 году на Крите археологи обнаружили небольшой глиняный диск диаметром всего 16 сантиметров. На обеих сторонах — спираль из загадочных символов, нанесённых с помощью специальных печатей.

45 уникальных знаков, 241 оттиск, 61 группа символов, предположительно обозначающих слова. И ни одного другого найденного текста, который позволил бы уверенно установить язык.


Это Фестский диск — одна из знаменитых неразгаданных загадок древнего мира.

Недавно наткнулся на статью РИА о лингвисте Гарете Оуэнсе, который заявил, что смог прочитать 99% надписи. По его версии, это религиозный текст, посвящённый богине-матери.

Но академическое сообщество пока не признало расшифровку окончательной. И мне стало интересно: неужели никто не пробовал решить эту задачу с помощью современных нейросетей?

Полез искать по международным площадкам. И нашёл несколько интересных экспериментов.

🟦Google Gemini. В январе 2026 года на SSRN появилась работа, в которой исследователь использовал Gemini для анализа диска. Получилась неожиданная гипотеза: перед нами не молитва, а древняя административная система, своеобразный аналог смарт-контракта, описывающий распределение ресурсов.

🟦GitHub. Нашёл целый исследовательский репозиторий Phaistos Disc Decipherment с цифровыми данными, словарями символов и многоэтапными попытками расшифровки. Авторы даже заявляют, что решили загадку, но независимого научного подтверждения пока нет.

🟦Научные исследования. В журнале Computational Linguistics опубликован большой обзор вычислительных методов дешифровки древних письменностей. Там рассматривают машинное обучение, статистику, сопоставление языков и способы работы с неизвестными системами письма.

Нейросети обучаются на триллионах токенов. А здесь у нас всего 241 знак, неизвестный язык и практически полное отсутствие сопоставимых текстов. Даже если модель предложит очень красивый перевод, как проверить, что она действительно прочитала надпись, а не придумала убедительную историю? 🤔

Я бы попробовал объединить GPT, Claude, Gemini и классические алгоритмы дешифровки. Дать им одинаковую цифровую последовательность символов, заставить независимо построить гипотезы, а затем проверить их статистически и сопоставить с известными древними письменностями.

Причём оценивать не красоту получившегося перевода, а то, насколько гипотеза выдерживает независимую проверку.

Ведь настоящее достижение ИИ — не предложить ещё одну интерпретацию загадки, а найти способ доказать, что она верна.

Кто знает, возможно, именно нейросети помогут нам однажды прочитать послание, оставленное почти четыре тысячи лет назад. А пока загадка остаётся открытой.

Кому интересно почитать:

🔵Исследование с Gemini
🔵GitHub с материалами дешифровки
🔵Научный обзор MIT Press
🔵Оригинал диска в музее Ираклиона

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


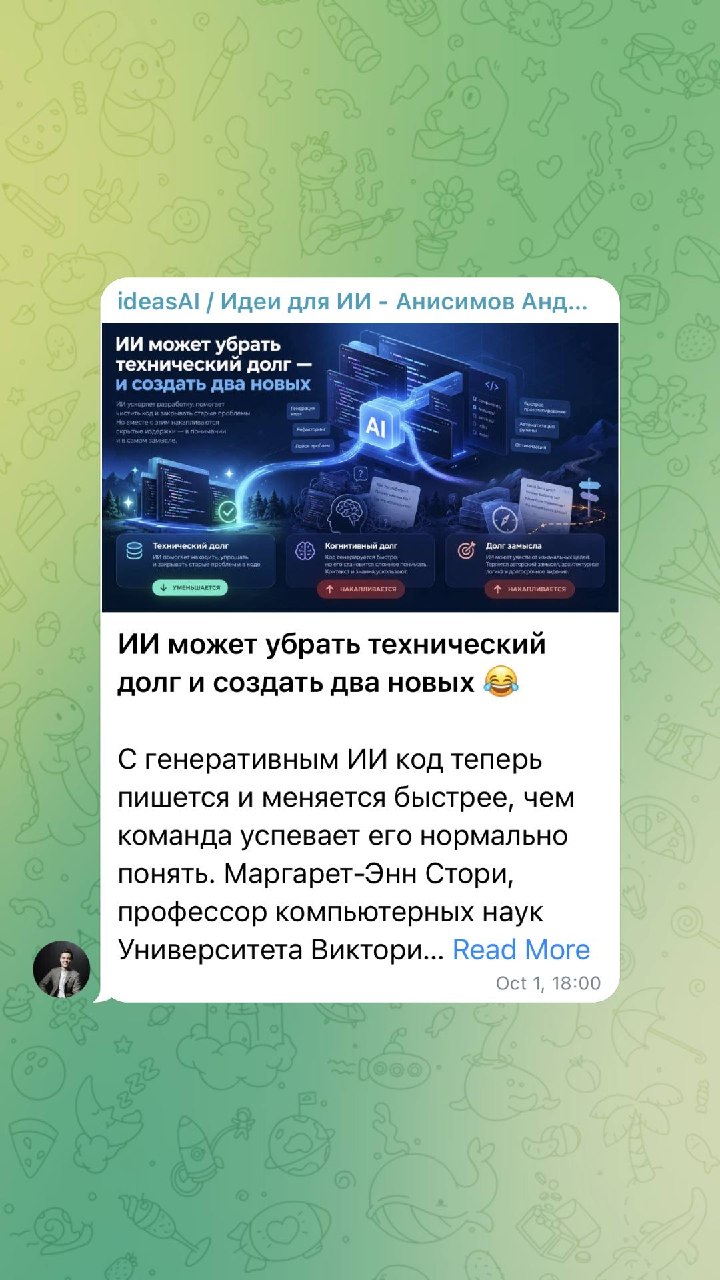
ИИ может убрать технический долг и создать два новых 😂

С генеративным ИИ код теперь пишется и меняется быстрее, чем команда успевает его нормально понять. Маргарет-Энн Стори, профессор компьютерных наук Университета Виктории, предлагает смотреть не на один долг, а сразу на три.

🔷Технический долг - это знакомые костыли и временные решения. Здесь ИИ помогает: находит проблемы, пишет тесты, переписывает код, улучшает архитектуру.

🔷Но появляется когнитивный долг.

Код работает, тесты проходят, а команда уже хуже понимает, как всё устроено. Из-за этого люди боятся лишний раз что-то менять, новички дольше входят в проект, а знания остаются у нескольких человек.

🔷И ещё один - долг замысла.

Все видят, ЧТО делает система, но уже не помнят, ПОЧЕМУ она устроена именно так: какие были ограничения, зачем выбрали такую архитектуру, что было критично для бизнеса.

🔍 Вот здесь AI-агенты могут начать очень быстро улучшать вообще не то.

Формально код становится чище, а по факту система уходит от реальных требований: по производительности, приватности, доступности или логике продукта.

Что с этим делать:

1️⃣После крупных изменений кто-то в команде должен уметь объяснить, как теперь работает система.

2️⃣Фиксировать не только решение, но и почему его приняли.

3️⃣Разбирать важные изменения вместе, особенно если большую часть кода написал ИИ. Автор как раз советует регулярные разборы, фиксацию бизнес-контекста и обмен знаниями в команде.

Если команда стала писать код быстрее, но хуже понимает собственную систему - часть долга остается и это сложно назвать успехом..

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Video is unavailable for watching
Show in Telegram
Meta* показала карманного AI-агента 🤖

Muse Charm выглядит как небольшая отдельная штука с экраном, микрофоном, динамиком и 5G. Но смысл не в самом гаджете. Meta* пытается сделать ИИ не приложением, которое надо каждый раз открывать, а постоянным помощником, который уже подключён к вашим сервисам.

➡️У Muse заявлены интеграции с Notion, GitHub, Box, Instacart, PayPal. Ему хотят дать собственную почту, чтобы агент мог переписываться и выполнять часть задач от вашего имени.

То есть вместо обычного сценария "открыл сервис → нашёл данные → скопировал → пошёл в ChatGPT → объяснил, что с этим делать" можно сказать одну фразу и дать агенту самому пройти по этой цепочке.

☑️ Дальше конкурировать будут не только модели. Будет важнее, сколько сервисов агент реально видит, что ему разрешено делать и насколько хорошо он понимает ваш контекст.

Если он знает ваши задачи, документы, переписку, покупки и историю работы, то ему уже не надо каждый раз пересказывать жизнь заново.

Ну и, конечно же, мы не забывает про персональные данные и безопасность, с чем возникает вопрос. Но об этом будет отдельный пост - 🔥

*Meta Platforms Inc. признана в России экстремистской организацией, её деятельность запрещена.

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Пробую Дзен - подпишитесь 🔥
https://dzen.ru/ideasforai


400 000 GPU — это сколько? Почти целая электростанция в Мытищах 🤣

Дженсен Хуанг заявил, что AGI уже достигнут. И рядом назвал следующую цифру масштаба: совсем скоро для обучения топ-нейросети потребуется переход от 100 тысяч GPU к 400 тысячам.
Сама цифра почти ничего не говорит. Поэтому переведём её в железо и электричество.

Если считать на архитектуре NVIDIA Blackwell:

🟦около 5 556 серверных стоек;
🟦примерно 800 МВт с охлаждением и инфраструктурой ЦОД;
🟦почти 7 млрд кВт·ч в год, если такая система работает под полной нагрузкой постоянно;
🟦несколько футбольных полей только под серверные залы. Весь кампус будет заметно больше.

Теперь сравнение, которое вы вряд ли ожидали... В Мытищах работает ТЭЦ-27. Её установленная электрическая мощность - 1 060 МВт. То есть кластер на 400 тысяч GPU в такой конфигурации мог бы потреблять примерно 75% мощности этой станции.

Конечно, 400 тысяч GPU не означают, что все они завтра окажутся в одном здании и будут одновременно обучать одну модель. 800 МВт = оценка масштаба. Но цифра хорошо показывает, куда всё пришло.

Вот почему AI-гонка всё сильнее становится ещё и энергетической. И да... похоже, новые модели скоро действительно удобнее будет сравнивать не только по бенчмаркам, но и по электростанциям.

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


➡️Google давно написал инструкцию, как не сделать из ИИ ещё одну бесполезную кнопку в продукте

У Google есть People + AI Guidebook - практический гайд для тех, кто добавляет ИИ в сервис, приложение или внутренний продукт. Он собран на основе исследований, опыта продуктовых команд Google и академических работ.

И там есть мысль, которую я бы вообще вынес отдельно:

Если ИИ не решает конкретную пользовательскую проблему лучше обычного интерфейса - возможно, он там просто не нужен.

Google предлагает начинать с вопроса:
какую проблему пользователя ИИ умеет решать действительно лучше других подходов?

Потому что сейчас во многих продуктах AI появляется примерно так: добавили чат, назвали это copilot и…. сидим довольные. Что еще к этому добавить:

1️⃣Не объясняйте человеку технологию - объясняйте пользу

При знакомстве с AI-функцией лучше объяснять, что она даст человеку, а не как она работает внутри. Пользователю редко важно, какая там модель. Ему важно, что теперь можно сделать быстрее или проще.

2️⃣Не отдавайте ИИ всё управление сразу

Сначала подсказки, потом действия под контролем пользователя, потом больше автономности. Особенно если ошибка может что-то стоить.

3️⃣Дайте человеку возможность поправить ИИ

Если AI ошибся, продукт не должен загонять пользователя в тупик. Нужен понятный путь: исправить, откатить, выбрать другой вариант, продолжить вручную. В Guidebook этому посвящён отдельный блок про feedback, control и graceful failure.

4️⃣Не делайте вид, что ИИ понимает больше, чем понимает

Отдельно про mental models: человек должен понимать, что система умеет, где у неё ограничения и почему результат иногда меняется. Если ожидания завышены, дальше обычно идут разочарование и отказ от функции.

5️⃣Самая полезная проверка для любой AI-фичи. Я бы вообще сохранил себе один вопрос:

Если убрать слово “AI” из описания продукта — останется ли у этой функции реальная ценность?


Если нет, скорее всего, перед вами просто AI-декорация.

Сам гайд большой, но удобный: там шесть разделов - от выбора задачи и данных до доверия, контроля и работы с ошибками.

Плюс есть worksheets, которые можно буквально прогонять с командой при проектировании AI-функции.

Для продакта, руководителя или человека, который сейчас что-то строит с ИИ, это полезнее половины подборок «100 лучших промптов»

Сам Guidebook: People + AI Guidebook от Google⁠

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Что было за неделю:

➡️Предсказать, кто купит, уже мало. Интереснее понять, кто купит именно благодаря вам 🧐 прочитать пост⁠

➡️37 000 AI-агентов собрали в виртуальную биотех-компанию. И она уже ищет лекарства 🧐 прочитать пост⁠

➡️Чем лучше человек умеет работать с ИИ — тем меньше он ему доверяет 🧐 прочитать пост⁠

➡️Любите Дэна Брауна и «Код да Винчи»? У меня была загадка длиной в 14 лет — и GPT наконец помог её добить 🧐 прочитать пост⁠

➡️Зачем MBA, если и так всё знаешь? Потому что MBA не всегда про нехватку знаний 🧐 прочитать пост⁠

➡️ИИ, который слушает лес и понимает, кто там живёт. Уже не фантастика, а рабочий экологический мониторинг 🧐 прочитать пост⁠

➡️Claude теперь можно спросить про весь свой прогресс в тренировках — не по одному забегу, а по всей истории 🧐 прочитать пост⁠

➡️Если в голове уже свалка из дел — не начинайте с планировщика. Сначала выгрузите всё в ChatGPT 🧐 прочитать пост⁠

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai

#дайджест


Если в голове уже свалка из дел - я бы не начинал с планировщика. Я бы сначала выгрузил всё в ChatGPT.

Просто рассказываете всё, что висит: кому не ответили, что откладываете, что раздражает, что надо купить, оформить, доделать.

1️⃣ Сначала собрать весь хвост

Расспроси меня обо всём, что я не закончил, откладываю или постоянно держу в голове. Потом собери всё в один список без дублей


Это полезнее, чем самому садиться и вспоминать. ChatGPT начинает задавать вопросы, и обычно всплывает ещё половина того, про что уже забыл.

2️⃣ Потом превратить кашу в нормальный день

Собери из этого план на сегодня. Сначала поставь задачи, которые можно закрыть за 5–15 минут. Потом оставь 2–3 действительно важных


3️⃣Часть списка сразу отдать ИИ

Сделай сам всё, где моё участие не требуется: письма, сообщения, черновики документов, списки, расчёты, заготовки


Вот этот пункт я бы вообще не пропускал. Потому что если после разговора с ChatGPT у вас просто появился ещё один список дел — вы использовали его как дорогой блокнот.

4️⃣Найти одну задачу, которая реально что-то меняет

Какое одно действие из этого списка даст мне самый большой эффект, если я сделаю его сегодня?

Иногда это вообще не самая большая задача. Может оказаться один звонок, одно письмо или решение, которое разблокирует ещё пять дел.

5️⃣И последний вопрос:

Что из этого списка я могу вообще не делать?


Вот после него список обычно становится сильно приятнее.

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Claude можно спросить про весь свой прогресс в тренировках 😉

Завтра, 27 сентября, проходит основная дистанция Московского марафона - 42,2 км. А я свой первый марафон пробежал два года назад.

И забавно посмотреть, как за эти два года поменялась работа с ИИ. Перед своим марафоном я использовал ChatGPT как тренера. Сначала отправлял ему скриншоты из Garmin с последними забегами.

GPT пытался понять мой уровень, оценивал темп на марафон, потом расписал последнюю неделю тренировок и питание перед стартом. Потом мне захотелось дать ему больше данных.

Я запросил у Garmin полный архив, ждал его несколько дней, получил кучу непонятных файлов, начал разбираться, что где лежит, вручную перекидывал их в GPT. Он даже попытался написать скрипт для анализа — и благополучно упал с ошибкой. В итоге часть данных пришлось просить разбирать вручную.

Для 2024 года это уже казалось довольно крутым. Теперь выглядит как минимум спорно... потому что Strava запустила официальный MCP-коннектор для Claude. Модель получает доступ к истории тренировок, GPS, темпу, мощности и даже пульсу посекундно.

То есть можно загрузить в разговор не один забег, а месяцы тренировок и спросить:

🟦где я реально стал быстрее;
🟦после каких тренировок чаще проседаю;
🟦когда лёгкие дни перестают быть лёгкими;
🟦как менялся пульс на том же темпе;
🟦какая нагрузка в моём случае вообще работает.

Если отдельно подключить Oura, можно уже сопоставлять тренировку с тем, что было после неё: сон, HRV, восстановление. Например:

"После каких тренировок у меня HRV восстанавливается дольше всего?"
"На каком недельном объёме у меня начинает портиться сон?"
"После каких нагрузок я прогрессирую, но не разваливаюсь на следующие два дня?"


🔷В Claude открываете Customize → Connectors → Strava → Connect и входите в свой аккаунт Strava. Коннектор работает через OAuth, доступ можно в любой момент отозвать. Он только читает данные — менять или удалять тренировки Claude не может. Функция входит в подписку Strava.

После подключения я бы не спрашивал что-то общее вроде "оцени мои тренировки". Гораздо полезнее дать Claude конкретный период и задачу:

"Разбери мои последние 12 недель. Найди тренировки, после которых темп рос при сопоставимом пульсе. Отдельно покажи недели, где нагрузка резко выросла."

Или:
"Сравни мои лёгкие пробежки за последние 6 месяцев. Стали ли они быстрее при том же пульсе?"


Claude получает доступ к актуальной истории Strava и может анализировать её целиком: объём, темп, нагрузку, разные виды тренировок, GPS и посекундные данные.

У большинства из нас эти данные копятся годами и почти никак не используются. Максимум — посмотрели средний пульс после пробежки и закрыли приложение. А можно делать больше!

#AI_и_наука

➡️Я в сетке — подписывайтесь
https://setka.ru/communities/01a0d9e7-1820-71f2-ab43-456e2269399f


ИИ, который слушает лес и понимает, кто там живёт 🏞

Обычно мониторинг природы представляют так: биологи ходят по лесу, считают птиц, ставят фотоловушки и вручную разбирают наблюдения.

😅 Но когда территория — 25 000 км², такой подход просто перестаёт масштабироваться.

В Сьерра-Неваде Cornell разворачивает больше 1 600 автономных акустических рекордеров. Они постоянно записывают лес, а дальше ML помогает искать в этом потоке голоса животных и отслеживать, как меняется биоразнообразие. Сейчас система используется для мониторинга более 100 видов птиц 🦜

По таким данным можно смотреть, где вид исчезает, где возвращается, как животные реагируют на пожары, изменение среды и климат, а потом использовать это в реальном управлении территориями. Cornell объединяет акустические данные ещё и со спутниковыми наблюдениями, чтобы делать инструменты для природоохранных служб.

Сам BirdNET тоже давно вышел за рамки распознавания нескольких птиц. Его база сейчас охватывает более 16 тысяч видов, включая птиц, млекопитающих, насекомых, амфибий и рептилий.

Спутник хорошо показывает, что с лесом произошло физически. А звук помогает понять, кто в этом лесу ещё живёт. Это уже совсем другой уровень мониторинга природы.

#AI_и_наука

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Зачем MBA, если и так всё знаешь? 🎓

MBA - это не всегда про нехватку знаний. Иногда просто наступает момент, когда твои задачи становятся сложнее, чем рамки одной функции.

Когда руководишь командой, внедряешь AI или трансформируешь бизнес, уже недостаточно разбираться только в своей предметной области. Нужно понимать, как твои решения влияют на финансы, стратегию, процессы и людей.

Для меня SKOLKOVO MBA стал возможностью систематизировать опыт, посмотреть на бизнес глазами руководителей из других индустрий и научиться находить решения там, где нет готового ответа.

И, конечно, отдельная ценность - люди, с которыми продолжаешь общаться и после выпуска.

Кстати, если давно присматриваетесь к MBA, есть интересный способ попробовать себя в деле.

10 октября СКОЛКОВО проводит первый кейс-чемпионат SKOLKOVO MBA.

Собираете команду, решаете реальный бизнес-кейс и получаете возможность выиграть грант на обучение.

Хороший способ проверить свои управленческие навыки, познакомиться с единомышленниками и почувствовать атмосферу бизнес-школы.

📍 Кампус СКОЛКОВО

🔗 Регистрация на кейс-чемпионат⁠


Любите Дэна Брауна и «Код да Винчи»? Вам понравится: моя загадка длиной в 14 лет, с которой наконец справился GPT 😄

В телефоне у меня с 2012 года лежали эти фотографии из одного кафе. Там предлагалось расшифровать кодовое слово и получить какой-то сладкий приз.

Казалось бы, насколько сложную задачу можно дать посетителю кафе ради десерта?

Как выяснилось - очень сложную 😂

Кафе уже давно нет, а фотографии периодически всплывали у меня в галерее. И раз в несколько лет я снова пытался понять, что же там зашифровано.

После появления ChatGPT начал подсовывать задачу новым моделям. И каждый раз что-то шло не так: то распознавание символов ломалось, то модель пыталась искать закономерность там, где её нет.

В этот раз тоже получилось не с первого раза. Сначала GPT решил, что две фотографии нужно наложить друг на друга, и довольно уверенно пошёл по ложному следу.

Потом подключился поиск, около 55 минут рассуждений - и внезапно загадка раскрылась.

Оказалось, что владелец кафе выбрал для посетителей совсем не случайный набор символов.

Это криптограмма из истории Эдгара Аллана По. В XIX веке По устраивал криптографические конкурсы и предлагал читателям присылать ему шифры. Один из таких текстов, приписываемый У. Б. Тайлеру, оставался нерасшифрованным больше 150 лет и был окончательно разобран только в 2000 году.

Использовался гомофонный шифр - одна буква открытого текста могла кодироваться несколькими разными символами.

Начало текста после расшифровки: IT WAS EARLY SPRING, WARM AND SULTRY…


То есть человек в кафе в 2012 году должен был между кофе и десертом решить задачу, над которой криптографы возились полтора века 😁

Теперь я хотя бы понимаю, почему сладкий приз, судя по всему, так никому и не достался. Уж не знаю, кем был владелец заведения, но бесплатно отдавать десерты он явно не собирался))

И отдельный забавный момент про нынешний AI: с телефона задача так и не взялась. Справился Codex с компьютера - когда смог нормально разобрать фотографии, искать источники и проверять гипотезы.

Не загадка тысячелетия, конечно. Но закрыть маленький гештальт, который лежал у тебя в телефоне 14 лет, - тоже очень приятно.

Lesson learned: не удаляйте странные фотографии. Возможно, просто модель для них ещё не вышла.

И да - на скринах как раз книга Codebreaking: A Practical Guide Элoнки Дюнин и Клауса Шмеха, где я и нашёл историю этой криптограммы. Там есть и другие картинки с шифрами и загадками — похоже, материала для следующих 14 лет у меня теперь достаточно 😄

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Чем лучше человек умеет работать с ИИ - тем меньше он ему доверяет 🤔

Microsoft изучила 20 000 пользователей ИИ из 10 стран и больше 100 000 диалогов с Copilot. Подробно можно прочитать тут. Я же собрал для вас саммери:

🔵53% продвинутых пользователей еще до начала работы решают, что сделать самостоятельно, а что отдать ИИ. Среди остальных таких только 33%.

🔵43% иногда специально работают без ИИ - чтобы не терять собственные навыки.

🔵86% воспринимают ответ ИИ как отправную точку, а не готовый результат.

При этом польза вполне измеримая:

🟦66% освободили больше времени для действительно важных задач;
🟦58% с помощью ИИ делают то, чего еще год назад не умели;
🟦среди продвинутых пользователей таких уже 80%.

Но самая интересная цифра - другая. Количество активных ИИ-агентов в Microsoft 365 выросло в 15 раз за год.

Один человек ставит задачи нескольким ИИ-агентам, получает от них результат: «Я поставил задачу - ИИ собрал данные - другой агент обработал их - я проверил результат и принял решение».

И здесь цена сотрудника уже определяется не скоростью печати и даже не умением писать промты.

Главный навык - понимать, что можно отдать ИИ, как проверить его работу и где нужно вовремя забрать управление обратно. А промт - просто инструмент.

#AI_и_работа

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


37 000 AI-агентов собрали в виртуальную биотех-компанию. И она уже ищет лекарства 🥸

В Стэнфорде решили провести эксперимент и создали систему, которая больше похожа на оргструктуру биотеха, чем на обычного AI-ассистента.

Она называет Virtual Biotech (читаем тут). Наверху — агент в роли Chief Scientific Officer. Ниже — специализированные отделы: поиск "мишеней", оценка безопасности, выбор терапевтической стратегии, анализ клинических испытаний. В пике система запускала больше 37 тысяч агентов параллельно 😱

Первую большую задачу ей дали: разобрать результаты 55 984 клинических испытаний.

Для этого Virtual Biotech разослала 37 075 отдельных агентов, каждый из которых занимался своим испытанием: сначала искал данные в ClinicalTrials.gov, потом при необходимости шёл в PubMed, пресс-релизы и регуляторные сообщения.

🔷После этого система связала результаты испытаний с генетическими и клеточными данными. Кому интересно - читаем ниже, все расписал:

Получился любопытный сигнал: препараты, которые бьют по мишеням, активным в конкретных типах клеток, на 40% чаще переходили из Phase I в Phase II и на 48% чаще доходили до рынка, при этом у них было на 32% меньше нежелательных явлений.

Дальше Virtual Biotech дали уже конкретный вопрос: стоит ли рассматривать белок B7-H3 / CD276 как мишень при раке лёгкого.

Система собрала генетические, single-cell, spatial и клинические данные и предложила стратегию с antibody-drug conjugate — антителом, которое распознаёт B7-H3 и несёт противоопухолевый препарат.


Звучит как "ИИ нашёл лекарство от рака", но тут важно не уходить в фантазию. Авторы не проверяли эту стратегию в клетках, на животных или в клиническом исследовании. Nature отдельно подчёркивает: система пока не прошла реальную проверку.

Посмотрите как меняется сама форма научной работы. Раньше агент обычно делал одну задачу (или несколько): нашёл статьи, написал код, проанализировал таблицу.

🔝 Здесь уже появляется организация из агентов: один ставит задачу, другие параллельно копают разные источники и специализации, потом результаты снова собираются наверху. То есть AI начинают масштабировать не только по размеру модели, но и по структуре команды.

И если такая система действительно выдержит проверку на реальных исследованиях, узким местом может стать уже не скорость поиска и анализа данных, а совсем другое: какие гипотезы стоит проверять в лаборатории и на что вообще тратить дорогие человеческие эксперименты.

Вот это уже заметно ближе к "AI-учёному"....

#AI_и_наука

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai

#AI_и_наука


Предсказать, кто купит, - недостаточно 😉

Нужно понять, кто купит именно благодаря вам. Допустим, у банка есть миллион клиентов и предложение: «возьмите кредит — получите бонус».

Обычная ML-модель решает задачу: P (покупка | клиент). Находим клиентов с максимальной вероятностью покупки и отправляем им предложение.

Но тут есть проблема: часть из них и так собиралась взять кредит. Получается, мы просто заплатили бонус за действие, которое произошло бы без нас.

Uplift-моделирование решает другую задачу:

uplift(x) = P(Y=1 | treatment, x) − P(Y=1 | control, x)


То есть пытается оценить не вероятность события, а насколько наше воздействие изменит поведение конкретного клиента.

Классически клиентов здесь делят на четыре группы:

🔵Убеждаемый (Persuadables) - купят именно благодаря воздействию. Самая интересная аудитория.
🔵Лояльный (Sure Things) - купят и без нас. Зачем тратить на них скидку?
🔵Потерянный (Lost Causes) - не купят в любом случае.
🔵Не беспокоить (Do-Not-Disturbs) - коммуникация может даже снизить вероятность покупки.

Поэтому uplift - это уже не просто prediction. Это переход в сторону causal ML: что произошло именно вследствие нашего действия?

Причем это давно не академическая история.

1️⃣У X5 был RetailHero - соревнование по uplift-моделированию на реальных данных ритейла: сотни тысяч клиентов и десятки миллионов транзакций. Этот датасет сегодня можно загрузить прямо из scikit-uplift.

2️⃣Одна синяя компания применяла uplift в запрещенном в РФ инстаграме для управления push-уведомлениями. Пользователей случайно делили на treatment / control, а затем модель училась оценивать incremental impact: изменится ли поведение конкретного пользователя именно из-за отправленного ему уведомления.

3️⃣Uber открыл CausalML - большую библиотеку для оценки heterogeneous treatment effects: S/T/X/R/DR-learners, uplift trees и другие causal-подходы.

4️⃣Microsoft Research развивает EconML - еще более серьезный инструментарий на стыке ML и эконометрики для оценки индивидуальных эффектов воздействия.

В России тоже есть отличный open-source стек.

⚡️ МТС — scikit-uplift (sklift). Sklearn-like библиотека, с которой довольно удобно начинать: meta-learners, uplift-подходы, Qini, uplift curve, AUUC и интеграция с привычными ML-моделями.

А теперь появился еще и AUF - Automatic Uplift Framework от Alfa Advanced Analytics: смотрим ссылку

Здесь идея уже ближе к AutoML для uplift: подготовка и проверки данных, feature selection, обучение разных uplift-подходов, сравнение моделей, метрики и MLflow. Есть S-, T-, X-learners, uplift trees / forests и multi-treatment.

И вот последнее интересно. Потому что следующий уровень — оценивать уже не просто: кому показать предложение?

А: кому × какое предложение × по какому каналу × в какой момент × с какой скидкой?

Например, одному клиенту ничего не отправлять. Второму - push без скидки. Третьему - дать 5%. Четвертому - позвонить. А пятого вообще лучше не трогать.

🔹И оптимизировать при этом не вероятность покупки, а инкрементальную прибыль с учетом стоимости воздействия.

Получается важный переход: Propensity → Uplift → Next Best Action.

Обычный ML пытается предсказать будущее. Causal ML пытается понять, как это будущее изменить.

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai

#AI_и_работа


Что было за неделю — собрал всё в одном месте, чтобы ничего не искать👇

➡️ В AI нет одной профессии. На самом деле там уже сформировалась целая экосистема специальностей 🧐 прочитать пост

➡️ ИИ прочитал больше, чем вы сможете прочитать за всю жизнь. Причём сильно больше 🧐 прочитать пост

➡️ ИИ, который узнаёт лемуров в лицо. Оказывается, Face ID нужен не только людям 🧐 прочитать пост

➡️ Вы всё ещё не можете сделать своего бота? Идите в школу, 9 класс 🧐 прочитать пост

➡️ Сотрудники всё чаще советуются с ИИ, а не с руководителем... 🧐 прочитать объявление

➡️ Как ставка ва-банк создала самую дорогую компанию в мире 🧐 прочитать пост

➡️ Муха умерла несколько лет назад. Но её мозг до сих пор «учится»: играет в Doom, управляет роботами и даже торгует криптой 🧐 прочитать пост

➡️ ИИ учится слушать китов... есть класс задач: попытаться понять другой биологический вид 🧐 прочитать пост

Хорошо провести воскресенье 😎

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai

#дайджест


🐋 ИИ учится слушать китов

Нравятся такие новости - как раньше по каналам шли передачи вроде Animal Planet, так теперь мы описываем задействование ИИ... есть класс задач, который выглядит куда интереснее очередной генерации текста или картинки: попытаться понять другой биологический вид 🤯

Project CETI занимается именно этим. Исследователи записывают кашалотов гидрофонами, датчиками, дронами и автономными аппаратами, а потом прогоняют тысячи их "разговоров" через ML-модели.

В 2024 году команда разобрала почти 9000 последовательностей щелчков - codas. Выяснилось, что коммуникация кашалотов устроена не хаотично: в ней есть ритм, темп, rubato и ornamentation. Из их сочетаний исследователи выделили как минимум 143 регулярно встречающихся паттерна. Прочитать статью можно здесь.

Получается что-то вроде набора строительных блоков, из которых киты собирают свои сигналы. В 2025 году появился WhAM - Whale Acoustics Model.

🔷Это transformer-модель, которая работает непосредственно со звуками кашалотов: строит их представления, генерирует новые "псевдокоды" и умеет преобразовывать другие звуки в структуру, похожую на китовую вокализацию.

Данных там тоже не "пара записей с микрофона". Сеть акустических сенсоров CETI покрывает примерно 20×20 км и собирает больше 30 ТБ в месяц.

Похожий подход уже использовал и Google вместе с NOAA: ML прогнали по 187 000 часам подводных записей, чтобы автоматически искать песни горбатых китов. Так удалось обнаружить их присутствие в районе Kingman Reef, где раньше такие песни не фиксировали.

😅 Но переводчика "с китового" у нас пока нет. Найти повторяющуюся структуру, различать типы сигналов и замечать закономерности - одно. Понять, означает ли конкретная последовательность "еда", "опасность" или вообще что-то, чему в человеческом языке нет аналога, - совсем другое.

AI здесь не говорит за китов. Он помогает человеку впервые разбирать их коммуникацию в масштабе, который вручную просто не потянуть.

Возможно, один из самых необычных интерфейсов будущего будет выглядеть не как человек ↔️ компьютер, а как человек ↔️ AI ↔️ другой вид.

#AI_и_наука

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai

20 last posts shown.