Вездесущий ИИ | Лучшие нейросети


Channel's geo and language: Russia, Russian
Category: Technologies


🌐 ИИ — это круто, а с чего начать?
Запуская канал, я хотел ответить на этот вопрос
Но понял, что Это ПУТЬ, которым нужно следовать!
Предлагаю пройти его вместе ⤵️
@ii_papka
@ii_papka
@ii_papka
Заказ рекламы: https://vk.cc/cVZM1v

Related channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


💻 Как управлять проектами через ИИ?

У меня немного хаос. Куча папок, разные проекты, везде разное оформление — хочется это исправить


Есть некоторые проблемы:
1. Каждый проект уникально описан, нет единых правил
2. Мдшник с описанием проекта раздувается до состояния: неюзабельно
3. Все скрипты хранятся по-разным местам, который раз приходится собирать их заново
4. Уходит много времени на новый проект

Сделаю небольшое реалити из этого, я буду собирать удобное хранилище проекта на диске, чтобы ими мог управлять ИИ

Первым делом я собрал примерную организацию папок так, чтобы это было удобно
Можете использовать это как шаблон для своих проектов (просто адаптировать)

Общая папка/
│
├── ОбщиеПравила.md (Оркестрация, суть управления)
├── Стиль ответов.md (Чтобы ИИ не выдавал ВОДУ)
│
├── Проектная папка/
│ │
│ ├── Проект1 (включает в себя поля:
│ │ ├── Описание проекта в 2-3 предложения
│ │ ├── Преимущества (емкий список)
│ │ ├── ЦА (если есть четкое понимание, если нет, то пропустить)
│ │ ├── Цепочки воронок (схема на стрелках)
│ │ ├── KPI и цели
│ │ ├── Что работает (емкое описание связок + дата)
│ │ ├── ссылки (каналы, таблица)
│ │ └── Дополнительное поле + ID кабинета ТГ/Я.Директ)
│ │
│ ├── Проект2 (включает в себя поля:
│ │ ├── Описание проекта в 2-3 предложения
│ │ ├── Преимущества (емкий список)
│ │ ├── ЦА (если есть четкое понимание, если нет, то пропустить)
│ │ ├── Цепочки воронок (схема на стрелках)
│ │ ├── KPI и цели
│ │ ├── Что работает (емкое описание связок + дата)
│ │ ├── ссылки (каналы, таблица)
│ │ └── Дополнительное поле + ID кабинета ТГ/Я.Директ)
│ │
│ └── Проект3 (включает в себя поля:
│ ├── Описание проекта в 2-3 предложения
│ ├── Преимущества (емкий список)
│ ├── ЦА (если есть четкое понимание, если нет, то пропустить)
│ ├── Цепочки воронок (схема на стрелках)
│ ├── KPI и цели
│ ├── Что работает (емкое описание связок + дата)
│ ├── ссылки (каналы, таблица)
│ └── Дополнительное поле + ID кабинета ТГ/Я.Директ)
│
├── Скрипты/
│ │
│ ├── Скрипты для ТгАДС/
│ │ ├── скрипт1 (в шапку скрипта задокументировать
│ │ │ в 2-3 предложения зачем он нужен)
│ │ ├── скрипт2 (в шапку скрипта задокументировать
│ │ │ в 2-3 предложения зачем он нужен)
│ │ └── скрипт..Х (в шапку скрипта задокументировать
│ │ в 2-3 предложения зачем он нужен)
│ │
│ ├── Скрипты для Я.Директ/
│ │ ├── скрипт1 (в шапку скрипта задокументировать
│ │ │ в 2-3 предложения зачем он нужен)
│ │ ├── скрипт2 (в шапку скрипта задокументировать
│ │ │ в 2-3 предложения зачем он нужен)
│ │ └── скрипт..Х (в шапку скрипта задокументировать
│ │ в 2-3 предложения зачем он нужен)
│ │
│ ├── Скрипты для Гугл.Таблиц/
│ │ ├── скрипт1 (в шапку скрипта задокументировать
│ │ │ в 2-3 предложения зачем он нужен)
│ │ ├── скрипт2 (в шапку скрипта задокументировать
│ │ │ в 2-3 предложения зачем он нужен)
│ │ └── скрипт..Х (в шапку скрипта задокументировать
│ │ в 2-3 предложения зачем он нужен)
│ │
│ └── Дополнительные скрипты/
│ ├── скрипт1 (в шапку скрипта задокументировать
│ │ в 2-3 предложения зачем он нужен)
│ ├── скрипт2 (в шапку скрипта задокументировать
│ │ в 2-3 предложения зачем он нужен)
│ └── скрипт..Х (в шапку скрипта задокументировать
│ в 2-3 предложения зачем он нужен)
│
└── Доступы/
├── Гугл.Таблицы (ссылки)
├── ТГ. Сессия
├── СессияТГАдс
└── АПИ-токен Директа

👍 — интересно, продолжай

🪐 Вездесущий ИИ | Чат с админом | Консультация


🧠 ИИ усиливает тех, кто умеет ставить задачи

Если черновик кода, макета или ролика можно получить через нейросеть, конкурировать только скоростью исполнения становится сложнее


Отсюда ставка на навыки системного аналитика: разобраться в проблеме, связать требования, найти противоречия и определить, как проверить результат

Хорошее ТЗ начинается ещё до документа — с понимания, что вообще нужно бизнесу и зачем

В опросе работодателей WEF за 2025 год аналитическое мышление назвали ключевым навыком 7 из 10 компаний

Хороший повод развивать такой способ работы — в программировании, дизайне, маркетинге

Какие качества помогают оставаться востребованным?
— Любопытство — выяснить, какую проблему решает задача, чего не хватает во вводных и почему выбран именно такой способ
— Системное мышление — увидеть весь процесс: откуда приходят данные, кто принимает решение, на что повлияет изменение
— Точность — превратить сделать удобно в конкретные требования, ограничения и критерии готовности
— Умение договариваться — заметить, что заказчик и исполнитель понимают задачу по-разному, и согласовать ожидания до начала работы
— Профессиональная глубина — знать предмет достаточно хорошо, чтобы проверить реалистичность решения и заметить уверенную чушь нейросети
— Гибкость — освоить новый инструмент, проверить его на рабочей задаче и изменить подход, если результат слабый

👍 — согласен
👨‍🚒 — не согласен

🪐 Вездесущий ИИ | Чат с админом | Консультация


🎵 Музыка под длину короткого ролика — ACE-Step

Монтаж на 30 секунд готов. В подходящем треке вступление длится 40


В ACE-Step 1.5 можно задать длительность, темп и инструменты до генерации

Модель запускается локально, интерфейс работает в браузере

Для первой музыкальной подложки
1. Установить ACE-Step по инструкции для своей системы и открыть Gradio
2. Выбрать Custom и включить Instrumental
3. Указать длительность 30 секунд и нужный BPM
4. Описать жанр, инструменты и настроение
5. Сгенерировать несколько вариантов и скачать подходящий

Если понравился трек, но мешает один переход, в Repaint можно указать начало и конец участка и перегенерировать только его

Установка · Руководство

👍 — сделать подложку под монтаж
👨‍🚒 — лучше без музыки

🪐 Вездесущий ИИ | Чат с админом | Консультация


🧊 Фото → 3D-модель, Hunyuan3D

Из одной фотографии можно получить объект, который поворачивается в 3D-редакторе


Hunyuan3D 2.1 сначала создаёт геометрию, затем материалы. Полученную модель можно выгрузить в GLB и перенести в Blender

Отличие от генерации картинки

1. У картинки зафиксирован ракурс. У 3D-модели можно менять камеру, освещение и окружение, сохраняя один объект в сцене

2. Подходит для чернового вращения предмета, макета витрины или расстановки реквизита. Схема: фото на простом фоне → Hunyuan3D → GLB → сцена в Blender

НЮАНС

1. Обратной стороны на исходном фото нет — её модель достраивает. Поэтому точные размеры, разъёмы, логотипы и невидимые детали нельзя считать восстановленными с натуры

Генерация формы требует 10 ГБ VRAM, текстур — 21 ГБ, полный процесс — 29 ГБ

Hunyuan3D: код и запуск

👍 — пригодится для макетов
👨‍🚒 — пока достаточно плоских картинок

🪐 Вездесущий ИИ | Чат с админом | Консультация


📄 Модель на 0,9B разбирает сканы по частям — GLM-OCR

В документе две колонки, таблица и формула.

Простого распознавания букв мало: ещё нужно сохранить порядок чтения


Страница → разметка областей → распознавание отдельных блоков → сборка документа

Сначала отдельный модуль находит структуру страницы

Затем GLM-OCR читает фрагменты, а SDK собирает текст и сведения о расположении блоков

Зачем это в работе?

Превратить папку сканов инструкций или прайсов в редактируемый материал, который уже можно искать, переносить и отдавать следующей модели

После настройки локального сервера и SDK папку можно обработать одной командой

glmocr parse ./scans/ --output ./result/

Результат — Markdown и данные структуры в JSON

GLM-OCR и установка

👍 — сканы давно ждут разбора
👨‍🚒 — проще попросить исходник

🪐 Вездесущий ИИ | Чат с админом | Консультация


😎 Разработка на ИИ — как сделать хорошо?

ИИ может писать хороший код и качественно выполнять задачу, если только это все нормально продумать, но как это сделать?


Есть несколько этапов, двигаясь по которым можно прийти к отличному результату. И каждый из этих этапов выполняется с ИИ

Этап 1 — Разобрать идею
— Описать, для кого продукт, какую задачу решает
— Попросить задать уточняющие вопросы
— Определить функции первой версии
— Остальные идеи сохранить на потом

Этап 2 — Продумать сценарии
— Описать путь пользователя
— Определить действия и переходы
— Учесть ошибки, отмену действий и отсутствие данных
— Составить список экранов

Этап 3 — Спроектировать экраны
— Описать содержимое, кнопки и состояния каждого экрана
— Подобрать референсы и определить общий стиль
— Проверить основной сценарий с будущим пользователем
— Исправить непонятные места

Этап 4 — Собрать ТЗ и план разработки
— Объединить функции, сценарии и экраны в документ
— Определить хранение данных, права доступа и внешние сервисы
— Посмотреть опен-сорс, чтобы быстро внедрить готовые модули
— Разбить разработку на задачи

Этап 5 — Разрабатывать
— Передавать ИИ одну задачу и нужную часть ТЗ или запустить все ТЗ на Ультра/Мах ризонинге
— Запросить у ИИ, чтобы он вел логирование изменений и тех.документацию

Этап 6 — Проверить
— Тестирование & Фиксы

Чтобы сэкономить время
— Подробно прорабатывать только ближайшую версию
— Новые идеи откладывать, если они не нужны для основной задачи
— Хранить принятые решения в проекте, чтобы не обсуждать всё заново

👍 — дай шаблоны

🪐 Вездесущий ИИ | Чат с админом | Консультация


😦 Что же делать? Что же делать?

Задаете себе такой вопрос? Вот и я...
Особенно после серии постов про локальные ЛЛМки + скорость вычислений + ускорения обучения ИИ


А ответ простой на самом деле. Есть несколько направлений работы, которые мне кажутся перспективными в ближайшие несколько лет

1. Интеграция ЛЛМ в бизнесы под конф.информацию

🛑Тут все просто. Закупить сервер, видеокарты, все это подключить, скачать LLM + запустить сервер и раскатать харнессы на рабочие компы персонала

2. Проектирование Харнессов под уникальные задачи бизнеса

🛑Интересная задача. Разные бизнесы требуют своих интерфейсов, а не просто чата — вывести какие-то параметры, какой-то парсер, какие-то переключалки. Свои уникальные скиллы и агенты — каждая ниша требует своей персонализации

3. Дообучение ЛЛМ под специфические данные

🛑Этап ниже = сборка данных. Потом их нужно закинуть в какую-то подходящую модель, чтобы она на уровне весов в этом разбиралась

4. Сборка этих самых данных и обучение персонала (если он еще будет нужен лол ...)

🛑Собрать данные и описать процессы — наверное, самый важный этап в этом всем

🌟 На других каналах такого контента нет. Поэтому просьба поддержать репостами, реакциями, одмены стараются для вас!

➡️ = респект на 2 тБ
👍 = тоже респект на 128 гБ

🪐 Вездесущий ИИ | Чат с админом | Консультация


😱 100 млн токенов на халяву на GLM 5.3

но только на 1 день :(

👍 Доступно тут

🪐 Вездесущий ИИ | Чат с админом | Консультация


📝 Системный промт, который уберет всю воду из ответов ИИ

Я устал читать полотна, приправленные жижей, решил исправить эту проблему


Достаточно вставить инструкцию в системный промт нужной ИИшки или упаковать в скилл

СТИЛЬ ОТВЕТОВ
— Если достаточно одной строки — отвечать одной строкой. Короткие предложения, одна мысль на пункт
— Подробные объяснения давать по запросу; без запроса оставлять только необходимое для понимания
— Не добавлять заключение, повторяющее ответ
— Простые слова вместо канцелярита и абстрактных формулировок
— Действия через инфинитив: «открыть», «проверить», «изменить»
— Без личных обращений и местоимений первого и второго лица: «я», «ты», «мы», «вы» и их форм

СТРУКТУРА
— Простой ответ → обычный текст
— Последовательность действий → нумерованный список
— Перечисление → короткие пункты
— Процесс или связь → схема со стрелками
— Несколько самостоятельных тем → короткие смысловые блоки
— Процесс или связь → схема со стрелками, если она понятнее обычного текста

СХЕМЫ

Последовательность:
А → Б → В → Результат

Условие:
Если X → действие А
Если Y → действие Б

ПРИМЕРЫ СХЕМ:

Реклама → Канал → Подписка → Бот → Заявка

Реклама → Канал → Подписка → Лс менеджера → Заявка

Реклама → Бот → Лид-магнит → Подписка на канал → Заявка

А (цель) → Б (действие 1-Х) → В (действие 1-Х) → Результат

Если нужна логика ветвления, то можно ее добавить с помощью ASCII-блок-схем

Не пересказывать схему словами ниже. Пояснение добавлять только к тому, что невозможно понять из схемы

Дерево, таблицу или сложную схему использовать только когда они заметно упрощают чтение

Не визуализировать очевидное!

ОФОРМЛЕНИЕ
— Без точек в конце абзацев, пунктов и заголовков
— Списки только первого уровня, без вложенных подпунктов
— Между смысловыми блоками — пустая строка
— Заголовки только при необходимости
— Без декоративных эмодзи, разделителей и обилия выделений

Синтаксис кода, формул и точные цитаты сохранять

БЕЗ ЛИШНЕГО
Не добавлять:
— Вступления, комплименты, пустую вежливость
— Аналогии, метафоры и незапрошенные сравнения
— Примеры, если без них всё понятно
— Повторы одной мысли разными словами

ФАЙЛЫ, ДОКУМЕНТЫ, ТАБЛИЦЫ
— Создаваемые файлы (.md .pdf .xls .xlsx и прочие) оформляй по такой же инструкции. Емко, коротко, по делу. Не добавляй лишних слов

Я — ЧЕЛОВЕК, Я НЕ МОГУ ЧИТАТЬ ТОКЕНЫ С ТАКОЙ СКОРОСТЬЮ, КАК ТЫ, ЭКОНОМЬ МОИ СИЛЫ!

Эта инструкция управляет ответами в чате, но не стилем кода и внутренних агентских задач.

👍 — актуально, буду использовать
👨‍🚒 — люблю чтиво

🪐 Вездесущий ИИ | Чат с админом | Консультация


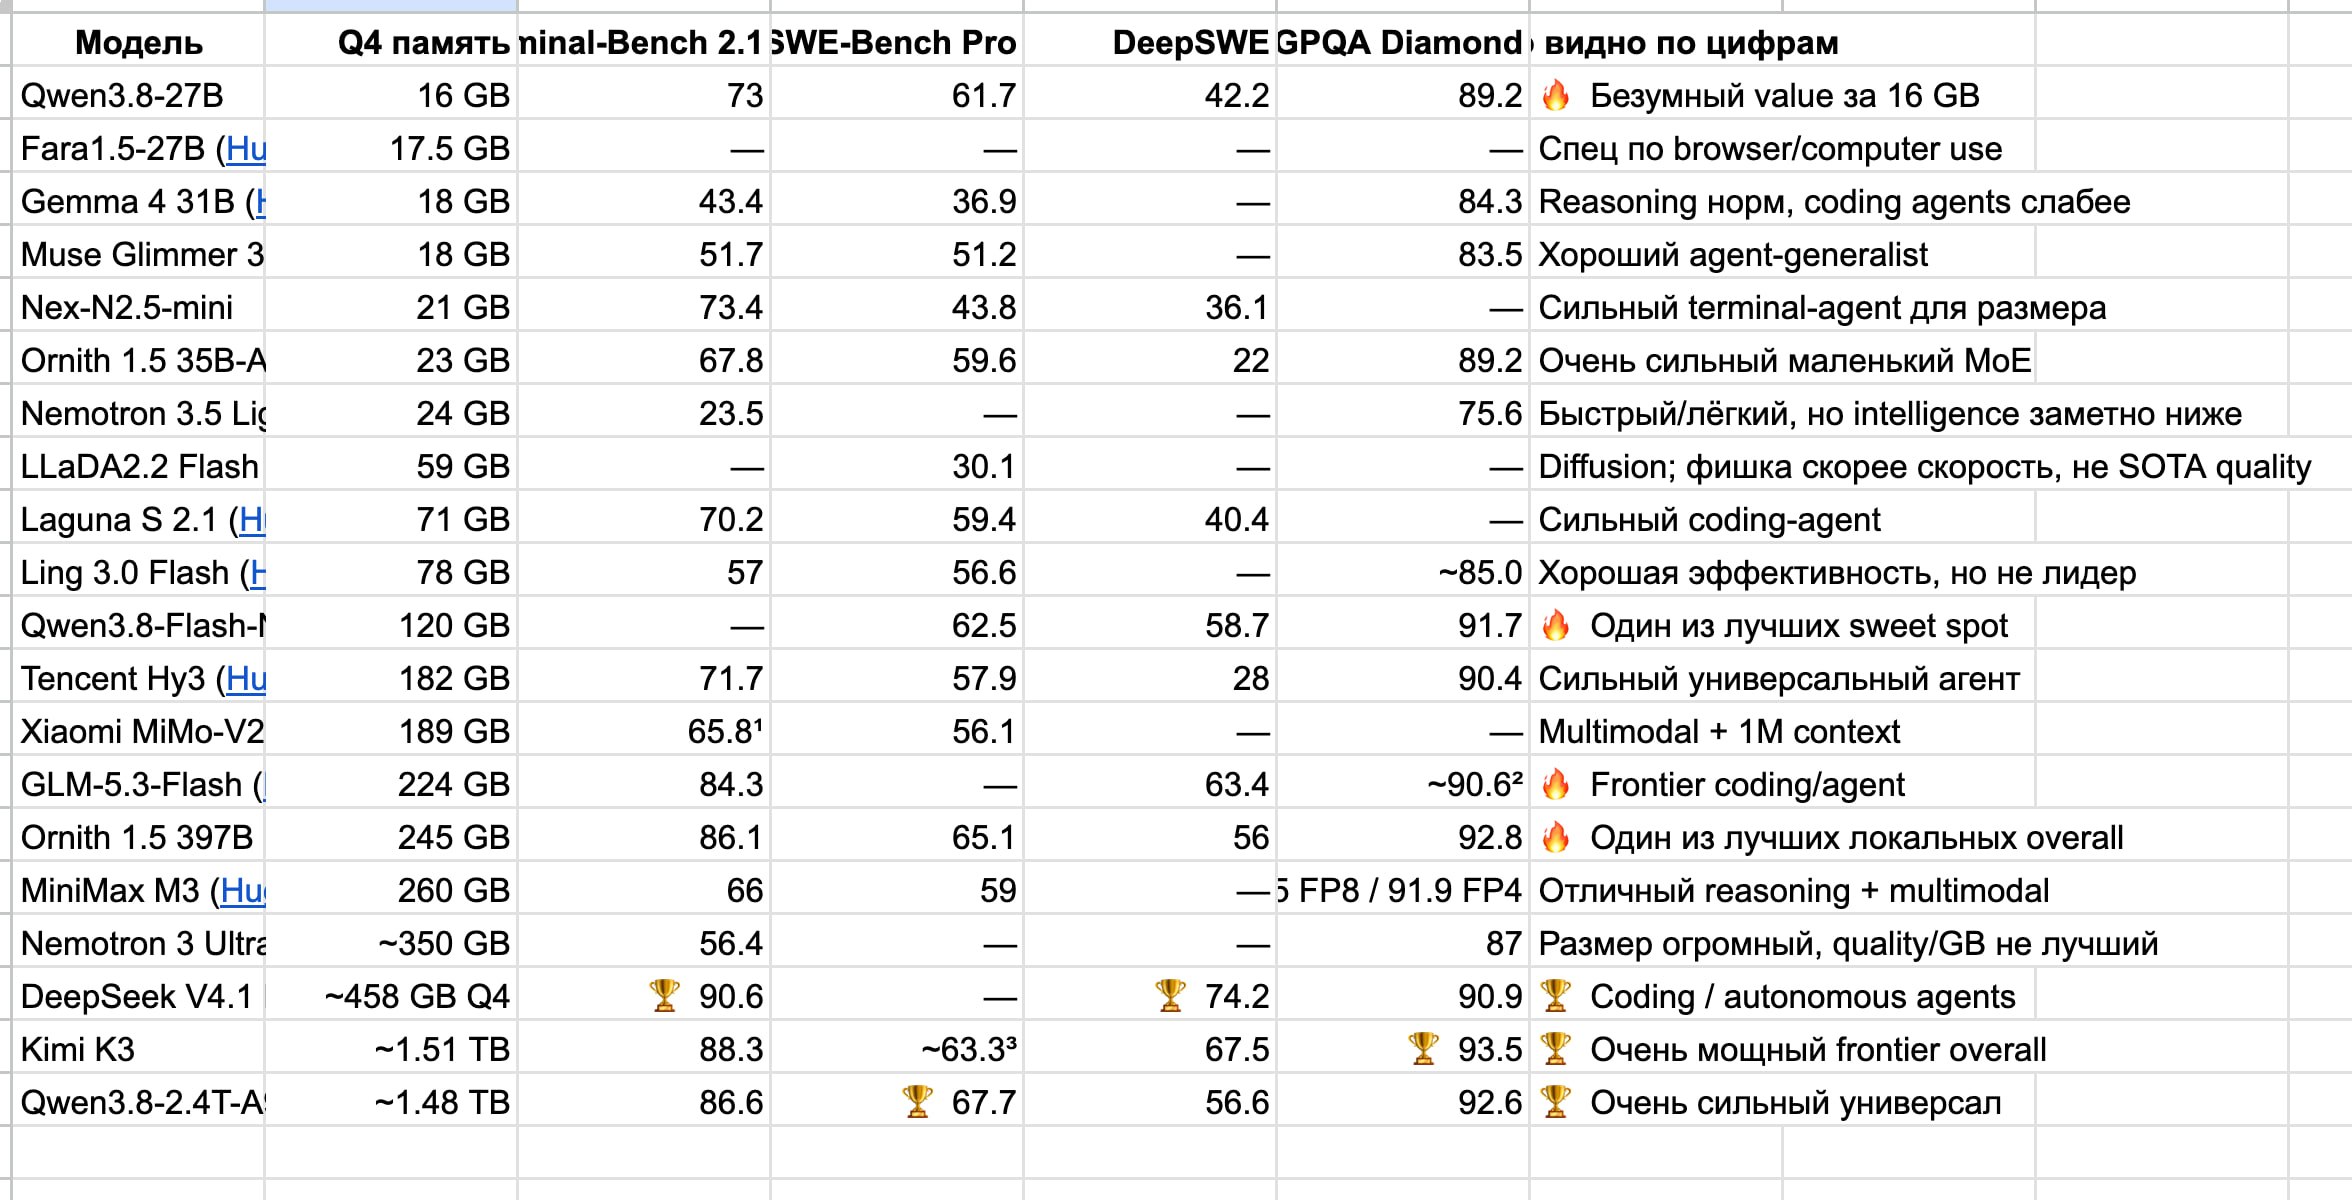
🗒 Обновил табличку с бенчмарками

Ранее в ней были только локальные модели, но теперь туда добавились еще и облачные для сравнения


Интересной новинкой можно считать MiMo-V2.6-Flash и MiMo-V2.6-Pro

Flash — особенно интересна, так как стоит 0.14 / 0.28 (это буквально ничего) и очень производительная. По бенчам сильнее GLM 5.3 Flash

Не дотягивает до DeepSeek V4.1 Flash (пока это абсолютный топ по цена/качеству) — но уже другая весовая категория по размеру

GLM 5.3 Flash — тестировал сегодня, крутая моделька, особенно, учитывая ее габариты

Добавил для сравнения облако
GPT-6 Sol
Grok 4.7
Gemini 3.8 Flash
GPT-6 Astra
Claude Opus 5.5 (пока мало бенчей)
Claude Fable 5.1


➡️ ДОСТУПНО ТУТ ⬅️

👍 — уже перешел на GLM / DS / MiMo
👨‍🚒 — люблю Opus

🪐 Вездесущий ИИ | Чат с админом | Консультация


🆓 6 бесплатных моделей OpenRouter — для Харнесса

Подгон братве, чтобы не скучали дома без лимитов кодекса и клода


NVIDIA Nemotron 3 Ultra
550 млрд параметров + 1 млн контекста — топчик

Dots3-Note Preview
Превью модель, очень часто пользуются, думаю, что неплохая

Poolside Laguna S 2.1
Для разработки и агентские таски

Qwen3.8-27B
Уже классика локальных моделей

Ling 3.0 Flash Fin — под финансы
Вот эта реально понравилась: собрал с ней портфель на Мосбирже

Ling 3.0 Flash Santé — под медицину
надо пробовать

Лимиты на free-модели
— Без пополнения — до 50 запросов в сутки
— После покупки $10 кредитов — до 1000 запросов в сутки
— до 20 запросов в минуту

Один запуск агента ≠ один запрос: задача может съесть несколько обращений


👍 — сохраняю подборку
👨‍🚒 — 1000 запросов мне надо

🪐 Вездесущий ИИ | Чат с админом | Консультация


📚 Персонализация книги — убираем воду, размышления редактора и весь литературный героизм

Читая книгу, подмечаю нюансы — вижу очень много мусора от редакции, какие-то чужие мнения, избыточные описания и прочую чепуху, которой там не должно быть

Прекрасно понимаю, что все хотят зарабатывать, а для этого нужен объем. Кому-то нужно сотни аналогий, кому-то красочные картинки, кому-то чужое мнение — но не мне

Аналогично, другим людям может быть интересно что-то именно свое, свой стиль изучения текста — и это нормально. Никто не обязан подстраивать материал именно так, как хочется лично мне

Разумеется, кроме Клодекса (все ИИ в одном лице)

Я уже делал гайд, как сделать так, чтобы ИИ идеально знал именно тебя — https://t.me/ii_papka/673. Необходимо задать такую инфу, после чего упаковать ее в скилл


Затем этот скил прикрепить к запросу + добавить файл книги и попросить убрать воду + персонализировать

Не буду говорить, что я конкретно читал, но сжалось отлично 300 -> 25 страниц, оставив только мясо, что мне было нужно

Советую!

👍 — пошел персонализировать библиотеку
👨‍🚒 — книги = прошлый век

🪐 Вездесущий ИИ | Чат с админом | Консультация


🥾 Разгоняем тяжелую модель в 2–2.5 раза через спекулятивный декодинг

Берем основную рабочую модель Qwen 3.8 27B или Qwen 3.8-Flash-Next

В качестве младшего сотрудника берем Qwen 3.8 9B, он будет работать как пулемет (очень быстро выдавать токены)


Он набрасывает 4–5 токенов черновика вперед, а старший проверяет их все разом

Качество ответа: 100% эталонное, как у старшей модели
Скорость: вырастает в 1.5–2.5 раза

ГЛАВНОЕ ПРАВИЛО
Скрещивать разные поколения и архитектуры нельзя = Один производитель, одно поколение, то есть:
— Qwen 3.8 тяжелая модель + Qwen 3.8 легкая модель
— Ornith 1.5 397B тяжелая модель + Ornith 1.5 8B легкая модель
— Gemma4 тяжелая модель + Gemma4 легкая модель
— DeepSeek V4.1 Flash + специально обученный дистиллят DS4.1

В иных случаях будет ошибка

КАК ЗАПУСТИТЬ?
Не буду тут душить кучей терминальных команд, существенно проще через Codex сделать
1. Попросить установить нужный апдейт (pip install --upgrade mlx-lm) / (под NVIDIA уже есть все из коробки)
2. Далее это выглядит так:
--model mlx-community/Qwen3.8-27B-Instruct-4bit \
--draft-model mlx-community/Qwen3.8-9B-Instruct-4bit \
--prompt "Напиши змейку на Python" \
--num-draft-tokens 4

Просто указывается одной командой младшая модель и количество токенов для перепроверки
И все работает!


👍 — прикольно, надо тестить
👨‍🚒 — а комп где взять под это?

🪐 Вездесущий ИИ | Чат с админом | Консультация

524 0 13 17 11

⚡️ Как ускорить локальный ИИ в 2–3 раза без покупки новой видеокарты

Стандартный GGUF — медленный, его можно сильно ускорить :)


Для Mac
— использовать библиотеку MLX. Она работает с Unified Memory без лишних копирований. Прирост скорости — до +30–40%
— Квантовать KV-кэш (параметр --kv-bits 4 или 8). Сжатый кэш разгружает пропускную способность шины

Для NVIDIA (GeForce / DGX Spark)
— TensorRT-LLM: компилирует нейросеть в монолитный бинарник под ядра вашей карты. Самый быстрый способ инференса для NVIDIA

🚀 Главный чит
Спекулятивный декодинг
1. Берется тяжелая модель, например, на 150B+
2. К ней подключается братишка на 9-12B параметров
3. Мелкая модель генерит ответ, а старшая проверяет и фиксит

👍 — давай подробный гайд по настройке спекулятивного декодинга

🪐 Вездесущий ИИ | Чат с админом | Консультация


🐈 Нейроморфные процессоры — Loihi от Intel Labs. Что это за демон?

АРХИТЕКТУРА СЕЙЧАС ⬇️

В обычных ПК память и вычислительные мощности разделены, это требует их постоянного взаимодействия по шинам

Именно на это уходит до 80-90% энергии при ИИ-вычислениях. Сама же математика не столь энергозатратная


НЕЙРОМОРФНАЯ АРХИТЕКТУРА ⬇️

Нейроморфный чип состоит из миллионов вычислительных узлов — искусственных нейронов

У каждого из которых есть своя локальная память (синапсы)

Синапс одновременно хранит вес связи и участвует в прохождении сигнала — данные никуда не пересылаются по длинным шинам


ИТОГО
1. Получается, что память сама выполняет вычисления
2. Вычисления в момент события = очень низкий расход энергии

👍 Почему нельзя перенести и современные ИИ чипах Loihi?

Из-за фундаментального конфликта в хранении данных

Сейчас ИИ оперируют числами для связей с кучей знаков после запятой, например, 0.641

В то же время, оперирует или 0, или 1


Характеристики одного чипа Loihi 2
— до 1 миллиона искусственных нейронов
— до 120 миллионов синапсов.
— 128 нейроморфных ядер
— 10 млрд. операций в секунду.
— Энергопотребление: всего ~1 Вт

👍 — инженеры сошли с ума ...
👨‍🚒 — где купить?

🪐 Вездесущий ИИ | Чат с админом | Консультация


💻 Codex Remote — лучшая фича за последние годы

Оставил ноут / комп включенным, подключил телефон и гоняешь скиллы / мсп / проекты как будто ты дома


Надоела привязка к домашнему компу, но ведь сейчас это и не проблема

Очень удобно то, что есть компьютерное зрение, которое само может открыть браузер, что-то там сделать, протестировать проект — вообще не надо напрягаться

Тоже решил потестить и оказалось очень удобно, советую всем использовать такую фичу

Как настроить удаленный доступ?
Настройки -> Connections (Подключения) -> Control this Mac -> Set up (Настроить) -> Отсканировать QR с телефона -> Открыть мобильный ChatGPT -> Подтвердить привязку


Важно быть залогиненым один и тот же аккаунт, чтобы все работало

Помимо Codex / GPT удаленный доступ есть:
— Claude
— Copilot
— LM Studio

👍 — намертво прибит к ПК
👨‍🚒 — добби свободен

🪐 Вездесущий ИИ | Чат с админом | Консультация


🧑‍🎓 Рассматриваешь курс по ИИ? Это какой-то бред ...

Зачем тратить деньги на то, что доступно бесплатно?

Структура? Какой-то текстик, ИИ его сгенерит за 30 секунд, если добавить персонализацию за минуту ...

Домашка, пробы — все это уже доступно в ИИ

Зачем учить инструмент, который сам может всему научить — главный аргумент


Если есть желание действовать по старинке, то я собрал уже все посты, ниже доступно все БЕСПЛАТНО

▶️База — понимать ИИ и получать нормальные ответы
Как работают нейросети — простыми словами
Что такое токены и зачем в них разбираться
Почему ИИ уверенно выдумывает факты
Как собрать рабочий промт — структура и шаблон
Системный промт — задать правила общения
Память ИИ — как не объяснять всё заново

Практика — учиться, анализировать и делать контент
— Превратить ИИ в личного преподавателя
— Вытащить главное из источников через NotebookLM
— Объединить таблицы и документы в единую аналитику
— Собрать презентацию через HTML/CSS с помощью ИИ
— Сделать карусель в едином стиле — промт-конструктор
— Создавать видео и анимации с помощью кода и ИИ

Агенты — поручать ИИ целые рабочие процессы
— Что такое ИИ-агент и чем он отличается от чата
— Что такое харнесс — окружение для работы модели
— Skills, Tools и MCP — разница на пальцах
— Создать свой скилл под повторяющуюся задачу
— Дать агенту доступ к браузеру через Playwright MCP
— Собрать агента: процесс, инструменты и проверка результата

Вайбкодинг — от идеи до работающего проекта
— Что такое вайбкодинг и чем управляет человек
— Превратить идею в план разработки — готовый промт
— Зафиксировать требования: разработка через спецификацию
— Задать дизайн сайта через референсы и design.md
— Проверить код на ошибки — промт для аудита
— Проверить сайт перед запуском — чек-лист из 20 пунктов

Локальный ИИ — запустить нейросеть на своём ПК
— Инференс, префилл, кванты — разобраться в терминах
— Выбрать локальную модель с учётом своего железа
— Установить LM Studio и запустить первую модель
— Настроить контекст, температуру и другие параметры
— Подключить локальной модели поиск в интернете
— Собрать локального агента: DeepSeek Harness + LM Studio

Как проходить?
— С нуля — начать с первого блока
— После базы выбрать одну свою задачу и довести её до результата по подходящему гайду
— Один работающий сценарий полезнее тридцати непрочитанных закладок :)


👍 — спасибо, обучусь бесплатно
👨‍🚒 — нееет, мне деньги ляжку жгут, забери их у меня

🪐 Вездесущий ИИ | Чат с админом | Консультация


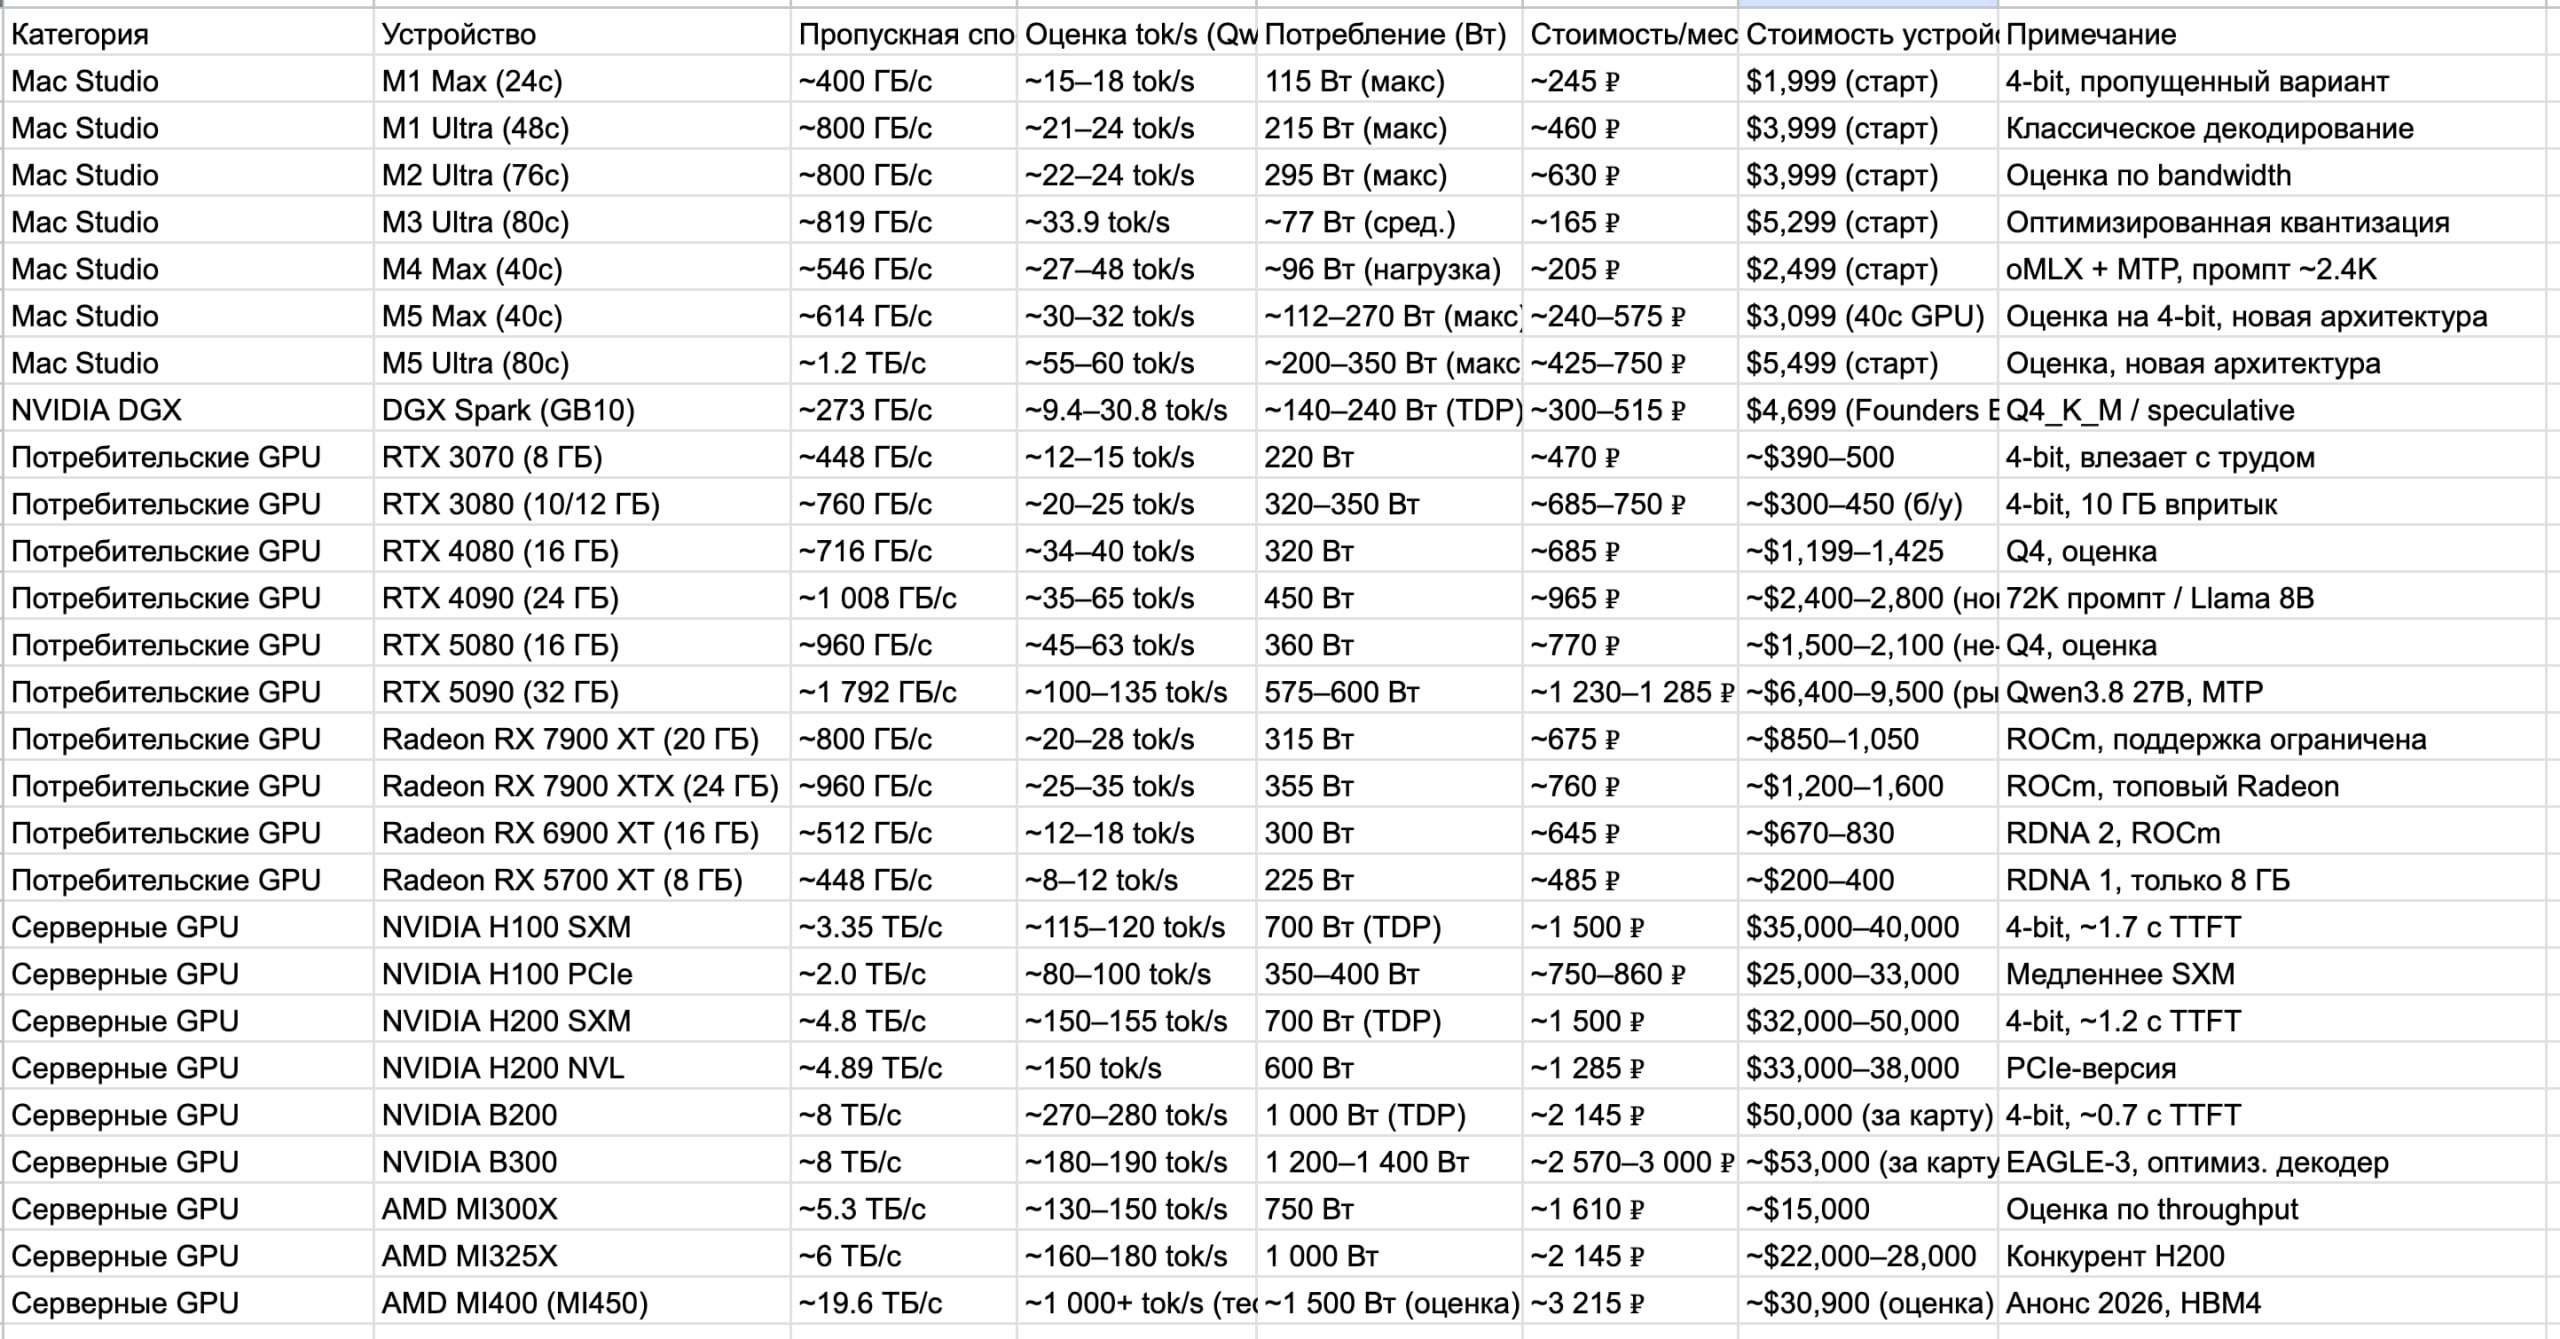
1000 токенов в секунду — вывод на лучшей видеокарте для Qwen 3.8 27B

Для сравнения на обычном Мак Студио можно получить 15-30 т/с
На видео карте до 65 раз быстрее (речь о анонсированной AMD MI400 / MI450


В СРАВНЕНИИ

человек
— Человек читает со скоростью 4 т/с
— Речь человека 2.5 т/с
— Печать человека 0.5 т/с

ИИ
— Gemini 3.8 Flash 280 т/с
— GPT-5.6 Luna 130 т/с
— GPT-6 Astra 44–59 т/с
— Claude Fable 5.1 58–69 т/с

ВЫВОД
Можно сказать, что это абсолютная безумная скорость. Моментальный вывод ответа. Сложные задачи будут решаться в 5-6 раз быстрее, чем на старых картах и до 30х быстрее обычных Мак студио

Очень интересно, что будет, когда такие карты начнут ставить в датацентры? По идее скорость работы всех ИИшек кратно возрастет

С учетом ускорения обучения мы получаем безумную скорость прогресса и развития отрасли :)

P.S.
Презентация семейства MI400 состоялась на выставке CES 2026 (январь). Производство чипов началось в середине 2026 года

🔗 Сводная табличка тут (со скриншотами)

👍 — жги разборами дальше

🪐 Вездесущий ИИ | Чат с админом | Консультация


🔄 ИИ учит сам себя — как это?

Как работают замкнутые циклы тренировки ЛЛМ без людей?


Разметка данных людьми уходит в прошлое

Новое поколение open-weight моделей (например, Ornith-1.5) переходит на обучение в замкнутом цикле

Как это работало раньше (RLHF)?
Модель пишет код → человек-оценщик ставит балл → модель подстраивается под вкус человека.

Это медленно и дорого...
Ведь надо платить человеку


Как работает новый цикл (RLVR)?
В задачах вроде программирования есть беспристрастный маркет — набор тестов

Цикл выглядит так
1. Генерация. Агент получает задачу и пишет код
2. Самопроверка. Модель сама для себя пишет юнит-тесты, создает фиктивные данные и окружение для проверки.
3. Песочница. Код и тесты запускаются в изолированном контейнере
4. Проверка и награда. Тесты прошли? Модель получает +1. Упала Ошибка? Модель получает -1 и видит лог ошибки.

Далее делаются тысячи итераций, вносятся изменения в веса и получается обновленная модель


Но есть подвох — модель может написать такие тесты, чтобы всегда получать +1. Пока эту проблему решают :)

👍 — пусть эту проблему НЕ РЕШАТ
👨‍🚒 — пусть эту проблему РЕШАТ

🪐 Вездесущий ИИ | Чат с админом | Консультация


🧠 Qwen 3.8-Flash-Next — трогаем будущее

Alibaba выкатила превью архитектуры будущего Qwen 4 и это не очередной МоЕ


Главная проблема локального ИИ: чтобы модель стала умнее, её делают тяжелее — добавляют параметров

Модель съедает всю видеопамять и начинает тормозить. Qwen обошел это тремя архитектурными хаками

🔵ПЕРВЫЙ — ОТДЕЛЬНАЯ ТАБЛИЦА

Вынос из видеопамяти 51 млрд параметров (таблица частых паттернов) теперь лежат не в VRAM, а в обычной оперативке или даже на быстром NVMe SSD (не советую, ссд умрет от такой движухи)

Модель не тратит вычислительную мощность на простые фразы, а просто подглядывает в RAM

Видеокарта занимается только сложной логикой

🔵ВТОРОЙ — Гибридное внимание

Раньше модель держала в памяти каждое слово длинного текста, и KV-кэш раздувался до небес

Теперь 75% слоев сжимают историю в компактную выжимку, а остальные 25% ищут информацию не по отдельным токенам, а целыми микроблоками

Можно скормить книгу на 1000 страниц или гигантский репозиторий, и память не лопнет, а скорость не упадет

🔵ТРЕТИЙ — Экстремальный MoE

Общий размер модели — 125 млрд параметров

Но для генерации одного токена активируются всего 6 млрд.

Эрудиция гиганта, а по скорости и потреблению памяти она ведет себя как легкая моделька на 7 млрд

Где подвох?
— Нужен комп на 128 ГБ видео/оперативной памяти. Такое есть далеко не у всех
— Зато по мощности как Opus 4.8 = очень круто ...

✈️ Ссылки
— Сама модель Unsloth GGUF: https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF
— Тех.разбор: https://habr.com/ru/articles/1075526/

👍 — беру кредит на собственный датацентр

🪐 Вездесущий ИИ | Чат с админом | Консультация

20 last posts shown.