Information Retriever


Channel's geo and language: Russia, Russian
Category: Technologies


Author: @kkhrylchenko
Рекламу не размещаю.

Related channels  |  Similar channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


Воскрешаю рубрику про забавные рекомендации, в этот раз на Ютубе. Возможно, это генеративный ретривал просит о помощи


Как прошли мои первые две недели на работе, в числах:
* 35 1-1 встреч
* 175 чатов в телеграме (вне archived chats)
* 174534 шагов (~12466 в день)
* 4 часа спортивной мафии (в Яндексе)
* 5 часов ночного караоке и 1 день рождения Яндекса (эти события связаны)
* 1 премия Yandex ML Prize


Не знаю, как студенты сейчас проводят свободное время (кэгл решают?), а мы в свое время по вечерам брали гитары, тамтам, маракасы и вайбили в лекционных аудиториях.

Нашу маленькую группку даже угораздило на первом курсе выступить на вмкшном музыкальном фестивале «Живой звук». Без Стрыкало и Radiohead не обошлось…

https://www.youtube.com/live/vMJC4sm8D0E?t=10756

P.S. Если отмотать назад, можно найти нашу основную программу — музыку на стихи Маяковского и Crying Lightning от Arctic Monkeys =)


28 сентября начинается ACM RecSys'26 в Миннесоте. Впервые за три года его пропускаю (RecSys'24, RecSys'25), придется прервать традицию обзоров на RecSys конфу :(

Зато там есть Саша Петров @Recsys_IR_Travel! Саша, при этом, еще и организатор двух воркшопов. Ждем постов!

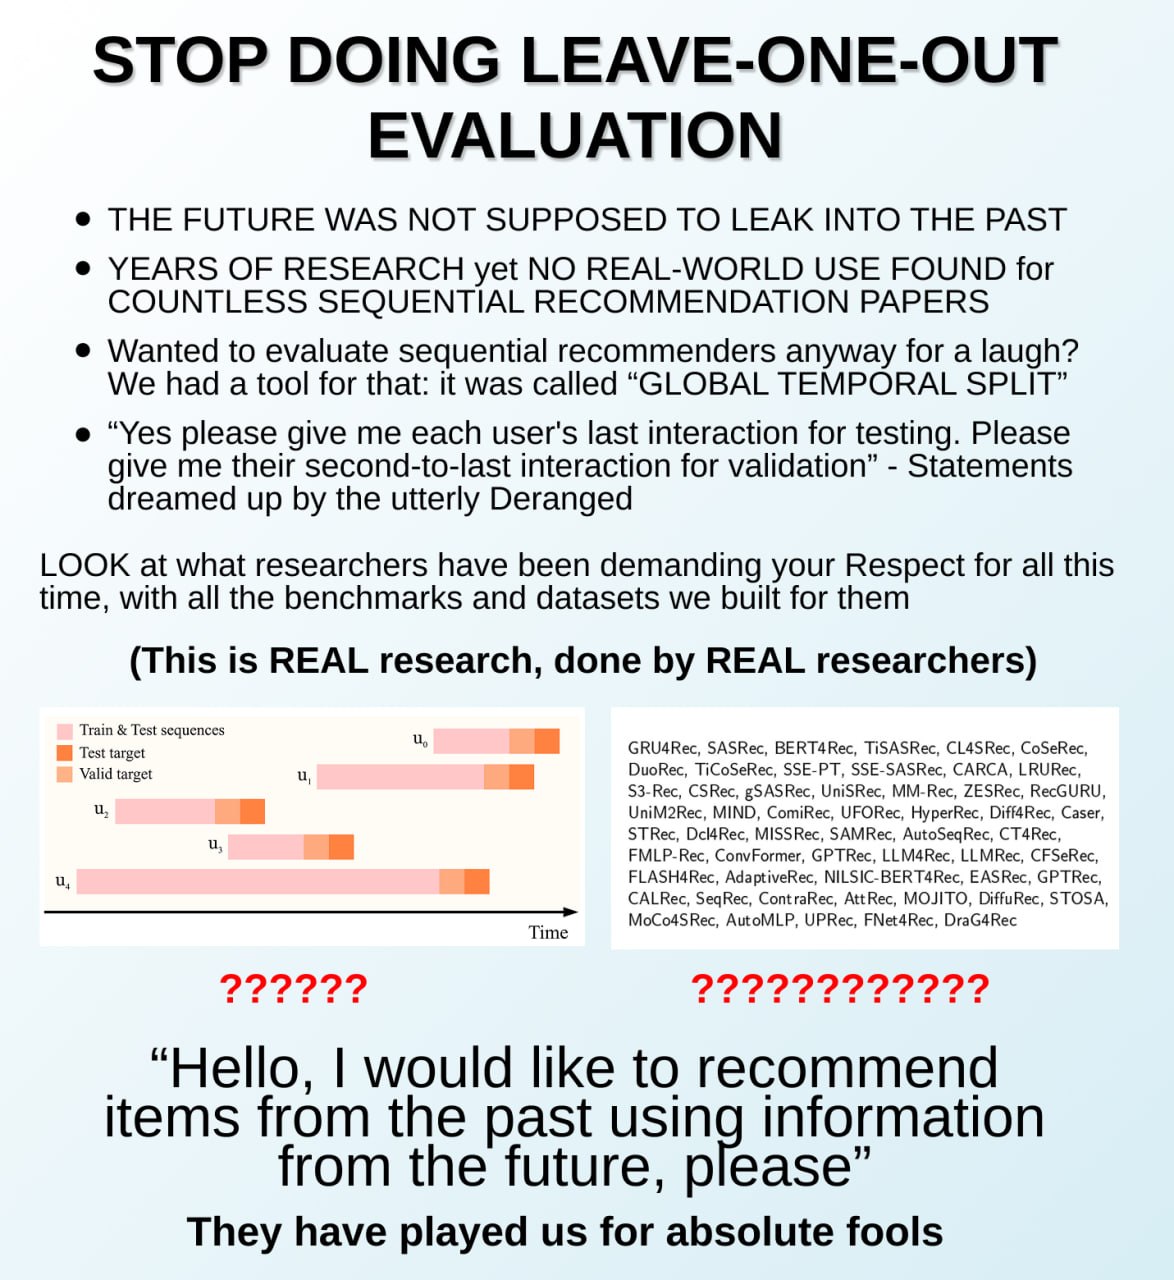
P.S: держите новый мем


По мотивам поста Вани Рубачёва

Вечная классика


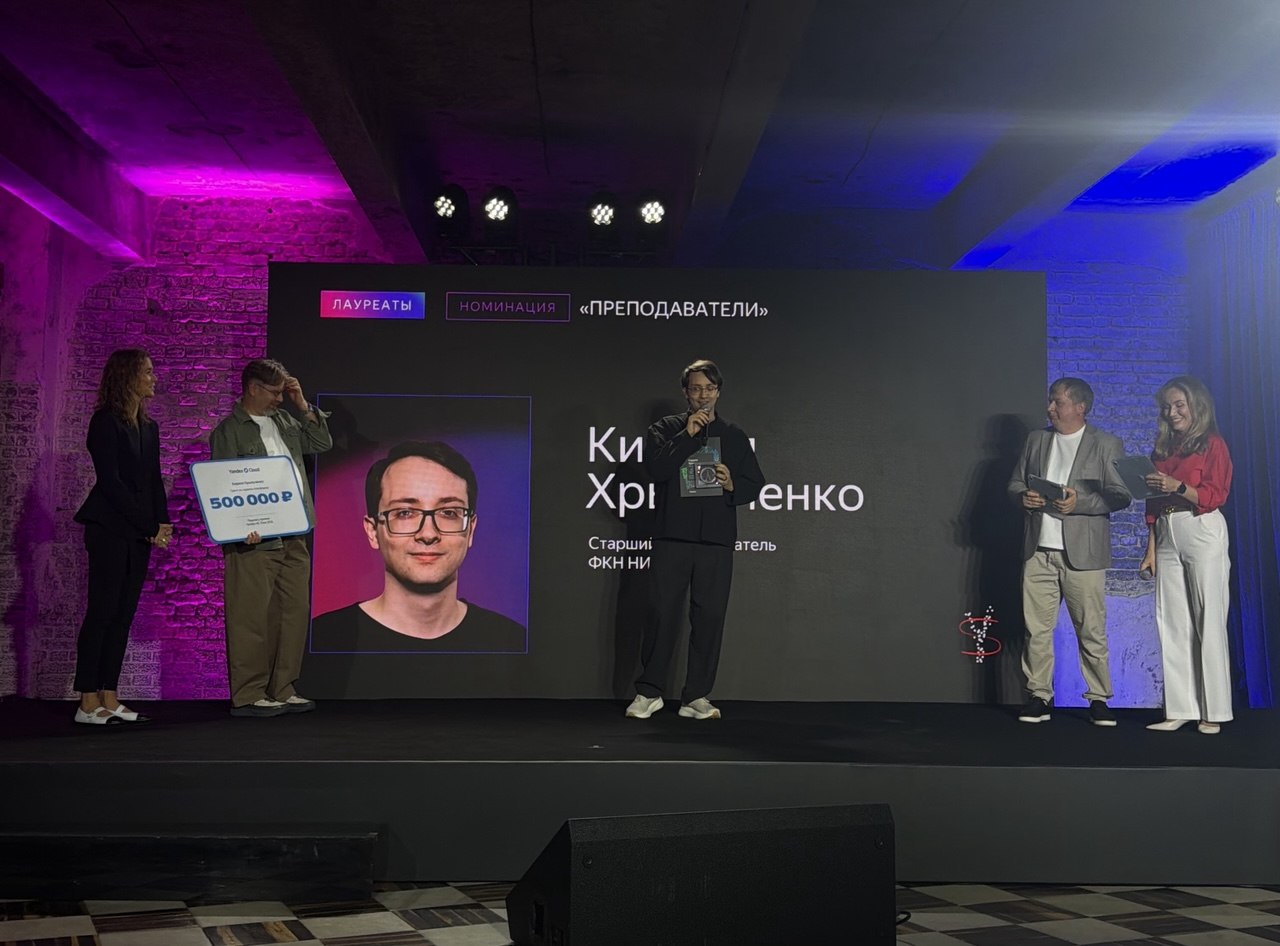
А я сегодня стал лауреатом премии Yandex ML Prize! В номинации “Преподаватели”.

Спасибо всем моим со-преподавателям и со-организаторам курсов из ШАДа и Вышки, а также Жене Соколову за мощную поддержку со стороны Вышки. Без вас бы ничего не получилось! Если и получилось бы, то в разы хуже))

И спасибо студентам за поддержку, внимательность (в том числе на лекциях) и лестные отзывы! И Яндексу спасибо за премию и поддержку преподавания в целом.

Конечно же приятно, когда преподавательские заслуги признают. Преподавание требует очень много времени и сил, и по пути часто происходят качели — думаешь нафига оно все надо, затем едешь на лекцию к студентам, общаешься с ними и понимаешь “а вот зачем!”. И так по кругу)) Любые поощрения преподавания эти качели слегка сглаживают)

Но я, конечно, надеюсь, что это не венец моей преподавательской карьеры и все еще впереди. Есть ощущение, что нужно еще много всего сделать. Будем делать)

P.S: и еще раз попиарю наш дипрексис курс :)


Я не покемон, но меня можно сегодня поймать на Practical ML Conf :)


WARNING: пост на отвлеченную тему))

Я люблю историю. В детстве мне попадались различные книжки про исторических личностей — Наполеона, Цезаря, Спартака и т. д. Еще были детективы/романы/etc с разной долей историчности — например, серия книг про Эраста Фандорина или романы Конана Дойля про столетнюю войну.

В студенческие годы перешёл на формат подкастов/аудиокниг, о которых и расскажу.

Сначала я наткнулся на подкаст Dan Carlin's Hardcore History. Мой личный топ выпусков:
* (death throes of the republic) про падение Римской республики, см. на эту тему еще следующий подкаст
* (punic nightmares) про Пунические войны. Переход через Альпы это epic
* (Thor’s angels и twilight of the aesir) про викингов. Интерес к викингам появился после одноименного сериала
* (wrath of the khans) про монгольскую империю — no comments. Можно еще в Ghost of Tsushima поиграть =)
* (blueprint for armageddon) про первую мировую, начиная с детального описания как Франц Фердинанд завернул не туда на перекрестке; на реддите многие считают эту серию лучшей
* (ghosts of the ostfront) внезапно, про Вторую мировую с перспективы Советского Союза
* (the destroyer of worlds) про Холодную войну и угрозу ядерной войны; про Карибский кризис и переговоры Кеннеди с Хрущевым (тряска невероятная)
* (prophets of doom) про Мюнстерскую коммуну, когда в 16 веке в немецком городке все спятили в ожидании конца света. Актуально
* (mania for subjugation) прямо сейчас выходит хорошая серия эпизодов про Александра Македонского

Если интересно углубиться в историю Древнего Рима (все мы иногда думаем про Римскую империю), есть подкаст от Mike Duncan “The History of Rome”. Рассказ очень дотошный, от самого основания Рима и его 7 королей (да, там были короли) до падения Римской империи. Подробно проходится по всем императорам. Для понимания масштаба, я прослушал 113 эпизодов из 179; каждый эпизод длится где-то 20-30 минут. Больше всего понравился сегмент про падение римской республики, про Цезаря и Августа. Если что, первый римский император это Август, не Цезарь ;)

Чтобы узнать больше про Восточную Европу, рекомендую курс “A History of Eastern Europe” от Gabriel Liulevicius; слушал даже дважды. Второй раз, кажется, после прохождения Kingdom Come Deliverance и перед посещением Чехии)

Про Европу в целом:

* у того же лектора есть курс “War, Peace, and Power: Diplomatic History of Europe, 1500-2000”. Очень интересно слушать про дипломатические игрища и европейский баланс сил (Concert of Europe). Кажется, отсюда и от Цвейга я много узнал про Габсбургов, потом с большим интересом ходил по венскому музею истории искусств и разглядывал габсбурские коллекции.

* у Mike Duncan есть еще один подкаст под названием “Revolutions”; каждый сезон освещает какую-то конкретную революцию. Я слушал про французскую; на реддите её советуют всем, кому интересно узнать побольше про Европу. Пока что меня хватило примерно на 100 эпизодов. Mike всегда делает очень подробные хронологические рассказы, детально описывает все, что происходит в рамках выбранного исторического периода. Круто, что ничего не упускается, но в определенный момент начинаешь уставать))

* еще рекомендую книгу Стефана Цвейга “World of Yesterday”, если хочется проникнуться вайбиками Европы до мировых войн.

Перед второй поездкой в Японию хотелось про нее что-нибудь поизучать. Подробную историю Японии я быстро дропнул =) А вот про современный период есть хороший курс под названием “The Rise of Modern Japan”. Внезапно, было интересно послушать про японский кинематограф.

И раз уж зашла тема про подкасты, хочу также порекомендовать подкаст по философии — "Philosophize This!". Слушать все эпизоды подряд необязательно, они самодостаточные.


Yandex Advanced Personal Intelligence Lab
(лаборатория перспективных исследований персонального интеллекта)

Возвращаюсь в Яндекс!

Моя давняя амбиция — немного подвинуть рексисоидов из Дипмайнда. Показать, что мы тоже умеем (научились) в рексис. Что у нас есть свое видение, навыки, и мы можем мощно контрибьютить в общее фундаментальное развитие рекомендательных систем. А еще персонализация — это, кмк, очень важная задача, которой в силу проф. деформации топовые лабы занимаются постольку-поскольку. Человечество пока не сильно продвинулось в персонализации агентов/чатботов; в общем, есть куда поконтрибьютить.

Чтобы эту амбицию реализовать, нужно:

* построить крутую команду — такой опыт у меня уже есть. Раньше я в основном "черпал" талантов из пула ммпшников; все самые удачные наймы — это кличи на стажировку в чатик выпускников/студентов ммп. Но даже самых талантливых ребят надо было года два учить рекомендашкам/large-scale диплернингу. Сейчас ситуация проще — рексис коммьюнити / популярность рексиса среди студентов / пул кадров растут; а с онбордингом помогает дипрексис курс.

* много ресурсов. Чем больше ресурсов (GPU/CPU/диска), тем быстрее ставятся эксперименты. На масштабе рекомендаций, когда мы работаем с очень большими датасетами (см. следующий пункт), без нормальных ресурсов вообще тяжело.

* конкретно в рекомендашках еще важен доступ к пользовательским данным; и чем больше данных, тем лучше — особенно для текущих фронтирных направлений.

* и, наконец, нужен доступ к продакшну и к коллегам, которые помогут быстро итерироваться в оном продакшне. Сильного доверия оффлайн-оценке качества в рекомендациях нет — она смещена из-за специфики пользовательского фидбека и продовой рексистемы. Для железных выводов нужны A/B-тесты. Если посмотреть на тот же (рексис) Дипмайнд — там всё сильно production-oriented и почти во всех статьях репортятся результаты A/B тестов; аналогично Spotify Research.

Что в итоге имеем:

* для первого пункта нужно вкладываться в популяризацию и развитие образования в области рекомендательных систем. Очень много усилий было вложено в дипрексис курс; мы на этом не останавливаемся и планируем вторую итерацию — более масштабную и ещё более актуализированную.

* для остального нужно быть частью индустрии. В академии нет нужного количества ресурсов, доступа к данным нужного масштаба и A/B тестов на реальных пользователях.

Так вот.

Буду строить свою лабу в Яндексе! Почему Яндекс: в любом другом месте мне потребовалось бы много времени, чтобы наладить инструменты, процессы, выстроить коммуникации, встроиться в организацию. Внутри Яндекса есть разные варианты, где этим можно заниматься — я выбрал Рекламу.

Почему Реклама: это самая большая и важная рекомендательная система Яндекса. На протяжении всей карьеры в Яндексе у меня было много совместных проектов с ребятами; все ключевые разработки, типа первых яндексовых рекомендательных трансформеров / Дипранкера (нейросетевого ранжирования) / Аргуса, туда успешно доехали. Команда в рекламе большая и экспертная — есть крутые зрелые R&D / продуктовые / инфровые команды, почти со всеми из которых я хорошо знаком и вместе работал. К ребятам можно органично встроиться ресерч лабой, с хорошей синергией; и с порога получить приличное количество ресурсов.

Чем будет заниматься лаба: тем же, чем занималась моя бывшая команда, но с еще большим фокусом на ресерч. Я это позиционирую как applied research — делаем долгосрочные исследования, но при этом сохраняем прикладной фокус; прямо как (рексис) DeepMind и Spotify Research. Конечная цель — импакт в продуктах и рост метрик; и важно то, какими методами мы будем этого достигать — через фундаментальные исследования и фронтир, а не через инкрементальные улучшения и жесткий тюнинг под домены. А ещё очень важно при этом поддерживать и развивать ресерч культуру и делиться результатами с сообществом — писать статьи, участвовать в конференциях, преподавать. Также я рассчитываю, что наши наработки в конечном счете будут полезны не только рекламе Яндекса, но и другим доменам (в том числе горячо любимой мной Музыке

3.2k 0 146 18 253


Небольшой тизер :)

Таксую чисто для души (шучу)


Посмотрел новый видеоролик Dwarkesh Patel про ситуацию с агентами и OpenAI, где он в том числе про третью волну агентов рассказывает. Мы после первых двух волн уже загнались, а тут еще и третья, более страшная… Непонятно почему так спокойно рассказывает, возможно оставил эмоции на четвертую волну — ждем, когда окажется, что агенты уже выкачали веса и сервят себя где-то на просторах интернета.

Вообще, если чем-то давно хотели заняться, но откладывали — возможно хороший момент))

Игорь в сиолошной рекомендует упражнения для спины, а я порекомендую компьютерную игру — сейчас самое время пройти Nier: Automata. Там, в целом, неплохо раскрыта тема persistent агентов с недостижимыми целями

P.S: от меня можно ждать в сентябре карьерных апдейтов. Stay tuned 👀


Когда прочитал UniPinRec: Unifying Generative Retrieval and Ranking at Pinterest Scale

За шакальное качество мемов извините, делал с планшета))


Forward from: next item


Отличный пост от Артёма


На пятый день KDD’26 ничего особо интересного не было.

Генеративные и LLM-based рекомендации, agentic RecSys — основные текущие тренды в рекомендашках, которые мы с вами обсудили в рамках этой серии постов.

В общем, как и всегда, спасибо, что читали!

P.S: ну а я теперь держу путь в Японию. Следующие две недели буду собирать гачапоны на Акихабаре и откисать в горячих источниках на Хоккайдо. Не теряйте))


KDD’26, день четвертый.

Сегодня в основном вел закулисные разговоры, про которые не могу ничего рассказать. А вот про что могу:

1. Доклад от команды YouTube и GDM. Судя по всему, у них прям очень жестко цензурируются любые рассказы наружу, ничего лишнего упоминать нельзя, поэтому они придерживаются формата пересказа уже опубликованных статей.

Держите еще одно название для кандгена — nomination. А преранжирование — prescoring. А группировку айтемов в выдачу в докладе нарекли packing.

В рамках доклада выступало четыре человека. Сначала был рассказ про knowledge distillation в ранжировании:
* упоминали две свои более старые работы — Bridging the Gap: Unpacking the Hidden Challenges in Knowledge Distillation for Online Ranking Systems и Zero-shot Cross-domain Knowledge Distillation: A Case study on YouTube Music
* и как раз на KDD’26 у них вышла новая статья — Addressing Intent Dissonance in Cross-Domain Distillation on YouTube. Кто первый прочитает, напишите в комментариях что там :)

Затем был раздел про анализ последовательностей:
* упоминали нашу любимую Top-K Off-Policy Correction for a REINFORCE Recommender System, а также оригинальный YoutubeDNN, в котором впервые предложили next watch prediction
* затем показали свою новую работу ClockRoPE: Random Fourier Rotations for Temporal Routine Modeling, в которой, как я понял, сделали time-aware RoPE, то есть учли время при анализе последовательности
* и еще одну новую работу Tokens are All You Need: Dual-purpose Semantic IDs for Achieving LLM-Level I/O Efficiency in recommendation systems. Заменили в рекомендательной нейросети эмбеддинги на семантические айдишники

Потом говорили про LLM x RecSys:
* упомянули TIGER, а также статью про semantic IDs для ранжирования в YouTube, PLUM, STATIC
* Token Factory: Efficiently Integrating Diverse Signals into Large Recommendation Models. Заменили в LLM семантические айдишники на эмбеддинги :)
* LLM-Based User Personas for Recommendations at Scale. Используют LLM для exploration с помощью генерации новых для пользователя интересов
* TokenMinds: Pretrained User Tokens and Embeddings for User Understanding in Large Recommender Systems. Делают семантический айдишник пользователя. У меня в этом году студент такую дипломную работу в бакалавриате вышки защитил))

Последняя, четвертая секция называлась Gemini Commercial Intelligence:
* это как раз работы команды Derek Cheng, подарившей миру DCN-v2
* как и писал в прошлом посте, делают ИИ-ресерчера, который их заменит (ну и нас тоже, за компанию). Прикладываю статьи ниже
* AgenticTagger: Structured Item Representation for Recommendation with LLM Agents
* PACEvolve: Enabling Long-Horizon Progress-Aware Consistent Evolution
* PACEvolve++: Improving Test-time Learning for Evolutionary Search Agents
* также активно занимаются бенчмарками для этого ИИ-ресерчера. Статья Evo-Memory: Benchmarking LLM Agent Test-time Learning with Self-Evolving Memory
* еще делают модель, которая по набору товаров будет генерировать рекламу, в которой эти товары присутствуют. Звучит немного рандомно, но в тему коммерциализации укладывается

3. Был доклад от Федора Борисюка про эволюцию ранжирования в Линкедине. Подсвечу лишь статью Semantic Search At LinkedIn; вроде как это их главная работа про ранжирование на текущий момент. Федор, как всегда, первый автор :)


KDD’26, день третий.

1. Keynote от Джеффа Дина. Это один из гигантов области ИИ, стоящий у истоков большого числа различных исследований и разработок Гугла, которыми мы все с вами пользуемся. Он буквально придумал MapReduce, TPU, tensorflow, был соавтором word2vec, mixture of experts, knowledge дистилляции; делал первый нейросетевой машинный перевод. В последние годы лидил разработку Gemini. У него 426490 цитирований на google scholar.

Пока текущий кейноут не залили на ютуб, можете посмотреть как в 2014 году он выступал на ACM RecSys с кейноутом Large Scale Machine Learning for Predictive Tasks.

Сначала сегодня был экскурс в его основные околонейросетевые работы, часть которых я упомянул выше. Забавные факты:
* в своем диссере из 90-х он уже занимался нейросетями — скейлил обучение до 32-х процессоров. Потом продолжил тем же самым заниматься в Гугле :)
* статью про knowledge distillation (которая с Хинтоном в соавторах) — реджектнули на NeurIPS со словами “это никому никогда не понадобится”))

Затем рассказывал про свой уход из Гугла — как объявлял на всю компанию что уходит; что очень много людей пришли на прощальную вечеринку, все не поместились в Гугл кафешке; что было очень много прощальных писем, он пытался на них все ответить, но не получалось, но он пытался, но не получалось... Сходил на йогу, поиграл в футбол, уволился.

И, наконец, рассказал про свою новую компанию Discovery Loop:
* основная идея — автоматизация типичного экспериментального пайплайна “propose experiment -> implement and run -> evaluate”
* К вопросу подходят масштабно — предполагается, что запускаться будет очень большое количество экспериментов, их результаты (и отрицательные, и положительные) будут использоваться агентами на следующих итерациях экспериментов. Ожидается, что при должном масштабировании это приведет к большому количеству научных прорывов
* Сначала фокусируются на digital областях, в которых эксперименты не требуют доступа к физическому миру
* Приводил как пример масштабного запуска экспериментов разработку Gemini, в которой одновременно принимали участие тысячи людей и мерджили результаты экспериментов в единую модель

Еще было немного про кодинг:
* сейчас происходит переход на следующий, еще больше верхнеуровневый этап программирования: ассемблер, C++, Python, а теперь — делегирование задач агентам
* по мнению Джеффа, агенты нас не заменят, а сделают продуктивней (ага, ага)

2. Вообще, сегодня я хорошенько прочувствовал, что агенты становятся основным трендом в рекомендательных технологиях. Семантические айдишники и генеративные рекомендации, конечно, это все еще очень горячая тема, про которую большие компании трубят из каждого угла; но уже появилось четкое ощущение, что самые передовые ребята занимаются агентами, а большие компании просто как всегда не поспевают за прогрессом.

Чуть более конкретно:
* пообщался с Derek Chеng (руководителем команды в Google DeepMind, в которой придумали DCN-v2). Раньше его команда помогала различным сервисам Гугла (в первую очередь рекламе) делать рекомендательные технологии — придумывали архитектуры нейросетей, работали над эффективностью, etc. А теперь они делают агента, который их заменит)) Буквально занимаются посттрейном LLM
* Артёму @nxt_item стажер из команды onerec-think/onereason Куайшоу сказал, что сейчас у них половина команды занимается проектом Агент X, суть которого буквально такая же — создать ИИ ресерчера, который их заменит

В общем, тренды страшные. Мы все призадумались; на постерной сессии полчаса стояли в кружке и пытались осмыслить надвигающийся экзистенциальный кризис. Если еще посты Игоря @seeallochnaya про ситуацию с OpenAI агентами почитать, то совсем страшно.

3. Также сегодня была вторая постерная сессия (вчера industry track, сегодня research), ее я провел в основном возле статьи A Unified Language Model for Large Scale Search, Recommendation, and Reasoning от Spotify, про которую в этом году уже даже на лекциях рассказывал!)

На этом всё. Следующий пост за меня будет писать агент

20 last posts shown.