Дмитрий Кузьмин | Инженерия данных


Channel's geo and language: Russia, Russian
Category: Technologies


Путь Data engineer от Junior до Lead.
Делюсь мыслями, рабочими кейсами, обучением. Блог для junior - middle DE.
Мой профиль: @dim4eg91
Сайт: https://kuzmin-dmitry.ru
Практикум Data engineer: https://kuzmin-dmitry.ru/de_practicum

Related channels  |  Similar channels
Channel's geo and language
Russia, Russian
Statistics
Posts filter


Ребят, хочу показать две мои недавние рецензии по ДЗ. Некоторые спрашивают, что означает моя личная проверка. Вот два случая, где одного скрина с результатом было бы мало.

В первой работе дата заказа строилась из крайнего срока отправки позиции. Временная аналитика из-за этого считала не то, данные неожиданно дошли до апреля 2020 года. Я указал строку с ошибкой и написал, какие витрины и проверки нужно пересчитать.

Во второй работе есть скрин Spark UI, но сохранённый notebook не воспроизводит этот результат. Часть кода закомментирована, проверки падают, а профиль снят с прежнего запуска. Я попросил выполнить notebook с нуля и приложить номера задач из Spark UI, чтобы связать метрики с кодом, который сдан сейчас.

Это рецензии разным участникам.

Так я разбираю каждую сдачу:
🎯читаю код и проверки,
🎯смотрю на смысл результата и возможность повторить запуск,
🎯в ответе пишу, что именно не сходится и как это проверить.

Пересдачу ради баллов я не требую. Если участник приносит исправление, проверяю его снова.

Шестой поток DE-практикума стартует 12 октября.

ℹ️ Короткая входная диагностика, отзывы, стенд: https://kuzmin-dmitry.ru/de_practicum
🎓 С полной программой можно ознакомиться на платформе Stepik: https://stepik.org/a/297679
❓ Если остались вопросы по курсу, напишите мне в Telegram: https://t.me/dim4eg91. Можно спросить про свой уровень, нагрузку или проверку ДЗ. Отвечу сам.

#DEпрактикум


Можно отдельно изучить SQL, Spark и Airflow, а потом всё равно не понимать, как связать их в один работающий пайплайн 🥵

Вчера получил отзыв от участника четвёртого потока. Меня особенно зацепило, что он отметил не отдельные технологии, а весь путь от SQL и Spark до Airflow и Metabase, а также большое количество проверок, которые заставляют глубже разбираться в решении.

Для меня это прям супер точное попадание в идею практикума.

Участник не начинает каждый модуль с пустого файла. В уроках есть рабочие шаблоны с TODO: часть логики нужно дописать самостоятельно, запустить код и показать фактический результат.

После этого я лично проверяю схемы, скрипты и данные. На каждое домашнее задание пишу рецензию: показываю, где результат может быть неверным, что стоит дополнительно проверить и как исправить решение. Обычно отвечаю в течение суток, хотя при высокой загрузке иногда требуется больше времени.

🛡 Такой формат требует времени. В среднем проект занимает 6–8 недель, а самые быстрые участники собирали полный контур примерно за месяц. Для старта достаточно среднего SQL, базового Python и готовности работать в терминале. Spark и Airflow заранее знать не нужно: они появляются по ходу проекта вместе с конкретной задачей.

В конце остаётся связный репозиторий, где данные проходят путь от исходных файлов до витрин: PostgreSQL и MinIO используются для хранения, Spark для обработки, Airflow для оркестрации, а проверки качества помогают контролировать результат перед загрузкой в BI.

За пять потоков в практикуме участвовали более 50 человек. Для меня такой формат тоже означает много ручной работы, но именно в ней я вижу смысл практикума: помочь участнику довести проект до состояния, которое он понимает и может объяснить.

По обратной связи уже планирую расширить материалы по моделированию хранилища. Все карты пока раскрывать не буду, но обновление получат участники всех потоков.

🤔 Если ты уже пишешь SQL, но пока не собирал весь путь данных от исходного файла до BI, на странице можно посмотреть программу, примеры сдач и проверить свою входную точку.

Шестой поток стартует 12 октября.
Подробнее - https://kuzmin-dmitry.ru/de_practicum
Stepik - https://stepik.org/a/297679

#DEпрактикум


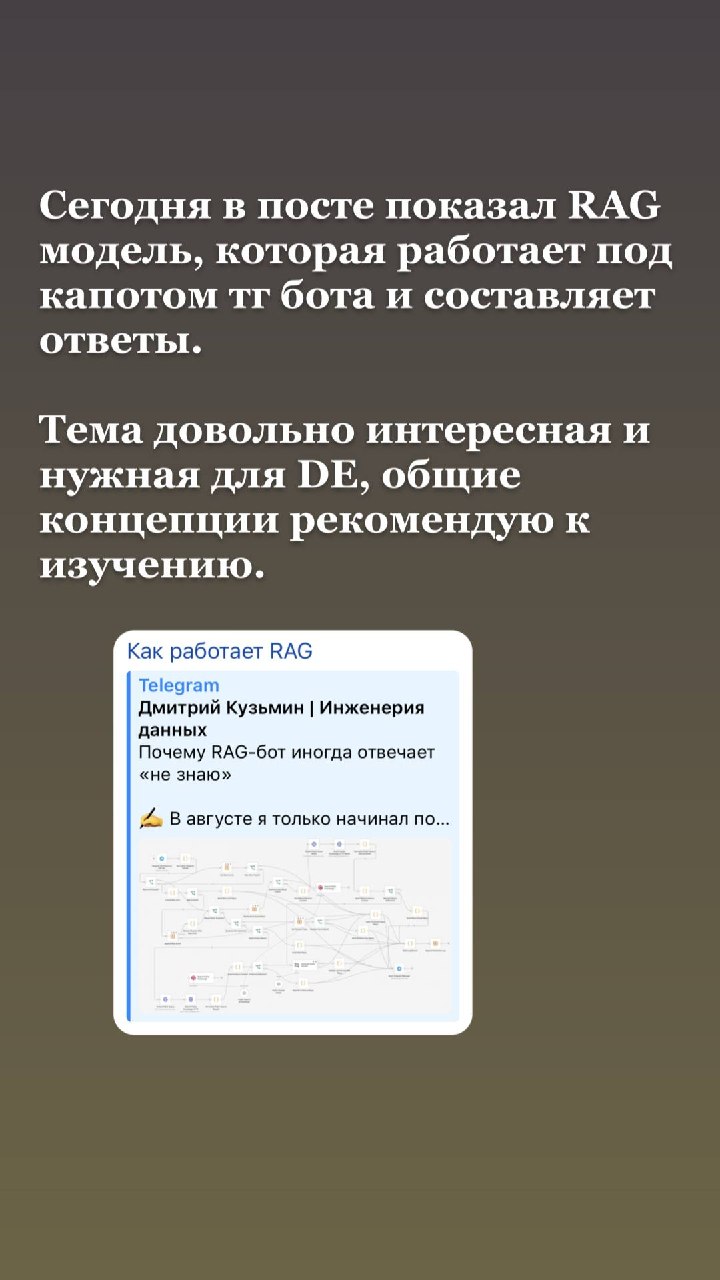
Почему RAG-бот иногда отвечает «не знаю»

✍️ В августе я только начинал погружаться в RAG и собирал первую версию информационного бота для DE-практикума. Тогда задача выглядела довольно коротко: загрузить материалы курса, подключить LLM и научить её отвечать на вопросы.

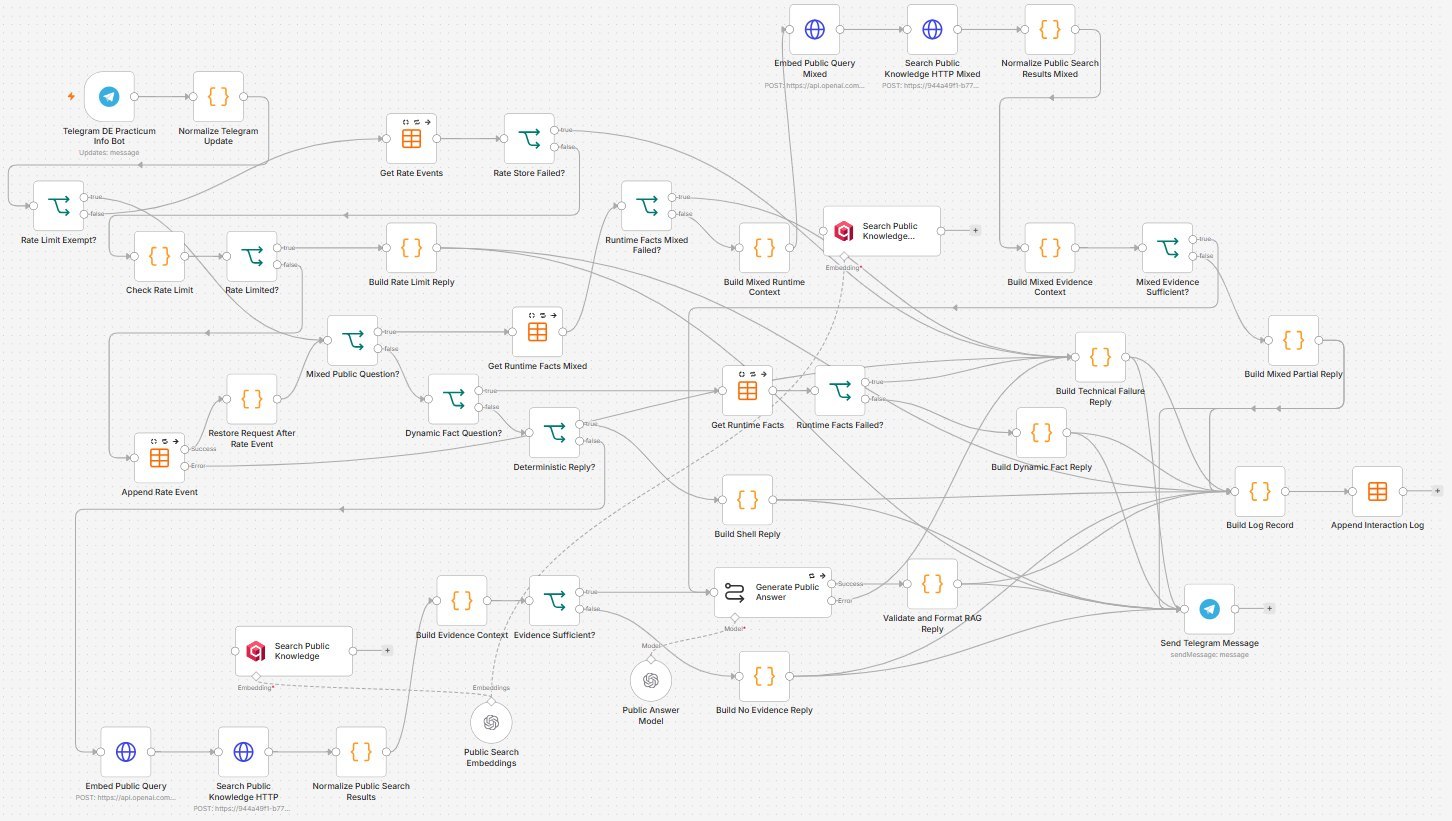
Сейчас бот уже работает в бета-режиме, а схема внутри выросла в нормальный пайплайн. Хочу показать, что происходит между сообщением в Telegram и готовым ответом, и почему иногда правильный результат этого пайплайна звучит как «я не знаю».

📣 RAG расшифровывается как Retrieval-Augmented Generation, или генерация с дополненным контекстом. Перед ответом модель получает несколько фрагментов, которые система нашла специально под вопрос пользователя. В этих фрагментах и нужно искать основание для ответа.

Например, человек спрашивает:
Я аналитик, уверенно пишу JOIN и оконные функции, Python использую для небольших скриптов. Достаточно ли такой базы для входа и когда стартует следующий поток?


Теперь подробнее, что происходит:

В одном сообщении смешаны два типа данных. Требования к входу лежат в программе и меняются редко. Дата старта, цена и количество мест относятся к текущим условиям, поэтому их нельзя доставать из старого описания курса.

Сначала бот определяет тему вопроса. Затем поиск находит в базе знаний фрагменты, близкие по смыслу. Каждый найденный фрагмент получает оценку близости: чем она выше, тем лучше текст соответствует вопросу. Актуальные условия бот получает отдельно и только после этого собирает общий контекст для модели.

Если поставить высокий порог, в контекст попадут только очень близкие фрагменты. Ответов станет меньше, зато случайный текст из соседнего урока почти не пройдёт. Если опустить порог, бот будет отвечать чаще, но вместе с полезным контекстом начнут приезжать слабо связанные куски. Из них модель легко собирает убедительный, но неверный ответ.

Порог я проверяю на контрольных вопросах: смотрю, какие фрагменты нашлись, с какими оценками и хватает ли их для ответа. Отдельно прогоняю смешанные формулировки и вопросы, ответа на которые в базе нет.

До генерации слабые фрагменты отсекаются по порогу. Затем система проверяет, покрывает ли оставшийся контекст сам вопрос. Если человек спросил и про требования, и про дату старта, ответа только на первую часть недостаточно.

После генерации валидатор проверяет, подтверждаются ли основные утверждения контекстом и закрыты ли все части вопроса. Если нет, бот задаёт уточнение, отвечает только на подтверждённую часть или сообщает, что данных недостаточно.

В лог сохраняются вопрос, найденные фрагменты, их оценки, решение валидатора и итоговый ответ. Так можно разобрать случай, когда текст звучит нормально, хотя доказательств под ним нет.

Здесь ответ «я не знаю» становится полезной функцией. Неверная цена, дата старта или требование к участнику могут привести человека к неправильному решению. Поэтому я скорее приму меньше ответов, но с понятным основанием. Генерировать мусор ради высокой доли ответов здесь нет смысла.

В итоге внутри получился знакомый инженерный маршрут: входное сообщение, классификация, поиск, отсечка по порогу, сборка контекста, проверка, генерация и логирование. Только вместо строк в таблице через него проходит текст.

⌨️ Вот, поэтому сейчас боту можно написать о своём опыте и спросить, подходит ли текущая база для практикума, что будет в модулях по Spark и Airflow или как устроена проверка работ: @de_practicum_info_bot

Шестой поток DE-практикума стартует 12 октября. Если бот ответит странно или пропустит часть вопроса, перешлите мне диалог. Такие примеры помогают точнее настроить поиск и пороги.

#материалы
#курсы


У блога появился свой герой 🐻

В последнее время здесь много пайплайнов, проверок качества, Spark и Airflow, поэтому я решил немного разбавить серьёзные разборы и собрал стикерпак с DE-медведем.

Внутри есть OOM, упавшие джобы, data skew, dependency hell, успешный backfill и тот самый момент, когда после обычного JOIN в таблице внезапно оказывается миллиард строк. В общем, почти стандартная рабочая неделя Data Engineer, только в виде медведя с ноутбуком.

Стикеры бесплатные, можно забирать и отправлять коллегам:

Забрать DE-медведя

У меня пока фаворит медведь после OOM, хотя again? тоже довольно жизненный 😅 Если будете использовать, напишите потом, какой стикер прижился больше всего и кадайте в комменты самый прикольный!


💬 Какой результат SQL отправить бизнесу?

Ребят, одна из частых ошибок в SQL-задачах состоит в том, что мы сразу открываем редактор, механически считаем показатель и отправляем заказчику готовую цифру. Я сам не раз на этом обжигался: запрос написан правильно, результат выглядит убедительно, а потом выясняется, что под одной и той же формулировкой мы понимали разные вещи.

Покажу на небольшом примере.

Менеджер присылает таблицу с заказами за сентябрь и просит посчитать, сколько клиентов было за месяц. Вроде бы обычная задача на COUNT, которую можно закрыть одним запросом.

order_id | customer_id | order_date
---------+-------------+-----------
1001 | 1 | 2026-09-02
1002 | 1 | 2026-09-11
1003 | 2 | 2026-09-04
1004 | 3 | 2026-09-06
1005 | 3 | 2026-09-18
1006 | 4 | 2026-09-22

На первый взгляд задача простая, но по этим данным можно вернуть как минимум три правдоподобных ответа: 6, 4 или 2. Какой из них вы бы отправили менеджеру?

Попробуйте сначала выбрать свой вариант, а затем посмотреть разбор ниже.

Теперь разбираемся

Если выполнить COUNT(*), получится 6, но это количество заказов, поскольку одна строка в таблице соответствует одному заказу. Запрос выполнился правильно, только на вопрос о клиентах он не ответил.

COUNT(DISTINCT customer_id) вернёт 4. Это количество уникальных клиентов, которые сделали хотя бы один заказ в сентябре, и именно такой смысл чаще всего подразумевают под числом покупателей за период.

Если сгруппировать данные по customer_id и оставить клиентов с двумя и более заказами, получится 2. Но называть их повторными клиентами пока рано: мы видим только сентябрь и не знаем, покупали ли клиенты 2 и 4 раньше. Для одного бизнеса повторная покупка означает второй заказ внутри месяца, а для другого любой заказ после первой покупки за всё время.

Все три числа можно получить корректным SQL-запросом:

with customer_orders as (
select
customer_id,
count(*) as orders_cnt
from orders
where order_date >= '2026-09-01'
and order_date < '2026-10-01'
group by customer_id
)
select
sum(orders_cnt) as orders_cnt,
count(*) as buyers_cnt,
sum(
case
when orders_cnt >= 2 then 1
else 0
end
) as clients_with_2plus_orders
from customer_orders;

Обратите внимание на границу периода: условие order_date < '2026-10-01' безопаснее, чем попытка перечислить все возможные значения последнего дня сентября, особенно если в поле хранится не только дата, но и время.

Результат будет таким:

orders_cnt | buyers_cnt | clients_with_2plus_orders
-----------+------------+--------------------------
6 | 4 | 2

При этом правильного ответа на фразу «сколько клиентов было за месяц» всё ещё нет, пока мы не договорились о смысле метрики. Вместо того чтобы угадывать, я бы вернулся к менеджеру с конкретным вопросом:

Уточню смысл: считаем всех уникальных покупателей с заказом в сентябре, клиентов с двумя и более заказами внутри месяца или тех, кто в сентябре вернулся после своей первой покупки за всю историю?


В работе к этому добавятся статусы заказов, возвраты, границы периода и часовой пояс. Самая опасная ошибка здесь появляется ещё до написания SQL, когда расплывчатую формулировку превращают в точную цифру, а потом эта цифра попадает в отчёт и начинает выглядеть как факт.

Поэтому я бы не отправлял ни 6, ни 4, ни 2, пока не зафиксирован смысл метрики. Хороший запрос начинается с ответа на два вопроса: что означает одна строка исходных данных и какой бизнес-смысл должна иметь итоговая цифра.

❔ Если хотите проверить, где у вас заканчивается уверенный SQL, на сайте есть страница с небольшой диагностикой.

#материалы


Когда пайплайн упал в пятницу в 18:30, но дежуришь не ты.

С пятницей! Пусть выходные пройдут отлично! 🥳


Сначала выучу весь DE-стек

У меня переход в Data Engineering тормозился примерно на этой мысли.
Сначала нужно разобраться с Docker. Потом с Airflow. Ещё Spark, Kafka, облака, форматы хранения… Список рос, а момент «теперь можно собрать первый проект» всё откладывался.

У такой подготовки нет финиша. Всегда найдётся ещё один инструмент, который вроде бы надо изучить заранее.

Сейчас перед первым учебным проектом я бы проверял базу по трём вещам:

🟣 SQL. Могу написать запрос, соединить таблицы, посчитать агрегаты и объяснить, почему после JOIN строк стало больше.
🟡 Python. Могу прочитать файл, обработать данные и разобраться в чужом несложном коде.
🔘 Docker. Могу запустить контейнеры, проверить их состояние и посмотреть логи, если что-то сломалось.

Оконные функции стоит подтягивать по ходу работы с SQL. Слои хранилища, оркестрацию и Spark тоже проще осваивать, когда понятно, какую задачу ты ими решаешь.

Но как понять, хватает ли именно твоей базы?

Этот вопрос мне задают и про DE-практикум. Чтобы с ним было проще разобраться, я собрал информационного бота.

Недавно показывал, как изучаю LLM и n8n. Бот стал одним из результатов: я собрал материалы о практикуме, добавил контекст по программе, формату и входным требованиям, проверил ответы. Теперь можно попробовать альфа-версию.

Боту можно написать о своём опыте или сразу спросить то, что важно перед участием. Например:

Работаю аналитиком 1,5 года, знаю SQL на уровне оконок и питон использую для формирования отчетов (автоматический скрипт), умею читать функции. Этого достаточно для входа? И когда старт потока?

Что изучается в spark и airflow? Насколько детально и глубоко?

Как устроена поддержка и проверки домашек? Есть ли дедлайны?


Он поможет сориентироваться в требованиях и формате. Это пока альфа: бот может неправильно понять вопрос или ошибиться в ответе. Если ответил невпопад, попробуйте переформулировать.

✅ de_practicum_info_bot

В следующих постах покажу, как он устроен: как обрабатывает вопрос, откуда берёт информацию и что пришлось доработать, чтобы ответы стали полезными 😅


Наконец-то нормальное объяснение JOIN 😆

С пятницей!


112 650 строк загрузились. Этого достаточно? 😧

В одной из сдач по DE-практикуму в итоговой таблице получилось 112 650 строк. На первый взгляд всё нормально: загрузка прошла, таблица заполнилась, можно идти дальше и собирать витрину.

Но сначала нужно понять, что означает одна строка в этой таблице. В нашем случае это одна позиция заказа, а её уникальность определяется парой order_id и order_item_id.

Допустим, при сборке факта к позиции заказа присоединились две версии одного клиента. Запрос выполнится без ошибки, таблица заполнится, но строк станет больше, а выручка в отчёте окажется завышенной. Скорее всего, проблему заметят уже в BI, где искать её будет гораздо сложнее.

➡️ Поэтому отдельно проверяем, нет ли в факте повторяющихся позиций:

select
order_id,
order_item_id,
count(*) as row_count
from core.fct_order_items
group by
order_id,
order_item_id
having count(*) > 1;

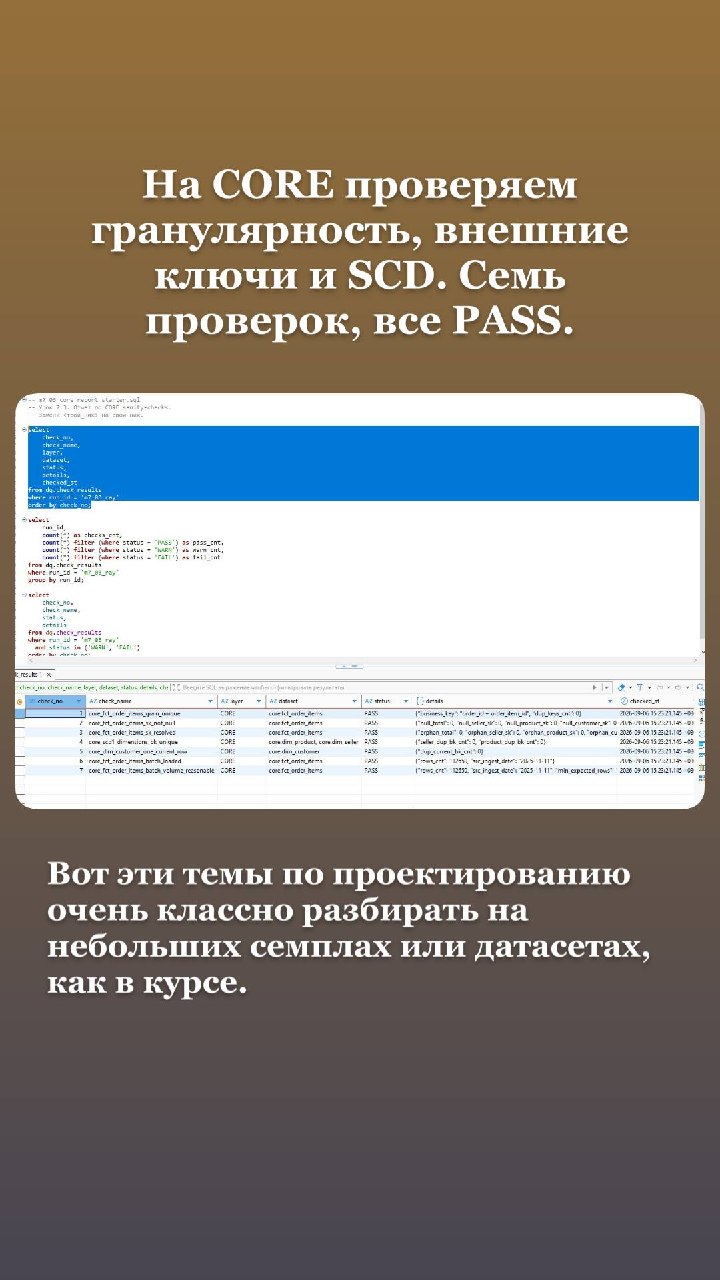
Пустой результат означает, что дублей по выбранной гранулярности нет. Дальше проверяем внешние ключи товара, продавца и клиента, а также убеждаемся, что для одного клиента не осталось несколько актуальных версий.

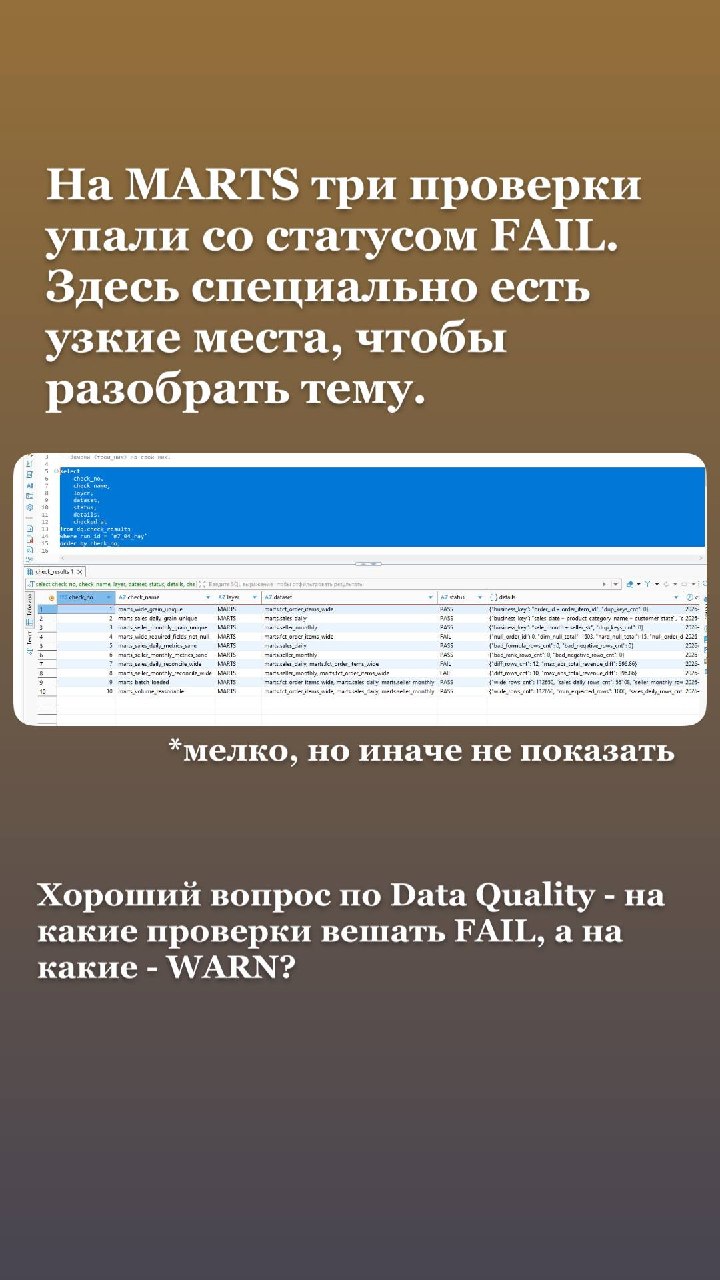
↘️ На втором скрине эти проверки уже собраны в pipeline_smoke_check в Airflow. Количество дублей, пустых ключей и конфликтующих версий равно нулю, а размер текущей загрузки составляет те самые 112 650 строк.

Теперь эти проверки не нужно каждый раз повторять руками. При следующем запуске пайплайн выполнит их сам и сохранит результат для конкретной загрузки.

В работе инженер данных отвечает за то, чтобы аналитики и другие потребители получили данные, которым можно доверять. Поэтому на собеседованиях регулярно спрашивают про уникальность, полноту, связи между таблицами и корректность загрузки.


👍 Можно начинать с двух простых вопросов: что означает одна строка в таблице фактов и какие поля делают её уникальной? Если на них есть внятный ответ, дальше уже понятно, какие проверки нужно встроить в пайплайн.

#кейсы


📢 6 вредных привычек для потери времени в Data Engineering

Собрал несколько плохих привычек, которые когда-то были у меня самого. Некоторые стоили пары часов, некоторые целого вечера, а одна чуть не снесла всё Docker-окружение.

1️⃣ Делать красиво раньше, чем правильно

Раньше я мог добавить ещё один CTE, переименовать все поля и начать оптимизацию до того, как проверил сам расчёт.

Проблема в том, что красивый запрос тоже может считать ерунду. Только место ошибки в нём искать сложнее.

Сейчас сначала собираю простой рабочий вариант, запускаю на небольшом сэмпле, проверяю количество строк, уровень данных и контрольные суммы, а потом уже можно рефакторить и оптимизировать.

2️⃣ Менять во время отладки сразу всё

Однажды я одновременно правил docker-compose, переносил WSL, чистил диск и переустанавливал окружение. В итоге потерял контейнеры, образы и случайно снёс Java runtime.

Когда меняешь пять вещей сразу, невозможно понять, какая из них помогла, а какая всё окончательно сломала.

Лучше поменять что-то одно, одну переменную, снять метрики, потом заново. И это правда работает, потому что получаешь одно изменение и можешь его объяснить.

3️⃣ Оставлять полезный код в tmp и ноутбуках

Кажется, что скрипт временный и больше не пригодится. Потом сессия падает, каталог очищается, а через месяц, как всегда это бывает, нужен именно этот код.

Теперь даже черновые скрипты стараюсь отправлять в Git. Пусть файл пока некрасивый, зато он не исчезнет вместе с окружением.

4️⃣ Доверять автоматически определённым типам

У меня разваливалась вставка из-за того, что один из выходных типов не совпал со схемой целевой таблицы. Логов было мало, поэтому до причины я дошёл далеко не сразу.

С тех пор в важных местах явно задаю схему, использую CAST и даже для пустых колонок фиксирую ожидаемый тип. Особенно при чтении CSV, перед INSERT и UNION.

5️⃣ Проверять всё руками и не оставлять след

Раньше я мог скопировать несколько запросов, руками заменить таблицы и даты, посмотреть результат и закрыть вкладку. Через неделю приходилось вспоминать, что именно я сверял.

Повторяющиеся проверки теперь стараюсь параметризовать, а важные результаты записывать в DQ-журнал: дата, таблица, название проверки, статус и значение.

6️⃣ Лечить медленный Spark добавлением ресурсов

Первая реакция на медленную или падающую Spark job понятная: дать больше памяти и ядер. Иногда это помогает. Иногда job просто дольше ждёт ресурсы, которых в очереди нет, а настоящая проблема остаётся в shuffle, перекосе данных или неудачном числе партиций.

Поэтому сначала смотрю план выполнения, Spark UI и ограничения кластера. И только потом добавляю ресурсы.

Все эти привычки поначалу выглядят как экономия времени.

⬇️ Делитесь своими плохими привычками, которые когда-то были.


Немного личного: теперь я КМС

Друзья, хочу поделиться новостью. Помимо любимой айтишной работы у меня есть ещё одно серьёзное увлечение: тяжёлое железо 🏋️

Вчера мне официально присвоили разряд кандидата в мастера спорта по становой тяге. Теперь всё по-настоящему: со значком и разрядной книжкой.

Шёл к этому не быстро, но последовательно. Большие цели, будь то спорт, учёба или работа, обычно складываются из маленьких действий, которые повторяешь достаточно долго.

Вчера все эти шаги сложились в результат. Очень рад 🖤

P.S. Ребят, всем кто скидывал мне домашки по практикуму, в ближайшее время обязательно отвечу, был занят.


За последний год у меня собралась линейка курсов по SQL и Python.

Эту линейку я весь год дорабатывал: пересматривал задачи, добавлял практику и менял то, что по обратной связи оказывалось слабым. По обратной связи от тех, кто уже прошёл курсы, я продолжаю обновлять задачи и добавлять то, что чаще встречается в работе и на собеседованиях.

Здесь не обязательно брать самый большой курс или сразу всю программу. Полезнее выбрать один навык, которого не хватает в работе или на собеседованиях прямо сейчас.

⭕️ Если пока путаются SELECT, WHERE, GROUP BY и первые соединения, лучше начать с основ.

⭕️ Если ты пока неуверенно работаешь с JOIN, GROUP BY, NULL и базовыми бизнес-условиями, начни с Junior.

⭕️ Если обычные запросы уже даются нормально, но есть сложности с CTE, окнами и ранжированием, тебе подойдёт Middle.

⭕️ Middle+ рассчитан на тех, кому база и окна уже знакомы, но не хватает плотной практики со сложными задачами и объяснением решений на собеседованиях.

⭕️ Python стоит выбрать, когда SQL уже держится, а работа с файлами, функциями и небольшими пайплайнами всё ещё идёт медленно.

⚠️ Если текущие задачи и так решаются уверенно, покупать ещё один курс только из-за скидки смысла нет.

🛒 До 31 августа включительно действуют специальные цены:

• ️SQL основы: 3190 → 2600 ₽
• SQL Junior: 2690 → 2300 ₽
• SQL Middle: 3490 → 3000 ₽
• SQL Middle+ : 4290 → 3700 ₽
•️ Python для DE: 2500 → 2200 ₽

Если нужен последовательный маршрут, есть два комплекта:

• Junior + Middle: 5390 → 4500 ₽
• SQL Pro pack: 8690 → 7300 ₽

Перед покупкой можно посмотреть примеры задач и пройти диагностику. Она поможет выбрать уровень: Выбрать свой маршрут

⚠️ Промокод TG_AUGUST_2026 действует до 31 августа включительно.

Доступ к курсам остаётся бессрочным. Можно купить сейчас, а пройти позже в удобном темпе.

#курсы


Как посчитать несколько метрик без четырёх подзапросов

Задача не выглядит эффектно, зато постоянно встречается при разработке витрин.

🟫 Допустим, в одной строке за каждый месяц нужно получить:

• общее число заказов;
• число оплаченных заказов;
• долю оплаченных;
• выручку по оплатам.

Похожая задача есть и в моём курсе SQL Middle.

Можно написать несколько подзапросов, посчитать в каждом свою метрику, а потом соединить результаты. Но для такой задачи это лишняя конструкция.

☕️ Я обычно использую условную агрегацию через SUM(CASE WHEN ...):

select
date_trunc('month', created_at)::date as month_start,
count(*) as total_orders,
sum(
case
when status = 'paid' then 1
else 0
end
) as paid_orders,
round(
100.0 * sum(
case
when status = 'paid' then 1
else 0
end
) / count(*), 1
) as paid_share,
sum(
case
when status = 'paid' then amount
else 0
end
) as paid_revenue
from orders
group by 1
order by 1;

Каждый CASE решает, какие строки попадут в конкретную метрику. Все метрики считаются в рамках одной агрегации, без отдельных подзапросов и JOIN между их результатами.

Главное, не выносить status = 'paid' в общий WHERE. Иначе неоплаченные заказы исчезнут ещё до агрегации, а доля оплат получится бессмысленной.

✅ В PostgreSQL ту же логику можно записать короче через FILTER:

count(*) filter (where status = 'paid')

В конкретной задаче это аналог:

sum(case when status = 'paid' then 1 else 0 end)

Мне чаще удобнее SUM(CASE WHEN ...): конструкция читается буквально и поддерживается разными СУБД. Но для PostgreSQL вариант с FILTER тоже вполне рабочий.

Такой шаблон подходит не только для заказов. Тем же способом считаются этапы воронки, статусы событий, категории ошибок и результаты проверок качества данных.

Ставь реакцию:

🔥 - знаю и применяю конструкцию
🤔 - узнал новое

#база_знаний


Начал ковыряться в n8n ⌨️

Вокруг него много разговоров про ИИ-агентов и автоматизацию всего подряд. Я очень долго смотрел на этот сервис и все никак не мог подступиться. Сейчас захотелось собрать несколько схем руками и понять, как это работает.

🔛 Пока попробовал загрузку текста через webhook, разбиение на части, простое векторное хранилище и поиск по нему. Затем добавил Telegram: отправляешь вопрос, workflow находит подходящие фрагменты и возвращает ответ.

Визуально всё выглядит понятно, но внутри очень много деталей: структура items, связи между узлами, циклы, преобразования и передача контекста. Как раз это и интересно поковырять самостоятельно, и с первого раза сложно. Сервис напоминает конструктор Lego.

Дальше хочу посмотреть, насколько n8n удобен для обычных задач с данными: API, проверки, небольшие загрузки и уведомления об ошибках. Интересно также собрать своего помощника для простых повторяющихся действий. Кажется, что это может упростить отдельные задачи, как в свое время я написал скрипт по сборке файлов для релизов 🎧

Статьи, с которых начал:
• n8n: всё, что нужно знать о сервисе
• n8n: реальные возможности и ограничения
• Плюсы и минусы n8n

Если уже что-то собирали в n8n, накидайте интересных сценариев. Особенно интересны сценарии вокруг данных и обучения.

#материалы

669 0 12 3 17

📌 Сегодня хочу дать шпаргалку. SQL-запрос легко прочитать и неправильно представить, как он выполняется.

Мы пишем SELECT первым, хотя движок добирается до него далеко не сразу. Понимание этого порядка часто проверяют на собеседованиях по SQL, аналитике и Data Engineering.

Упрощённый логический порядок выглядит так:

FROM → JOIN → WHERE → GROUP BY → HAVING → оконные функции → SELECT → DISTINCT → ORDER BY → LIMIT


⬇️Какие отсюда следствия:

• WHERE фильтрует исходные строки до группировки;
• HAVING работает уже с результатами группировки;
• оконные функции считаются после WHERE, GROUP BY и HAVING, поэтому обратиться к результату ROW_NUMBER() в WHERE того же запроса нельзя (важно);
• ORDER BY видит алиасы из SELECT, а WHERE обычно ещё не видит.

Например, если нужно оставить только первую строку внутри каждой группы, придётся использовать подзапрос, CTE или QUALIFY, если СУБД его поддерживает.

Но логический порядок ещё не означает, что база физически выполнит операции именно так.

⬆️Оптимизатор может:

• протолкнуть фильтр ближе к чтению данных;
• не читать лишние столбцы и партиции;
• поменять порядок JOIN;
• выбрать Hash Join, Merge Join или Broadcast Join;
• добавить сортировку, Exchange или Shuffle.

По плану выполнения можно заметить полное чтение таблицы вместо нужных партиций, лишний Shuffle, перекос данных, неудачную стратегию JOIN или большую разницу между ожидаемым и фактическим количеством строк.

Поэтому к запросу стоит задавать не только вопрос «правильный ли получился результат?», но и «что движку пришлось сделать, чтобы его получить?».

В PostgreSQL для этого есть EXPLAIN ANALYZE, в Spark — explain() и Spark UI.

Сохраняй и ставь 🔥, если было полезно.

#материалы


🆙 В понедельник, 10 августа, стартует пятый поток DE-практикума.

🧩 Если совсем простыми словами, мы берём сырые CSV-файлы и постепенно превращаем их в нормальный работающий проект: принимаем данные, чистим ошибки, раскладываем по слоям, запускаем обработку и доводим всё до отчёта для бизнеса.

По пути поднимаем Docker-стенд, работаем с PostgreSQL, Spark, Airflow, MinIO и BI. Хочется, чтобы в конце ты действительно понимал, как движутся данные, зачем нужен каждый слой, где искать ошибку и как перезапустить пайплайн, если что-то пошло не так.

Я собирал этот практикум примерно так, как сам хотел бы изучать Data Engineering: на одном цельном проекте, руками и с возможностью задать вопрос, когда застрял. Для меня это давно уже не просто записанный курс. Я постоянно что-то дополняю, переписываю и стараюсь проще объяснять места, на которых участники спотыкаются.

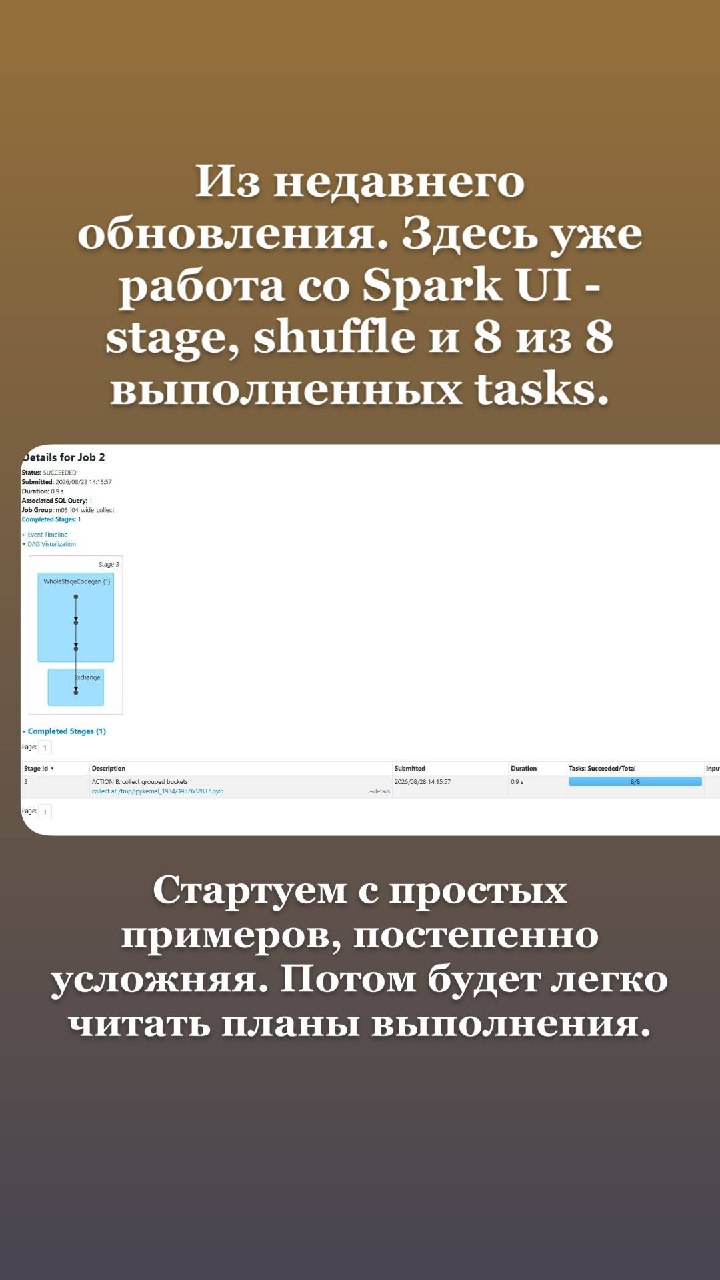
🆕 Буквально вчера полностью обновил модуль по основам Spark. Добавил Spark UI, карту архитектуры и задания по чтению Jobs, Stages, Tasks и Executors.

Теперь можно легко посмотреть, что происходило внутри, как распределилась работа и где искать проблему, если обработка начала тормозить.

В пятом потоке этот модуль уже будет. Участникам предыдущих потоков тоже добавлю обновление в течение недели.

🔎 Заранее знать Spark и Airflow не нужно. Достаточно базы SQL, немного Python и желания разобраться. При этом нужно быть готовым выделять на практикум примерно 6–8 часов в неделю и действительно работать руками.

Если что-то непонятно, будем разбираться вместе. Я много отвечаю участникам и остаюсь на связи до полного прохождения, а не только до формального окончания потока. Мне правда важно, чтобы человек не просто получил доступ, а смог собрать проект до конца.

⏰ Старт 10 августа.

Программа и короткая диагностика

💬 Если интересно, но остались сомнения или вопросы, просто напиши мне: @dim4eg91. Посмотрим на твою текущую базу и решим, комфортно ли тебе заходить сейчас.

#путь_DE


(Кейс из сториз)


🥳 Наконец-то обновил сайт

Как многие, наверное, уже заметили, за последние пару недель я почти полностью пересобрал сайт.

Я менял не только оформление. Главное, что теперь по сайту можно пройти от своей текущей точки до подходящего курса или практикума:
посмотреть программу, требования к старту, примеры задач и ожидаемый результат.

🔍 Что изменилось:

1️⃣ Разделил направления

Теперь на сайте три отдельные траектории:
→ SQL
→ Python для работы с данными
→ Data Engineering

Все направления и точки входа собраны на главной странице.

2️⃣ Выстроил понятный маршрут по SQL

SQL-линейка теперь разделена по уровням:
→ база: JOIN, GROUP BY, NULL, даты и CTE
→ Junior: подготовка к собеседованиям
→ Middle: оконные функции и сложные запросы
→ Upper-Middle: очень плотная практика

Добавил примеры задач, чтобы можно было заранее оценить сложность, а не ориентироваться только на описание.

Там же появилась короткая SQL-диагностика. Она помогает определить текущую точку и предлагает следующий курс или маршрут по всей линейке.

3️⃣ Отдельно оформил Python для работы с данными

Это не общий курс по языку, а практика с файлами и данными: CSV, JSON, даты, Decimal, дубли, некорректные строки, группировки и небольшие batch-пайплайны.

На странице можно посмотреть программу и примеры задач, а заодно понять, достаточно ли текущей базы Python для такого формата.

4️⃣ Полностью пересобрал страницу DE-практикума

На странице практикума теперь видно, что именно делает участник и что остаётся после прохождения.

Отдельно показал рабочие экраны, восемь этапов проекта, формат участия, требования к входу, отзывы и условия потока.

Там же работает диагностика готовности. Шесть вопросов проверяют SQL, Python, чтение кода, окружение и доступное время, а затем предлагают следующий шаг.

5️⃣ Добавил бесплатную точку входа

Перед практикумом можно поднять демо-проект: локально запустить PostgreSQL и Airflow, пройти путь данных от CSV до витрины и выполнить несколько проверок.

Это небольшой, но настоящий фрагмент работы внутри полного проекта.

📆 Пятый поток DE-практикума стартует 10 августа.

Если маршрут уже понятен, перейти к подходящему курсу можно прямо со страницы направления.

На DE-практикум сначала лучше пройти диагностику или оставить заявку. После заявки я сверю входную точку и пришлю ссылку на оплату. После оплаты отправлю чек-лист по инструментальной подготовке, чтобы до старта спокойно проверить окружение.

😡 Если полазите по сайту и напишете, где чего не хватает или что осталось непонятным, буду благодарен. Можно в комментариях или мне лично.

P.S. Пока сайт работает на Tilda. Следующим техническим шагом рассматриваю переезд на отдельный сервер: хочу ускорить загрузку и сделать переходы между страницами плавнее.


Один файл, четыре слоя и сумма, которая легко уезжает

В пятницу показал дерево репозитория практикума и обещал показать что-нибудь интересное 😡

На скрине было много папок: data, dags, db, scripts, spark, checks. Без контекста это выглядит просто как большой технический проект, и сложно понять, что к чему.

Допустим, источник прислал orders.csv.
Внутри идентификатор заказа, дата, статус и сумма. Одна сумма записана как 1299.90, другая как "1 299,90". Где-то нет даты, часть заказов повторилась, а один и тот же файл вообще могли прислать второй раз.

😮 Путь этого файлика будет примерно таким:
orders.csv → RAW → STG → CORE → MARTS → BI


1️⃣ В RAW сохраняем файл таким, каким он приехал. Вместе с ним полезно зафиксировать имя, дату загрузки, источник, количество строк и хеш.
Если дальше что-то сломалось, можно вернуться к исходному файлу и понять, что именно было на входе. Также хеш помогает проверить, не загружали ли мы этот файл раньше.

2️⃣ В STG начинаем приводить данные в порядок. Нормализуем названия колонок, разбираем даты, превращаем сумму в число, ищем пустые обязательные поля. Строки с ошибками лучше складывать отдельно, чтобы они не исчезали бесследно.
Здесь же возникает важный вопрос: какие дубли технические, а какие действительно пришли из источника? Просто сделать DISTINCT обычно недостаточно, потому что он уберёт одинаковые строки, но не объяснит, почему они появились.

3️⃣ В CORE собираем нормальную модель данных. Определяем ключ заказа, связываем его с клиентом и платежом, разбираемся со статусами, отменами и возвратами.
Именно здесь сумма начинает получать бизнес-смысл. Заказ создан, но не оплачен. Оплачен, но потом возвращён. Частично оплачен. Все эти случаи могут выглядеть одинаково в исходном CSV, но по-разному влиять на выручку.

4️⃣ В MARTS данные уже собираются под конкретный вопрос: продажи по дням, заказы по регионам, средний чек или показатели для дашборда.
На этом шаге особенно важно понимать гранулярность таблицы. Одна строка здесь означает заказ, товар в заказе, клиента или день? Если ошибиться, обычный JOIN легко размножит сумму, а итоговая цифра при этом будет выглядеть вполне правдоподобно.

😎 В практикуме этот путь собирается на локальном стенде. MinIO хранит файлы, Spark их обрабатывает, CORE и MARTS лежат в Postgres, Airflow запускает шаги в нужном порядке, а проверки помогают поймать расхождение до BI.

➡️ Небольшая проверка для своего проекта: возьмите одно поле, например amount, и попробуйте провести его от источника до отчёта.

Как оно выглядело в исходном файле?
Где поменялся тип?
На каком шаге добавилась бизнес-логика?
Когда появилась агрегация? Как проверить итоговую сумму?


🔦 Если на эти вопросы есть ответы, путь данных уже читается намного понятнее.

Ставь 🔥 если было полезно и показало картину немного сверху.

#путь_DE


🐻 Сегодня моему блогу про Data Engineering ровно 2 года! ✨

Спасибо всем, кто читает, отвечает, спорит, задаёт вопросы и иногда просто молча остаётся рядом!

Очень ценю, что всё это время вы здесь! ❤️❤️❤️

20 last posts shown.