


AI ликбез: RAG (Retrieval Augmented Generation) ч.1
Решил, что RAG как концепция настолько важен для современных AI приложений, что несмотря на широкую общеизвестность, все равно заслуживает отдельной серии постов в канале.
1️⃣ RAG (Retrieval Augmented Generation) - это подход, когда перед генерацией LLM ответа, приложение ищет релевантую информацию в внешних данных и добавляет ее в контекст вопроса, делая генерацию ответа аргументированной.
Схематично:
RAG = поиск релевантной информации > создание контекста > генерация ответа LLM по контексту
Главная идея: не нужно учить модель всем вашим данным, нужно научить систему находить правильный контекст для модели.
Скорее всего вы уже пользуетесь приложениями, использующими RAG в том или ином виде, потому что это базовый кирпичик поверх которого строится работа AI ассистентов, копайлотов или агентов.
2️⃣ RAG призван решить следующие проблемы:
- LLM не знает ваши внутренние документы
- LLM может галлюцинировать и нужна верифицируемость ответов (например, ссылки на источники)
- Знания LLM устаревают
В качестве альтернативы RAG рассматривают prompt engineering или fine-tuning. Но в-первом случае, невозможно добавить много документов и знаний в один промпт из-за ограничений размера контекстного окна и высокой стоимости токенов, а следовательно вопросов-ответов. А во-втором, стоимость дообучения модели и необходимость постоянно добавлять данные делают его практически непригодным для часто изменяющихся данных.
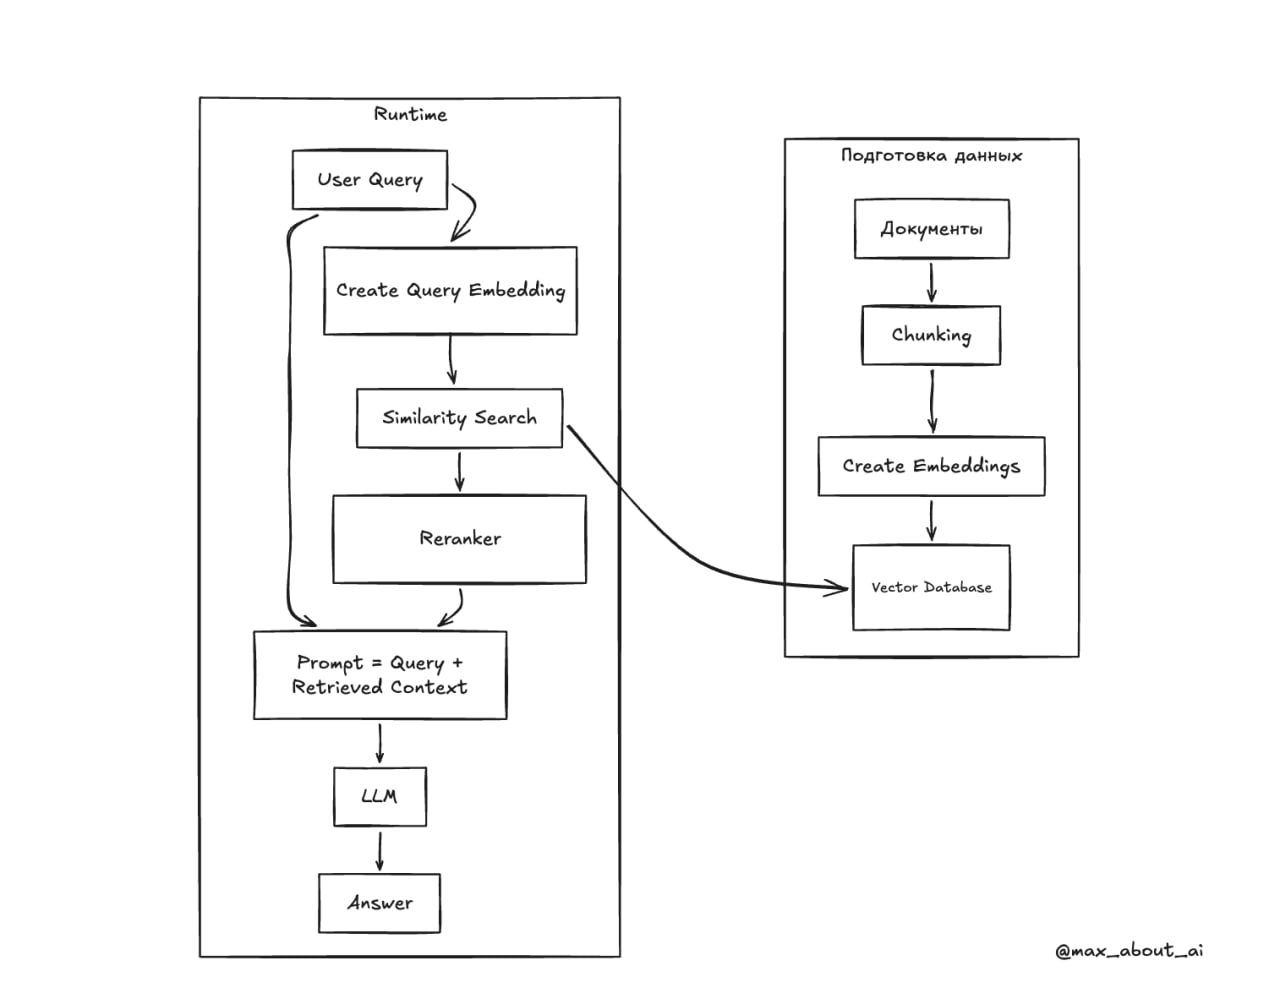
3️⃣ Базовым подходом к поиску в RAG является векторный поиск. Он не всегда лучший, но самый популярный. Часто базовый пайплайн называют Naive RAG и он состоит из двух этапов:
Этап 1. Подготовка данных:
Документы -> Chunking (разбиение на части) -> Embedding generation (векторизация) -> Vector DB
Этап 2. Рантайм:
Вопрос -> Retriever (векторный поиск в базе данных) -> Reranker (сортировка по наибольшей релевантности) -> LLM -> Ответ и источники
В научных работах и на синтетических бэнчмарках Naive RAG показывает хорошие результаты, но на практике существует бесконечное количество подводных камней и пограничных ситуаций. Если полученная система на основе Naive RAG показывает 90% точности на репрезентативной выборки - это считается очень хорошим результатом, но такая точность не достаточна для большинства бизнес-сценариев. Поэтому в большинстве систем Naive RAG либо заменяется либо дополняется более продвинутыми техниками.
Про разные архитектуры, оценку качества, проблемы и путь от прототипа до продакшена, я расскажу в следующих частях.
@max_about_ai