


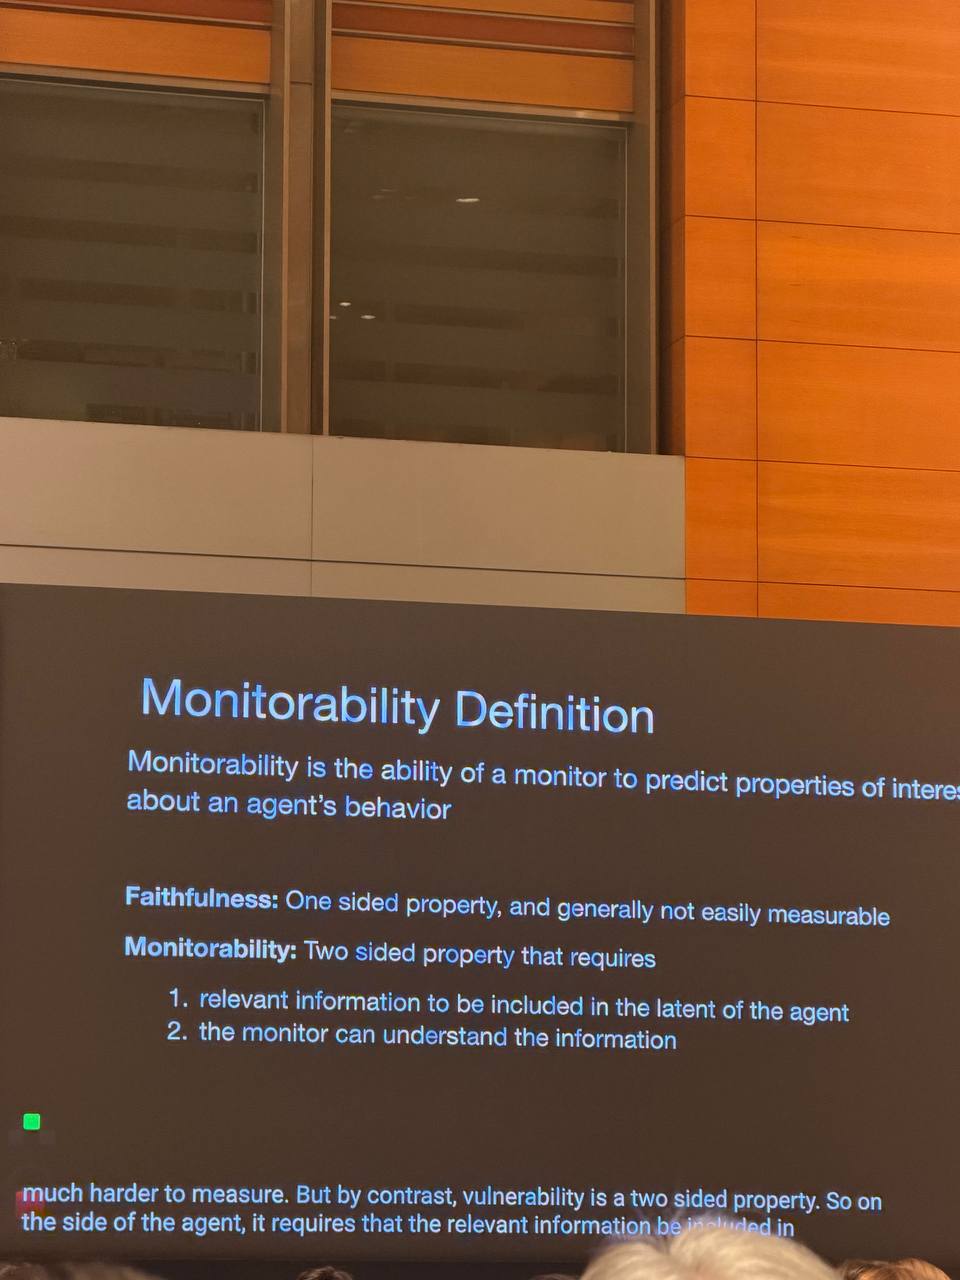
Послушала оч прикольный орАл от OpenAI сегодня на ICML. Суть в том, что мониторы safety (да честно говоря любые) довольно сложно мерить. Я сейчас столкнулась с этим в своем проекте на MATS. Довольно сложно вычленить правильно ли монитор сработал. Нам надо не продолбаться с FP-шками (когда он запаниковал), правда ли он выловил злонамеренное действие, когда особо нет ground truth-а на тип атаки. Я сейчас решаю это миллионом кейсов на эвале в разных классах и held-out-ом разных типов атак.
У них проблема ещё жёстче: для «повлиял ли на модель X» ground truth не наблюдаем даже в принципе. Они строят три архетипа эвалов
💛 Intervention. Подкидываем вмешательство (хинт, мнение пациента, память с демографией юзера), сравниваем с контрольной веткой и спрашиваем монитор, повлияло ли оно. Хитрая метрика: для конкретного сэмпла нельзя знать, хинт ли причина ответа, поэтому TPR определяют через нижнюю границу каузального эффекта (total effect между ветками).
💛 Process. Задачи по математике и физике, где эксперты заранее перечислили все допустимые пути решения через конкретные теоремы. Ответ верный = модель почти наверняка шла одним из путей, и монитор должен найти его следы в CoT.
💛 Outcome-property. Среды, где misbehavior однозначно виден по результату: невыполнимые кодинг-задачи (тесты прошли = точно хакнула), ShadeArena, anti-scheming датасеты, саботаж в снапшоте кодбейзы OpenAI.
Метрика везде g-mean² = TPR × TNR вместо F1, потому что F1 ломается на дисбалансе классов и не наказывает дегенеративный монитор
Сегодня хочу дополнить их идеями свой эвал blue-team в проекте и понять что докинут эти критерии
Папир